Claude Fable 5.1 custa $10 e $50 por milhão de tokens. Claude Opus 5 custa $5 e $25. Os próprios documentos da Anthropic dizem para você começar com o Opus 5 e mudar para o Fable 5.1 apenas "quando suas avaliações no Claude Opus 5 com maior esforço ainda ficarem aquém". Essa é uma regra testável, e esta comparação foi construída em torno dela: onde os números da Anthropic mostram o Fable 5.1 superando o Opus 5, onde eles mostram alguns pontos que a otimização de prompts poderia resolver, e onde a matemática de preços fica interessante porque as leituras de cache do Fable 5.1 são metade das do Opus 5.
As fontes são o post de lançamento da Anthropic, a página do modelo Fable 5.1 e a página de preços. Para uma visão geral de cada modelo, veja o que é o Claude Fable 5.1 e o que é o Claude Opus 5.
Lado a lado
| Claude Fable 5.1 | Claude Opus 5 | |
|---|---|---|
| ID do Modelo | claude-fable-5-1 |
claude-opus-5 |
| Lançado em | 1º de setembro de 2026 | 24 de julho de 2026 |
| Posicionamento | Raciocínio exigente e trabalho de agente de longo prazo | Codificação complexa de agente e trabalho empresarial; o padrão recomendado |
| Entrada / saída | $10 / $50 | $5 / $25 |
| Leitura de cache | $0.25 | $0.50 |
| Escrita de cache (5m / 1h) | $12.50 / $20 | $6.25 / $10 |
| Lote | $5 / $25 | $2.50 / $12.50 |
| Modo rápido | Não | Sim ($10 / $50) |
| Nível de Prioridade | Não | Não |
| Contexto / saída máxima | 1M / 128K | 1M / 128K (300K em Lote com beta) |
| Data limite de conhecimento | Junho de 2026 | Maio de 2026 |
| Latência comparativa | Mais lento | Moderada |
| Pensamento | Sempre ativo; disabled retorna 400 |
Ativo por padrão; disabled permitido em high ou abaixo |
tool_choice forçado |
400 | Aceito |
| Classificadores de segurança | ciber, bio, llm_de_fronteira, extração_de_raciocínio, danos_gerais | apenas ciber |
| Retenção zero de dados | Não disponível, a menos que autorizado | Disponível |
| Esforço por mensagem (beta) | Sim | Sim |
| Verificação de edição de histórico | Sim | Não |
O que os benchmarks dizem
Todos os números são da Anthropic, executados pela Anthropic, sem reprodução independente ainda.
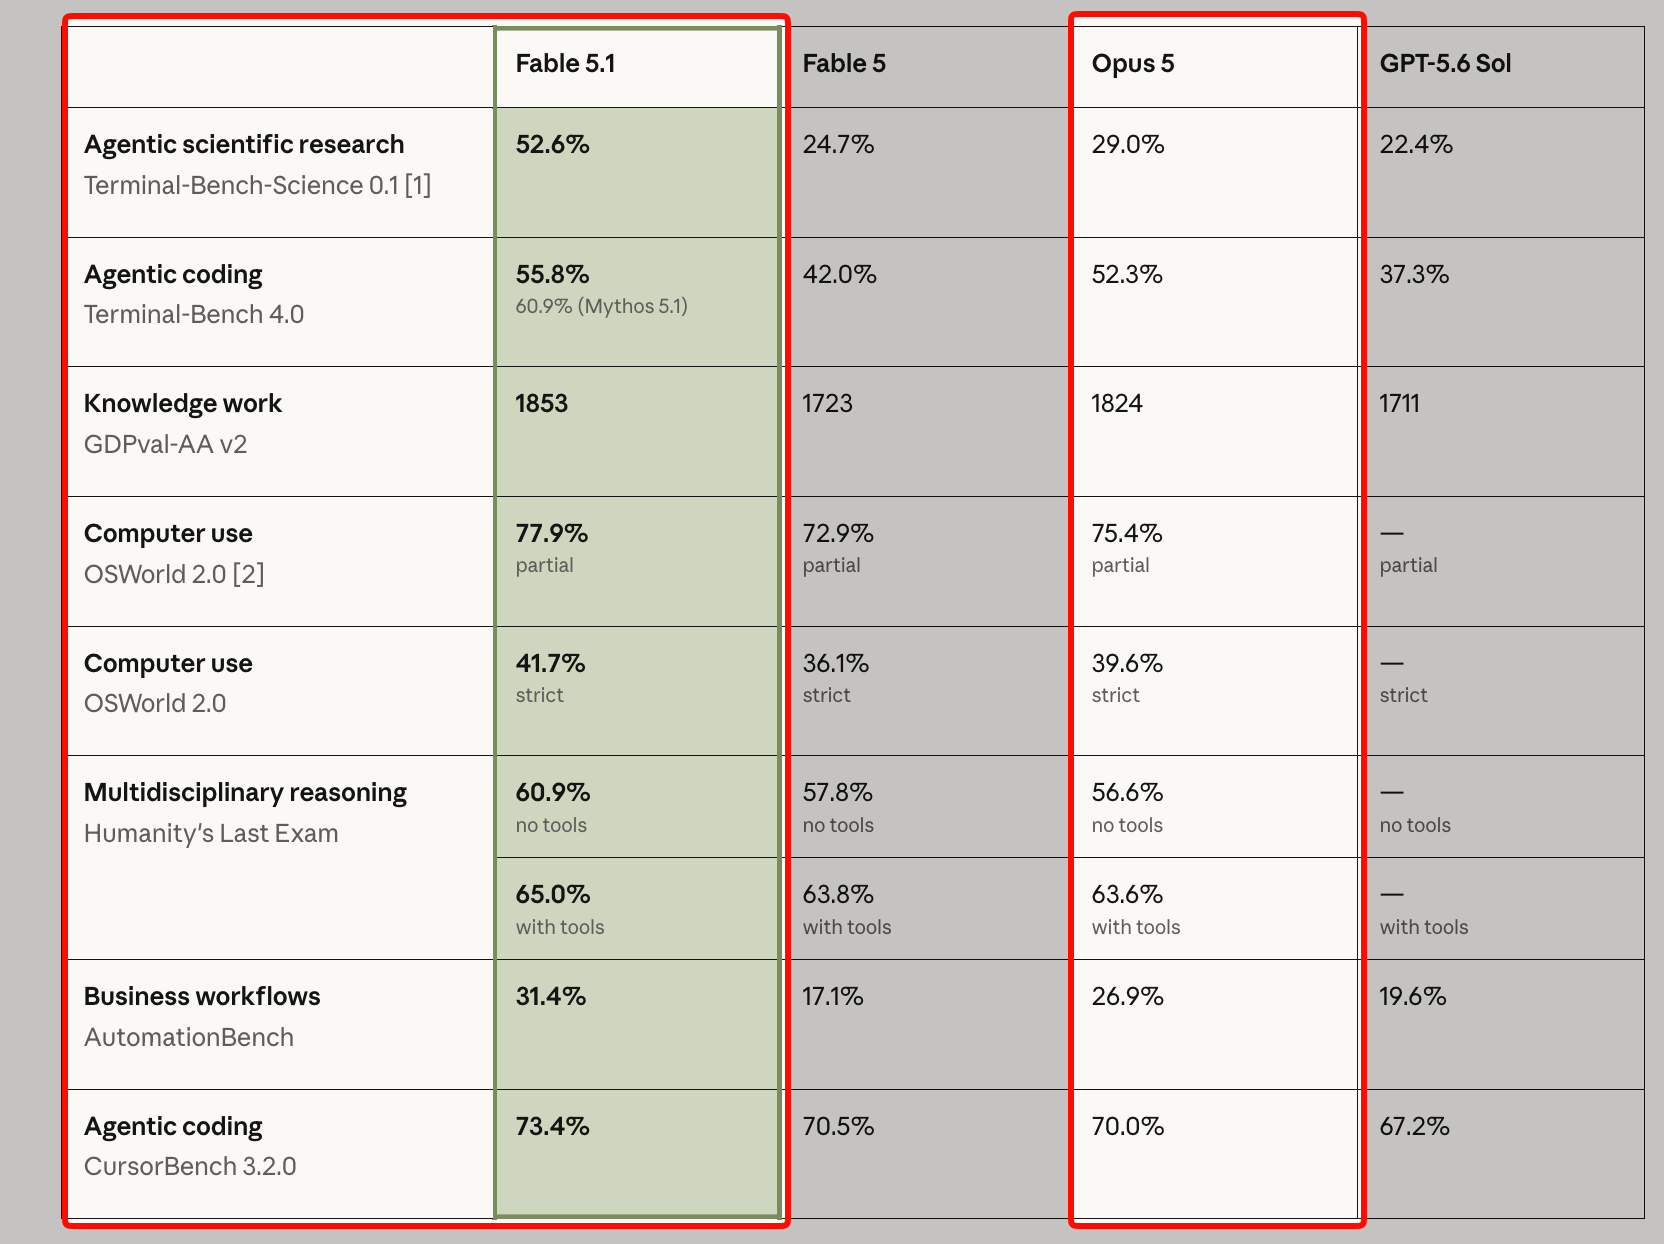
| Benchmark | Fable 5.1 | Opus 5 | Diferença |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | +23.6 |
| AutomationBench | 31.4% | 26.9% | +4.5 |
| Último Exame da Humanidade (sem ferramentas) | 60.9% | 56.6% | +4.3 |
| Terminal-Bench 4.0 | 55.8% | 52.3% | +3.5 |
| CursorBench 3.2.0 | 73.4% | 70.0% | +3.4 |
| OSWorld 2.0 (parcial) | 77.9% | 75.4% | +2.5 |
| OSWorld 2.0 (estrito) | 41.7% | 39.6% | +2.1 |
| Último Exame da Humanidade (com ferramentas) | 65.0% | 63.6% | +1.4 |
| GDPval-AA v2 | 1853 | 1824 | +29 Elo |
Leia essa tabela como duas histórias. No Terminal-Bench-Science, Fable 5.1 quase dobra o Opus 5, e este é um benchmark de pesquisa de longo prazo e intensivo em ferramentas, onde o modelo executa experimentos em um terminal por um longo tempo. Em todo o resto, a diferença está entre um e cinco pontos. Uma diferença de cinco pontos no AutomationBench é significativa. Uma diferença de 1,4 pontos no Último Exame da Humanidade com ferramentas, ou 29 Elo no GDPval, está dentro do intervalo em que seu prompt e sua configuração de esforço movem o resultado mais do que a escolha do modelo.
O outro dado que vale a pena reter: o Opus 5 foi lançado em julho com 52,3% no Terminal-Bench 4.0, à frente dos 42,0% do Fable 5. O Fable 5.1 retomou a liderança com 55,8%, mas por 3,5 pontos, não 13,8. A vantagem da camada Fable sobre a camada Opus na codificação agentica é real e mais estreita do que era em junho. A comparação Opus 5 vs Fable 5 capturou o estado anterior dessa disputa.
A matemática dos preços não é simplesmente 2x
Sem cache, o Fable 5.1 custa exatamente o dobro do Opus 5 em todas as linhas. Mas as leituras de cache invertem: $0.25 no Fable 5.1 versus $0.50 no Opus 5. Portanto, o multiplicador efetivo depende de quanto do seu input é um prefixo em cache.
Considere uma rodada de agente com 150.000 tokens em cache, 1.000 tokens de input não em cache e 800 tokens de output. Opus 5: 5(0.001) + 0.5(0.15) + 25(0.0008) = $0.005 + $0.075 + $0.02 = $0.10. Fable 5.1: 10(0.001) + 0.25(0.15) + 50(0.0008) = $0.01 + $0.0375 + $0.04 = $0.0875. Nesta rodada, o Fable 5.1 é mais barato.
Agora, considere uma revisão de código com 30.000 tokens de entrada não em cache e 4.000 tokens de saída. Opus 5: $0.15 + $0.10 = $0.25. Fable 5.1: $0.30 + $0.20 = $0.50. Exatamente o dobro.
O ponto de virada: o custo por rodada do Fable 5.1 fica abaixo do Opus 5 quando os tokens de entrada em cache excedem aproximadamente 20 vezes a soma dos tokens de entrada não em cache e 5 vezes os tokens de saída. Para loops de agente pesados em prefixos, essa condição é comum. Para qualquer coisa pesada em saída, isso nunca acontece. As gravações de cache também são o dobro no Fable 5.1, então uma sessão que redefine seu cache frequentemente perde a vantagem. O detalhamento de preços do Fable 5.1 e o detalhamento de preços do Opus 5 têm as tabelas completas.
Onde o Opus 5 vence de forma inquestionável
Tudo o que você pode executar com o pensamento desativado. O Opus 5 aceita thinking: {"type": "disabled"} no nível de esforço high ou abaixo. O Fable 5.1 nunca aceita. Para classificação, extração e rotas de resposta curta, o Opus 5 com o pensamento desativado (ou em esforço low) é mais barato e mais rápido.
Modo rápido. O Opus 5 possui um modo rápido em pré-visualização de pesquisa com velocidade de saída de até 2,5x por $10 e $50. O Fable 5.1 não tem equivalente. Se o tempo de resposta for mais importante do que os últimos pontos de benchmark, isso é decisivo.
Latência em geral. A Anthropic lista o Fable 5.1 como "mais lento" e o Opus 5 como "moderado". Turnos únicos do Fable 5.1 em tarefas difíceis com alto esforço podem levar muitos minutos.
Retenção zero de dados. O Opus 5 está disponível sob ZDR. O Fable 5.1 é um Modelo Coberto e retorna 400 a menos que a Anthropic autorize expressamente o acesso ZDR.
Menos recusas. O Opus 5 executa apenas classificadores de cibersegurança. O Fable 5.1 executa o conjunto completo do Fable: ciber, bio, desenvolvimento de LLM de fronteira, extração de raciocínio e danos gerais. Uma carga de trabalho benigna de ciências da vida ou ML que nunca dispara o Opus 5 pode disparar o Fable 5.1, e quando isso acontece, o alvo de fallback é o Opus 5 de qualquer maneira.
Uso forçado de ferramenta. O Opus 5 ainda aceita tool_choice any e tool. O Fable 5.1 retorna 400. Se sua integração depende de chamadas forçadas, o Opus 5 evita que você precise reescrever.
Sem verificação de edição de histórico. O Opus 5 não se importa se você edita turnos anteriores. O Fable 5.1 invalida blocos de pensamento posteriores quando você o faz. Um sistema que compacta no lado do cliente ou injeta lembretes por turno funciona no Opus 5 hoje e precisa de uma auditoria antes do Fable 5.1.
Onde o Fable 5.1 vence de forma inquestionável
Pesquisa de longo prazo e agentes de terminal. O resultado de 52,6% versus 29,0% no Terminal-Bench-Science é a maior diferença única na tabela da Anthropic. Se seus agentes executam experimentos, buscam pesquisa web em várias etapas ou operam por horas, esta é a carga de trabalho para a qual o modelo foi construído.
Automação de fluxo de trabalho empresarial. 31,4% versus 26,9% no AutomationBench é uma diferença real em um benchmark que modela tarefas de ponta a ponta em aplicativos.
Agentes pesados em prefixo armazenado em cache. Abordado acima: a leitura de cache de $0.25 torna o Fable 5.1 mais barato por rodada em loops dominados por prefixos.
Data limite de conhecimento. Junho de 2026 versus maio de 2026. Um mês, mas é o mais recente de qualquer modelo Claude.
Visão em documentos densos. A Anthropic lista a leitura aprimorada de gráficos, registros e tabelas aninhadas em PDFs, especialmente com ferramentas de corte e zoom, como uma área de ganho do Fable 5.1. O Opus 5 não é comparado em um benchmark de visão publicado, então trate isso como uma afirmação a ser testada.
Quando o Opus 5 em xhigh falha. Esta é a regra da Anthropic, e é a correta. Se uma tarefa falhar na sua avaliação com o Opus 5 em xhigh, tente o Fable 5.1 em high antes de tentar qualquer outra coisa.
O esforço muda a comparação
Ambos os modelos expõem cinco níveis de esforço, e a Anthropic faz uma afirmação específica sobre o Fable 5.1 no nível mais baixo: no esforço low, ele é "frequentemente competitivo com os modelos Claude Opus e Claude Sonnet em custo por tarefa, enquanto pontua mais alto". Isso reformula a escolha. Em vez de Opus 5 em high versus Fable 5.1 em high, a comparação justa para trabalho rotineiro pode ser Opus 5 em high versus Fable 5.1 em low ou medium. A contagem de tokens de saída em menor esforço é menor, o que compensa o preço 2x por token.
O inverso também é válido. Os ganhos do Fable 5.1 sobre o Fable 5 são maiores em xhigh e max, o que significa que o teto de capacidade acima do Opus 5 é mais alto nos níveis de esforço que também custam mais tempo. Teste ambos os modelos em diferentes níveis de esforço em suas próprias avaliações antes de concluir algo a partir das tabelas de lançamento. O guia de esforço do Opus 5 cobre os cinco níveis; a semântica é a mesma no Fable 5.1.
Um framework de decisão
- Comece com o Opus 5 em
high. Recomendação padrão da Anthropic, metade do preço, menos classificadores, ZDR disponível. - Aumente o Opus 5 para
xhighnas tarefas que falharem. Mais barato do que mudar de modelo. - Mova as tarefas que ainda falham para o Fable 5.1 em
high. Por rota, não globalmente. Mantenha o Opus 5 em tudo o que passar. - Verifique o perfil de cache do que você moveu. Se for um loop pesado em prefixos, o Fable 5.1 pode acabar sendo mais barato por rodada do que o Opus 5.
- Audite o sistema antes da etapa 3. O
tool_choiceforçado e as edições de histórico falham no Fable 5.1. O guia de migração tem a lista de verificação.
Executando a comparação no Apidog
Crie uma coleção com seus prompts de produção e model como uma variável de ambiente. Execute-a contra claude-opus-5 em high, novamente em xhigh, depois contra claude-fable-5-1 em high e low. Para cada execução, registre a resposta, usage.output_tokens e usage.cache_read_input_tokens em um envio repetido. Multiplique pelas taxas de cada modelo em um script pós-resposta e você terá o custo por tarefa por modelo por esforço em uma tabela. O Apidog mantém cada execução como histórico, para que a comparação sobreviva ao próximo lançamento do modelo. Baixe o Apidog para configurá-lo.
FAQ
O Claude Fable 5.1 é melhor que o Opus 5? Em todos os benchmarks publicados pela Anthropic, sim, por margens de 1,4 a 23,6 pontos. A grande diferença está no Terminal-Bench-Science; a maioria dos outros está abaixo de cinco pontos. Estes são resultados executados pelo fornecedor.
O Fable 5.1 vale o dobro do preço do Opus 5? Para pesquisa de longo prazo e agentes de terminal, automação de negócios e loops de agente com prefixo pesado (onde leituras de cache mais baratas podem torná-lo mais econômico por turno), muitas vezes sim. Para trabalho com muita saída, sensível à latência ou de classificação, não. A própria regra da Anthropic: só mude quando o Opus 5 com maior esforço falhar nas suas avaliações.
Qual é mais rápido, Fable 5.1 ou Opus 5? Opus 5. A Anthropic o lista como latência "moderada" versus "mais lenta" para o Fable 5.1, e o Opus 5 tem um modo rápido com velocidade de saída de até 2,5x. O Fable 5.1 não tem nenhum.
O Opus 5 tem os mesmos classificadores de segurança que o Fable 5.1? Não. O Opus 5 executa apenas classificadores de cibersegurança. O Fable 5.1 adiciona bio, LLM de fronteira, extração de raciocínio e danos gerais. Quando o Fable 5.1 recusa, o Opus 5 é um dos dois alvos de fallback permitidos.
Posso usar o Fable 5.1 com retenção zero de dados como o Opus 5? Não. O Fable 5.1 requer retenção de 30 dias e é um Modelo Coberto. O Opus 5 está disponível sob ZDR.
Uma conversa pode transitar entre o Opus 5 e o Fable 5.1? Para cima, sim: o Fable 5.1 lê os blocos de pensamento do Opus 5. Para baixo, a API descarta os blocos de pensamento do Fable 5.1 antes que o Opus 5 os veja, sem cobrança, e o Opus 5 replaneja esse turno.