
Resposta rápida: A Claude Batch API processa requisições da Messages API de forma assíncrona com 50% de desconto tanto nos tokens de entrada quanto nos de saída. Você envia até 100.000 requisições (ou 256 MB) em uma única chamada, faz polling até o batch terminar e então lê os resultados indexados pelo seu próprio custom_id. A maioria dos batches termina em menos de uma hora, e o teto máximo é 24 horas.
Você tem 40.000 tickets de suporte para classificar, ou um catálogo de produtos para reescrever, ou um mês de transcrições para resumir. Nada disso é urgente. Cada uma dessas chamadas ainda é cobrada a preço cheio quando você as dispara uma de cada vez, e você passa a tarde vigiando retentativas contra seu rate limit.
A Claude Batch API existe exatamente para esse tipo de trabalho. Você entrega ao Anthropic uma lista de requisições, vai cuidar da vida e volta para um arquivo de resultados que custou metade do que as mesmas chamadas teriam custado de forma síncrona. Sem fila para rodar, sem ajuste de concorrência, sem lógica de backoff.
Este guia cobre o que o endpoint de batch faz, quanto custa, como enviar e coletar um job, e como deixar seu agente de codificação testar tudo isso com o Apidog CLI antes de apontá-lo para dados reais.
O que é a Claude Batch API?
A Claude Batch API é um endpoint assíncrono em /v1/messages/batches que aceita muitas requisições da Messages API em um único envio e retorna seus resultados quando o processamento termina. Ela troca latência por um desconto de 50%. A Anthropic a documenta em batch processing.
As restrições com as quais você precisa projetar:
- Tamanho: até 100.000 requisições ou 256 MB por batch, o que for atingido primeiro.
- Tempo: a maioria dos batches é concluída em até uma hora; 24 horas é o máximo antes que requisições inacabadas expirem.
- Retenção: os resultados ficam disponíveis por 29 dias após a criação do batch.
- Paridade de recursos: visão, uso de ferramentas, system prompts e prompt caching funcionam todos dentro de um batch.
- Ordenação: os resultados retornam em qualquer ordem, então você os indexa por
custom_ide nunca por posição.
Esse último ponto é o que pega as pessoas. Um batch é um saco, não uma fila.
Quanto custa a Claude Batch API
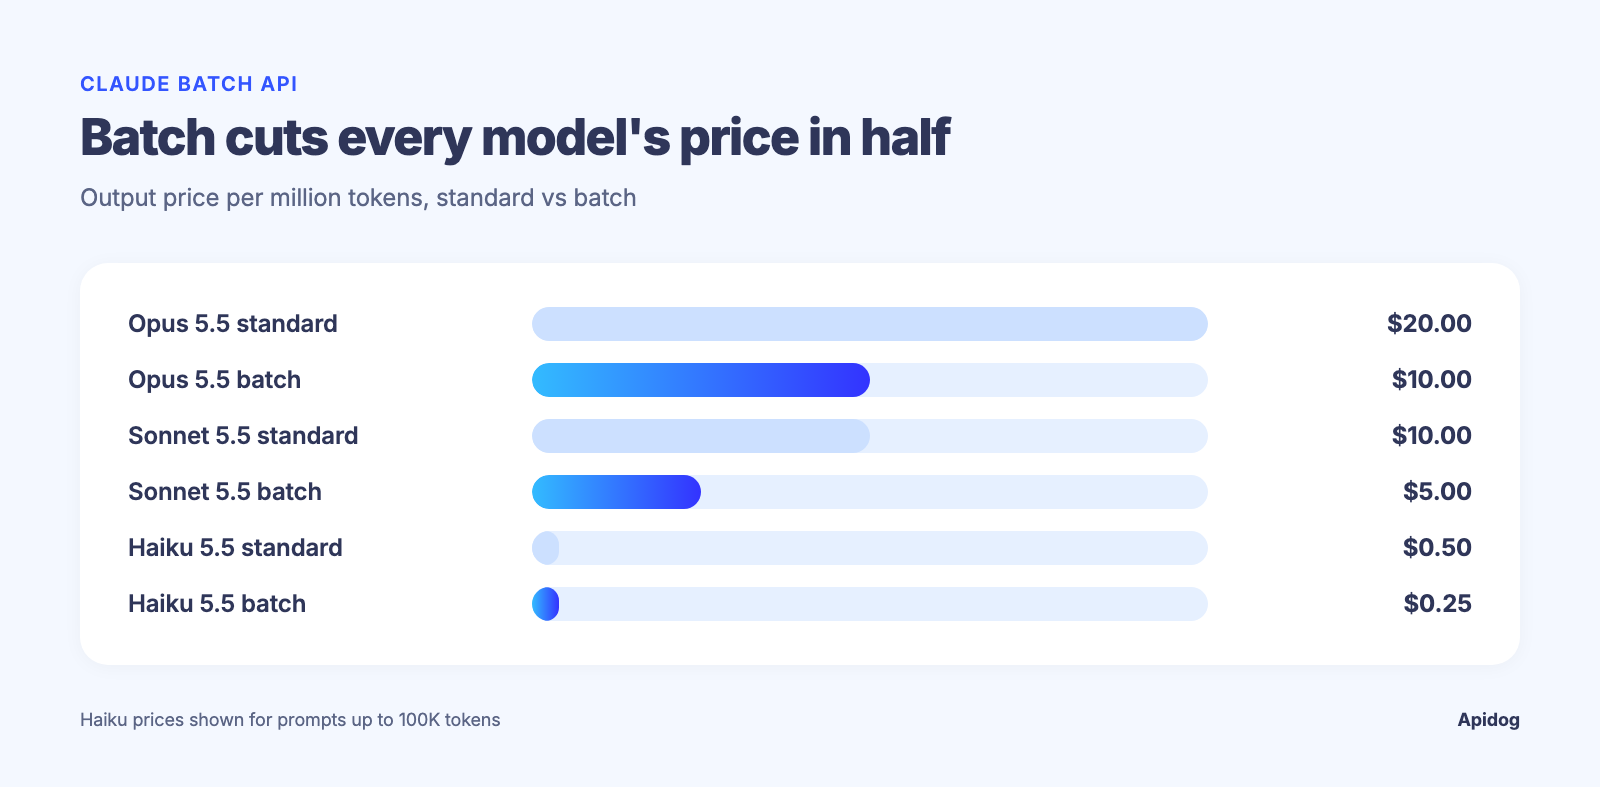
O desconto é um valor fixo de 50% tanto nos tokens de entrada quanto de saída, aplicado ao modelo que cada requisição nomeia. Você pode misturar modelos dentro de um mesmo batch, então um classificador barato e um resumidor caro podem andar juntos.
| Modelo | Entrada / saída padrão por MTok | Entrada / saída em batch por MTok |
|---|---|---|
| Claude Opus 5.5 | $4.00 / $20.00 | $2.00 / $10.00 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $1.00 / $5.00 |
| Claude Haiku 5.5 (prompts de até 100K) | $0.10 / $0.50 | $0.05 / $0.25 |
| Claude Haiku 5.5 (prompts acima de 100K) | $0.50 / $2.50 | $0.25 / $1.25 |
Leia as linhas do Haiku com atenção. O Haiku 5.5 tem preço por tamanho de prompt, então um prompt que ultrapassa 100.000 tokens é cobrado 5x a tarifa de prompt curto, com ou sem desconto de batch. Faça a previsão de trabalho com Haiku de contexto longo a $0.25 / $1.25, não $0.05 / $0.25. Confira a página de preços da Anthropic antes de construir uma previsão com esses números, e leia nossa análise de para onde vai o gasto com a Claude API se a fatura é o motivo de você estar aqui.
O preço de batch também se acumula com prompt caching, que é onde estão as economias reais. Mais sobre isso abaixo.
Envie seu primeiro batch
Instale o SDK oficial de Python e monte uma lista de requisições. Cada uma carrega um custom_id que você escolhe e um objeto params que se parece exatamente com uma chamada normal de messages.create().
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()

tickets = [
    "Card declined three times, support chat timed out.",
    "Love the new dashboard, the export button is hidden though.",
    "Webhook stopped firing after the 2.4 upgrade.",
]

batch = client.messages.batches.create(
    requests=[
        Request(
            custom_id=f"ticket-{i}",
            params=MessageCreateParamsNonStreaming(
                model="claude-haiku-5-5",
                max_tokens=1024,
                output_config={"effort": "low"},
                messages=[{
                    "role": "user",
                    "content": f"Label this ticket billing, bug, or praise. One word.\n\n{text}",
                }],
            ),
        )
        for i, text in enumerate(tickets)
    ]
)

print(batch.id, batch.processing_status)
Faça o custom_id carregar significado. Uma chave primária de banco de dados ou um caminho de arquivo economiza um join depois, e é a única coisa que liga um resultado de volta à sua entrada.
Se você preferir HTTP puro, o mesmo payload vai para POST https://api.anthropic.com/v1/messages/batches com seus cabeçalhos x-api-key e anthropic-version. A referência de criação de message batch tem o schema completo.
Faça polling do batch e colete os resultados
Recupere o batch até que processing_status leia ended, então transmita os resultados. Cada resultado carrega o custom_id que você definiu e um result.type de succeeded, errored, canceled ou expired.
import time

while True:
    batch = client.messages.batches.retrieve(batch.id)
    if batch.processing_status == "ended":
        break
    print("still working:", batch.request_counts.processing)
    time.sleep(30)

labels, retry = {}, []
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        msg = result.result.message
        labels[result.custom_id] = next(b.text for b in msg.content if b.type == "text")
    elif result.result.type == "errored":
        retry.append(result.custom_id)

print(f"{len(labels)} labeled, {len(retry)} need another pass")
Dois modos de falha merecem tratamento separado. Um erro invalid_request significa que o corpo da requisição estava errado, então corrija antes de reenviar. Qualquer outra coisa é do lado do servidor e segura de repetir como está. Um resultado expired significa que a janela de 24 horas se fechou antes de aquela requisição rodar, e você reenvia essas também.
Faça polling em um temporizador de 30 a 60 segundos. Martelar o endpoint de retrieve a cada segundo não te dá nada e conta contra seus rate limits da Claude API.
Combine o preço de batch com prompt caching
O maior ganho vem de combinar os dois descontos. Se toda requisição no seu batch compartilha um prefixo longo, um guia de estilo, uma taxonomia, um contrato de 40 páginas, marque esse prefixo com cache_control e envie o mesmo prefixo marcado em todas as 10.000 requisições.
shared_system = [
    {"type": "text", "text": "You are a support triage analyst."},
    {
        "type": "text",
        "text": taxonomy_document,          # thousands of tokens, identical every time
        "cache_control": {"type": "ephemeral"},
    },
]
Coloque esse bloco system em cada Request do batch. Qualquer requisição cujo prefixo corresponda byte a byte a uma entrada de cache ativa é cobrada com tarifas de cache-read para esse prefixo, e o desconto de 50% do batch se aplica tanto a leituras quanto a escritas de cache. Não orçe para uma taxa de acerto perfeita: um batch processa suas requisições de forma concorrente em vez de em ordem, então acertos de cache dentro de um batch são o melhor esforço. O guia de prompt caching da Anthropic cobre as regras de prefixo: qualquer byte que mude antes do seu breakpoint invalida tudo depois dele, então mantenha timestamps e texto por item depois do bloco cacheado.
Deixe o Claude Code testar o endpoint com o Apidog CLI
Antes de gastar dinheiro com 100.000 requisições reais, você quer um teste de regressão sobre o ciclo de vida do batch: criar, recuperar, resultados. Escrever isso à mão em uma GUI é lento. Deixe seu agente de codificação fazer isso com o Apidog CLI.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install   # pick Claude Code when prompted
Então um prompt para o Claude Code:
In Apidog project 4820193, create a test case for POST https://api.anthropic.com/v1/messages/batches
that submits two Haiku 5.5 requests with custom_id ticket-0 and ticket-1, asserts the response
has an id and processing_status, then polls GET /v1/messages/batches/{id} until processing_status
is ended. Run it against the anthropic-staging environment and summarize failures.
O agente lê o schema do payload, valida o próprio JSON, então cria e executa o caso:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file batch-case.json
apidog test-case create --project 4820193 --file batch-case.json
apidog run --test-case 77214 --project 4820193 -e 992301 -r cli,json
Sua API key fica em uma variável de ambiente do Apidog, então nunca cai em um prompt ou em um repositório. Troque o reporter para -r junit e o mesmo comando roda em CI a cada merge, que é a configuração do nosso guia de pipeline do Apidog CLI. Se você ainda não conectou o CLI ao seu agente, comece com usando o Apidog CLI no Claude Code.
Quando batch é a escolha errada
| Carga de trabalho | Usar batch? | Por quê |
|---|---|---|
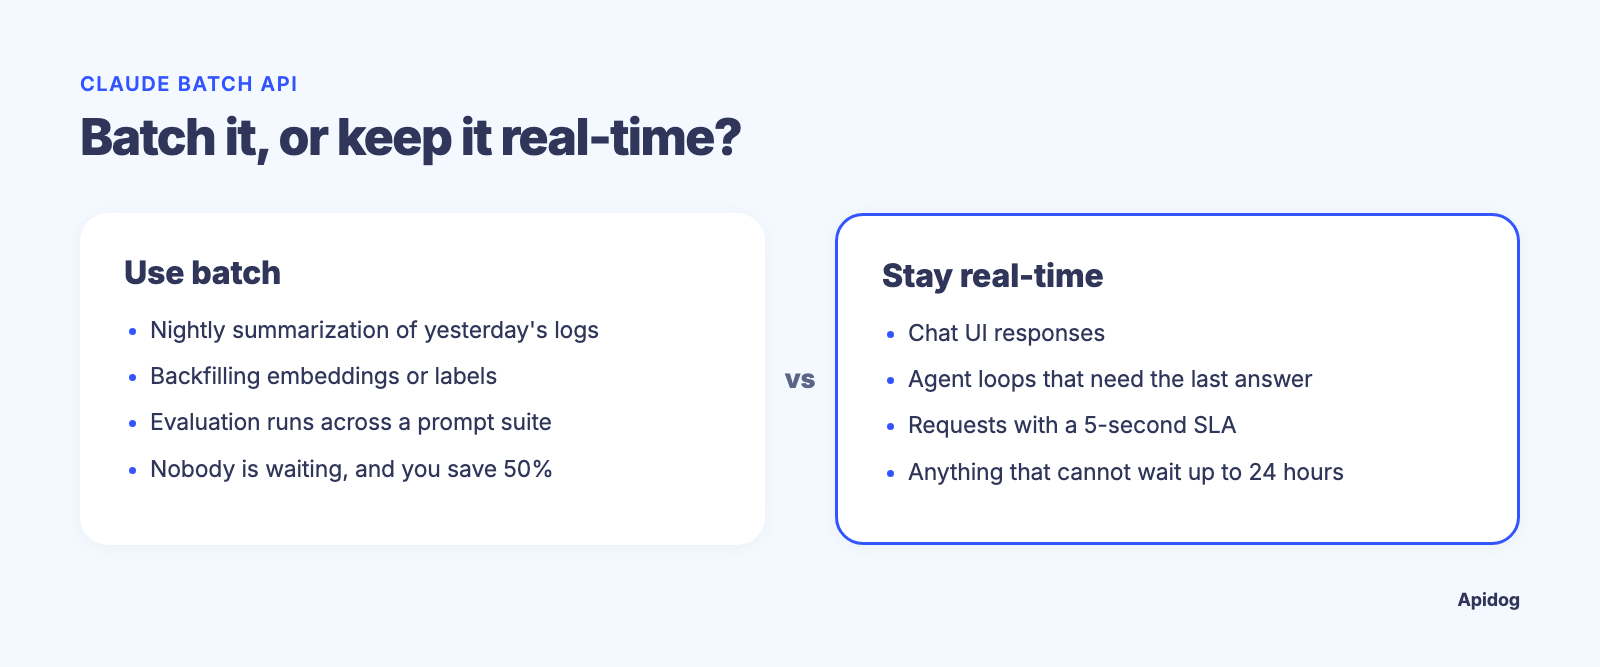
| Sumarização noturna dos logs de ontem | Sim | Ninguém está esperando; 50% de desconto |
| Backfill de embeddings ou rótulos sobre um corpus | Sim | Cabe no teto de 100.000 requisições |
| Execuções de avaliação sobre uma suíte de prompts | Sim | Resultados indexados por custom_id mapeiam para IDs de teste |
| Respostas de UI de chat | Não | Usuários não vão esperar uma hora |
| Um loop de agente que precisa da última resposta para escolher o próximo passo | Não | Requisições em batch não conseguem ver umas às outras |
| Uma requisição que precisa cumprir um SLA de 5 segundos | Não | Sem garantia de latência abaixo de 24 horas |
Algumas coisas também não atravessam. O modo rápido não está disponível na Batch API, fallbacks de recusa do lado do servidor são rejeitados lá, e no Claude Opus 5.5 e no Claude Sonnet 5.5 um tool_choice forçado de any ou tool retorna um 400 dentro de um batch exatamente como faria em uma chamada normal. Use tool_choice: auto com strict: true em vez disso.
Se você opera infraestrutura multi-provedor, o mesmo padrão existe em outros lugares: veja a OpenAI Batch API e o modo batch da Gemini API. As formas diferem, a economia não.
FAQ
O que é a Claude Batch API?
É um endpoint assíncrono que executa requisições padrão da Messages API em massa a 50% dos preços normais de tokens. Você envia uma lista de requisições com seus próprios IDs, faz polling até o batch terminar e lê os resultados em até 29 dias.
Quanto custa a Claude Batch API?
Metade da tarifa padrão tanto na entrada quanto na saída. No Claude Sonnet 5.5 isso é $1.00 por milhão de tokens de entrada e $5.00 por milhão de tokens de saída, contra $2.00 e $10.00 de forma síncrona.
Quanto tempo leva um batch do Claude?
A maioria dos batches termina em até uma hora. O máximo é 24 horas, após o que qualquer requisição não processada retorna um resultado expired e você a reenvia.
Posso usar prompt caching dentro de um batch?
Sim, e os descontos se acumulam. Marque um prefixo compartilhado com cache_control, repita esse prefixo idêntico em cada requisição, e leituras em cache são cobradas a uma fração do preço de entrada além do desconto de batch.
O que acontece quando uma requisição em um batch falha?
Apenas aquela requisição falha. Seu resultado carrega type: "errored" com um objeto de erro; todo o resto ainda tem sucesso. Erros de validação precisam de um payload corrigido, erros de servidor são seguros de repetir sem alterações.
Posso cancelar um batch em execução?
Sim. client.messages.batches.cancel(batch_id) move o batch para canceling. Requisições já finalizadas mantêm seus resultados; o resto volta como canceled.
A Batch API suporta ferramentas e imagens?
Sim. Todos os recursos da Messages API funcionam dentro de um batch, incluindo visão, definições de ferramentas e system prompts. As exceções são modo rápido, fallbacks do lado do servidor e escolha forçada de ferramenta nos modelos 5.5.
Conclusão
O processamento em batch é a segunda maior economia gratuita na Claude API, depois do prompt caching, e não custa nada em qualidade: mesmos modelos, mesmos recursos, metade do preço, pago em latência que você provavelmente não estava usando. Indexe seus resultados por custom_id, faça cache do prefixo compartilhado e trate expired como uma retentativa em vez de uma falha.
Teste o ciclo de vida antes de escalá-lo. Instale o Apidog CLI, aponte seu agente de codificação para os endpoints de batch e mantenha o caso de teste gerado rodando em CI para que uma mudança de schema nunca te surpreenda com 100.000 requisições. O plano gratuito cobre 4 usuários, e você pode baixar o Apidog e ter o primeiro caso rodando em alguns minutos.