
O Chain of Recall é uma forma de dar memória a um agente de IA de longa execução sem sobrecarregar sua janela de contexto. Cada Trigger, Thread e Worker recebe um ID estável. O contexto mantém apenas IDs, resumos curtos e mensagens próximas, e o agente percorre os links entre os IDs para buscar fatos mais antigos em poucos saltos.
O termo surgiu no artigo de design do DeepSeek Harness “Exploring Super-agent Design”, publicado em 01/11/2026. Um aviso antes de continuar: o artigo descreve uma arquitetura, e não um recurso já lançado. Partes dele estão em um plugin de protótipo, o dsh-superagent-prototype, que os autores definem como “não sendo um produto oficial da DeepSeek”. Não existe um botão do Chain of Recall para ativar. Trata-se de um padrão que você mesmo constrói.
O problema da janela de contexto em agentes de longa execução
Um agente de longa execução atinge o limite do contexto porque o trabalho não para de chegar. Um superagente monitorando chats, o GitHub e o CI lida com centenas de eventos por dia, e a janela que armazenava o trabalho de ontem não tem como comportar o de hoje.
As abordagens habituais cobram seu preço:
- Manter tudo. A janela enche e o custo dispara a cada interação.
- Resumir interações anteriores. O resumo acaba descartando a mensagem de erro exata ou o número do PR que você precisará mais tarde.
- Recuperar por similaridade. Funciona bem até o momento em que o fato necessário não se parece com a sua consulta.
O guia da Anthropic sobre engenharia de contexto para agentes de IA trata o contexto como um recurso finito que exige curadoria. O Chain of Recall é uma maneira prática de fazer essa curadoria, e nosso artigo explicativo sobre como funciona a memória de agentes de IA aborda uma gama mais ampla de opções.
Inline vs. spill: o contexto como cache
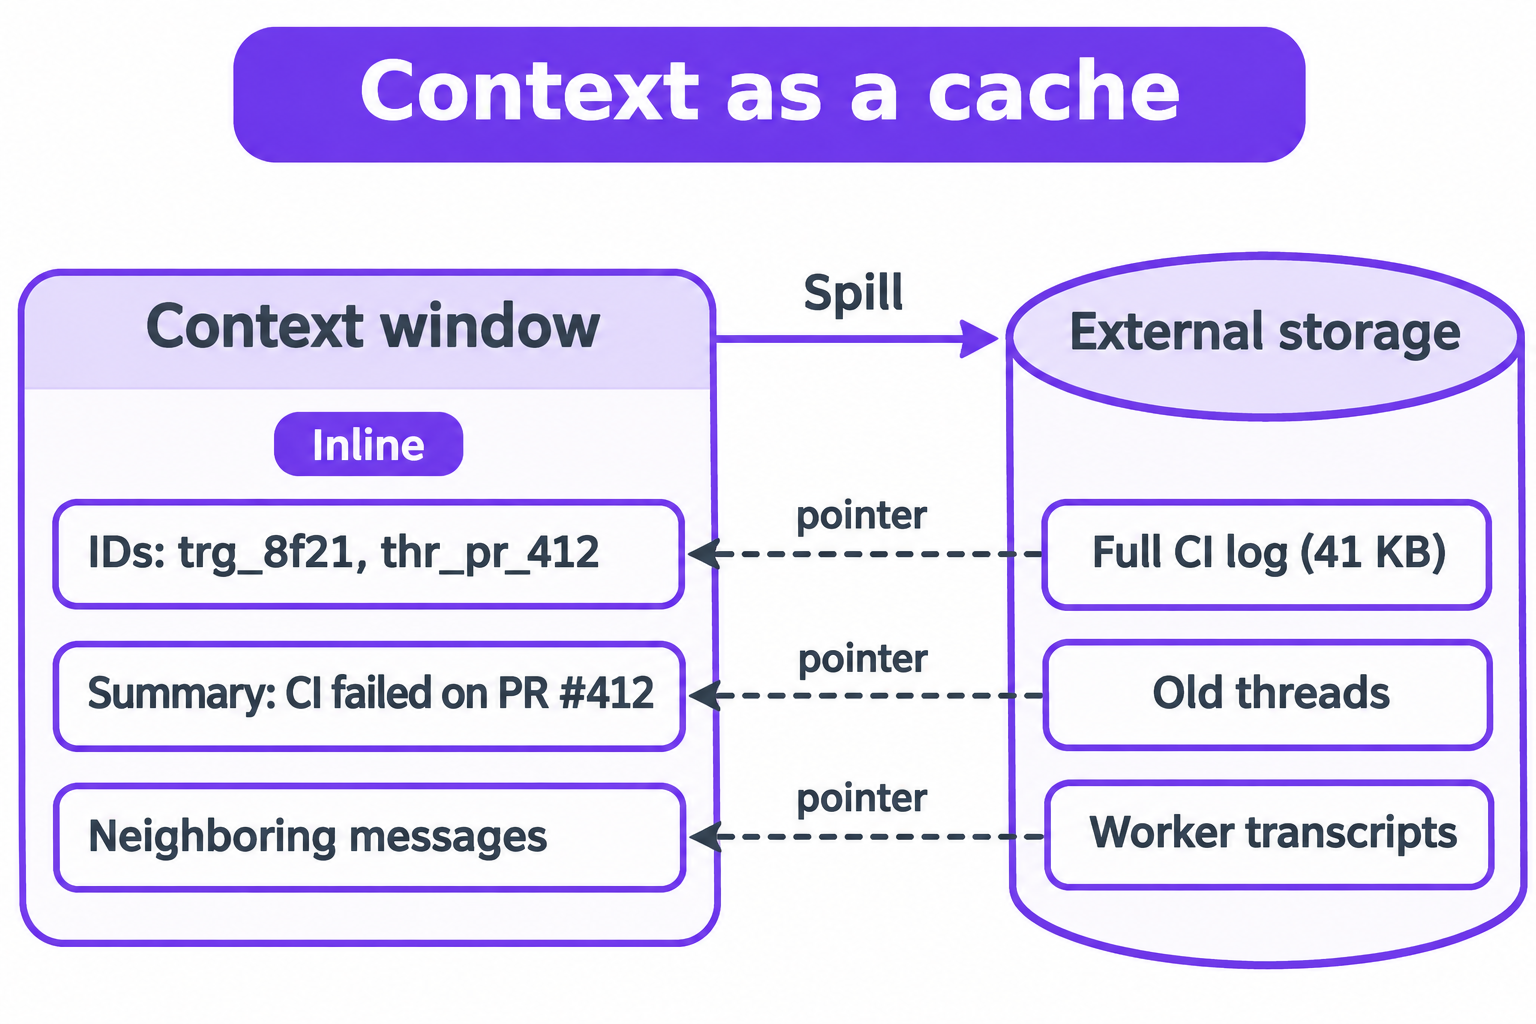
O artigo aborda a janela de contexto como um cache com duas ações principais:
- Manter inline o que o agente provavelmente precisará agora: IDs, resumos curtos e mensagens vizinhas.
- Fazer o spill de todo o resto: truncar o conteúdo e deixar um ponteiro que o agente possa seguir depois.
Um item transferido via spill não é apagado; apenas seu ponteiro permanece no prompt.
Veja como isso funciona na prática quando uma falha de CI chega ao Router. Esta estrutura é ilustrativa e não o código real da DeepSeek:
{
  "trigger_id": "trg_8f21",
  "source": "github.check_run",
  "thread_id": "thr_pr_412",
  "summary": "CI failed on PR #412: 3 of 118 tests red in payments/",
  "neighbours": ["trg_8f1c: review comment asking for retry logic"],
  "spilled": {
    "full_log": "GET /triggers/trg_8f21/payload (41 KB, truncated)"
  }
}
Se o resumo de uma linha for suficiente, o agente nunca gasta tokens com o log de 41 KB. Se não for, ele busca o log pelo ID.
IDs estáveis e o grafo de referências
O Chain of Recall funciona porque os IDs nunca mudam. No design proposto pelo artigo, três tipos de objetos os utilizam:
| Objeto | O que é | Exemplo de ID |
|---|---|---|
| Trigger | Um evento de entrada: uma mensagem de chat, um webhook, um callback de CI | trg_8f21 |
| Thread | Uma sequência de eventos relacionados em um PR, tópico de chat ou cadeia de e-mails | thr_pr_412 |
| Worker | Uma sessão isolada de agente que executa uma única tarefa | wkr_77a0 |
Um Trigger pertence a uma Thread, uma Thread é gerenciada por um ou mais Workers, e o relatório de um Worker cita os Triggers sobre os quais atuou. Esses links formam um grafo de referências, e esse grafo é a memória do agente.
A recuperação acontece seguindo os links salto a salto, e não carregando todo o histórico ou buscando por texto similar. O guia complementar sobre como criar um superagente explica onde Triggers, Threads e Workers se encaixam na arquitetura completa de Router e Workers.
Passo a passo de um recall em múltiplos saltos
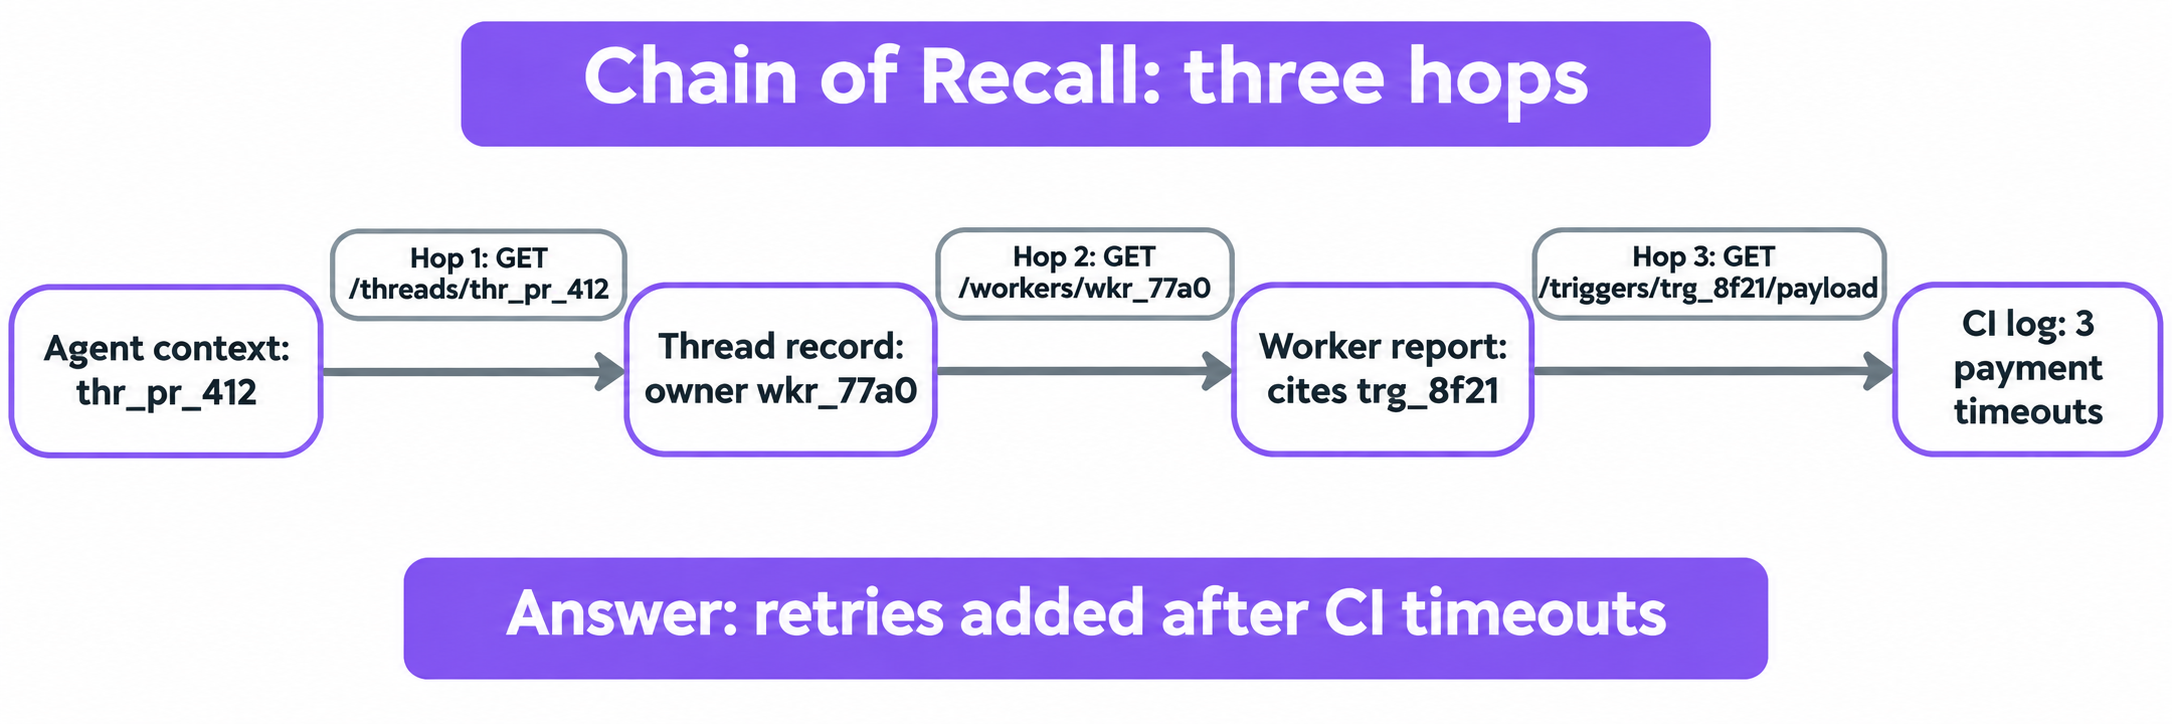
Suponha que um colega de equipe pergunte ao Router na sexta-feira: “Por que adicionamos lógica de repetição (retry) ao cliente de pagamentos?” A discussão original aconteceu na terça-feira e já sofreu spill há muito tempo. Veja o fluxo:
- Salto 1: encontrar a Thread. O contexto do Router ainda guarda uma entrada de índice de uma linha:
thr_pr_412: payments retry PR, merged Wed. Ele faz uma requisiçãoGET /threads/thr_pr_412. - Salto 2: encontrar o Worker. O registro da Thread lista
owner_workers: ["wkr_77a0"]. O Router consultaGET /workers/wkr_77a0e lê seu relatório final. - Salto 3: identificar a causa. O relatório cita
trg_8f21, a falha no CI. O Router busca o payload desse Trigger e analisa os erros de timeout no log. - Resposta. “O CI no PR #412 falhou com 3 timeouts de pagamento na terça-feira. O Worker wkr_77a0 implementou retries com backoff, e o PR foi mesclado na quarta-feira.”
Três buscas pequenas e cirúrgicas. Nada foi presumido e nada ficou ocupando espaço no prompt por três dias.
Chain of Recall vs. memória vetorial e resumos
O Chain of Recall não substitui outras técnicas de memória; ele responde a uma pergunta diferente. A recuperação vetorial, popularizada pelo artigo sobre geração aumentada por recuperação (RAG), pergunta: “o que se parece com isso?”. Já o Chain of Recall pergunta: “o que está conectado a isso?”.
| Chain of Recall | Memória vetorial (RAG) | Resumos contínuos | Servidores MCP de memória | |
|---|---|---|---|---|
| Como faz a recuperação | Segue links de IDs estáveis | Busca por similaridade em embeddings | Lê um histórico comprimido | Chama uma ferramenta de memória exposta pelo servidor |
| Precisão | Registro exato por ID | Aproximada, ranqueada por relevância | Com perdas por definição | Depende do armazenamento do servidor |
| Mais indicado para | Histórico de eventos: PRs, tickets, execuções de CI | Grandes conjuntos de documentos, perguntas abertas | Sessões curtas, continuidade de conversas | Fatos compartilhados entre ferramentas e sessões |
| Requisitos | IDs que nunca mudam, APIs de busca por ID | Modelo de embeddings e um índice vetorial | Etapa de sumarização | Um servidor MCP em execução |
| Ponto fraco | Não encontra o que não estiver vinculado | Pode ignorar fatos formulados de maneira diferente | Descarta detalhes | Mais um serviço para gerenciar e proteger |
Na prática, você combinará essas abordagens: um índice vetorial localiza o ID inicial da Thread, e então o Chain of Recall navega até os fatos exatos. A hierarquia de memória inspirada em sistemas operacionais apresentada no artigo do MemGPT é uma abordagem bastante similar. Se preferir começar com uma solução pronta, consulte nosso guia sobre como adicionar memória persistente a agentes de IA com MCP.
Há duas limitações importantes. O artigo lista a memória de longo prazo como um problema em aberto e não afirma que o Chain of Recall o resolve. Além disso, em seu experimento, a remoção do repasse de Threads (pass-through) aumentou a leitura de tokens do cache de 23,2M para 31,8M por execução — um acréscimo de cerca de 37%, decorrente da ausência de um recurso, e não de uma economia gerada pelo Chain of Recall em si.
O que as APIs subjacentes devem garantir
Cada salto no passo a passo representa uma chamada de API. Se uma chamada retornar um registro diferente ou nenhum dado, a cadeia se rompe e o agente trava ou responde com base em suposições. Por isso, as APIs que sustentam o Chain of Recall precisam cumprir quatro contratos:
- IDs nunca mudam. Um ID retornado hoje deve apontar exatamente para o mesmo objeto no mês que vem. Nada de reutilizar IDs após exclusões nem de renumerar registros após migrações.
- A busca por ID é rápida e exata.
GET /threads/{id}retorna aquele registro específico. Ela não faz buscas parciais nem retorna a “correspondência mais próxima”. - IDs desconhecidos falham explicitamente. Um ID inexistente deve retornar
404 Not Found, conforme definido pela RFC 9110, com uma mensagem de erro clara no corpo da resposta. Retornar200com um objeto vazio faz o agente presumir que o registro existe quando, na verdade, ele não existe. - Cursores paginam sem lacunas.
GET /threads/{id}/events?cursor=percorre uma Thread longa em ordem. Cada evento é listado uma única vez, nada é omitido, e o cursor continua válido mesmo com a chegada de novos eventos.
Esses contratos podem ser violados silenciosamente durante refatorações, por isso devem ser cobertos por testes automatizados. As respostas das ferramentas também precisam ser enxutas, como detalhamos em nosso guia sobre respostas de ferramentas para agentes e a janela de contexto.
Permita que seu agente de código teste as APIs de recall com a Apidog CLI
O Chain of Recall é tão confiável quanto os seus endpoints de busca por ID, e um agente de programação pode escrever e reexecutar essas validações para você. A Apidog CLI disponibiliza comandos para o agente definir os endpoints, criar casos de teste e executá-los diretamente pelo terminal.
Faça a configuração inicial uma única vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, envie o seguinte prompt ao Claude Code, Codex ou a qualquer outro agente que você utilize:
In Apidog project <projectId>, define three endpoints for our agent memory
service: GET /threads/{id}, GET /threads/{id}/events?cursor=, and
GET /workers/{id}. Then create test cases that check:
1. A thread_id returned by GET /threads/{id} resolves to the same record
   on a second call, and each owner worker ID resolves via GET /workers/{id}.
2. An unknown thread ID and an unknown worker ID both return 404.
3. Paging GET /threads/{id}/events with the cursor returns every event
   once, in order, with no gaps.
Run them against the staging environment and summarize any failures.
O agente lê o schema de cada payload, valida o JSON antes de gravar qualquer alteração e, em seguida, cria e executa os testes:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file thread-get.json
apidog endpoint create --project <projectId> --file thread-get.json

apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file id-resolves.json
apidog test-case create --project <projectId> --file id-resolves.json

apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
O relatório cli exibe no terminal os sucessos e falhas de cada asserção, e o relatório em json gera um arquivo estruturado que o agente pode interpretar para apontar qual salto falhou. Se um ID deixar de responder após uma migração, você identificará o problema no relatório antes que seu agente comece a formular respostas com base em uma cadeia rompida. Para executar essas mesmas verificações a cada merge, altere o reporter para -r junit; nosso passo a passo sobre a Apidog CLI no Claude Code demonstra o ciclo completo do agente.
Quando utilizar o Chain of Recall
Utilize o Chain of Recall quando a memória do seu agente for um histórico de eventos discretos e conectáveis: PRs, tickets, execuções de CI, conversas de suporte ou deploys. Esses elementos já possuem IDs naturais, e as perguntas feitas sobre eles (“por que fizemos isso?”, “o que aconteceu depois?”) são essencialmente perguntas sobre conexões.
Use a recuperação vetorial para documentos não estruturados e perguntas amplas, e utilize resumos em sessões curtas onde a perda de detalhes não for um problema.
O Chain of Recall nasceu de um artigo técnico e de um protótipo: uma ideia clara e testável, não um produto finalizado. Para conhecer a ferramenta por trás do artigo, confira o que é o DeepSeek Harness.
FAQ
O Chain of Recall é um recurso da DeepSeek que posso simplesmente ativar? Não. Trata-se de um conceito apresentado no artigo sobre superagentes do DeepSeek Harness, cujas partes integram um plugin de protótipo que, segundo os próprios autores, não é um produto oficial da DeepSeek. Cabe a você implementar esse padrão na sua arquitetura.
Qual é a diferença entre inline e spill? O inline mantém IDs, resumos curtos e mensagens próximas no prompt. O spill trunca todo o restante, mantendo apenas um ponteiro que o agente pode consultar pelo ID quando necessário.
O Chain of Recall substitui o RAG? Não. O RAG encontra conteúdos similares por proximidade semântica; o Chain of Recall navega por links exatos de IDs. Muitos agentes combinam ambas as abordagens.
O Chain of Recall reduziu o consumo de tokens em 37%? Não. O dado de 37% refere-se ao repasse de Threads (pass-through): no experimento do artigo, remover essa funcionalidade aumentou a leitura de tokens do cache de 23,2M para 31,8M por execução. O artigo não menciona uma economia direta de tokens gerada pelo Chain of Recall em si.
O que uma API de busca por ID deve retornar para um ID inexistente? Um status 404 Not Found com um corpo de erro detalhado. Retornar 200 com um objeto vazio faz o agente presumir que o registro existe, quebrando a cadeia de recuperação de forma silenciosa.
Como testar e garantir a estabilidade das APIs de memória do meu agente? Crie casos de teste para validar se um ID retornado em uma chamada é resolvido na seguinte, se IDs desconhecidos retornam 404 e se os cursores paginam sem omitir dados. Um agente de programação pode gerar e executar esses testes automaticamente com a Apidog CLI a cada merge.