
A Cerebras vende um único número: velocidade. O argumento é que seus chips de escala de wafer entregam tokens mais rápido do que um cluster de GPUs jamais conseguiria, e a camada gratuita é como a empresa faz você perceber isso. Mas “rápido” não é algo que você deve aceitar pela palavra de um fornecedor. É algo que você mede, na sua própria conexão, com o seu próprio prompt, e depois mantém como um registro que pode ser reexecutado sempre que a Cerebras lançar um novo modelo ou mudar um limite.
Este guia faz essa medição com você. Você vai obter uma chave de API da Cerebras, fazer uma chamada real de conclusão de chat no endpoint compatível com OpenAI, cronometrar o primeiro token e a resposta completa, e fazer com que seu agente de codificação transforme toda a requisição em um teste de CLI do Apidog para que ele sobreviva à próxima troca de modelo.
Resumo
A Cerebras concede a novas contas uma camada Free Trial: US$ 5 em créditos que expiram 30 dias após serem concedidos, limitados a dois modelos (gpt-oss-120b e qwen-3.8-27b) a 5 requisições por minuto e 30K tokens não armazenados em cache por minuto cada, de acordo com os limites de taxa publicados pela Cerebras. A API é compatível com OpenAI em https://api.cerebras.ai/v1, então você pode apontar um cliente OpenAI existente para ela e mudar três linhas. Abaixo, você vai construir uma requisição que mede o tempo até o primeiro token e os tokens por segundo por conta própria, em vez de confiar em uma página de marketing.
O que a camada gratuita documenta, e o que ela não documenta
A página de preços da Cerebras renderiza seus números no lado do cliente, o que significa que a taxa exata de dólares por milhão de tokens para uso pago não é algo que você consiga extrair de uma busca estática da página. Não adivinhe esse valor. Quando precisar dele, abra você mesmo a aba de faturamento do console do Cerebras Cloud, porque esse é o único lugar onde a taxa atual tem garantia de precisão.
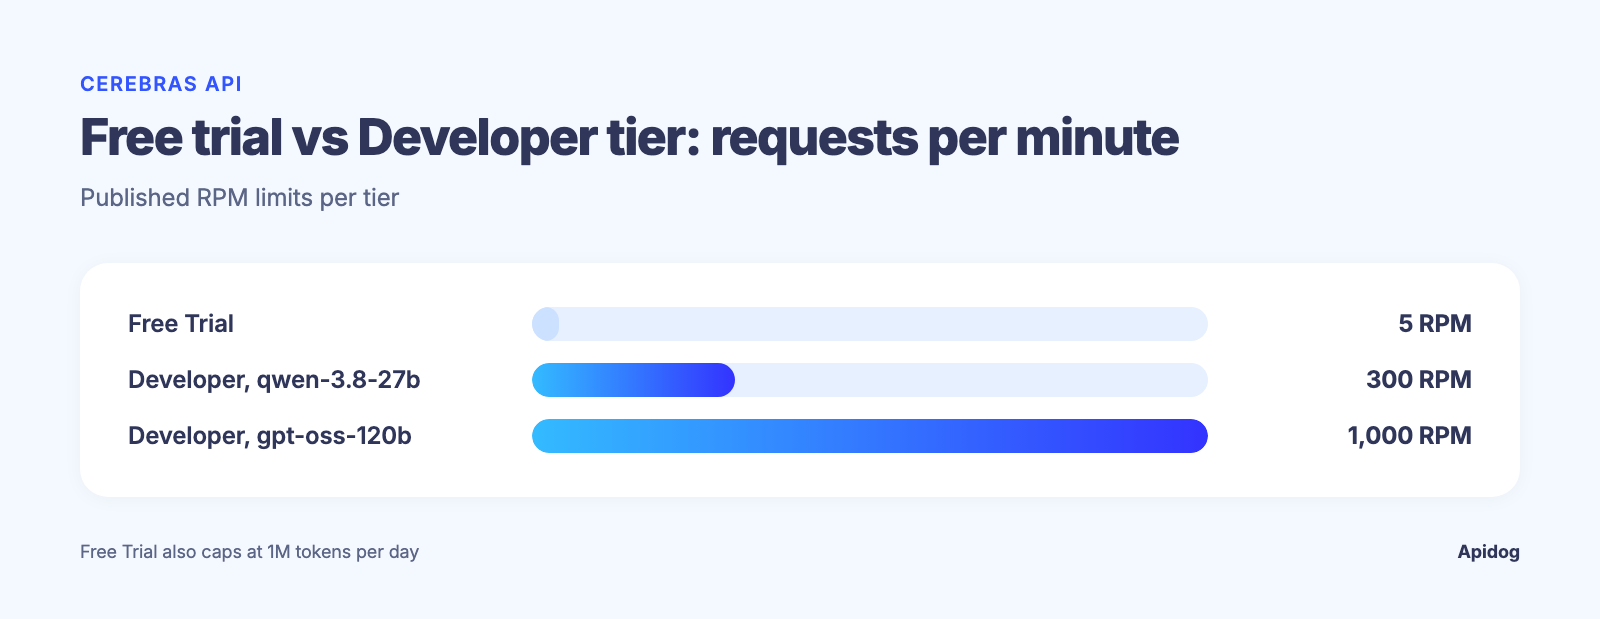
O que a documentação afirma claramente, na página de limites de taxa do suporte, é o formato da camada Free Trial:
| Camada | Modelos | RPM | TPM não armazenado em cache | TPM total | TPH | TPD |
|---|---|---|---|---|---|---|
| Free Trial | gpt-oss-120b, qwen-3.8-27b |
5 | 30K | 90K | 1M | 1M |
Developer (gpt-oss-120b) |
pagamento conforme o uso | 1,000 | 1M | 3M | nenhum | nenhum |
Developer (qwen-3.8-27b) |
pagamento conforme o uso | 300 | 150K | 450K | nenhum | nenhum |
Duas coisas importam aqui. Primeiro, “TPM não armazenado em cache” é o teto real: são tokens que precisam de computação total, e sua cota total de TPM é aproximadamente três vezes isso quando os acertos de cache são contados. Segundo, a conta Free Trial é limitada por crédito e por tempo, não por requisições para sempre: quando os US$ 5 acabarem ou 30 dias passarem, você cai para o que a camada da conta permitir até adicionar um método de pagamento. Tudo além desta tabela (preço por token, preço por assento, termos empresariais) fica atrás da página de preços renderizada por JavaScript e do console, não da documentação estática, então verifique lá antes de fazer orçamento com base nisso.
Se você já bateu em uma parede como essa em outro provedor, o padrão é o mesmo abordado em nosso guia sobre o que fazer quando você recebe uma resposta 429 rate-limit-exceeded: leia o corpo do erro, faça backoff e verifique o painel antes de presumir que a API está quebrada.
Obtenha uma chave e faça uma chamada real
Cadastre-se em cloud.cerebras.ai, abra API Keys e gere uma. O próprio quickstart da Cerebras orienta a defini-la como variável de ambiente para que ela nunca entre manualmente no corpo de uma requisição:
export CEREBRAS_API_KEY="your-key-here"
A URL base é https://api.cerebras.ai/v1, e o endpoint de conclusões de chat corresponde diretamente ao formato da OpenAI: POST /v1/chat/completions com um model e um array messages. Essa compatibilidade está documentada na referência da API, e é a razão pela qual você pode encaixar a Cerebras em código escrito para a biblioteca cliente da OpenAI mudando a URL base e a chave. Uma chamada curl bruta fica assim:
curl https://api.cerebras.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${CEREBRAS_API_KEY}" \
  -d '{
    "model": "qwen-3.8-27b",
    "messages": [
      {"role": "user", "content": "Explain time-to-first-token in two sentences."}
    ]
  }'
Execute, e a resposta traz mais do que o texto da conclusão. Ela inclui um bloco usage (prompt_tokens, completion_tokens, total_tokens) e um bloco time_info (queue_time, total_time) que a Cerebras retorna em todas as chamadas.
Se sua equipe está testando mais de um modelo ou provedor, este é um bom momento para parar de depender de comandos curl avulsos. A seção do Apidog CLI abaixo faz seu agente de codificação transformar esta chamada em um teste que ele reexecuta sempre que a Cerebras adiciona um modelo ou muda um limite.
Meça a alegação de velocidade: tempo até o primeiro token e tokens por segundo
Dois números dizem se “rápido” é real para sua carga de trabalho: tempo até o primeiro token (TTFT) e tokens gerados por segundo. Nenhum dos dois aparece como métrica de destaque na resposta da API, então você os calcula a partir do que a chamada fornece.
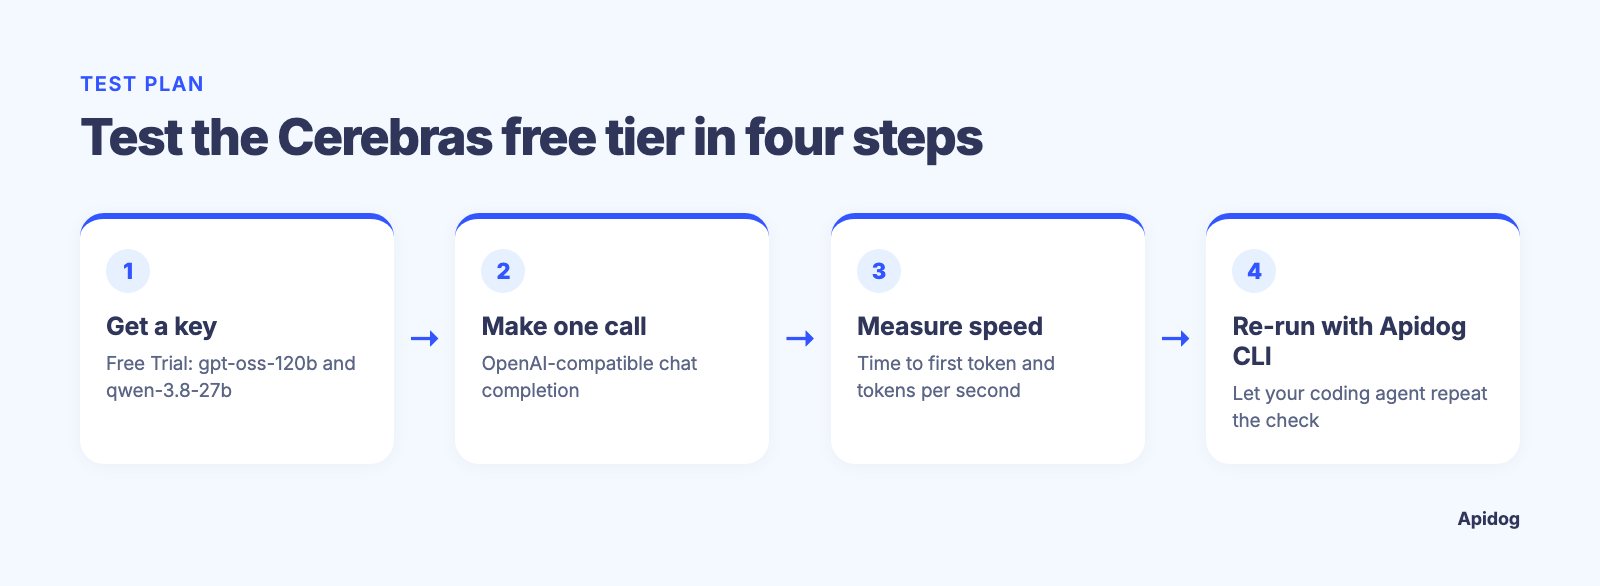
Para o TTFT, transmita a resposta e registre o intervalo de tempo real entre enviar a requisição e receber o primeiro chunk:
import time
from cerebras.cloud.sdk import Cerebras

client = Cerebras()
start = time.perf_counter()
first_token_at = None

stream = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Write a haiku about wafer-scale chips."}],
    stream=True,
)

for chunk in stream:
    if first_token_at is None and chunk.choices[0].delta.content:
        first_token_at = time.perf_counter() - start
        print(f"Time to first token: {first_token_at:.3f}s")
Para tokens por segundo, use uma chamada sem streaming e divida os tokens de conclusão pelo total_time que a Cerebras informa em time_info:
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Explain the CS-3 wafer-scale engine in 100 words."}],
)

tokens = response.usage.completion_tokens
seconds = response.time_info.total_time
print(f"{tokens / seconds:.1f} tokens/sec")
Execute isso algumas vezes, em horários diferentes, com um prompt próximo do que seu produto envia. Mantenha os dois scripts por perto e reexecute-os sempre que a Cerebras adicionar um modelo à camada gratuita, porque o número de tokens por segundo muda por modelo, não apenas por provedor.
Leia os limites antes que eles leiam você
O design de limites de taxa da Cerebras tem uma sutileza que vale conhecer antes de scriptar qualquer coisa: ele rastreia dois buckets de tokens separados por organização, TPM não armazenado em cache e TPM total, e aplica ambos ao mesmo tempo. Uma rajada de prompts curtos e repetitivos pode atingir o teto de requisições por minuto antes de chegar perto do teto de tokens, exatamente a armadilha descrita em nosso artigo mais amplo sobre como funciona a limitação de taxa de API.
Uma lacuna honesta na documentação: a Cerebras não publica um conjunto de cabeçalhos de resposta x-ratelimit-* como alguns provedores fazem. A referência da API não lista nenhum, e a página de limites de taxa também não. Isso é diferente da própria API de conclusões de chat da OpenAI, que retorna cabeçalhos de cota restante em todas as chamadas, um padrão que nosso guia de limites de taxa da OpenAI cobre em mais detalhes. Com a Cerebras, os dois lugares para verificar sua situação real são a seção Limits do console do Cloud e o corpo de uma resposta 429, que informa se você excedeu o teto de tokens não armazenados em cache ou o teto total de tokens. Construa sua lógica de repetição em torno desse corpo de erro em vez de presumir que um cabeçalho avisará primeiro.
Deixe seu agente de codificação reexecutar isso com o Apidog CLI
Uma medição em um arquivo temporário não prova nada no mês que vem. Faça seu agente de codificação transformar a chamada em um teste que ele possa reexecutar pelo Apidog CLI. Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
O token vem do Apidog em Account Settings, API Access Token. Depois, dê ao agente um prompt:
Use Apidog CLI on project <id>. Create a Cerebras environment with base URL
https://api.cerebras.ai/v1 and add POST /chat/completions with Bearer auth from
{{CEREBRAS_API_KEY}} and model set to {{MODEL}}. Create a test case asserting
status 200 and time_info.total_time under {{MAX_TOTAL_TIME}}, run it for
gpt-oss-120b and qwen-3.8-27b, and report completion tokens per second for each.
Os comandos que ele executa, verificados contra o Apidog CLI 2.2.7:
apidog environment create Cerebras --project <id> --base-url https://api.cerebras.ai/v1
apidog endpoint create --project <id> --file cerebras-chat.json
apidog cli-schema validate test-case-create --file speed-case.json
apidog test-case create --project <id> --file speed-case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d models.csv \
  --delay-request 12000 --env-var "CEREBRAS_API_KEY=$CEREBRAS_API_KEY" -r cli,json
models.csv contém uma coluna MODEL, então uma única execução cobre ambos os modelos, e qualquer coisa que a Cerebras lançar em seguida é só mais uma linha. --delay-request 12000 espaça as chamadas em 12 segundos para ficar abaixo das 5 requisições por minuto do Free Trial. Para o caminho 429, peça um segundo caso que deliberadamente ultrapasse esse limite e faça asserções sobre o corpo do erro, para que ele seja capturado e versionado em vez de redescoberto em produção. Isso é um fluxo de trabalho, não um benchmark único; veja nossa seleção de ferramentas de teste de API criadas para cargas de trabalho de agentes e LLMs se estiver comparando opções, e Apidog CLI no Claude Code para o lado do agente.
Camada gratuita ou Developer: quando migrar
A camada Free Trial foi feita exatamente para o que este guia percorre: confirmar a alegação de velocidade e o formato da requisição antes de comprometer um cartão. Quando você estiver construindo de verdade sobre a Cerebras, o salto da camada Developer, de 5 RPM para 1.000 RPM em gpt-oss-120b, é o número que normalmente força a decisão, não o preço por token. Se seu volume de prompts for em rajadas em vez de constante, compare os números da Cerebras com alternativas antes de se comprometer; nossa lista de alternativas ao OpenRouter e nosso tutorial da camada gratuita da API da Groq valem ser lidos lado a lado com a tabela acima, já que a velocidade de inferência e os tetos da camada gratuita variam mais entre provedores do que a maioria dos posts de comparação admite. Uma diferença que vale conhecer antes de escolher: a Groq documenta limites por modelo do plano gratuito diretamente, por exemplo openai/gpt-oss-120b a 30 RPM, 1.000 RPD, 8K TPM e 200K TPD, e retorna cabeçalhos de resposta x-ratelimit-* em todas as chamadas, então você sempre sabe seu orçamento restante pela própria resposta. A Cerebras não oferece nenhum dos dois; você lê sua situação no console do Cloud ou infere pelo corpo de um 429, como abordado acima.
Perguntas frequentes
A camada gratuita da Cerebras exige cartão de crédito? A camada Free Trial é baseada em crédito (US$ 5, expirando após 30 dias) em vez de um plano gratuito recorrente, e a própria documentação da Cerebras direciona você ao console do Cloud para os requisitos atuais de cadastro, já que esse detalhe pode mudar independentemente da documentação estática.
Quais modelos estão disponíveis na camada gratuita? De acordo com a documentação atual de limites de taxa, dois: gpt-oss-120b e qwen-3.8-27b. Ambos compartilham os mesmos limites do Free Trial (5 RPM, 30K TPM não armazenado em cache).
Posso usar meu código existente do SDK da OpenAI com a Cerebras? Sim. Aponte a URL base do cliente para https://api.cerebras.ai/v1 e troque pela sua chave da Cerebras; o formato de /v1/chat/completions corresponde, segundo a referência da API.
Por que recebi um 429 mesmo estando abaixo do meu orçamento de tokens? A Cerebras aplica TPM não armazenado em cache, TPM total e RPM como tetos separados. Uma sequência de requisições pequenas pode acionar o limite de RPM bem antes de qualquer bucket de tokens encher, que é o mesmo modo de falha abordado em nosso guia de solução de problemas de rate-limit-exceeded.
Como verifico meu uso atual sem bater em uma parede primeiro? A Cerebras não retorna cabeçalhos de resposta com cota restante, então verifique diretamente a seção Limits no console do Cloud em vez de inferi-la pelas respostas da API. O plano gratuito da Groq adota a abordagem oposta e retorna cabeçalhos x-ratelimit-* em todas as chamadas, então pondere essa diferença se monitoramento baseado em cabeçalhos for importante para sua configuração.
A vantagem real da Cerebras aparece no bloco time_info das suas próprias chamadas, não em uma manchete de marketing.