
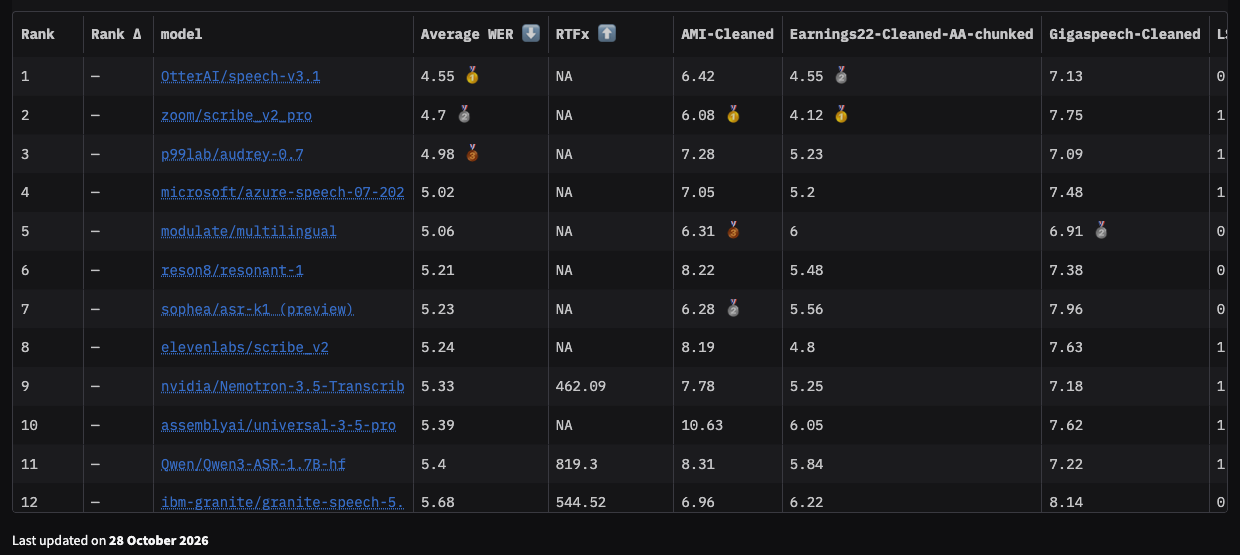
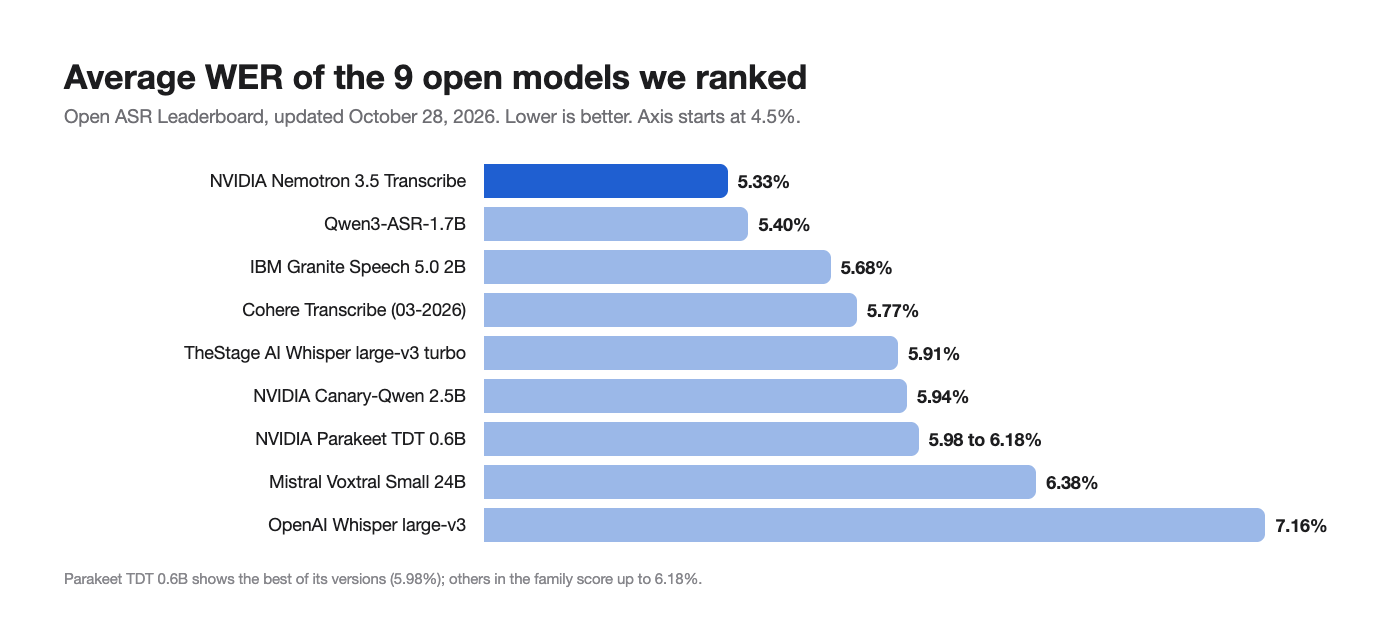
O melhor modelo open-source de fala para texto em outubro de 2026 é o Nemotron 3.5 Transcribe da NVIDIA, lançado em 28 de outubro. No Hugging Face Open ASR Leaderboard atualizado no mesmo dia, ele tem média de 5,33% de taxa de erro de palavra e ocupa a 9ª posição entre 61 modelos. Todos os oito modelos acima dele são APIs comerciais fechadas. O whisper-large-v3 da OpenAI, ainda o padrão em muitos tutoriais, está em 41º lugar com 7,16%.
Abaixo estão os nove modelos de reconhecimento de fala com pesos abertos que vale a pena considerar agora, classificados por esse leaderboard, com velocidade, pontos fortes e a tarefa para a qual cada um se adequa. Todos os números de WER e velocidade vêm do leaderboard conforme lido em 29 de outubro de 2026.
Se você está escolhendo entre APIs hospedadas, leia nosso guia da API Nemotron 3.5 Transcribe e o guia da API Whisper.
Como os classificamos
O Open ASR Leaderboard executa todos os modelos nos mesmos conjuntos de teste em inglês: reuniões (AMI), chamadas de resultados (Earnings22), podcasts e YouTube (GigaSpeech), audiolivros (LibriSpeech), chamadas financeiras (SPGISpeech), fala com ruído (URGENT24), áudio conversacional (Voice Arena Monsoon), discursos parlamentares (VoxPopuli) e dois conjuntos privados. A métrica de classificação é o WER médio, em que menor é melhor.
Também listamos RTFx, a medida de velocidade do leaderboard: segundos de áudio transcritos por segundo de computação. Quanto maior, mais rápido. APIs fechadas mostram “NA” porque não podem ser cronometradas no mesmo hardware.
Consideramos um modelo como de pesos abertos quando seu checkpoint é baixável e o leaderboard informa um RTFx para ele. Verifique cada licença antes do uso comercial.
O ranking em resumo
| Classificação (aberto) | Modelo | WER médio | RTFx | Classificação geral |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5,33% | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5,40% | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5,68% | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5,77% | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5,91% | 1.177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5,94% | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B (versões) | 5,98% a 6,18% | não comparado | 24 a 31 |
| 8 | Mistral Voxtral Small 24B | 6,38% | não comparado | 35 |
| 9 | OpenAI Whisper large-v3 | 7,16% | não comparado | 41 |
Para contexto, as melhores APIs fechadas no mesmo leaderboard: Otter speech-v3.1 com 4,55%, Zoom Scribe v2 Pro com 4,70%, ElevenLabs Scribe v2 com 5,24%, AssemblyAI Universal-3.5 Pro com 5,39% e OpenAI gpt-transcribe com 5,96%. O Nemotron 3.5 Transcribe supera a AssemblyAI e o modelo hospedado da OpenAI, além de ser gratuito para download.
1. NVIDIA Nemotron 3.5 Transcribe: melhor no geral
5,33% WER, RTFx 462, licença OpenMDW-1.1
O novo modelo da NVIDIA não é uma rede ASR clássica. É um modelo de linguagem aumentado por fala: um codificador ASR de 600M de parâmetros e um codificador de falante alimentam um LLM híbrido de mistura de especialistas Mamba-2 e Transformer com 34B no total e cerca de 4,3B de parâmetros ativos. Esse design é o motivo pelo qual ele faz mais do que transcrever.
Por que ele ocupa o primeiro lugar:
- 40 idiomas, com 13 avaliados como “líderes”
- Arquivos de uma hora em uma única passada, com contexto de 65.536 tokens
- Atribuição de falante (até oito falantes) e timestamps de palavras em um único modelo
- Prompts: texto literal ou limpo, termos de contexto para jargão, tradução
- Precisão em áudio longo: 10,98% de WER médio nos conjuntos de áudio longo do leaderboard, contra 13,37% do Parakeet-TDT-0.6B-v3, segundo a ficha do modelo
- Reuniões: 15,80% de cpWER médio em conjuntos com vários falantes, à frente do pipeline DiCoW mais DiariZen com 16,83%
Desvantagens: precisa de uma GPU grande (uma H100 de 80 GB em BF16, ou uma RTX 5090 com pesos NVFP4), não faz streaming, e a resposta a perguntas sobre áudio é apenas em inglês.
Escolha-o para: reuniões, podcasts, chamadas de resultados, arquivos multilíngues e qualquer coisa em que rótulos de falante ou arquivos de uma hora importem. Comece com as rotas gratuitas ou execute-o localmente.
2. Qwen3-ASR-1.7B: melhor precisão por dólar de GPU
5,40% WER, RTFx 819
O Qwen3-ASR-1.7B da Alibaba fica apenas 0,07 pontos atrás do Nemotron na média em inglês, enquanto roda cerca de 1,8 vez mais rápido no hardware do leaderboard, a partir de um modelo com um vigésimo do tamanho total. Na própria comparação multilíngue de sete idiomas da NVIDIA, o Nemotron lidera com mais clareza: 4,62% de WER médio contra 6,49%.
Escolha-o para: transcrição em lote com predominância de inglês em GPUs menores, quando você não precisa de atribuição de falante integrada. Se você já usa os modelos multimodais da Qwen, veja nosso guia sobre Qwen3.5-Omni.
3. IBM Granite Speech 5.0 2B: melhor em áudio de reunião para seu tamanho
5,68% WER, RTFx 545
O Granite Speech 5.0 da IBM registra 6,96% de WER em gravações de reuniões AMI, a melhor pontuação AMI entre os seis principais modelos abertos aqui e melhor que os 7,78% do Nemotron nesse conjunto. Seu ponto fraco são as chamadas financeiras SPGISpeech, com 3,36%.
Escolha-o para: equipes empresariais que estão padronizando na stack Granite da IBM, e transcrição de reuniões em GPUs de médio porte.
4. Cohere Transcribe: rápido e preciso
5,77% WER, RTFx 902
O modelo de transcrição da Cohere Labs de março de 2026 combina uma pontuação de precisão aberta entre as cinco melhores com uma das maiores velocidades daqui. Ele é mais forte no LibriSpeech (0,97% limpo, 2,05% outros) e mais fraco no VoxPopuli, com 5,38%.
Escolha-o para: pipelines em inglês de alto volume, em que a taxa de transferência importa tanto quanto a precisão.
5. TheStage AI Whisper large-v3 turbo: o mais rápido da categoria principal
5,91% WER, RTFx 1.177
Esta é uma versão otimizada do Whisper large-v3 turbo da TheStage AI, e é o modelo mais rápido da nossa lista. Ele marca 1,62% no SPGISpeech, a terceira melhor pontuação nesse conjunto entre todos os 61 modelos. Isso mostra quanta vida a família Whisper ainda tem quando alguém a ajusta.
Escolha-o para: equipes com código Whisper existente que querem uma atualização de velocidade e precisão sem grandes mudanças.
6. NVIDIA Canary-Qwen 2.5B: o antigo carro-chefe da NVIDIA
5,94% WER, RTFx 862
O Canary-Qwen era o modelo anterior de fala mais LLM da NVIDIA, e o Nemotron 3.5 Transcribe o substitui no topo. Ele ainda é rápido, e sua pontuação de 1,70% no SPGISpeech é excelente. No teste preference-ASR da NVIDIA, o Nemotron marca 7,56% contra 8,16% do Canary-Qwen.
Escolha-o para: implantações NeMo existentes que ainda não podem migrar para uma GPU de 80 GB.
7. NVIDIA Parakeet TDT 0.6B: menor opção séria
5,98% a 6,18% de WER entre as versões
O Parakeet TDT tem várias versões de 0,6B de parâmetros no leaderboard, todas dentro de cerca de 0,2 ponto entre si. Com 600M de parâmetros, é o menor modelo aqui que se mantém perto de 6% de WER, então roda em GPUs modestas. Sua fraqueza é áudio longo, em que o Nemotron o supera por mais de dois pontos.
Escolha-o para: dispositivos de borda, GPUs baratas e clipes curtos, como comandos de voz ou trechos de chamadas.
8. Mistral Voxtral Small 24B: fala mais um LLM forte
6,38% WER
O Voxtral Small combina entrada de fala com um modelo de linguagem Mistral de 24B, então, como o Nemotron, ele pode responder perguntas sobre áudio, não apenas transcrevê-lo. Ele fica atrás dos cinco primeiros em WER puro. Nossa análise comparativa Voxtral vs. Whisper cobre seu lançamento anterior em profundidade.
Escolha-o para: assistentes de voz e Q&A de áudio em que o modelo de linguagem importa mais do que o último ponto de WER.
9. OpenAI Whisper large-v3: a linha de base
7,16% WER, 41º no geral
O Whisper large-v3 ainda é o modelo aberto mais amplamente implantado, com o maior ecossistema de wrappers, fine-tunes e tutoriais. Em precisão, agora fica atrás de todos os outros modelos desta lista. Se você o executa em produção, mudar para qualquer um dos seis primeiros é a atualização de qualidade mais barata disponível.
Escolha-o para: protótipos que dependem de ferramentas específicas do Whisper, ou como a linha de base a ser superada.
Qual deles você deve escolher?
| Sua tarefa | Escolha |
|---|---|
| Reuniões com vários falantes | Nemotron 3.5 Transcribe |
| Podcasts ou chamadas de uma hora em uma única passada | Nemotron 3.5 Transcribe |
| Arquivos multilíngues | Nemotron 3.5 Transcribe |
| Tarefas em lote em inglês em GPUs menores | Qwen3-ASR-1.7B |
| Taxa de transferência máxima | TheStage Whisper large-v3 turbo ou Cohere Transcribe |
| Hardware de borda ou de baixo custo | Parakeet TDT 0.6B |
| Q&A de áudio mais transcrição | Nemotron 3.5 Transcribe ou Voxtral Small |
| Código Whisper existente, mudança mínima | TheStage Whisper large-v3 turbo |
Um alerta: as médias do leaderboard escondem lacunas de domínio. O Nemotron é melhor no geral, mas o Granite o supera no AMI e vários modelos o superam no LibriSpeech. Teste os dois ou três primeiros em 50 a 100 de suas próprias gravações antes de decidir.
Compare candidatos com seu agente de codificação e o Apidog CLI
A maneira mais rápida de fazer essa comparação é deixar seu agente de codificação fazer isso. Sirva dois ou três modelos por trás de endpoints /v1/audio/transcriptions no estilo OpenAI (o SGLang-Omni serve o Nemotron dessa forma) e, em seguida, peça ao agente para criar e executar as mesmas verificações em cada um com o Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao seu agente um prompt:
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
O agente lê o schema, valida seu payload, escreve os casos e os executa por ambiente:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Pontue as transcrições salvas em relação ao seu texto de referência com qualquer script de WER, e mantenha a execução do ambiente vencedor na CI com -r junit. Veja Apidog CLI no Claude Code e Apidog CLI em um pipeline de CI/CD.
Perguntas frequentes
Qual é o modelo open-source de fala para texto mais preciso? NVIDIA Nemotron 3.5 Transcribe, com 5,33% de WER médio no Open ASR Leaderboard de 28 de outubro de 2026.
O Whisper ainda é bom? Ele funciona, mas o whisper-large-v3 está em 41º com 7,16%. Versões ajustadas do Whisper, como o large-v3 turbo da TheStage, marcam 5,91%.
Qual modelo aberto é o mais rápido? Entre os modelos aqui, o Whisper large-v3 turbo da TheStage AI, com RTFx de 1.177.
Os modelos abertos agora superam APIs pagas? Alguns. O Nemotron 3.5 Transcribe supera o AssemblyAI Universal-3.5 Pro (5,39%) e o OpenAI gpt-transcribe (5,96%). Otter, Zoom e ElevenLabs ainda lideram no geral. Para opções hospedadas, veja nossa seleção de APIs de fala para texto.
Qual oferece suporte a diarização de falantes? O Nemotron 3.5 Transcribe faz isso no mesmo modelo, com até oito falantes. A maioria dos outros precisa de uma etapa separada de diarização.
O veredito
Para a maioria das equipes no final de 2026, comece com o Nemotron 3.5 Transcribe se você tiver uma GPU de 80 GB ou puder pagar US$ 0,12 por hora em uma API hospedada. Escolha o Qwen3-ASR-1.7B quando o orçamento de GPU estiver apertado, e o Parakeet quando o hardware estiver ainda mais apertado. Independentemente do que escolher, teste no seu próprio áudio e deixe seu agente manter as verificações do Apidog em execução para que o modelo escolhido continue com bom desempenho após cada atualização.