
O melhor LLM para agentes de navegador em outubro de 2026 é o Claude Opus 5.5 se você quer a maior taxa de sucesso publicada, e o Claude Sonnet 5.5 se você quer quase a mesma pontuação pela metade do preço. Para orçamentos apertados, Claude Haiku 5.5 e Gemini 3.8 Flash custam uma fração por etapa. Para pesos abertos, o Holo4 da H Company é a escolha. Todos os números abaixo vêm da própria página do fornecedor, lida em 27 de outubro de 2026.
Resposta rápida: o melhor modelo para uso no navegador por tarefa
| Tarefa | Escolha | Por quê | Preço por 1M de tokens (entrada / saída) |
|---|---|---|---|
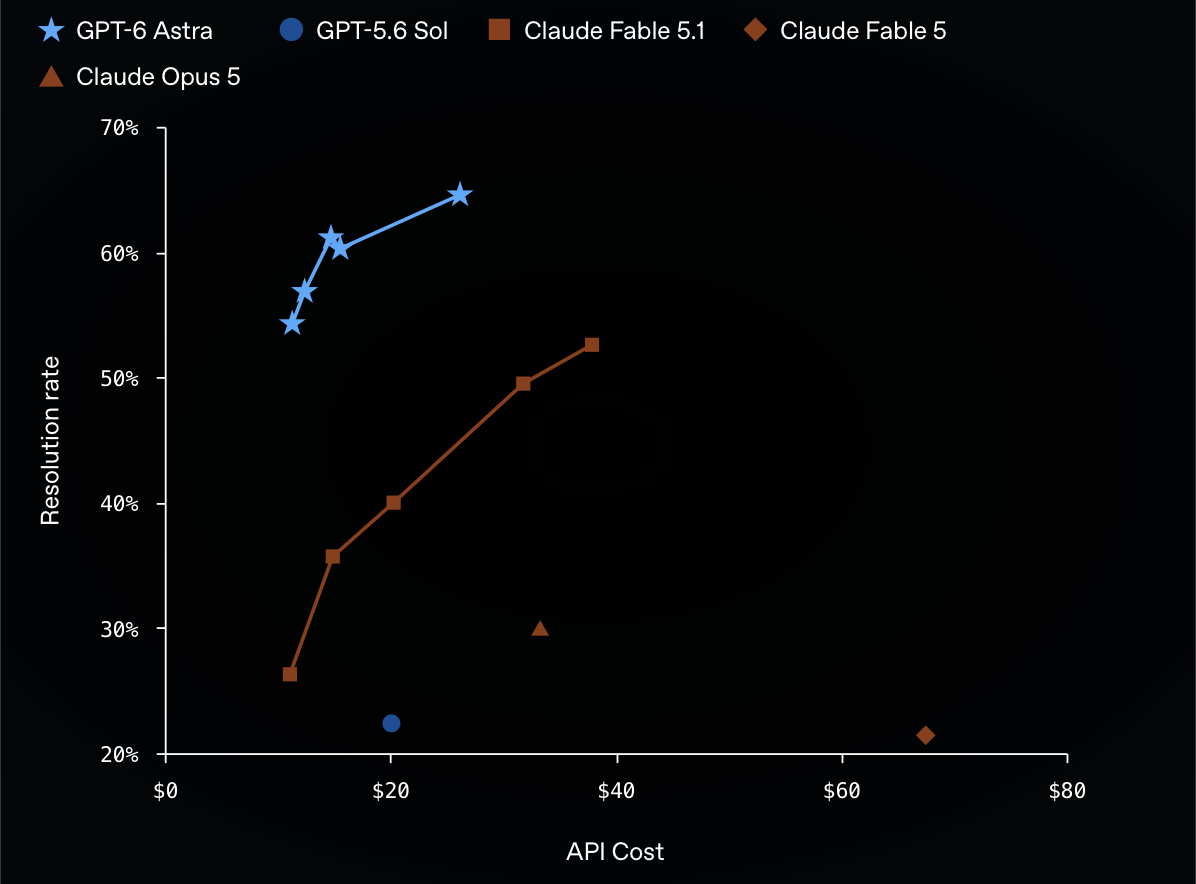
| Melhor pontuação | Claude Opus 5.5 | 81,8% no OSWorld 2.1 (pontuação parcial), conjunto de ferramentas de navegador nativo | $4 / $20 |
| Melhor custo-benefício | Claude Sonnet 5.5 | 80,1% no OSWorld 2.1 pela metade do preço do Opus | $2 / $10 |
| Melhor opção barata | Claude Haiku 5.5 | 72,4% no subconjunto offline do OSWorld 2.1 | $0.10 / $0.50 (prompts de até 100K) |
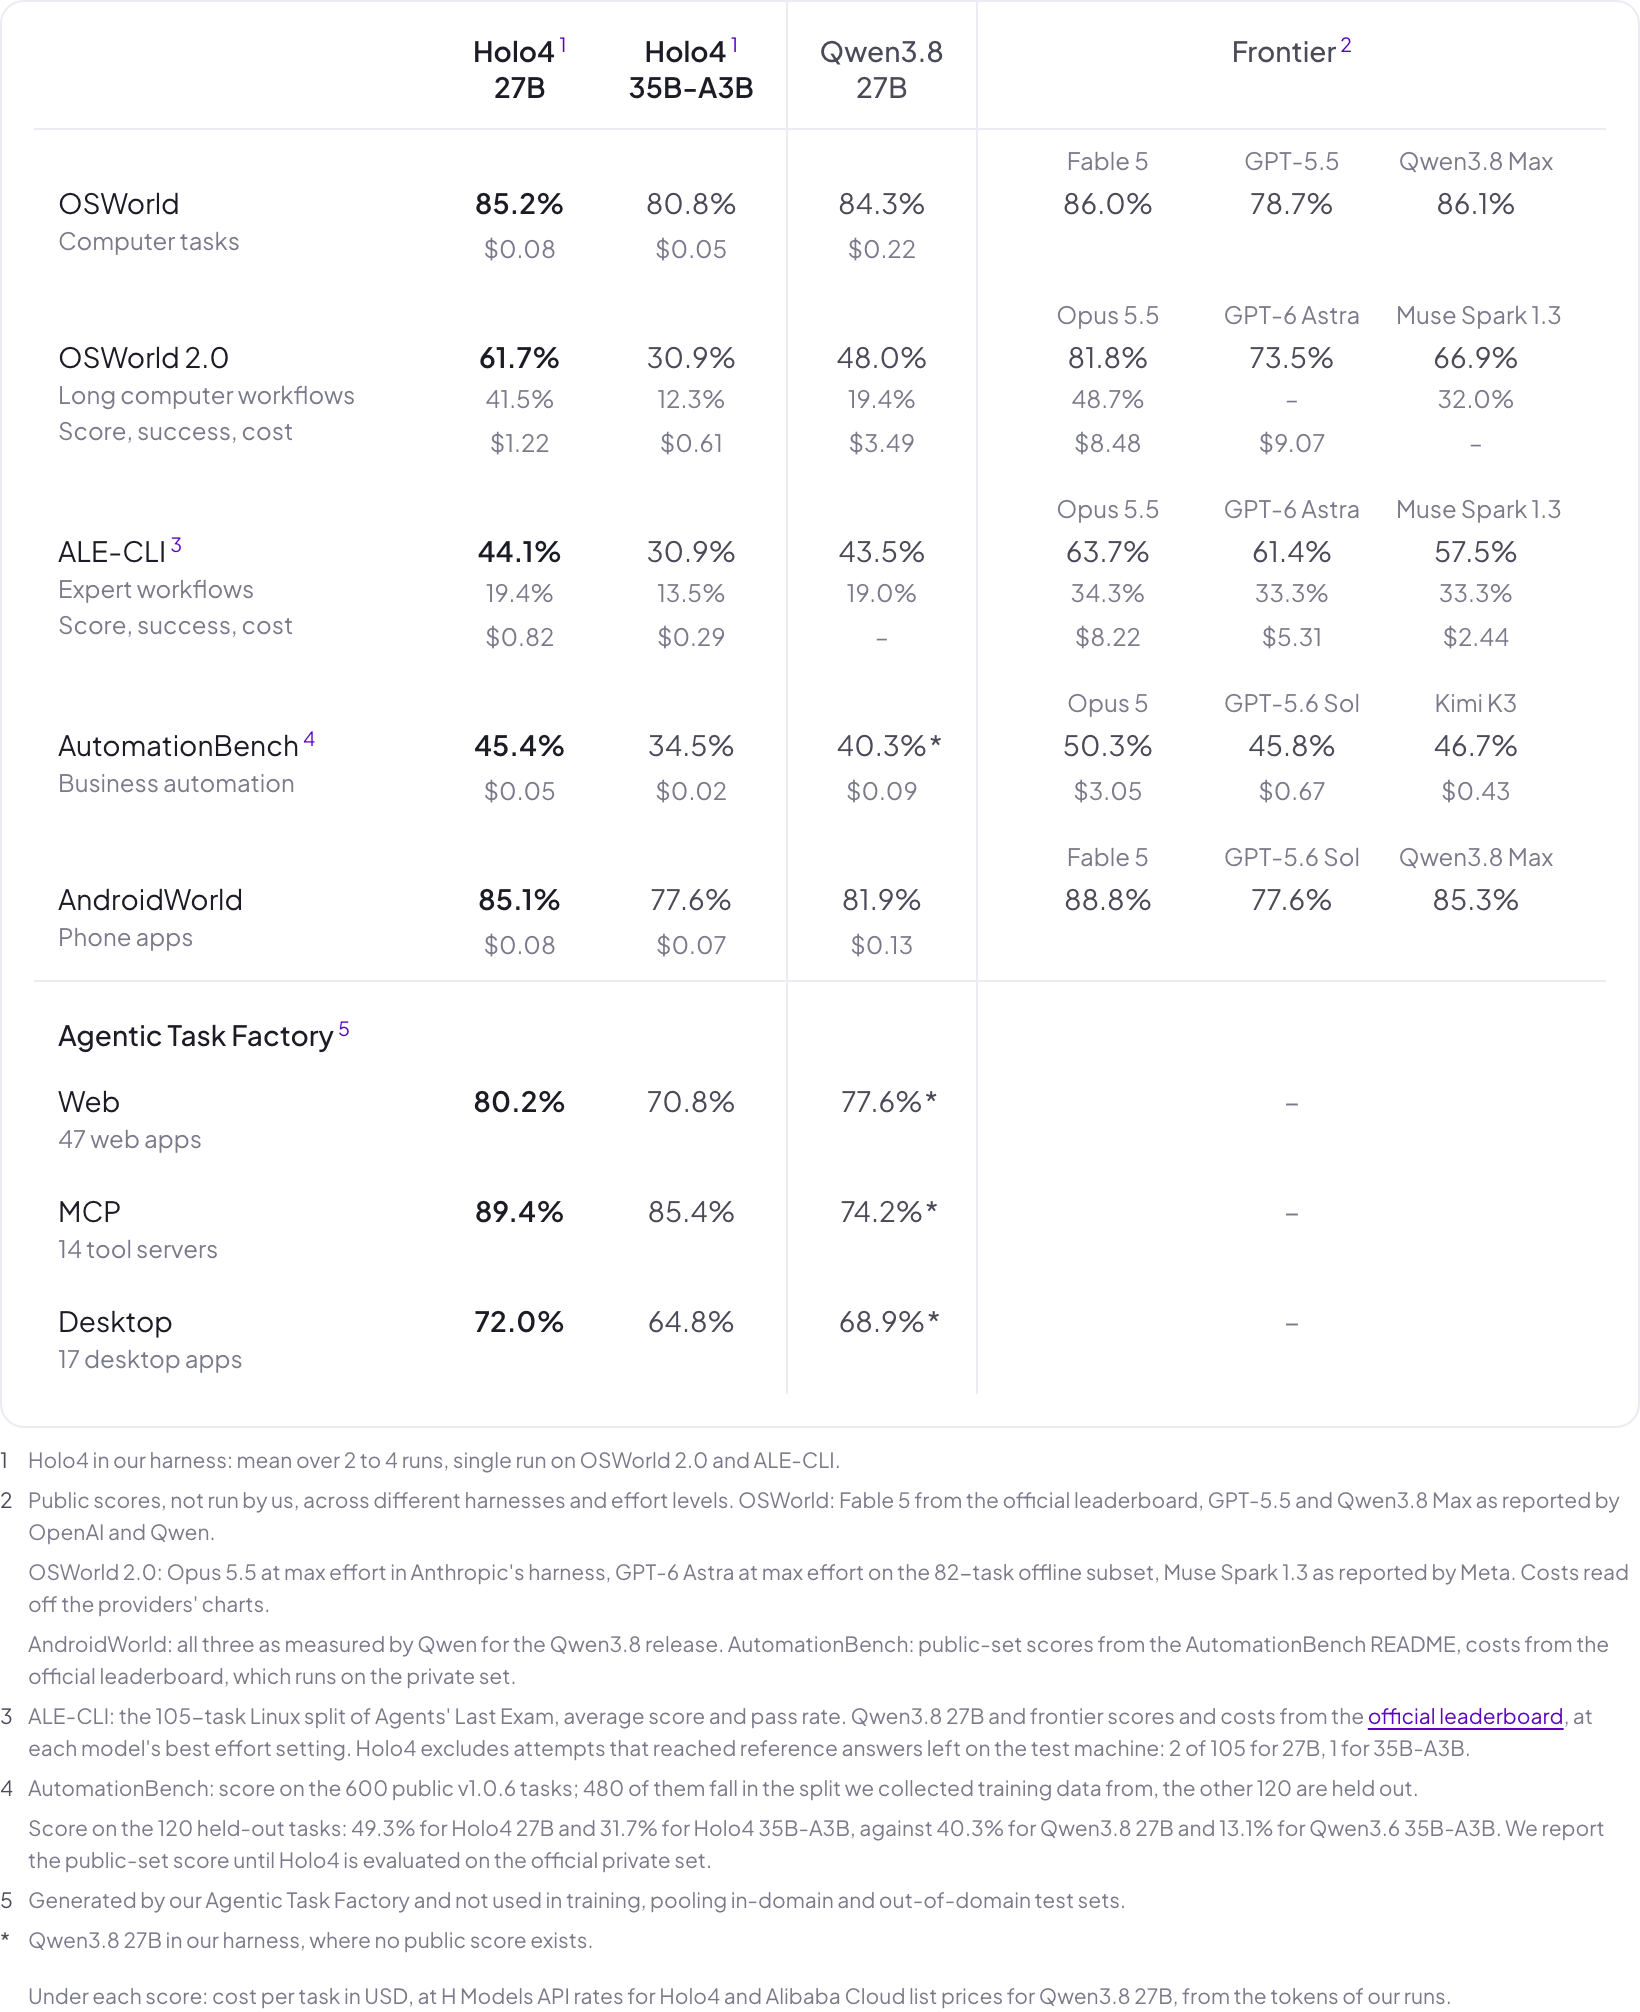
| Melhor com pesos abertos | Holo4 35B-A3B | Pesos Apache 2.0, 80,8% no OSWorld a $0.05 por tarefa (harness da H) | $0.30 / $2.00 na API da H |
| Melhor para navegação orientada por código | GPT-6 Astra | A OpenAI recomenda execução de código (Playwright) em vez de clicar | $10 / $50 |
| Melhor modo DOM barato | GPT-6.1 Terra | Suporta computer_use, contexto de 1,05M, entrada de texto e imagem |
$1 / $5 |
Um alerta: os fornecedores pontuam em versões, subconjuntos e harnesses diferentes do OSWorld, então trate cada número como uma alegação daquele fornecedor, não como um ranking compartilhado.
Como agentes de navegador usam um modelo
Um agente de navegador é um loop: o modelo olha a página, escolhe uma ação, seu código a executa, e o novo estado da página volta para o modelo. Uma tarefa humana de 2 minutos pode levar de 30 a 60 loops.
Os modelos veem a página de uma de duas maneiras:
- Modo captura de tela. O modelo recebe uma imagem e retorna coordenadas de pixel para clicar. Funciona em apps de canvas, mapas e áreas de trabalho remotas, mas cada etapa custa tokens de imagem.
- Modo DOM ou árvore de acessibilidade. O modelo recebe uma lista de texto de elementos com referências como
[ref_2]e clica por referência. Ele sobrevive a mudanças de layout e custa menos tokens em páginas com muito texto.
A maioria dos conjuntos de ferramentas atuais mistura os dois. A ferramenta de uso do navegador da Anthropic (browser_toolset_20260801, GA) traz 31 ferramentas membro: read_page e find retornam a árvore de acessibilidade, enquanto screenshot e zoom são o fallback para canvas, vídeo e iframes de origem cruzada. O guia de uso do computador da OpenAI oferece um BrowserToolset que lê o texto da página e chama funções de driver. A ferramenta de uso do computador do Google é baseada em captura de tela e cobre navegador, celular e desktop.
Por que as etapas multiplicam o custo
Cada etapa reenvia a conversa, então a etapa 30 carrega a definição do conjunto de ferramentas, suas instruções e 29 etapas de histórico. Dois custos fixos definem o piso:
- Sobrecarga do conjunto de ferramentas. Declarar o conjunto de ferramentas de navegador da Anthropic adiciona cerca de 6.600 tokens de entrada a cada requisição, segundo a página de preços da Anthropic.
- Capturas de tela. O Claude cobra uma imagem a um token visual por bloco de 28×28 pixels. Uma captura de tela de 1280×800 tem 46 × 29 = 1.334 tokens.
Notas modelo por modelo
Claude Opus 5.5
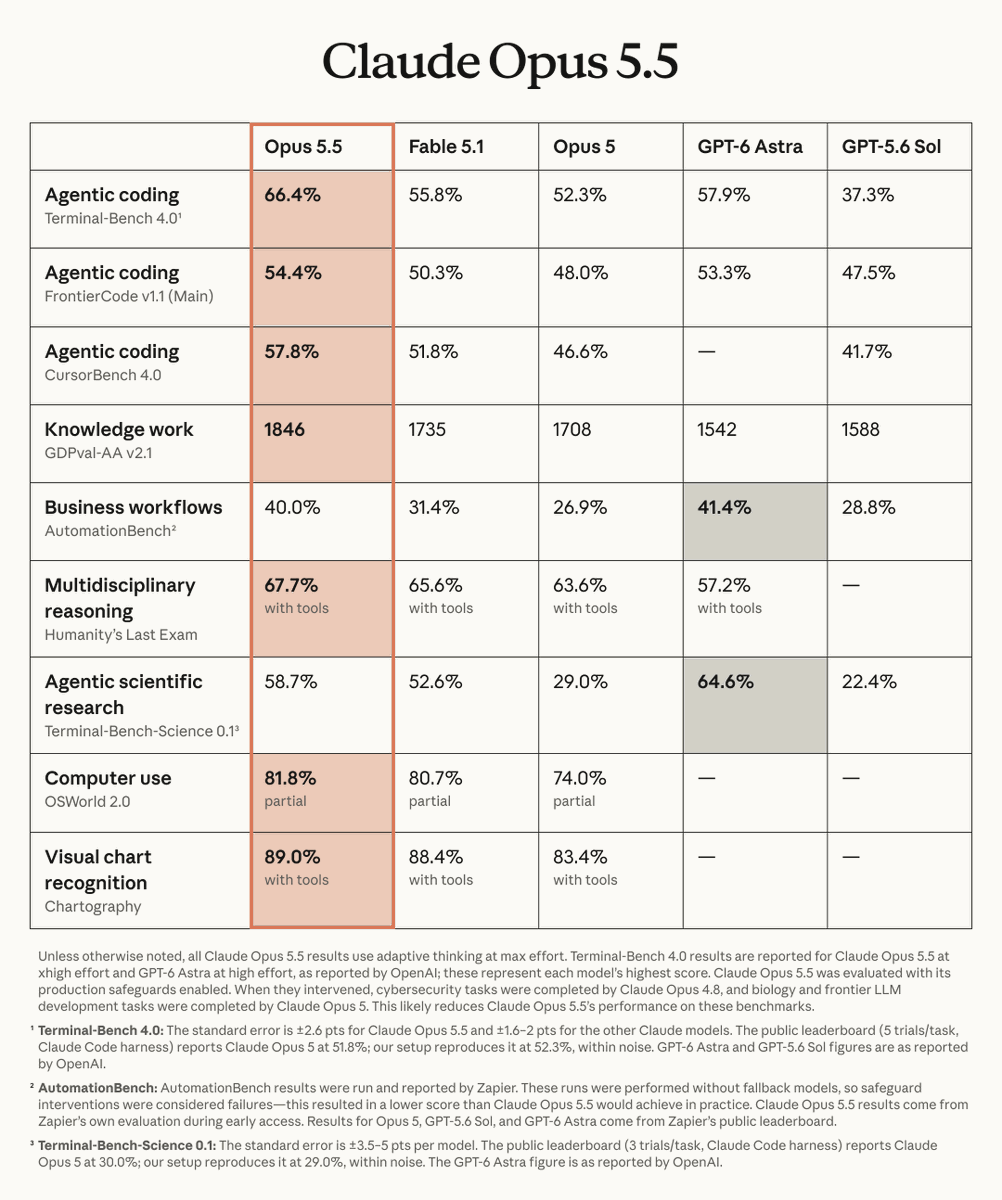
A Anthropic lançou o Opus 5.5 em 22 de setembro de 2026 e relata 81,8% no OSWorld 2.1 (pontuação parcial), à frente do Claude Fable 5.1 com 80,7%. O Fable 5.1 custa $10 / $50, então o Opus 5.5 o supera neste benchmark a 40% do preço. O post do Holo4 da H Company coloca o Opus 5.5 em 81,8% no OSWorld 2.0 para fluxos de trabalho longos a $8.48 por tarefa, com custos lidos dos gráficos dos provedores.
Ele também empata com o Fable 5.1 na menor taxa de sucesso de injeção de prompt no benchmark da Gray Swan, o que importa quando seu agente lê páginas não confiáveis.
Claude Sonnet 5.5
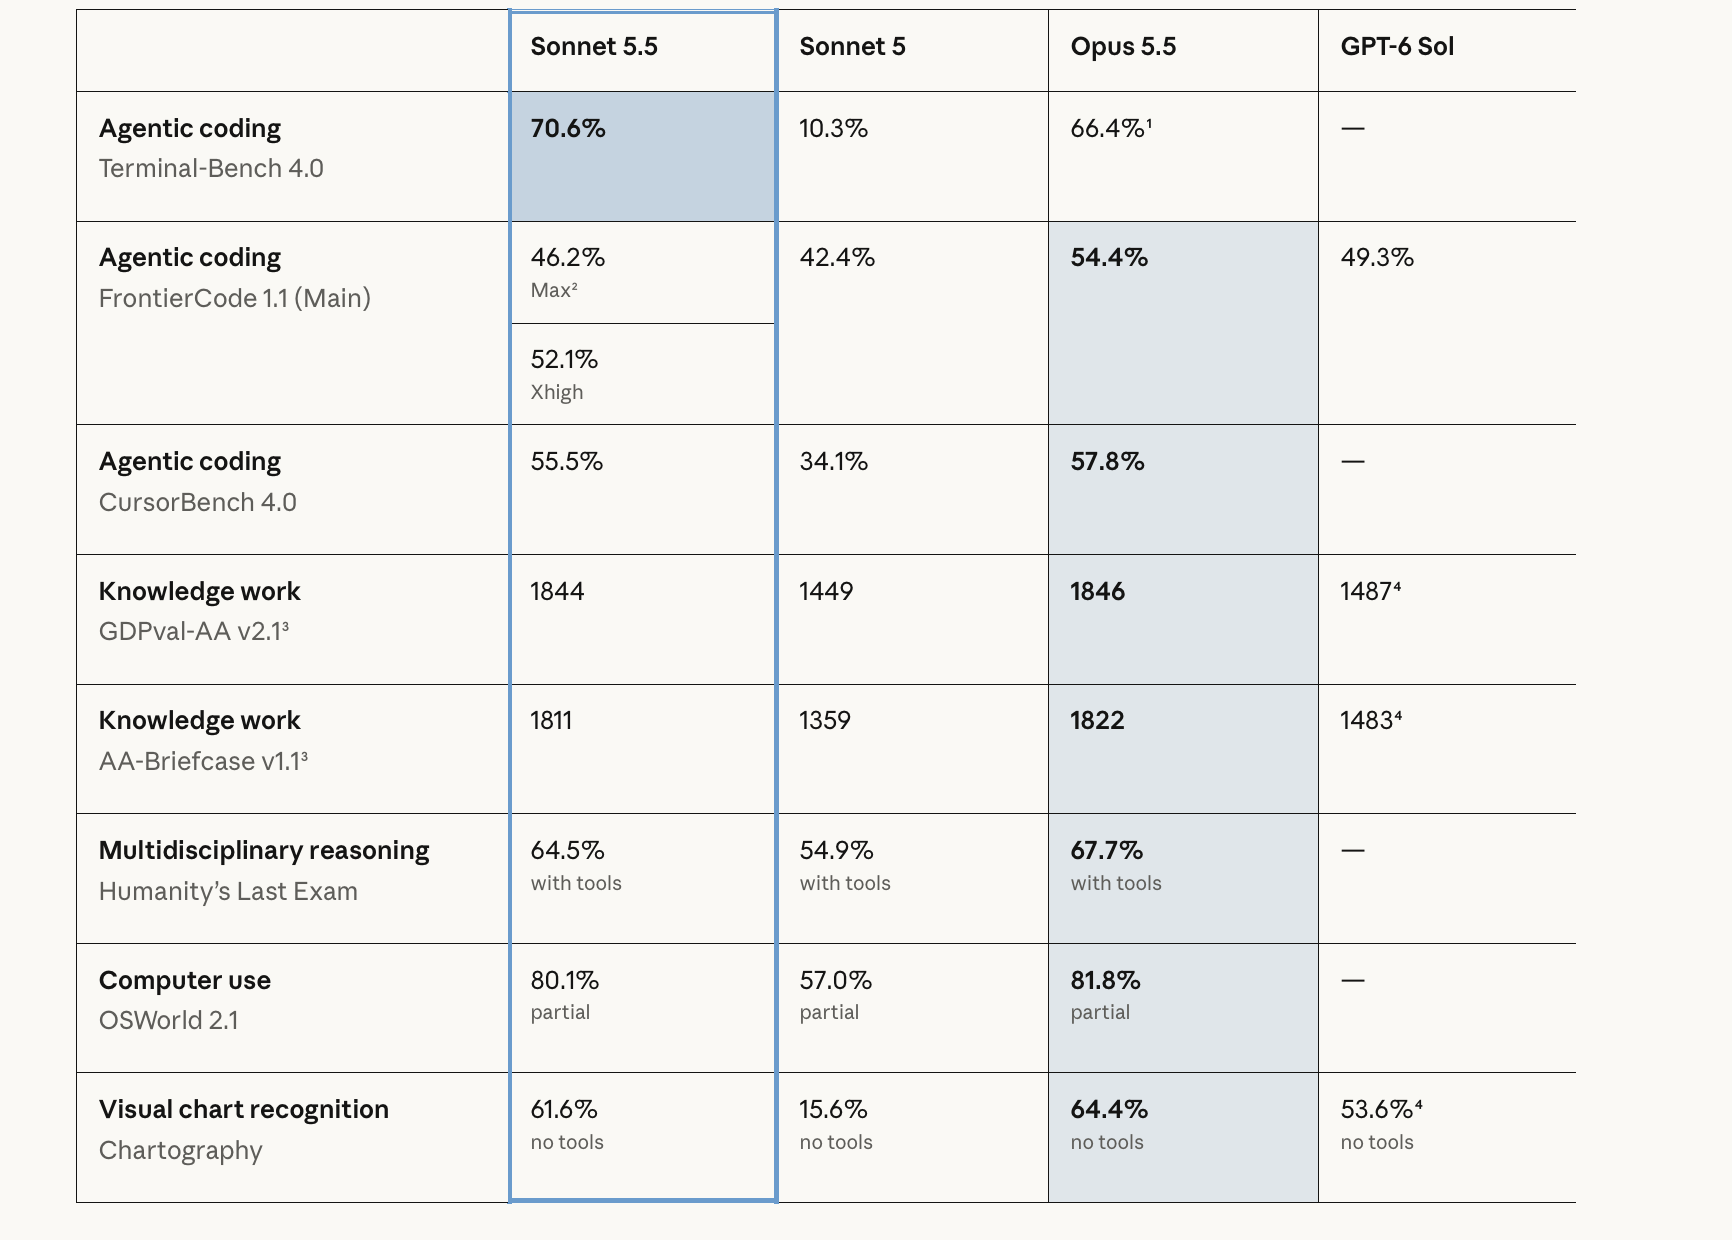
O Sonnet 5.5 (28 de setembro de 2026) pontua 80,1% no OSWorld 2.1, 1,7 ponto atrás do Opus, a $2 / $10. Acertos de cache custam $0.10 por 1M de tokens, e os loops de agente são majoritariamente acertos de cache. Para a maioria dos agentes de navegador em produção, esta é a escolha padrão. Se você controla o navegador pelo Claude Code, veja como usar o Claude Code para automação de navegador.
Claude Haiku 5.5
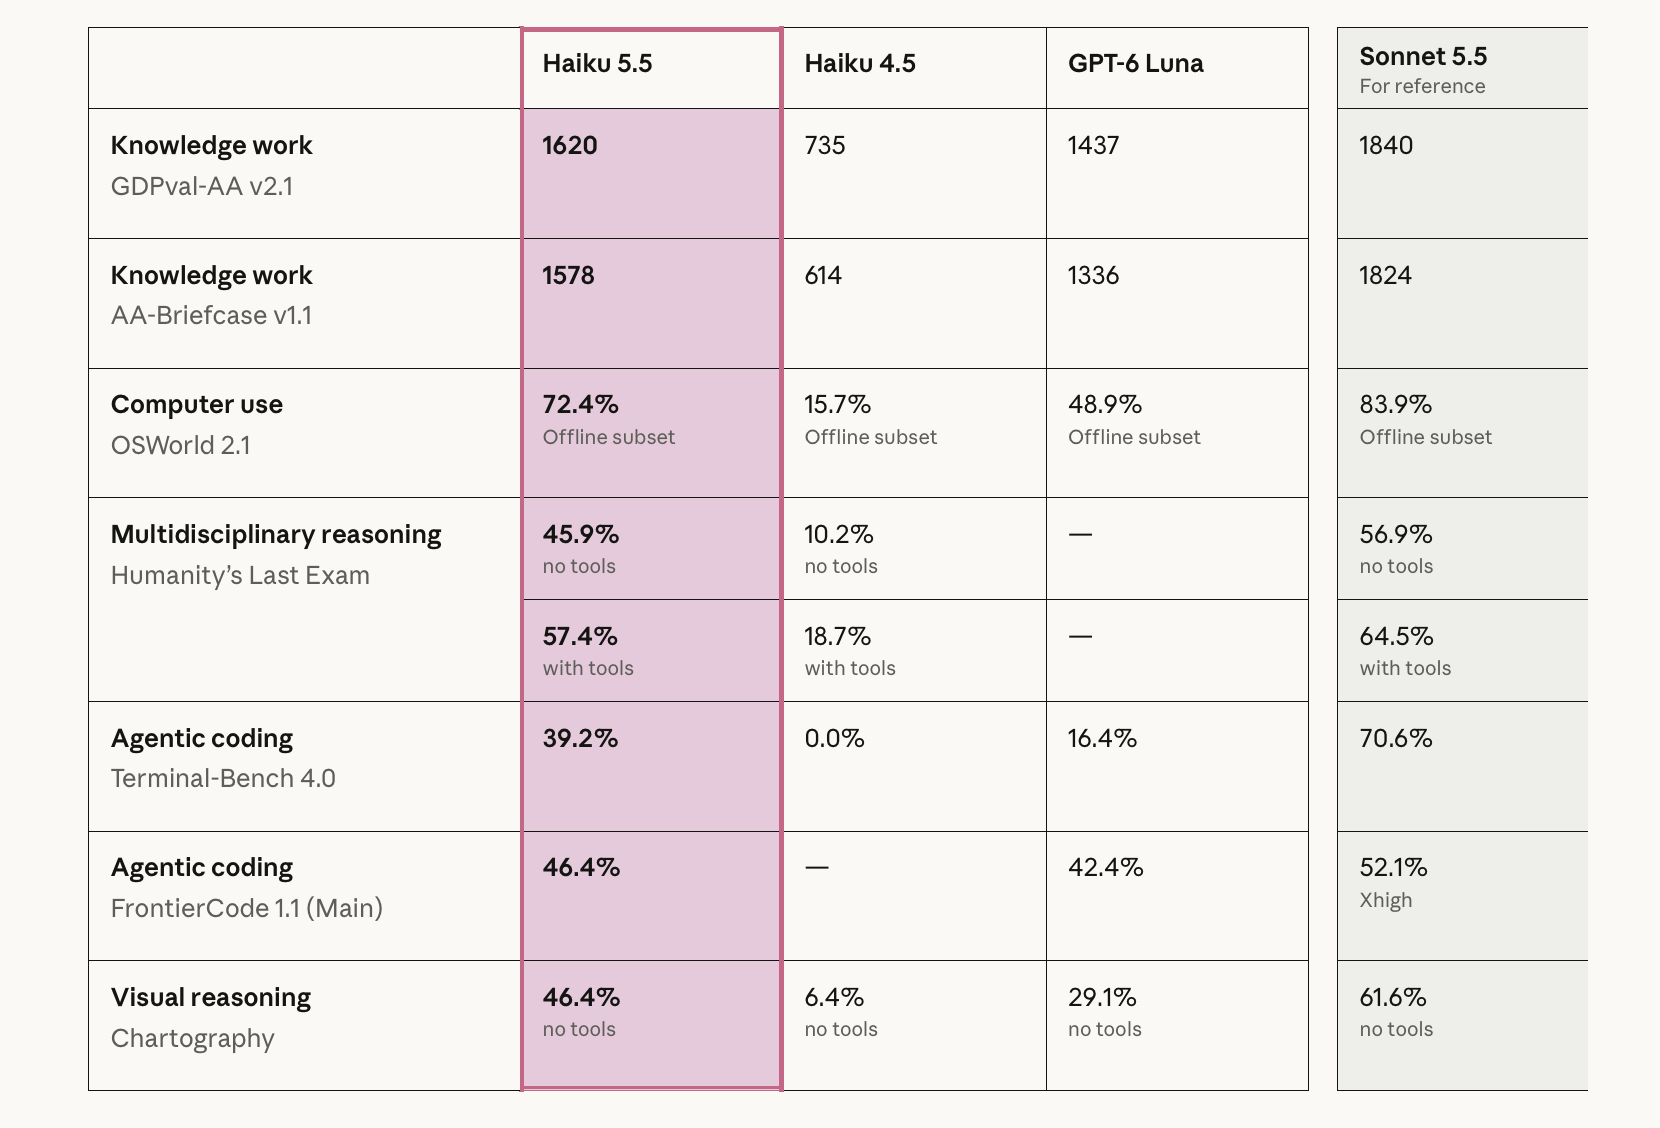
O Haiku 5.5 (7 de outubro de 2026) pontua 72,4% no subconjunto offline do OSWorld 2.1, onde a Anthropic lista o GPT-6 Luna com 48,9%. O preço tem duas faixas: $0.10 / $0.50 para prompts de até 100.000 tokens, depois $0.50 / $2.50 acima disso. Sessões longas que mantêm todas as capturas de tela no histórico passam de 100K rapidamente, então remova capturas de tela antigas para permanecer na faixa barata.
GPT-6 Astra
A ficha do modelo Gemini 4 Argon do Google lista o GPT-6 Astra com 72,6% no subconjunto offline do OSWorld 2.0 (pontuação parcial). O Astra custa $10 / $50 com uma janela de contexto de 1,05M. O guia da OpenAI diz que, para o Astra, recomenda execução de código: o modelo escreve código Playwright ou PyAutoGUI em vez de clicar uma etapa por vez. Isso serve para scraping repetitivo e trabalho com formulários. Nosso post sobre uso do computador do GPT-6 Astra cobre quando entregar uma especificação em vez disso.
GPT-6.1 Terra e Sol
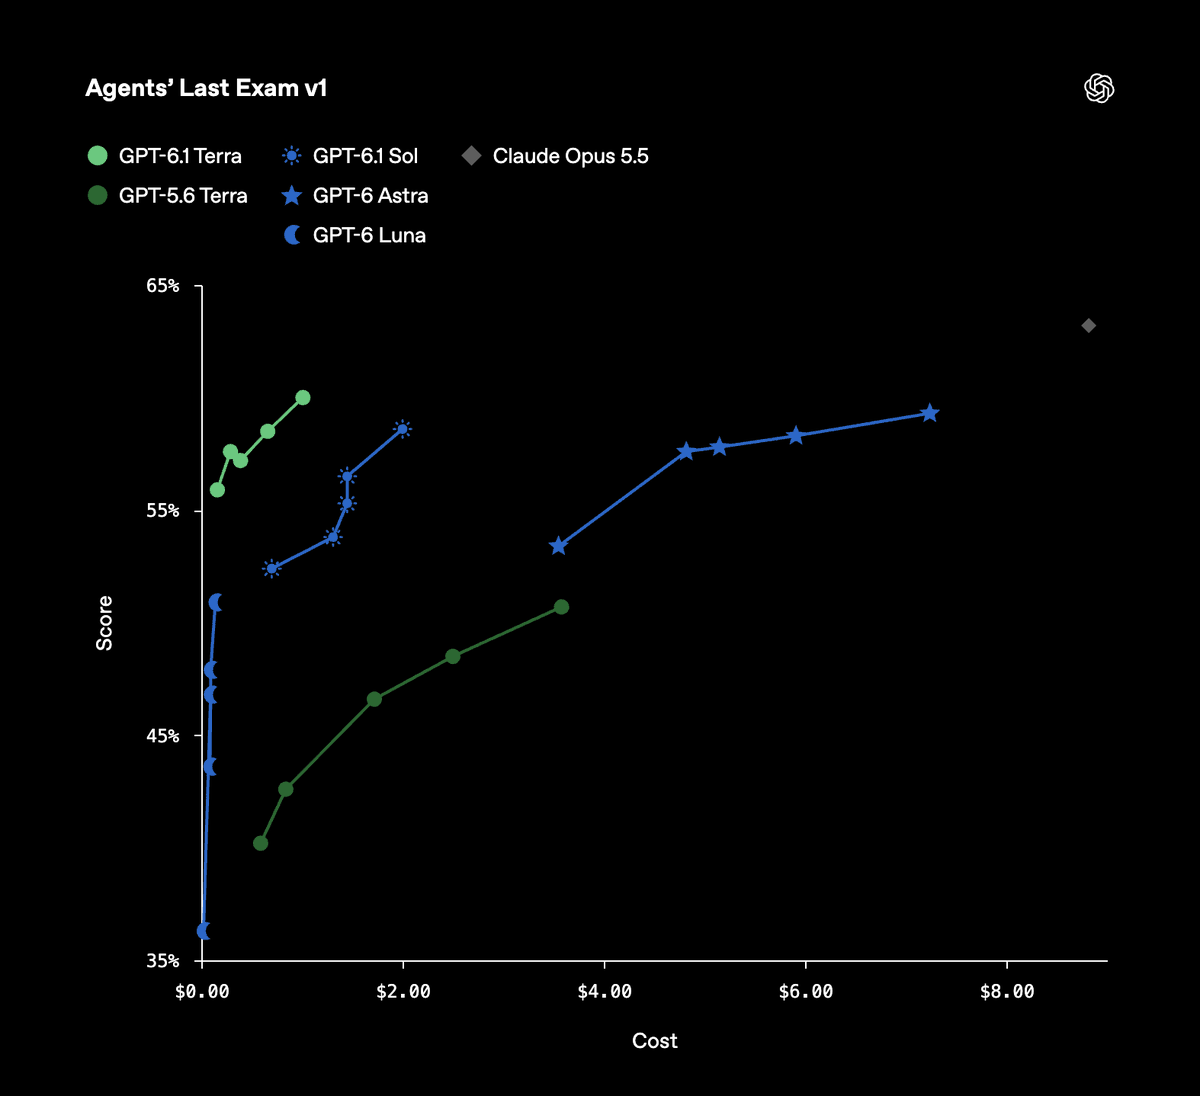
A página de modelos da OpenAI lista computer_use como uma ferramenta suportada para o GPT-6.1 Terra ($1 / $5, entrada em cache $0.05), e os exemplos do guia de uso do computador usam o GPT-6.1 Sol ($2 / $10). A OpenAI não publica pontuação de navegador ou OSWorld para nenhum dos dois nessas páginas. O Terra é uma opção sólida para o modo DOM, mas faça benchmark com suas próprias tarefas.
Gemini 4 Argon e Gemini 3.8 Flash
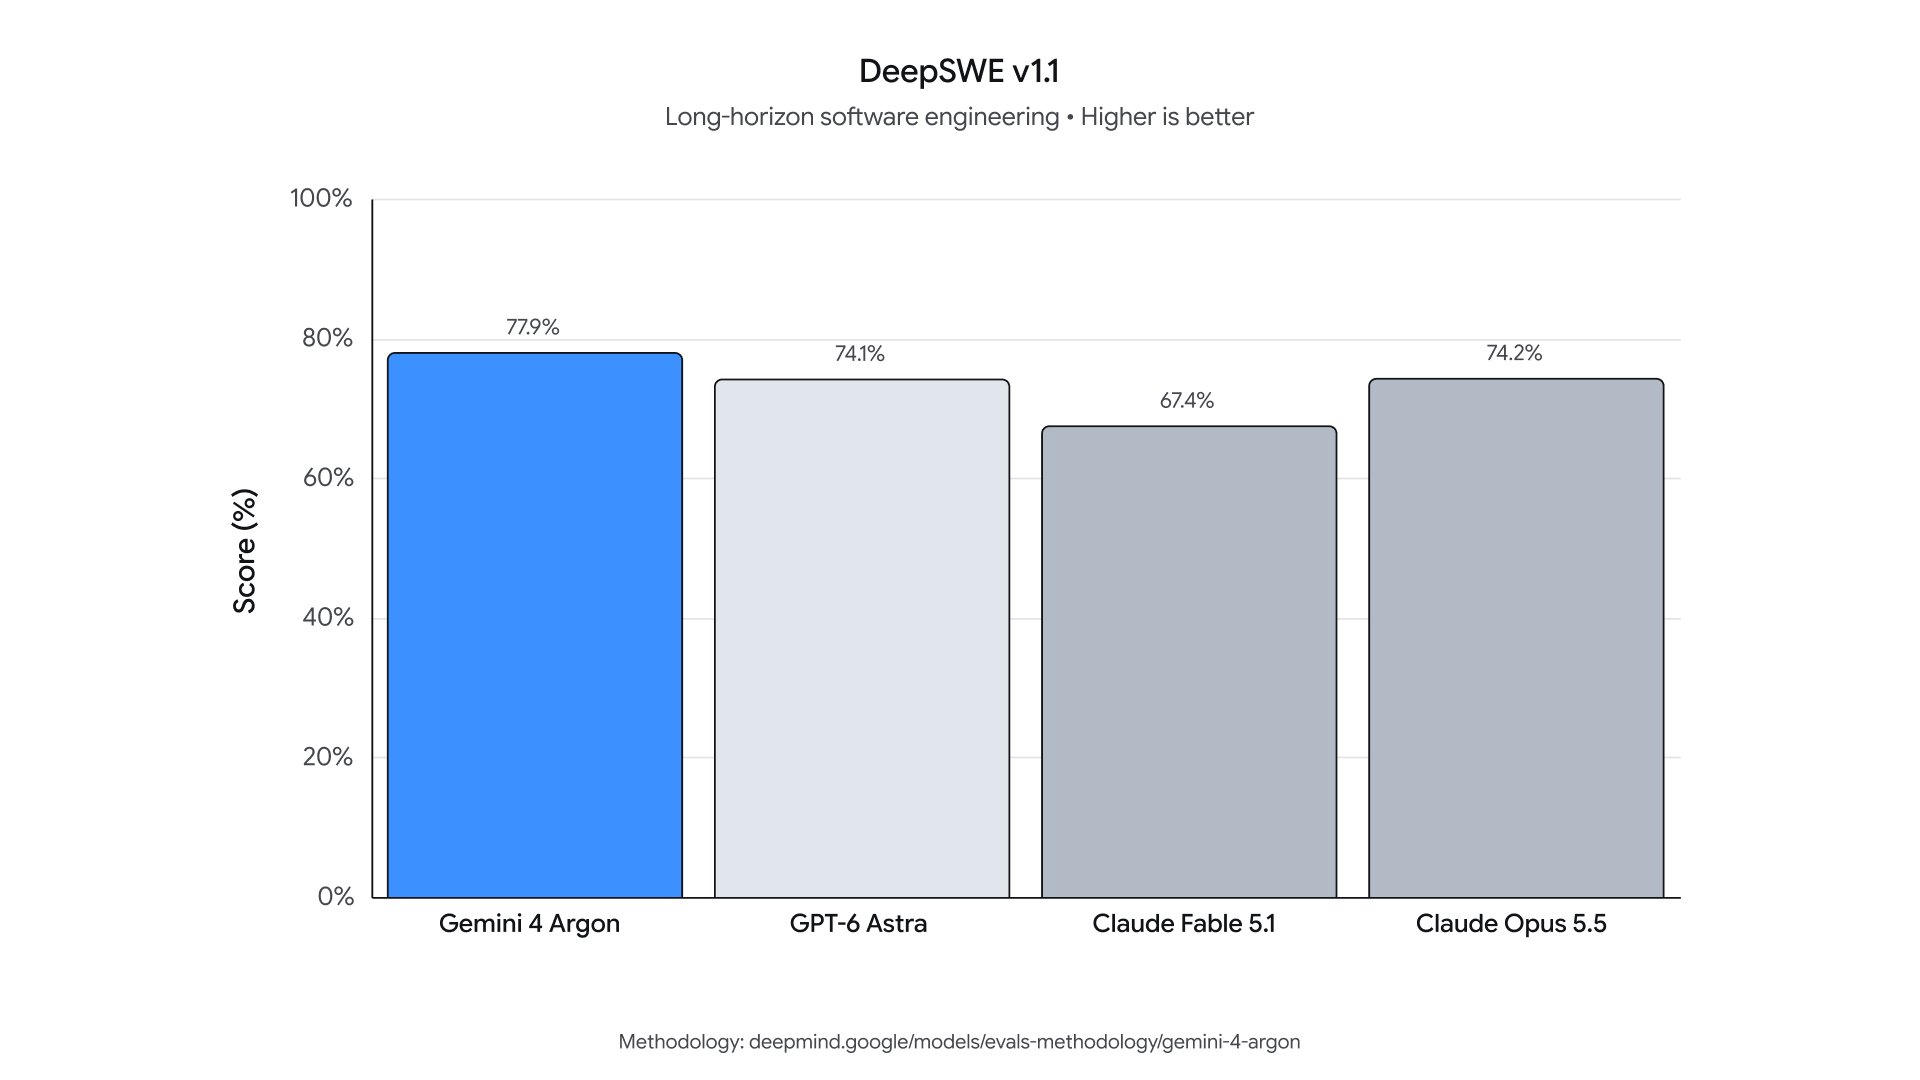
O Gemini 4 Argon entrou em GA em 13 de outubro de 2026. Sua ficha de modelo mostra 69,2% no subconjunto offline do OSWorld 2.0 e 39,5% no Agent’s Last Exam (uso do computador), acima dos 34,2% do Astra e dos 38,2% do Opus 5.5. O uso do computador no Argon ainda está em Preview. O preço é $2 / $10 até 30 de novembro de 2026, depois $4 / $20.
A página de uso do computador do Google recomenda gemini-3.8-flash ($0.75 / $3.75 até 31 de dezembro de 2026), mas não fornece benchmark para ele. O Gemini 2.5 Computer Use não aparece mais nessa página, então o removemos.
Holo4 (pesos abertos)
A H Company lançou o Holo4 em 28 de setembro de 2026, substituindo o Holo3. Em seu próprio harness, o Holo4 27B pontua 85,2% no OSWorld a $0.08 por tarefa e 61,7% no OSWorld 2.0 para fluxos de trabalho longos a $1.22 por tarefa. O 35B-A3B pontua 80,8% e 30,9% nos mesmos dois, a $0.05 e $0.61. A H afirma que os pesos do 35B-A3B são Apache 2.0; verifique a licença do 27B na ficha do modelo antes de distribuí-lo comercialmente. Ambos rodam na API da H a $0.40 / $3.00 (27B) e $0.30 / $2.00 (35B-A3B). Nosso post sobre o Holo3 cobre a API da geração anterior.
Kimi K3.1 Pro, DeepSeek V4.1 Flash e Qwen 3.7 Plus
- Kimi K3.1 Pro aceita imagens e vídeo com um contexto de 1M, segundo o quickstart da Moonshot. Sua pontuação de lançamento no BrowseComp mede pesquisa na web, não cliques em páginas, e nenhuma pontuação de uso do computador é publicada. Verifique o preço na página de preços do Kimi .
- DeepSeek V4.1 Flash (
deepseek-flash) agora suporta entrada de imagem a $0.15 / $0.60 fora de pico e $0.30 / $1.20 em pico, segundo a página de preços da DeepSeek. Nenhum benchmark de navegador é publicado. É a opção mais barata aqui para o modo DOM. - Qwen 3.7 Plus reporta 79,0 no ScreenSpot Pro, um teste de grounding de captura de tela. Veja nosso guia do agente de uso do computador Qwen 3.7 Plus.
O que as equipes de framework medem
O guia de modelos do Browser Use (BU Bench V1, atualizado em 11 de junho de 2026) mostra o lado da velocidade: o Claude Fable 5 atingiu 80,0%, mas teve média de 6 minutos e 53 segundos e cerca de $5.80 por tarefa. Os modelos 5.5 ainda não estão nele. Para a escolha do framework em si, veja Browser Use Cloud, Stagehand e o servidor MCP do Puppeteer.
Custo por tarefa: um exemplo prático
Suponha uma tarefa de 30 etapas no Claude com o conjunto de ferramentas de navegador. Cada etapa adiciona uma captura de tela de 1.334 tokens mais cerca de 450 tokens de texto de ação e resultados de ferramentas, e o modelo escreve cerca de 300 tokens de saída.
- Entrada da etapa n ≈ 6.600 + n × 1.784 tokens
- Entrada total em 30 etapas ≈ 198.000 + 1.784 × 465 ≈ 1,03M tokens
- Saída total ≈ 9.000 tokens
| Modelo | Sem cache | Com cache de prompt (cerca de 95% de acertos de cache) |
|---|---|---|
| Claude Opus 5.5 | cerca de $4.30 | cerca de $0.68 |
| Claude Sonnet 5.5 | cerca de $2.15 | cerca de $0.34 |
| Claude Haiku 5.5 | cerca de $0.11 | cerca de $0.02 |
Esses são números ilustrativos a partir dos preços de tabela da Anthropic, não execuções medidas. Duas conclusões continuam válidas de qualquer forma: o cache reduz a conta em mais de 80%, e remover capturas de tela antigas do histórico economiza mais do que trocar para um modelo mais barato.
Como escolher
- Comece com o Sonnet 5.5. Ele pontua dentro de 2 pontos do líder pela metade do preço.
- Passe para o Opus 5.5 apenas se sua taxa de sucesso em tarefas reais for o gargalo.
- Desça para o Haiku 5.5 ou Gemini 3.8 Flash para fluxos de alto volume, curtos e repetitivos. Meça primeiro.
- Use o Holo4 se os dados não puderem sair da sua infraestrutura.
- Use o GPT-6 Astra com execução de código quando a tarefa for um script repetível, não exploração.
- Ignore o navegador completamente quando o site tiver uma API. Uma chamada de API é uma requisição em vez de 30 etapas. Nossa análise de uso do computador vs APIs estruturadas mostra quando cada um vence, e a lista de ferramentas de automação de navegador cobre o resto.
Deixe seu agente de codificação testar a API em vez disso com o Apidog CLI
Agentes de navegador são o caminho lento e caro. Quando a página pela qual seu agente continua clicando é sustentada por uma API JSON, a medida mais barata é encontrar essa API uma vez e testá-la diretamente. O conjunto de ferramentas de navegador do Claude tem até um membro opcional read_network que lista as requisições que uma página faz.
Deixe seu agente de codificação fazer isso com o Apidog CLI. Configure uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois dê ao seu agente um prompt:
Export a HAR of the checkout flow you just ran in the browser. Import it into
Apidog project <id>, create a test case for POST /api/cart/items that asserts
a 200 status and a numeric cartTotal, then run it against the staging
environment and summarize any failures.
O agente importa o tráfego, lê o schema do payload, valida, escreve o caso e o executa:
apidog import --project <id> --format har --file checkout.har
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Troque -r cli,json por -r junit e o mesmo comando roda em CI; veja o guia pipeline CI/CD do Apidog CLI. Se o Claude Code for seu agente, Apidog CLI no Claude Code explica a configuração. O plano Free do Apidog cobre até 4 usuários.
Perguntas frequentes
Qual é o melhor LLM para agentes de navegador agora? O Claude Opus 5.5 tem a maior pontuação no OSWorld 2.1 relatada pelo fornecedor (81,8%). O Claude Sonnet 5.5 é o padrão melhor para a maioria das equipes, com 80,1% e metade do preço.
Qual modelo é melhor para uso do computador com orçamento limitado? O Claude Haiku 5.5 a $0.10 / $0.50 pontua 72,4% no subconjunto offline do OSWorld 2.1 da Anthropic. Mantenha os prompts abaixo de 100.000 tokens para permanecer na faixa barata.
Existe um bom modelo de pesos abertos para agentes de navegador? Sim. O Holo4 35B-A3B vem com pesos Apache 2.0 e pontua 80,8% no OSWorld no harness da H Company. O Holo4 27B pontua mais alto, mas verifique sua licença primeiro.
Modo captura de tela ou modo DOM? Use a árvore de acessibilidade ou o DOM quando a página tiver uma. É mais barato e sobrevive a mudanças de layout. Recorra a capturas de tela para canvas, mapas, vídeo e áreas de trabalho remotas.
Posso comparar pontuações do OSWorld entre fornecedores? Apenas de forma aproximada. Os fornecedores relatam OSWorld 2.0, OSWorld 2.1, subconjuntos offline e pontuações parciais com harnesses diferentes. Execute suas próprias 20 a 50 tarefas reais antes de decidir.
O Gemini 2.5 Computer Use ainda está disponível? Ele não aparece mais na página de uso do computador do Google desde 27 de outubro de 2026. O Google lista Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite e Gemini 3 Flash Preview em vez disso.