Resposta rápida: As chamadas assíncronas de ferramentas (async tool calls) para agentes de IA dividem uma execução bloqueante com run() em um contrato simples: start() retorna um identificador de tarefa (job handle) imediatamente, status() informa o progresso, stop() cancela e o resultado retorna mais tarde como um evento lido pelo agente em sua próxima iteração. Enquanto as tarefas mais lentas rodam em segundo plano, o agente continua conversando e recebendo novas instruções.
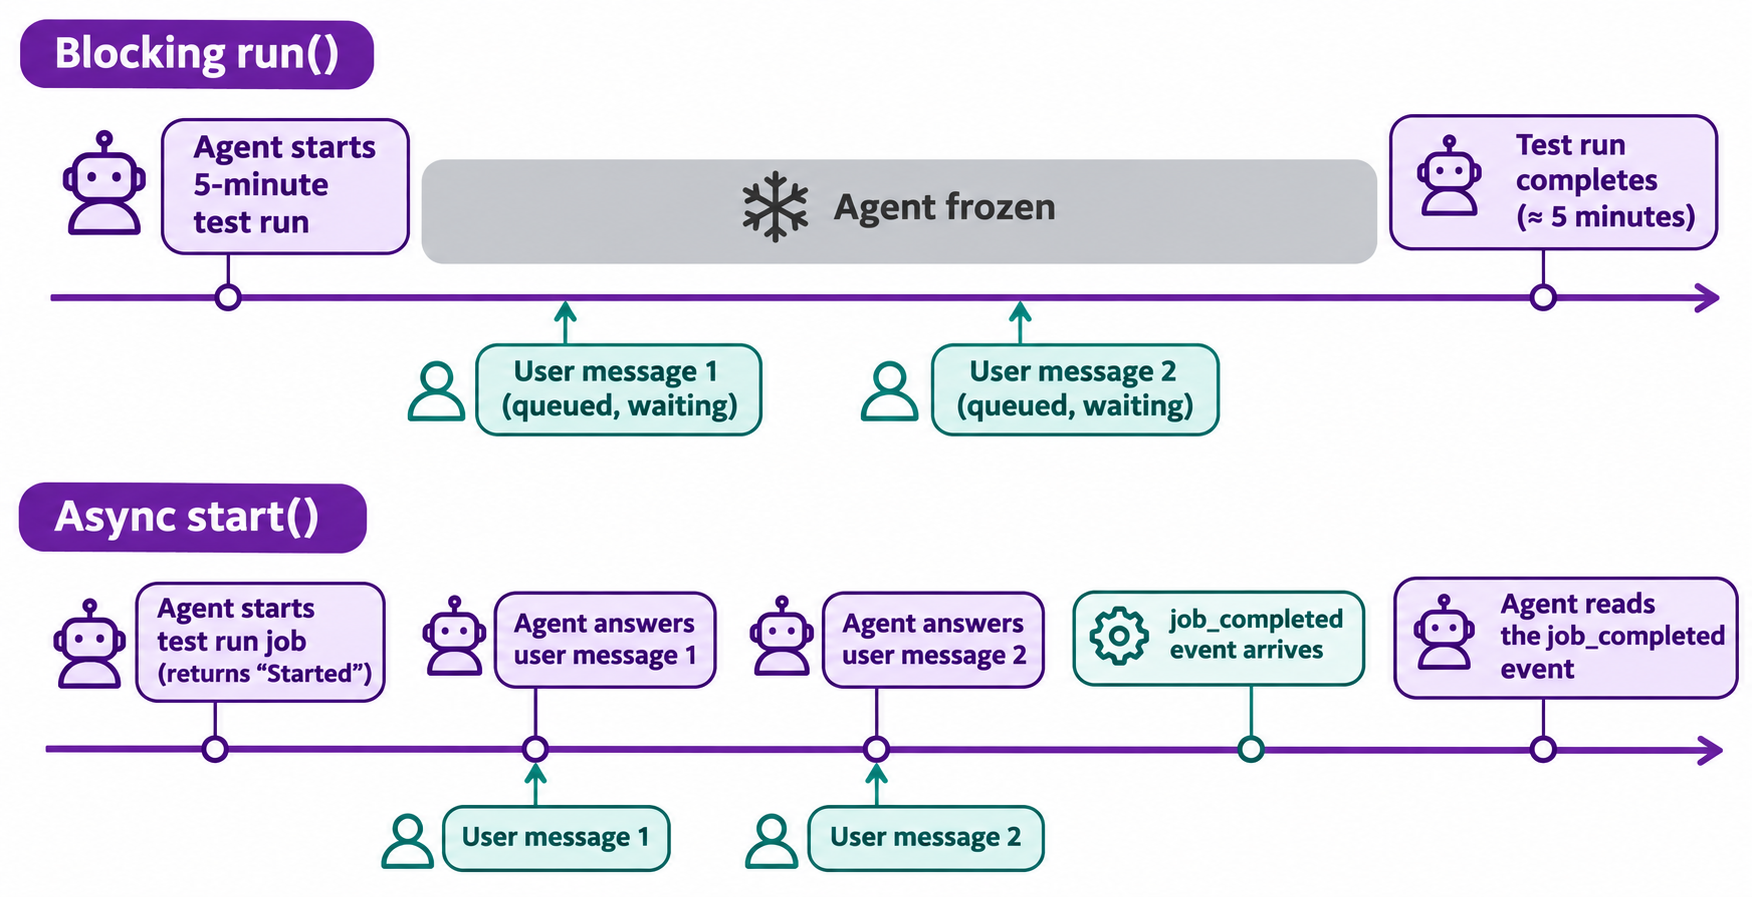
Hoje, a maioria dos agentes aciona uma ferramenta e fica aguardando. Se você fizer uma segunda pergunta durante a execução de uma suíte de testes de 6 minutos, ela ficará presa na fila. Isso funciona bem para uma busca rápida de 200 ms, mas torna-se um gargalo frustrante para um deploy ou uma varredura web (crawl).
Um artigo recente da equipe do DeepSeek Harness, “Exploring Super-agent Design”, chama a solução para esse problema de “full-duplex”: substituir o método bloqueante run() por start() e stop(). Este guia aborda o lado do loop do agente: o contrato da ferramenta, como os resultados retornam ao fluxo, o cancelamento e a API necessária para cada ferramenta. Para entender o lado HTTP de uma chamada demorada individual, leia AI Agents and Long-Running API Calls: Polling vs Webhooks.
O que são chamadas assíncronas de ferramentas em um loop de agente?
Uma chamada assíncrona de ferramenta é a invocação de uma ferramenta que retorna um identificador (handle) em vez de um resultado definitivo. O loop do agente registra esse identificador, encerra seu turno e permanece livre para interagir com o usuário. Quando a tarefa é finalizada, o runtime injeta um evento de conclusão na conversa, e o modelo o lê em seu próximo turno como faria com qualquer outra mensagem.
A diferença está em quem espera: com run(), quem espera é o modelo; com start(), quem espera é o runtime.
run() bloqueante |
start() assíncrono |
|
|---|---|---|
| Retorno | Resultado final | Job id, “Started” |
| Agente durante a execução | Travado | Conversando, planejando, iniciando novas tarefas |
| Nova mensagem do usuário | Na fila até a ferramenta retornar | Processada imediatamente |
| Cancelamento | Interrompe o turno inteiro | stop(job_id) |
O artigo da DeepSeek descreve isso como um padrão de arquitetura, não como uma chave pronta para ativação em produção. Ele pontua que o modo full-duplex está implementado no DeepSeek Harness, mas desativado por padrão, e que partes dele residem em um plugin de protótipo chamado dsh-superagent-prototype — o qual os próprios autores enfatizam não ser um produto oficial da DeepSeek. Encare-o como uma referência de arquitetura a ser adotada. Para mais detalhes, confira o que é o DeepSeek Harness e o artigo complementar sobre como construir um superagente.
O problema do bloqueio: uma ferramenta lenta paralisa o agente
Imagine um agente de programação encarregado de rodar uma suíte de testes (5 minutos) e responder a uma dúvida sobre uma importação com falha. Com chamadas bloqueantes, sua pergunta fica retida atrás dos testes, mesmo sem depender em nada deles. Três problemas acontecem:
- Acúmulo de latência. Cada ferramenta demorada soma sua duração total a tudo o que estiver na fila depois dela.
- Instruções desatualizadas. Se você disser “na verdade, ignore os testes e2e” aos dois minutos de execução, o agente não receberá essa instrução até o processo terminar.
- Problemas com timeouts. Gateways encerram conexões mantidas abertas por vários minutos, de modo que uma execução longa com
run()pode falhar mesmo quando a tarefa subjacente é concluída com sucesso.
O artigo descreve a característica desejável como sendo “produtiva”: o agente aceita a instrução seguinte antes mesmo de a anterior ser concluída. Ferramentas assíncronas são a forma de viabilizar isso.
start, status, stop: o contrato de ferramentas assíncronas
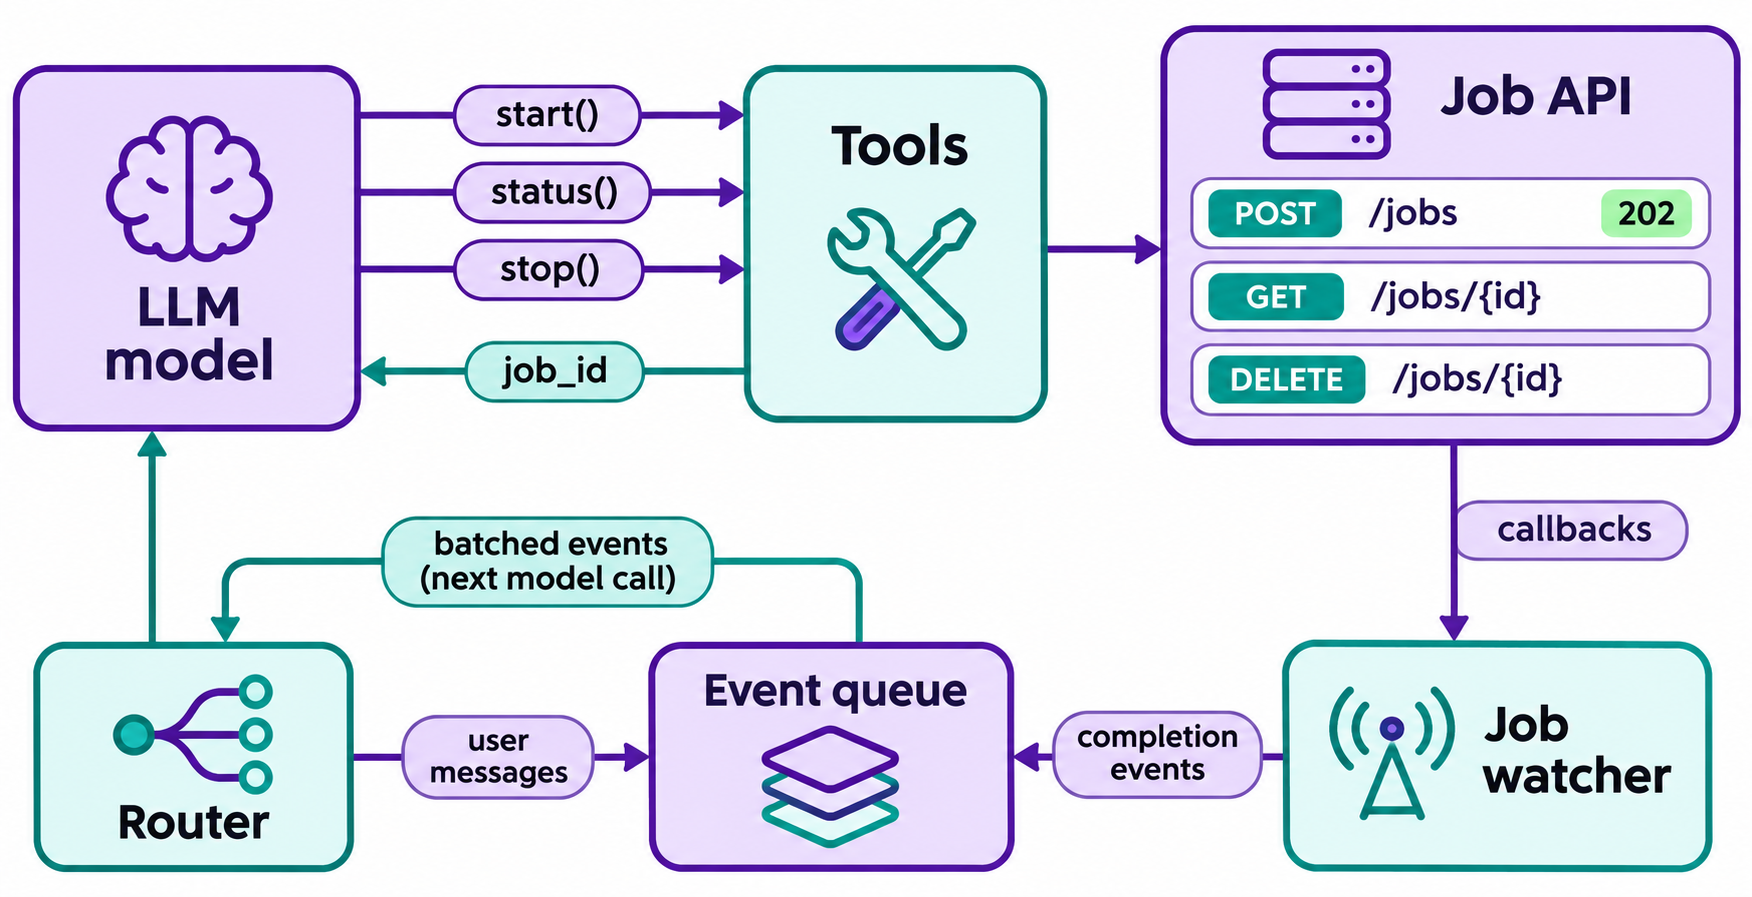
Em vez de disponibilizar apenas uma ferramenta para operações demoradas, forneça três ao modelo, com retornos de formato mínimo.
{
  "name": "start_test_run",
  "description": "Start the test suite. Returns immediately with a job_id. The result arrives later as a job_completed event; do not wait for it.",
  "input_schema": {
    "type": "object",
    "properties": {
      "suite": { "type": "string", "enum": ["unit", "e2e", "all"] },
      "idempotency_key": { "type": "string" }
    },
    "required": ["suite", "idempotency_key"]
  }
}
O start_test_run retorna {"job_id": "job_8f2", "status": "queued"} e nada além disso. O get_job_status(job_id) retorna queued, running, done ou failed, juntamente com uma breve observação de progresso. O stop_job(job_id) solicita o cancelamento e reporta o estado em que a tarefa parou.
Duas regras essenciais garantem o comportamento correto do modelo: inclua explicitamente “do not wait” (não espere) na descrição — caso contrário, ele fará polling em get_job_status em um loop fechado — e nunca retorne dados diretamente no start, para evitar que o modelo precise deduzir qual estrutura de resposta recebeu.
Como os resultados retornam ao loop
Fazer polling a partir do modelo é apenas um plano de contingência, não a arquitetura ideal. A melhor abordagem consiste em fazer o runtime monitorar as tarefas e despachar um evento de conclusão diretamente na conversa como uma nova mensagem:
[event] job_completed job_id=job_8f2 tool=start_test_run status=done
summary: 412 passed, 3 failed (auth/session.test.ts)
details: get_job_result(job_8f2)
Mantenha o evento enxuto e deixe o payload completo protegido atrás de uma ferramenta de busca (fetch), impedindo que um log de 40.000 linhas seja descarregado diretamente no contexto.
Em seguida, implemente o processamento em lote (batching). O artigo da DeepSeek descreve um roteador que reúne os disparos ocorridos durante um turno e os agrupa na próxima chamada ao modelo — com entradas longas e saídas curtas, integradas na fase de prefill. Nos testes apresentados no texto, a frequência de disparos subiu de 1 para 40 por minuto, o tamanho médio do lote passou de 1,0 para 2,8 e o tempo médio por decisão despencou de 6,4 s para 1,6 s. Embora sejam números de experimentos internos e não um benchmark genérico, fica claro que uma única chamada processando três eventos é muito mais eficiente do que três chamadas individuais. A regra é simples: enquanto o modelo estiver gerando resposta, enfileire eventos e mensagens do usuário; ao concluir o turno, envie todos juntos na ordem em que chegaram.
Ordenação, cancelamento e chaves de idempotência
Ordenação. As tarefas podem terminar em qualquer ordem. Caso a tarefa B dependa da tarefa A, torne essa relação explícita: só inicie B após o evento de conclusão de A, ou garanta que a API tenha suporte ao parâmetro depends_on.
Cancelamento. O comando stop é uma solicitação, não uma garantia imediata. Retorne o estado real final (cancelled, ou done se ela tiver terminado antes da requisição) para que o modelo informe a situação com precisão. A extensão Tasks do MCP adota a mesma premissa: sua documentação descreve o cancelamento como cooperativo, de modo que uma tarefa ainda pode atingir um estado terminal diferente de cancelled.
Chaves de idempotência. Modelos realizam retentativas com frequência, o que significa que uma falha transitória de rede pode desencadear uma segunda chamada a start. Exija uma idempotency_key em cada start e faça com que a API retorne a tarefa existente caso identifique a mesma chave. Sem essa proteção, operações críticas como “executar migração do banco” podem rodar em duplicidade.
Resultados parciais. Disponibilize saídas preliminares (como as primeiras 50 páginas varridas) por meio de chamadas como get_job_result(job_id, cursor), sem obrigar o agente a esperar a conclusão integral.
Crescimento do contexto. Condense o histórico de tarefas concluídas em uma única linha assim que o modelo tiver tomado as ações necessárias sobre elas.
Timeouts. Atribua um tempo limite para cada tarefa e emita job_timed_out sempre que ele for excedido.
Como deve ser a estrutura da API subjacente
Uma ferramenta assíncrona é tão eficiente quanto a API de tarefas que roda por trás dela: aceitar o trabalho, devolver um identificador e permitir que o cliente consulte o status. A RFC 9110 define o status 202 Accepted como “a solicitação foi aceita para processamento, mas o processamento ainda não foi concluído”, e a documentação sobre 202 na MDN explica seu uso na prática.
Uma API de tarefas mínima para sustentar uma ferramenta start() deve incluir:
| Chamada | Resposta | Utilizado por |
|---|---|---|
POST /jobs (com cabeçalho Idempotency-Key) |
202 + {"job_id", "status":"queued"} + Location: /jobs/{id} |
start |
GET /jobs/{id} |
200 + queued, running, done ou failed |
status, monitor de tarefas (job watcher) |
GET /jobs/{id}/result |
200 com os dados de saída, ou 409 se ainda não estiver concluído |
ferramenta de busca (fetch) |
DELETE /jobs/{id} |
202 cancelamento solicitado, seguido de 404 ou 409 em chamadas posteriores |
stop |
| URL de callback opcional | POST para o cliente solicitante na conclusão da tarefa |
monitor de tarefas (job watcher) |
O callback é o mecanismo que possibilita ao runtime enviar notificações por push em vez de ficar preso ao polling. Caso precise de ajuda para decidir entre as duas abordagens, veja a comparação em webhooks vs polling; já o lado de APIs orientadas a eventos é explicado em o que é AsyncAPI.
Se suas ferramentas já utilizam o padrão MCP, agora existe uma especificação formal para isso. A especificação do MCP (versão 2026-07-28) traz o suporte a Tasks como uma extensão opcional: o servidor responde a tools/call com um CreateTaskResult contendo um taskId, o cliente consulta tasks/get (ou assina notifications/tasks) e tasks/cancel solicita a interrupção. Os status são working, input_required, completed, failed e cancelled. Tanto o cliente quanto o servidor precisam ter suporte habilitado, e a adesão varia entre os hosts — verifique seu cliente antes de depender desse recurso.
Crie e teste a API de tarefas com seu agente de código usando o Apidog CLI
A API de tarefas é a camada que você pode validar por completo antes mesmo que qualquer agente comece a interagir com ela. Delegue o design e os testes ao seu agente de desenvolvimento integrado ao Apidog CLI. Basta fornecer um prompt, e o agente gera a especificação, estrutura os cenários de teste e executa as validações.
A configuração inicial requer apenas três comandos:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Em seguida, envie este prompt ao agente:
In Apidog project <projectId>, design the job API a start() tool needs:
POST /jobs returns 202 with job_id, GET /jobs/{id} returns queued|running|done|failed,
DELETE /jobs/{id} cancels. Create the endpoints, then create test cases that assert:
202 and a job_id on create, a status that reaches done within 60 seconds,
the same job_id when the Idempotency-Key repeats, and 409 or 404 on GET result after cancel.
Run them against the staging environment <envId> and summarize failures.
O agente lê a estrutura esperada de cada payload diretamente pelo CLI, valida o esquema e executa os passos correspondentes:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file post-jobs.json
apidog endpoint create --project <projectId> --file post-jobs.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-create-202.json
apidog test-case create --project <projectId> --file case-create-202.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
O formato de relatório cli exibe os sucessos e falhas de cada validação no terminal, enquanto a saída em json oferece um formato estruturado para o agente interpretar e explicar os resultados. Depois que os testes estiverem passando, rode o mesmo comando na sua pipeline de CI com -r junit; o guia de fluxo de trabalho de agentes com Apidog CLI detalha essa integração contínua, e o artigo sobre o Apidog CLI no Claude Code cobre a configuração em agentes de código. O plano gratuito do Apidog atende até 4 usuários.
Quando vale a pena usar ferramentas assíncronas (e quando não vale)
Adote chamadas assíncronas quando:
- A execução de uma ferramenta levar com frequência mais do que alguns segundos (builds, baterias de testes, varreduras web, renderizações, deploys).
- O usuário precisar interagir e dialogar com o agente enquanto o processamento ocorre.
Mantenha chamadas síncronas/bloqueantes quando:
- A resposta retornar em um ou dois segundos.
- O passo seguinte depender obrigatoriamente do resultado da operação atual.
- Não houver como estruturar uma API de tarefas autêntica por trás da ferramenta. Criar uma camada assíncrona fictícia que bloqueia a execução internamente só traz complexidade desnecessária.
Uma regra prática: mantenha leituras em formato bloqueante e transforme operações demoradas de escrita ou processamento pesado em tarefas assíncronas.
FAQ
Qual é a diferença entre chamadas assíncronas e chamadas paralelas de ferramentas? Chamadas paralelas disparam múltiplas ferramentas simultaneamente dentro do mesmo turno, mas o modelo ainda fica travado aguardando todas responderem. Já as chamadas assíncronas respondem instantaneamente com um identificador e concluem sua execução em turnos posteriores, permitindo que o modelo continue a conversa enquanto a tarefa é processada.
Preciso usar o MCP para implementar ferramentas assíncronas? Não. Qualquer ferramenta que retorne um job id associada a um runtime capaz de injetar eventos de conclusão funcionará perfeitamente. A extensão opcional Tasks do MCP apenas define um contrato padrão para identificadores, polling e cancelamentos caso tanto o cliente quanto o servidor ofereçam suporte.
Como o agente identifica quando uma tarefa chegou ao fim? O runtime é quem faz esse aviso. Um monitor de tarefas (job watcher) consulta a API via polling ou aguarda um callback e, em seguida, insere um evento sintético de conclusão na conversa. O modelo processa essa mensagem automaticamente em seu turno seguinte.
O que acontece se o usuário solicitar o cancelamento com a tarefa em andamento? O agente dispara stop(job_id), a API registra o pedido e a tarefa retorna o estado em que realmente se encontra. Caso o processo já tenha sido concluído antes de o cancelamento ser processado, o agente deve relatar que a tarefa foi concluída, em vez de afirmar indevidamente que foi interrompida.
O modo full-duplex da DeepSeek é um recurso que já pode ser habilitado diretamente? Não como uma funcionalidade pronta de produto. O artigo esclarece que o recurso está implementado no DeepSeek Harness, mas desativado por padrão, e que o plugin correspondente consiste em um protótipo experimental que os autores apontam não ser um produto oficial da DeepSeek. Ele deve ser utilizado como um modelo de arquitetura de referência.