
AlibabaのQwenチームは、Qwen-Image-2.1を2026年9月20日にオープンソース化しました。これは、テキストから画像を生成し、画像を編集する単一のモデルであり、そのビジュアル生成コンポーネントには70億のパラメータが搭載されています。背景除去処理でごまかすのではなく、プロンプトから直接透明なPNGを出力できます。ローンチ記事では、より軽量で高速なアーキテクチャ、ネイティブな透明度、最大10枚の参照画像による編集、そして優れたタイポグラフィとポートレートのディテールという4つの変更点が挙げられています。ウェイトはHugging FaceとModelScopeで公開されており、コードはGitHubで入手できます。
モデルカードの一文は、どの機能よりも重要です。ライセンスはApache 2.0ではなくQwen Research Licenseです。商用利用には別途契約が必要です。製品のために2.1を評価している場合は、ベンチマークの前にそのセクションを読んでください。もし実行したい場合は、Qwen-Image-2.1のハウツーガイドにdiffusersコードと、ApidogでテストできるHTTPラッパーが記載されています。ホスト型のQwen Image 3.0 APIと比較検討している場合は、2.1と3.0の比較ページが判断材料になります。
Qwen-Image-2.1の概要
| 項目 | 詳細(ローンチ記事、モデルカード、GitHub README) |
|---|---|
| リリース日 | 2026年9月20日 |
| 機能 | テキストから画像生成と画像編集を一つのモデルで実現(透明度付きRGBA出力を含む) |
| ビジュアルジェネレーター | 32層のSingle-Stream DiTレイヤー、70億パラメータ |
| テキストエンコーダー | Qwen3-VL 8B |
| VAE | 64チャンネルRGBAオートエンコーダー、16倍の空間圧縮 |
| デフォルト出力 | 2048 x 2048; 最大2752 x 1536までの7種類のアスペクト比 |
| 参照画像 | 編集ごとに最大10枚 |
| ローカル編集 | 円、ペイントされたアノテーション、または別途マスク画像 |
| コンパニオンモデル | Qwen-Image-2.1-PE-T2I および PE-I2I プロンプトリライティングモデル(Qwen3.5-VL 9B ファインチューン) |
| ライセンス | Qwen Research License Agreement; 商用利用には別途ライセンスが必要 |
| 試用 | Hugging Face Space, Qwen Chat, ComfyUI(リリース初日からネイティブ対応) |
Qwen-Imageシリーズにおける位置づけ
初代Qwen-Imageは2025年8月に20B MMDiTモデルとしてリリースされ、テキストレンダリングで知られていました。これとは別に編集モデルとしてQwen-Image-Editがありました。2025年後半には、リアリズムのための2512リフレッシュ、複数人物の一貫性のためのEdit-2511、そして透明レイヤーのためのQwen-Image-Layeredが12月に登場し、ラインナップはさらに分岐しました。Qwen-Image-2.0は2026年2月に登場し、生成と編集を1つの7Bモデルに統合し、ネイティブ2K出力を実現しました。
バージョン2.1は、2.0のサイズと統合されたデザインを維持し、Layeredモデルの透明度機能を組み込むことで、かつて3つのモデルが必要だった機能を1つのチェックポイントでカバーできるようになりました。また、新しい推論パス(詳細は後述)と、マスクと複数の参照画像を中心に構築された編集インターフェースも追加されています。これと並行して、Alibabaはホスト型ラインも展開しており、Qwen Image 3.0および3.0 Proは2026年7月にAPIモデルとしてリリースされ、公開されたウェイトはありません。したがって、この命名は連続したものではなく、分岐を示しています。2.1はダウンロード可能なオープンモデルであり、3.0はレンタルするモデルです。
2.1の新機能
より軽量なアーキテクチャとより高速な編集パス
ビジュアルジェネレーターは、70億パラメータを持つ32層のSingle-Stream DiTレイヤーで構成され、8BのQwen3-VLエンコーダーと、アルファチャンネルをネイティブに持つVAEが組み合わされています。興味深いのはアテンションのエンジニアリングです。Qwenはこれを「混合粒度(mixed-granularity)」と呼んでおり、テキストトークン(システムプリフィックスと編集指示)にはトークンレベルの因果マスクを使用し、画像生成にはチャンクレベルのマスクを使用します。入力画像と指示はノイズ除去ステップ全体で静的なため、モデルは最初のステップで一度キーバリューキャッシュを計算し、それを再利用します。Qwenが謳う利点は、複数の参照画像で編集する際のレイテンシとメモリの削減であり、これは10枚の画像制限で負荷が高くなったワークロードにまさに合致します。
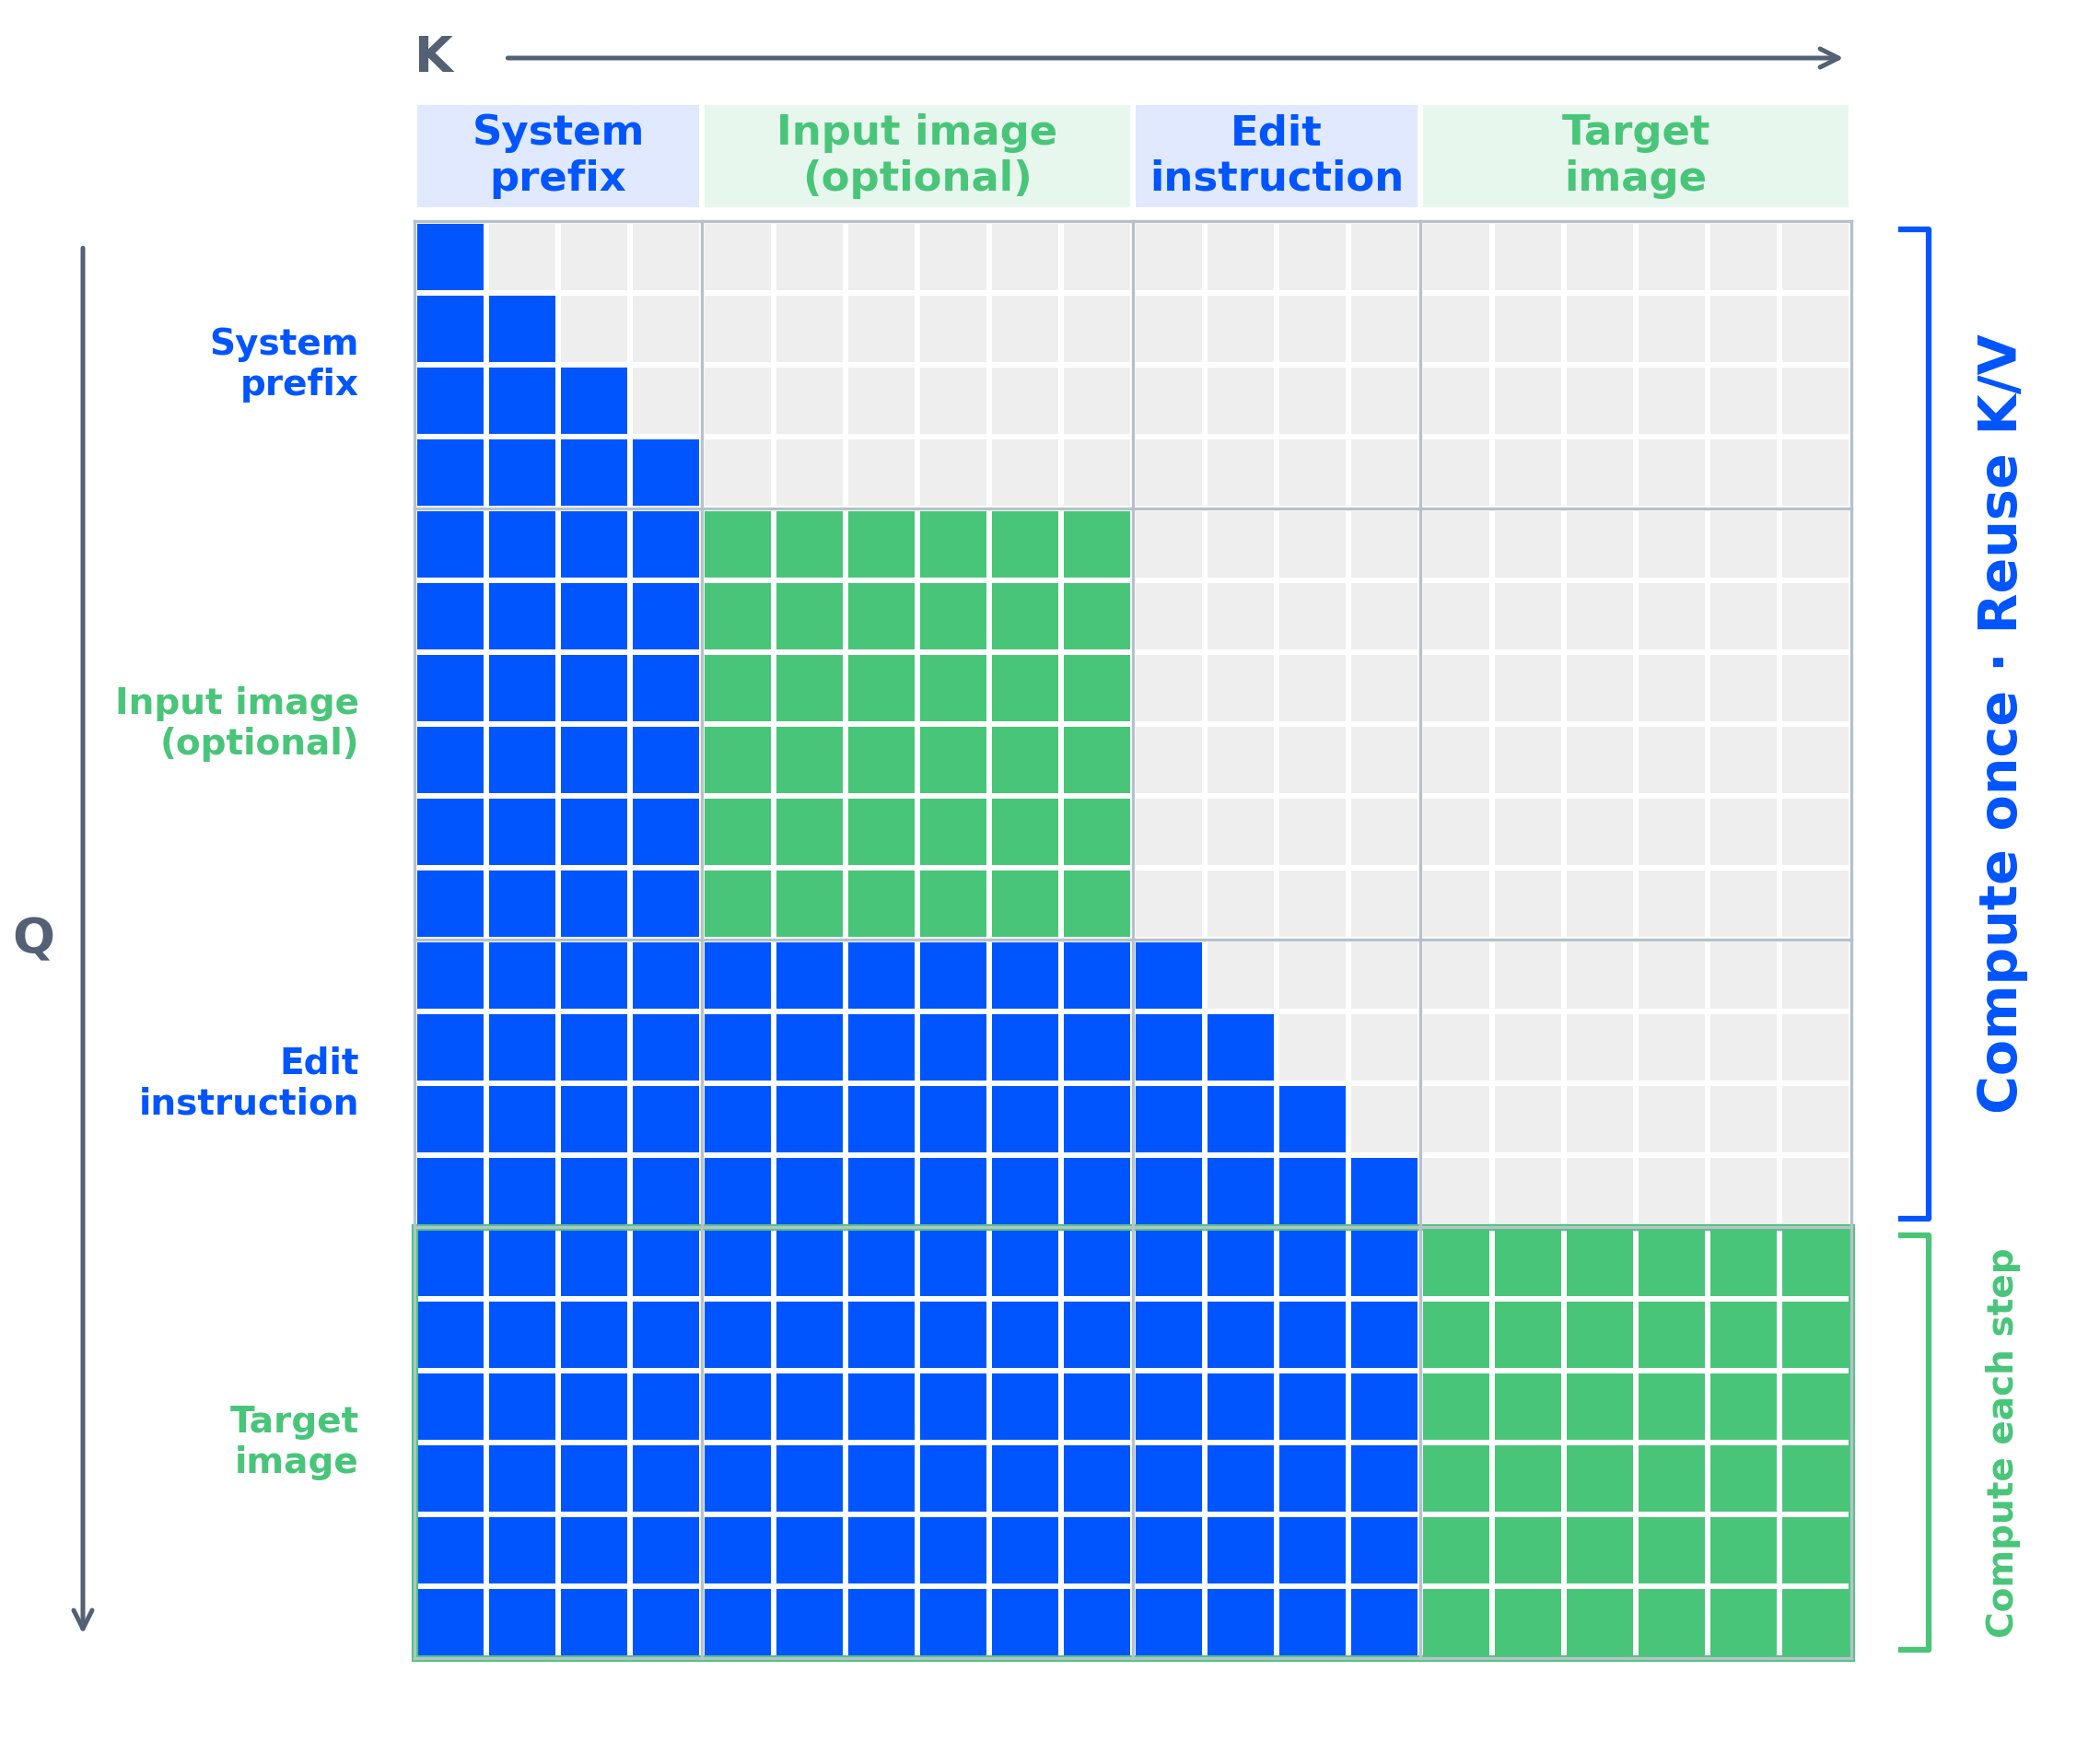
スケジューラはオイラー離散ステップを使用したフローマッチングで、参照コードはデフォルトで40ステップを実行します。
同一モデル内でのネイティブ透明度
これが目玉機能です。プロンプトで透明な画像を要求すると、モデルはRGBA形式で返します。READMEで推奨されている言い回しは文字通り、「これは透明度を持つRGBA画像です」から始め、背景が透明であることを伝えることです。ローンチ記事では、単一の被写体、複数の要素からなる構図、そして透明な入力に対する3つの編集例が示されています。被写体の表情をアルファチャネルを維持したまま変更する例、透明なレイヤー内のテキストを置き換える例、そして通常のRGB写真から被写体をRGBA切り抜きとして抽出する例です。
製品チームにとって、これは2つのモデル(生成、マット処理)からなるパイプラインを1回の呼び出しに置き換えます。また、背景除去ツールが髪の毛やガラスの周りに残すハローアーティファクトも除去します。これは、アルファチャンネルが後から推測されるのではなく、生成されるためです。2Kで自分のアセットに対してエッジがどれだけ保持されるかは、想定するよりもテストすべき点です。無料ティアガイドでは、GPUなしでこれらのテストを実行する方法が示されています。
最大10枚の参照画像とリアルな領域制御による編集
ローンチ例では、3つの編集機能が際立っています。
- 複数の参照画像。 6枚のポートレートが1枚の集合写真に、モデル、服、靴、バッグ、帽子が全身のコーディネートに、10枚の家具写真が家具付きの部屋になります。入力画像の制限は10枚です。
- 3通りのローカル編集。 色付きの円を描き、プロンプトで色によってそれぞれを指定する(例:「青い円の中の時計を削除」)、領域をペイントオーバーする、または編集されていない元の画像と別のマスクを2つの入力として渡すことで、ソースの何も覆い隠さないようにする方法があります。
- 忠実度。 Qwenによると、顔の同一性や製品のテキスト、テクスチャ、形状は2.0よりも編集後も良く保持されるとのことです。ローンチ記事ではビフォーアフターのペアが示されていますが、指標は記載されていないため、自身のSKUで検証すべき主張として捉えるべきです。
同じ編集パスで、自撮り写真からパノラマ、製品写真からインフォグラフィック、3面図のキャラクターシートからストーリーボードを作成できます。連続したローカル編集は、短いアニメーションとして連結でき、ローンチ記事ではカピバラのクリップで実演されています。
タイポグラフィとポートレートの品質
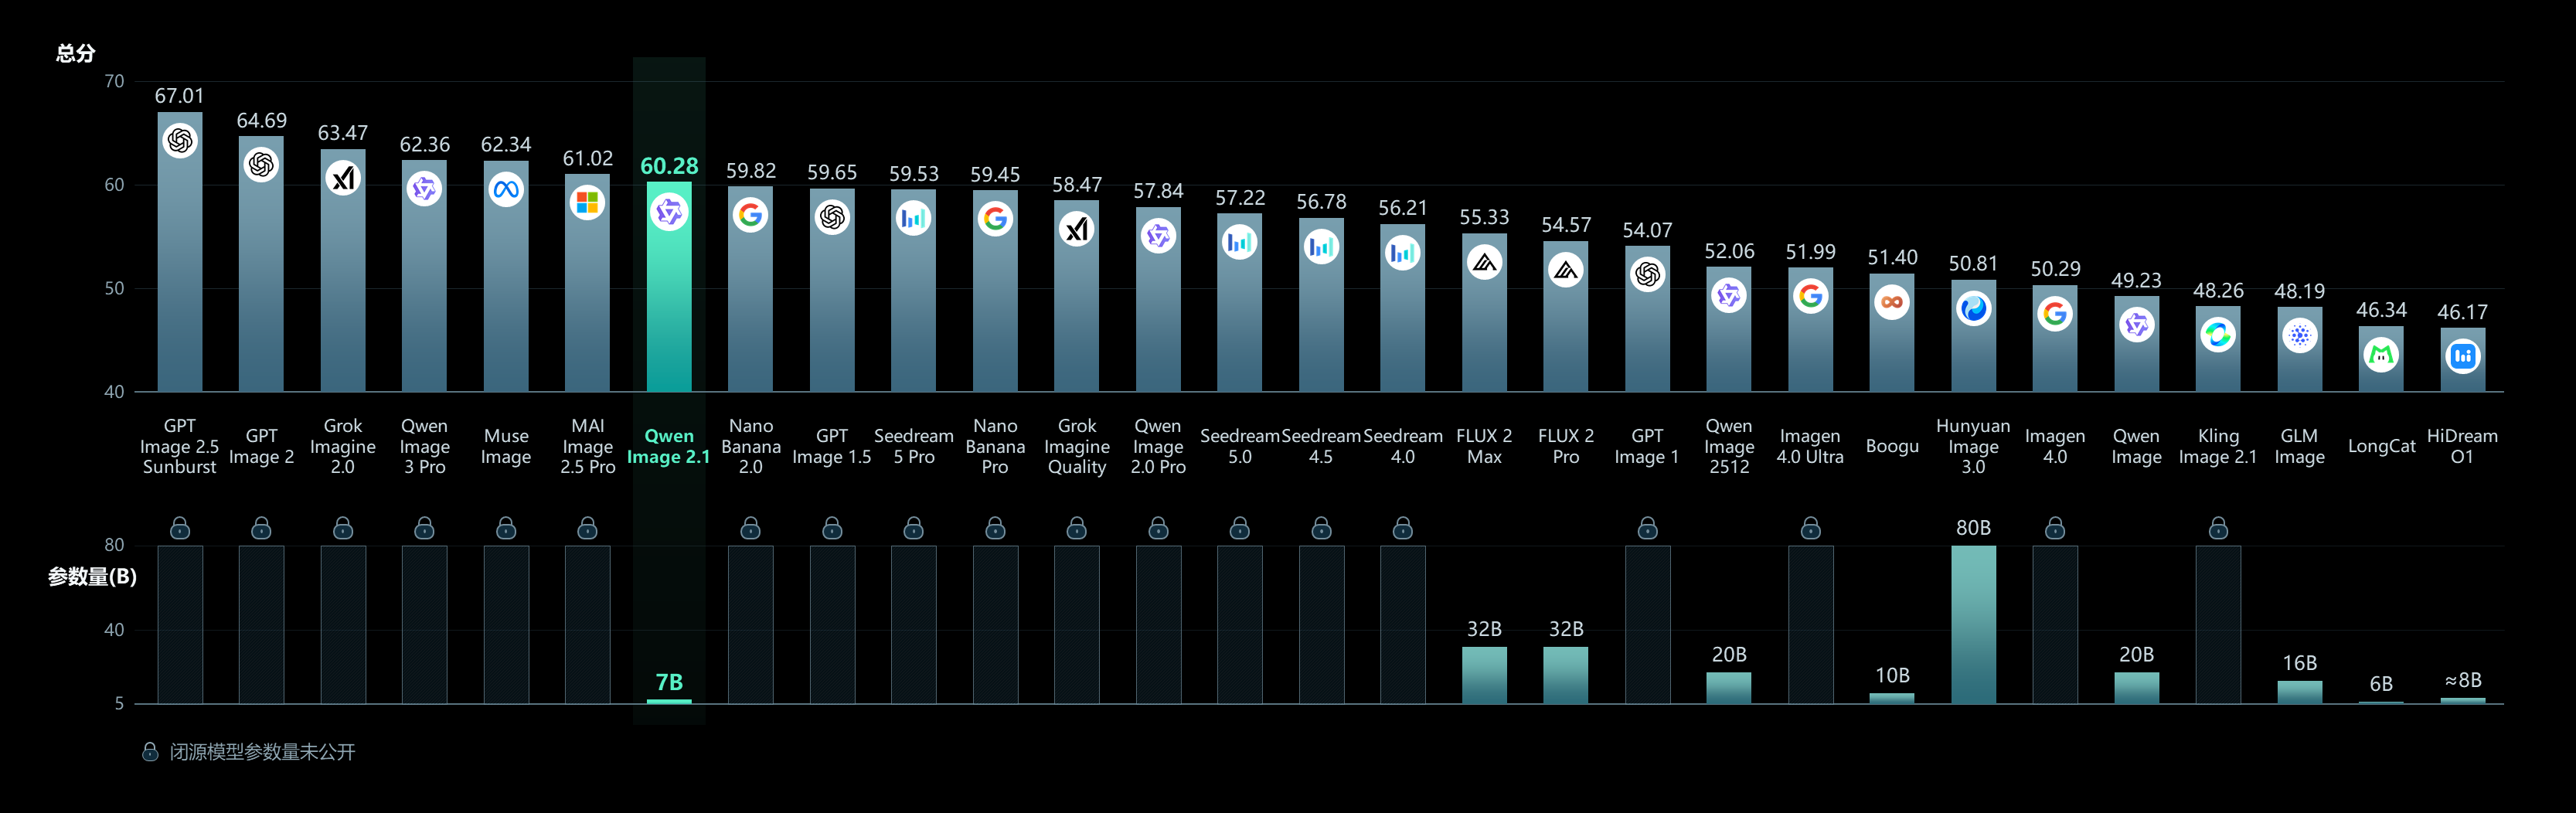
Qwenは初代Qwen-Image以来、オープンなテキストレンダリングを牽引してきましたが、2.1ではスペルだけでなく、文字のスタイル、レイアウト、構図の中でのテキストの配置にまで拡張されています。ポートレートのライティングと細かいディテールも改善されています。ローンチ記事では、これを裏付けるQwen-Image-Benchのチャートがオープンモデルとクローズドモデルを比較して示されていますが、そのチャートは画像であり、記事には数値が記載されていないため、ここでは引用しません。
ライセンス:オープンウェイト、研究利用条件
初代Qwen-ImageはApache 2.0でした。Qwen-Image-2.1はQwen Research License Agreementの下でリリースされており、ライセンス文書は、重要な点について短く明確に記述されています。
- Qwenから別途商用ライセンスを取得することなく、「いかなる商用目的」にもモデルを使用することはできません。ライセンスはメールで請求できます。
- 再配布および派生物には、ライセンス、「Built with Qwen」または「Improved using Qwen」の表示、およびHangzhou Tongyi Laboratoryを著作権者とする著作権表示を付記する必要があります。
- 派生物の主たる名称として「Qwen」を使用することはできません。
- 本契約は、中国の法律に準拠し、杭州の管轄裁判所が適用されます。
プロンプトリライティングのコンパニオンモデルも同じ条件で提供されます。趣味のプロジェクト、研究論文、または内部評価であれば問題ありません。SaaS機能として使用する場合、まずAlibabaと話し合うか、通常の商用条件と画像ごとの価格が設定されたホスト型3.0 APIを使用する必要があります。
2つのプロンプトリライティングモデル
ジェネレーターと並行して、QwenはQwen-Image-2.1-PE-T2IとQwen-Image-2.1-PE-I2Iを公開しました。PE-T2Iは、あらゆる言語の短いリクエストを受け取り、詳細な英語プロンプトと推奨アスペクト比をJSONで返すようにファインチューニングされたQwen3.5-VL 9Bです。PE-I2Iは編集用の対応モデルです[要確認]。これらはオプションであり、デモスペースが1行の入力から長く構造化されたプロンプトを生成する方法です。2.1を中心としたAPIを構築する場合、これはChatGPT Imagesのような製品が目に見えない形で行っている「プロンプトエンハンスメント」ステップです。
ローンチで語られなかったこと
- 解像度ごとのVRAM数値はありません。READMEには、より軽量または高速なサービス提供のための
enable_model_cpu_offload()、FP8対応vLLM-Omni、SGLang、LightX2V、およびAMDサポートが示されていますが、表形式のデータはありません。 - 公開されたベンチマーク数値はなく、チャートのみです。
- ローンチ時点ではModel Studioで2.1のホスト型APIは提供されていません[要確認]。ホスト型ラインは3.0です。
- 固定された推論速度の主張はなく、KVキャッシュの再利用による「効率の向上」のみです。
APIの背後に置き、テストする
ほとんどのチームは、アプリケーションコードからdiffusersパイプラインを直接呼び出すことはしません。GPUボックス上のHTTPサービスでラップし、それを呼び出します。エンドポイントになれば、それは他のAPIと同じであり、Apidogで設計・テストできます。リクエストスキーマ(プロンプト、オプションの参照画像、アスペクト比、透明度フラグ)を定義し、実際の呼び出しを送信し、応答がアルファチャンネルを持つPNGであることを確認し、良好なケースをモデル更新ごとに再実行する回帰テストスイートに変換します。また、GPUが処理中であってもフロントエンドチームが安定した契約に基づいて開発できるように、エンドポイントをモックすることも可能です。ハウツーガイドでは、そのラッパーとApidogテストについて順を追って説明しています。
Apidogをダウンロードして、一緒に試してみましょう。
FAQ
Qwen-Image-2.1は商用利用無料ですか? いいえ、Qwenから別途商用ライセンスを取得しない限り無料ではありません。ウェイトは研究目的および非商用目的でのダウンロードと使用は無料です。上記のライセンスセクションと、費用をかけずに試す方法については無料ティアガイドを参照してください。
2.1はQwen-Image-2.0とどう違いますか? 同じ7Bサイズと、生成と編集を統合したデザインは同じです。2.1の新機能は、ネイティブRGBA出力と編集、最大10枚の参照画像、マスクとアノテーション駆動のローカル編集、複数の画像編集を高速化するためのKVキャッシュ再利用を伴う混合粒度アテンションパス、そしてタイポグラフィとポートレートの詳細の改善です。
Qwen Image 3.0と同じですか? いいえ。3.0および3.0 Proは2026年7月にリリースされたホスト型APIモデルで、オープンウェイトはありません。2.1はオープンウェイトモデルです。比較では、価格と機能の違いがカバーされています。
必要なハードウェアは何ですか? QwenはVRAM要件を公開していません。参照コードは、1つのCUDAデバイスでbfloat16でパイプラインをロードし、CPUオフロードを提供します。コミュニティのサービススタックはFP8を追加します。40ステップで2K出力を得るには、データセンターまたはハイエンドの消費者向けGPUが必要です。
透明画像を生成するだけでなく、編集することもできますか? はい。ローンチ例では、被写体の表情を変更したり、透明なレイヤー内のテキストをアルファチャンネルを維持したまま置き換えたり、RGB写真からRGBAの被写体を抽出したりしています。
次へのステップ
Qwen-Image-2.1は、他のどのシングルチェックポイントモデルも提供していないネイティブ透明度というユニークな機能を持ち、研究ライセンスという利用の可否を決定する制約がある強力なオープン編集モデルです。ハウツーガイドでローカルで実行するか、無料オプションでGPUなしで試すか、コミットする前にホスト型3.0 APIと比較検討してください。どちらを選んだとしても、Apidogでエンドポイントをテスト下に置き、モデルの入れ替えが製品に静かに問題を引き起こすことがないようにしましょう。