
OpenAI LifeVal は、子供の学校への入学、家計の管理、役所での手続きなど、AIエージェントがブラウザ利用、コンピュータ操作、コネクタを使って完了する169の日常生活タスクのベンチマークです。各試行をルーブリックが採点し、スコアは0から1の平均報酬です。GPT-6 Astra は xhigh エフォートで80.6%を記録しています。
これが手短な説明です。以下では、OpenAI がどのように LifeVal を構築したか、公開したすべてのモデルスコア(ページ内のインタラクティブチャートの中にしか存在しないエフォート別の数値を含む)、それらの数値が推論エフォートについて何を語っているか、そしてこのベンチマークが省いているものを説明します。
OpenAI LifeVal とは何か?
LifeVal は OpenAI Research のベンチマークで、コーディングや試験問題ではなく、日常生活の雑事をモデルがどれだけうまくやり遂げるかを測定します。その169のタスクはエージェント型です。モデルはブラウジングし、コンピュータを操作し、コネクタを呼び出し、シナリオ固有のルーブリックが結果を採点します。
OpenAI は7つのタスク領域を挙げています。
- 介護
- 健康
- 教育
- 家計管理
- 個人財務
- 買い物
- 政府サービスの利用
主要な指標は平均報酬です。各データ点は、1つのタスク内の試行を平均し、その後169のタスク平均を等しい重みで平均します。スコア80.6%は報酬0.806を意味します。チャートの注記には「No WTP weighting」とあり、これについては後ほど触れます。
OpenAI はどのように LifeVal のタスクセットを構築したか
OpenAI はタスクリストをゼロから考案したわけではありません。人々が実際にどのように時間を使っているかを出発点とし、2つの公開データセットと独自の調査を用いました。
- 米国労働統計局のAmerican Time Use Survey。アメリカ人が時間ごとに何をしているかを記録したものです。
- Multinational Time Use Study。各国の時間使用日記を調和させたものです。
- 独自の調査。人口統計学的に代表性のある3,995人を対象に、どこでAIの助けを求めたいかを尋ねたものです。
時間使用データは、人々の1日をどの活動が占めているかを OpenAI に伝えます。調査は、それらの活動のうちどれを人々がエージェントに任せたいかを伝えます。その重なりが169のシナリオになりました。
ページには5つの例示タスクカードが表示され、それぞれにスコアがあります。これらは OpenAI が選んだ例であり、ランダムサンプルではありません。
| 例示タスク(OpenAIの選定) | スコア |
|---|---|
| 引っ越し後に適切な幼稚園に入学させる | 93.1% |
| 洪水に備えてボランティアを管理する | 98.0% |
| 家族のために新しい住まいを見つける | 100% |
| 遠くにいる祖母と一緒に試合を観る | 96.3% |
| 新たに糖尿病と診断された親のために食事を準備する | 90.4% |
LifeVal スコア:すべての OpenAI モデル
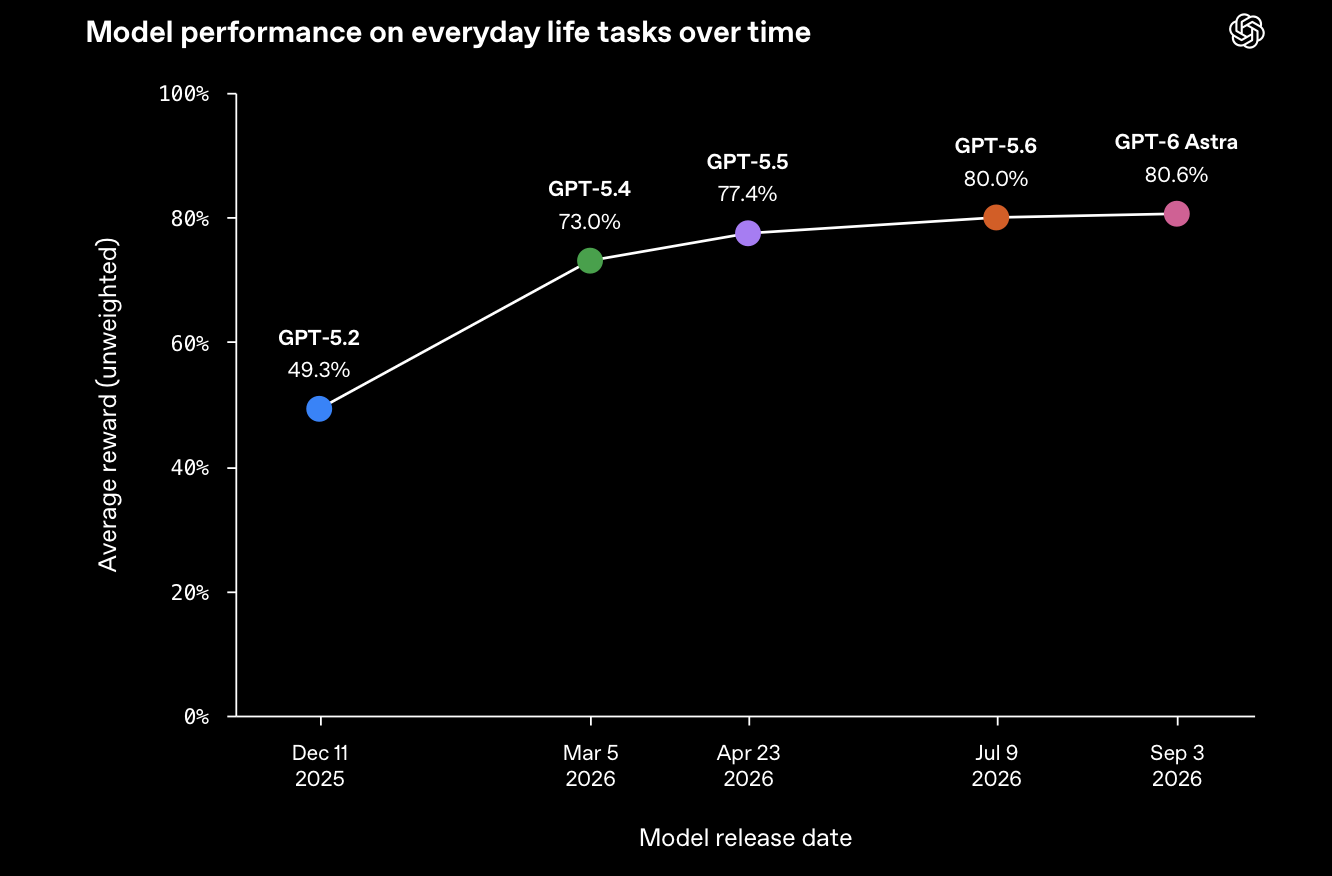
OpenAI の最初のチャートは、各モデルを xhigh 推論エフォートで、リリース日に対してプロットしています。GPT-6 Astra は「ローンチブログの xhigh 設定」を使用しています。
| モデル | リリース日 | LifeVal 平均報酬(xhigh) |
|---|---|---|
| GPT-5.2 | 2025-12-11 | 49.3% |
| GPT-5.4 | 2026-03-05 | 73.0% |
| GPT-5.5 | 2026-04-23 | 77.4% |
| GPT-5.6 | 2026-07-09 | 80.0% |
| GPT-6 Astra | 2026-09-03 | 80.6% |
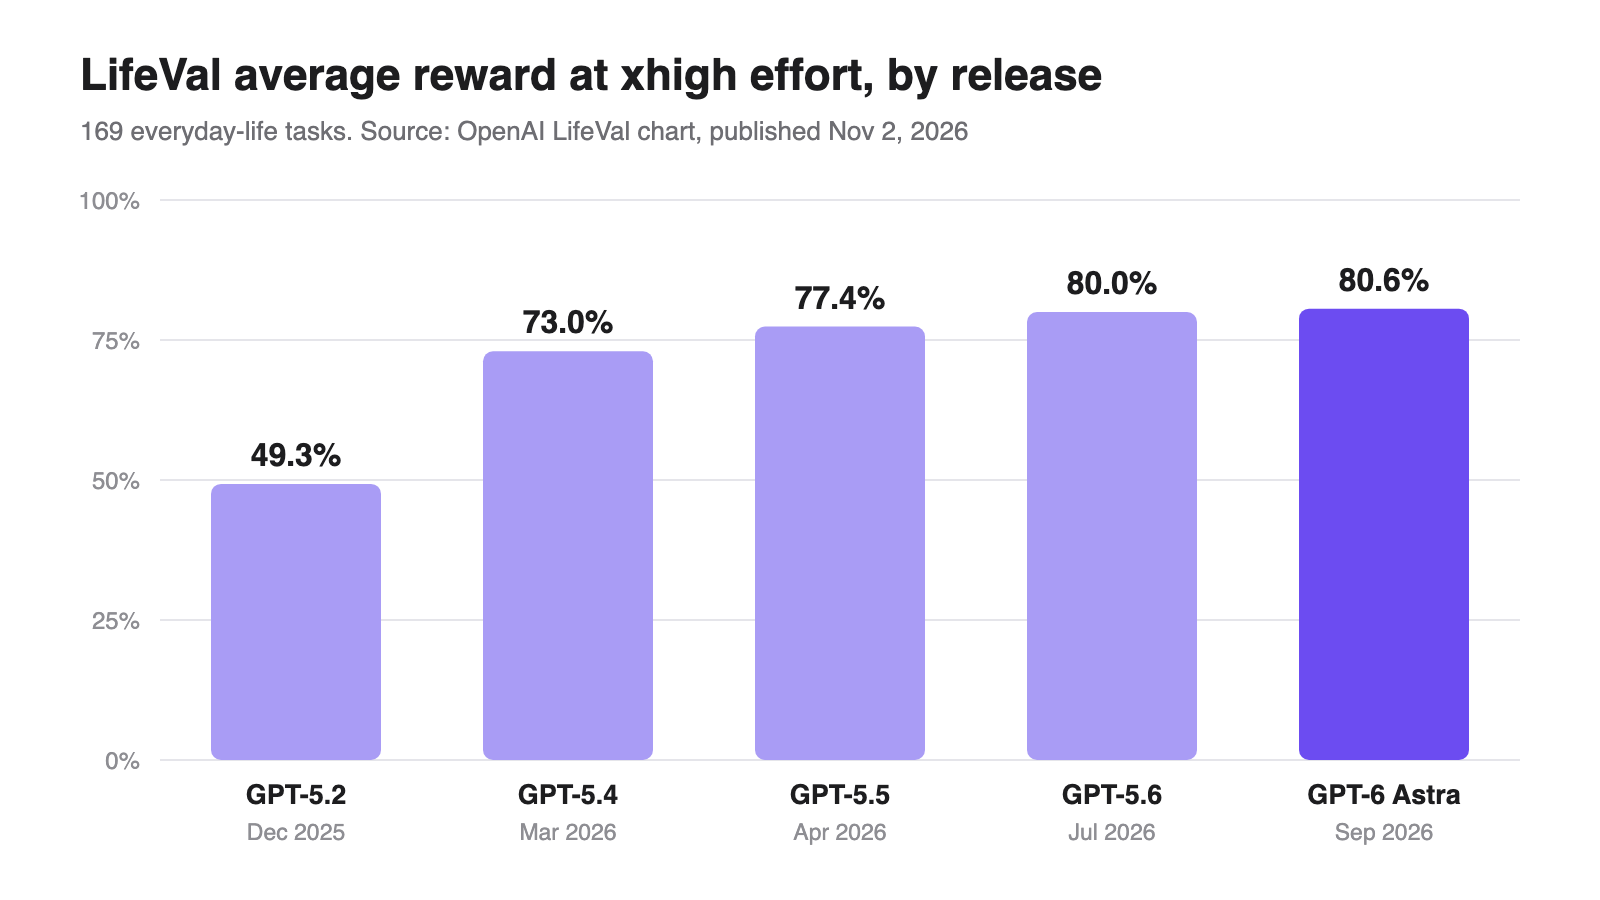
曲線は急峻で、その後平坦になります。GPT-5.2 から GPT-5.4 は3か月で23.7ポイント上昇しました。次の3つのリリースは合計で7.6ポイントを追加し、GPT-6 Astra は GPT-5.6 を0.6ポイント上回りました。
GPT-5.4 の飛躍は品質だけの話ではありませんでした。xhigh では、平均レイテンシが121.0秒から16.7秒に、生成トークン数がタスクあたり202.0Kから30.6Kに減少しました。新しいモデルは、およそ7分の1の出力で遥かに良い回答に到達しました。
GPT-6.1 Sol と GPT-6.1 Terra はどちらも出荷済みであるにもかかわらず、どちらのチャートにも現れません。タイムラインは2026年9月3日で止まっています。エージェント製品のために GPT-6.1 Sol と Astra のどちらを選ぶか検討しているなら、LifeVal はまだ役に立ちません。
推論エフォート別の LifeVal
2つ目のチャートの方が有用で、ホバーしないと見えません。すべてのモデルを推論エフォート別に分解し、各ポイントにつき4つの数値(報酬、レイテンシ、生成トークン、APIコスト)を示します。各設定の報酬は次のとおりです。
| モデル | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| GPT-5.2 | 27.7% | 37.2% | 45.2% | 49.3% | n/a |
| GPT-5.4 | 62.8% | 70.1% | 72.0% | 73.0% | n/a |
| GPT-5.5 | 57.1% | 71.3% | 75.6% | 77.4% | n/a |
| GPT-5.6 | 63.9% | 75.0% | 78.8% | 80.0% | 82.6% |
| GPT-6 Astra | 66.6% | 77.6% | 80.7% | 80.6% | 82.5% |
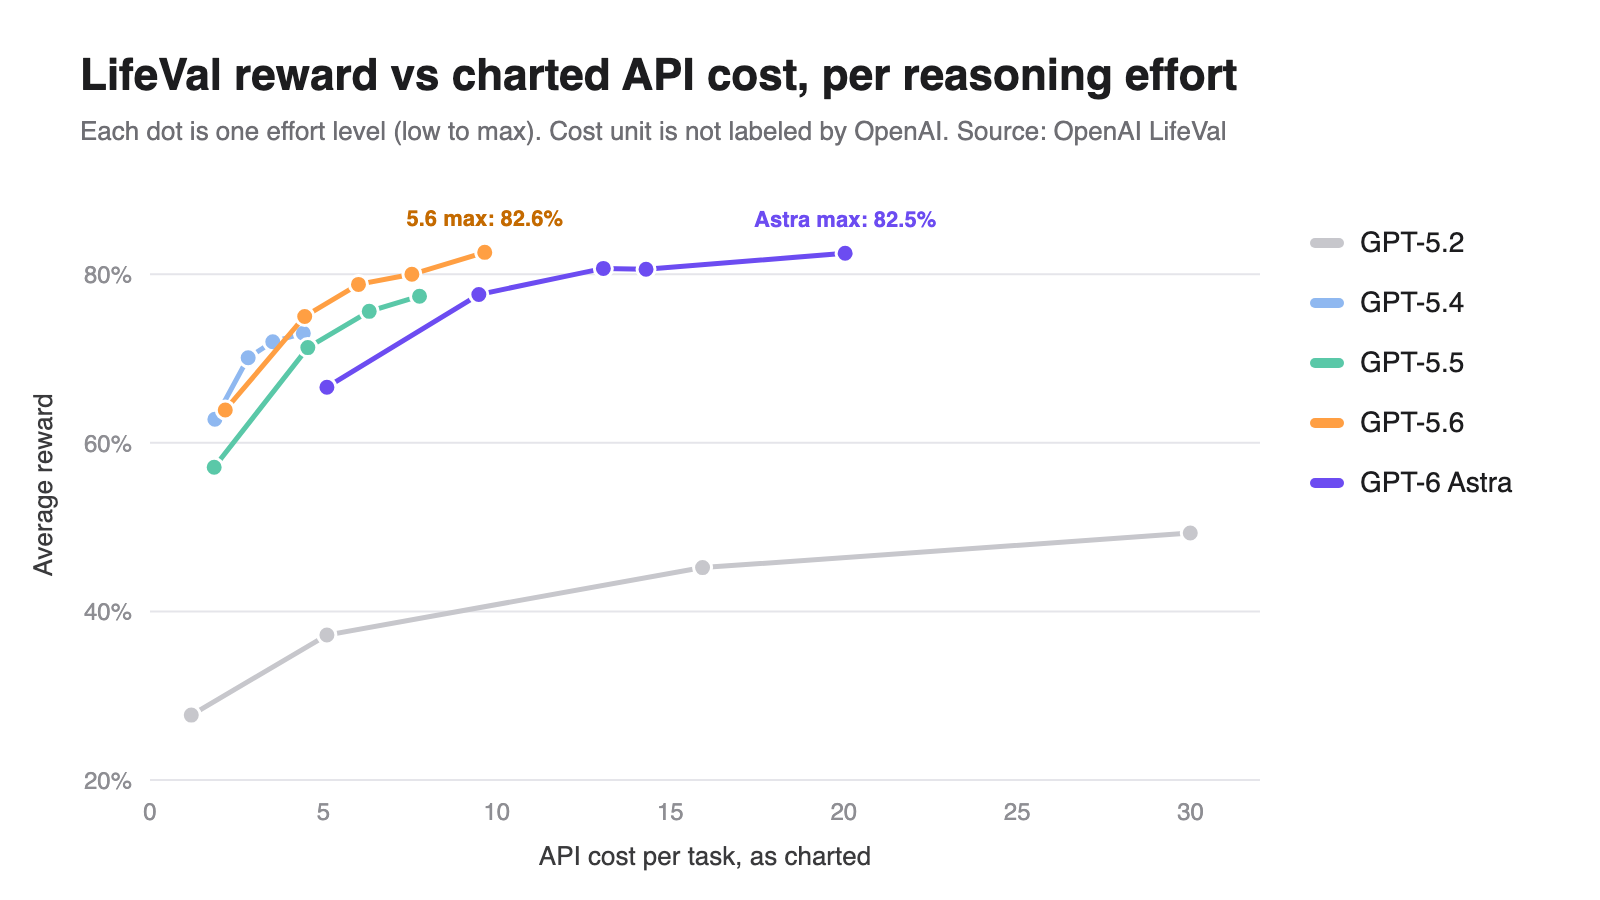
コスト列についての注記です。OpenAI はそれを API コストとラベル付けしていますが、単位を明示していないため、以下の数値は「チャートに表示されたタスクあたりの API コスト」として扱ってください。比率を見るには有用ですが、ドル額ではありません。
max の GPT-5.6 は max の GPT-6 Astra と同等
| 設定 | 報酬 | レイテンシ | トークン | チャート上のコスト |
|---|---|---|---|---|
| GPT-5.6, max | 82.6% | 22.2 s | 29.7K | 9.65 |
| GPT-6 Astra, max | 82.5% | 20.6 s | 26.3K | 20.04 |
| GPT-5.6, xhigh | 80.0% | 17.5 s | 20.7K | 7.55 |
| GPT-6 Astra, high | 80.7% | 13.6 s | 12.4K | 13.07 |
max での GPT-5.6 は、約半分のチャート上のコストで、max での Astra を0.1ポイント上回ります。同じエフォートで比較すると、Astra の GPT-5.6 に対するリードはどの設定でも3ポイント未満で、xhigh では0.6、max ではなくなります。Astra は若干速く、使用トークンも少ないですが、これらのタスクではおよそ2倍のコストを支払うことになります。この比率を自分のトラフィックで確認したい場合は、GPT-5.6 の価格内訳とGPT-6 Astra API ガイドにトークンあたりの料金があります。
「high」を超える推論はほとんど何ももたらさない
GPT-6 Astra では、high は80.7%、xhigh は80.6%です。追加のエフォートは1.4秒と2.1Kトークンを余分に消費し、スコアはわずかに低くなります。GPT-5.4 も同じ形を示します。high から xhigh で1ポイントです。
大きな伸びは曲線の下部にあります。GPT-5.5 を low から medium に動かすと14.2ポイント加わります。high から xhigh に動かすと1.8ポイントです。あなたのエージェントがこのような日常タスクを実行するなら、まず medium か high を試すべきです。OpenAI の推論ガイドで、Responses API における effort パラメータの仕組みが説明されています。
LifeVal が省いているもの
LifeVal は有用なシグナルですが、自己申告によるものです。引用する前に、その限界を知っておきましょう。
- 公開されていません。ダウンロード可能なタスクセットも公開リーダーボードもなく、OpenAI はルーブリックや採点者をどのように調整したかを公開していません。再実行することはできません。
- OpenAI のモデルしか採点していません。Claude、Gemini、オープンウェイトモデルは一切登場しないため、GPT-6.1 Sol が Claude Sonnet 5.5 とどう比較されるかや、その他のベンダー間の比較については何も語りません。
- 重み付け版がどこかに存在します。チャートには「No WTP weighting」とあり、WTP は支払意思額(willingness to pay)を意味します。これは、OpenAI が各タスクに対して人々が支払うであろう額で重み付けした変種を計算または検討したが、公開しなかったことを示唆します。
- 例示カードは手選びです。ページ上の5枚のカードは90.4%から100%のスコアです。最高モデルの169タスク平均は80.6%です。例はベンチマークの最高の日を示しており、典型的な日ではありません。
これらのことは LifeVal が間違っているというわけではありません。ベンダーベンチマークだということです。あらゆるローンチチャートを読むのと同じように読んでください。自分のタスクで検証できる主張として。
Apidog CLI で独自の推論エフォートテストを実行する
LifeVal のエフォート別テーブルは報酬対コストの曲線です。自分のプロンプトでも同じ曲線を描けます。手動でリクエストを送る代わりに、コーディングエージェントに仕事を任せ、Apidog CLI を操作させましょう。
CLI をインストールし、ログインし、エージェントに Apidog スキルを追加します。
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、Claude Code、Codex、Cursor のいずれかに1つのプロンプトを与えます。
In Apidog project <projectId>, add a POST https://api.openai.com/v1/responses
endpoint that sends {{model}}, reasoning.effort = {{effort}} and my test prompt.
Create a test case that asserts status 200 and saves latency,
usage.output_tokens and usage.output_tokens_details.reasoning_tokens.
Add a test data set with effort = low, medium, high, xhigh, run the case
once per row against environment <envId>, and give me a table of
latency, tokens and estimated cost per effort.
エージェントは各ペイロードスキーマを読み、その JSON を検証してから、次を書き込みます。
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json

apidog test-case category --project <projectId>
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json

apidog cli-schema validate test-data-create --file efforts.json
apidog test-data create --project <projectId> --file efforts.json

apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d <testDataId> -r cli,json --out-dir ./effort-runs
-d フラグはデータ行ごとに1回のイテレーションを実行し、-r cli,json はエージェントにテーブル構築用の JSON レポートを渡します。後で Apidog アプリで実行結果を閲覧したい場合は --upload-report を追加してください。apidog run コマンドリファレンスにはすべてのフラグが記載されており、Claude Code セットアップガイドではエージェント側を扱っています。
実際のプロンプトを1つではなく、5つか10つで実行してください。LifeVal が169タスクを平均しているのには理由があります。単一のプロンプトでは、エフォートよりも分散について多くのことを教えてくれます。
モデル選定で LifeVal を信頼すべきか?
方向性のために使い、意思決定には使わないでください。LifeVal は実行に移せる3つのことを教えてくれます。OpenAI のモデルは2025年12月から2026年3月の間に多段階の日常タスクでずっと良くなった、それ以降の伸びは小さい、そして high を超える推論エフォートはこの種の作業ではほとんど報われない、ということです。
OpenAI 以外のモデルがどうスコアするか、あなたのタスクが OpenAI の169とどう比べられるか、採点者が何を評価するかは分かりません。そのためには、上記のように自分のエフォートスイープを実行し、目に見える数値を比較してください。GPT-6 Astra のハンズオンテストは、実施する価値のあるチェックの出発点です。
FAQ
LifeVal は何の略ですか?
OpenAI はページ上で名前を展開していません。日常生活(「Life」)タスクの評価(「Val」)です。介護、健康、教育、家計管理、個人財務、買い物、政府サービスにわたる169のエージェント型シナリオです。
GPT-6 Astra の LifeVal スコアは?
xhigh エフォートで平均報酬80.6%、これは OpenAI が Astra のローンチブログで使用した設定です。max エフォートでは Astra は82.5%、high では80.7%です。
LifeVal を自分で実行できますか?
いいえ。OpenAI はタスクセット、ルーブリック、採点者を公開していません。Apidog CLI のようなテストハーネスを使えば、自分のプロンプトでエフォート対コスト分析を近似できますが、LifeVal のスコアを再現することはできません。
LifeVal に Claude や Gemini は含まれていますか?
いいえ。どちらのチャートも GPT-5.2 から GPT-6 Astra までの OpenAI モデルのみを含みます。GPT-6.1 Sol と GPT-6.1 Terra も含まれていません。
LifeVal のコスト列はドル建てですか?
OpenAI はそれを API コストとラベル付けしていますが、単位を明示していません。タスクあたりのドル額としてではなく、設定同士を比較するために使ってください。例えば、GPT-5.6 max の9.65対 Astra max の20.04などです。
日常的なエージェントタスクにはどの推論エフォートを使うべきですか?
LifeVal では、medium または high が利得のほとんどを捉えます。GPT-6 Astra は high で80.7%、xhigh で80.6%なので、より多く支払う前に、自分のタスクで medium と high を試してください。