
JevはTypeSafe AIが提供する新しい種類のモデルです。テキストを生成することはありません。プログラムの状態を渡し、回答が必要な質問を宣言すると、調整された確率(はい/いいえの確率、リストからの選択、ルーブリック上のスコア)とともに、型付けされた回答を返します。TypeSafeはこれを「システムワンモデル」と呼び、その売り込みはシンプルです。ソフトウェア内部のAI呼び出しのほとんどは、散文を求めているのではなく、意思決定を求めているからです。LLMを分類器に接続し、その応答からラベルを抽出するパーサーを作成したことがあるなら、Jevはまさにその仕事のために作られています。これは構造化出力がその第一歩だったのと同じようにです。
これは2026年9月16日にVercel AI Gatewayに登場し、多くの開発者の目に触れることになりました。このガイドでは、Jevとは何か、言語モデルとどう異なるのか、3つの質問タイプ、直接およびGateway経由でJevを呼び出す方法、そしてルーティングロジックに触れる前にApidogでテストおよびモックする方法について説明します。
Jevとは
TypeSafeのローンチ記事では、Jevを「フロンティアインテリジェンスの関数呼び出し:非構造化された状態を入力し、型付けされた確率的決定を出力する」と説明しています。それを定義する3つの特性があります。
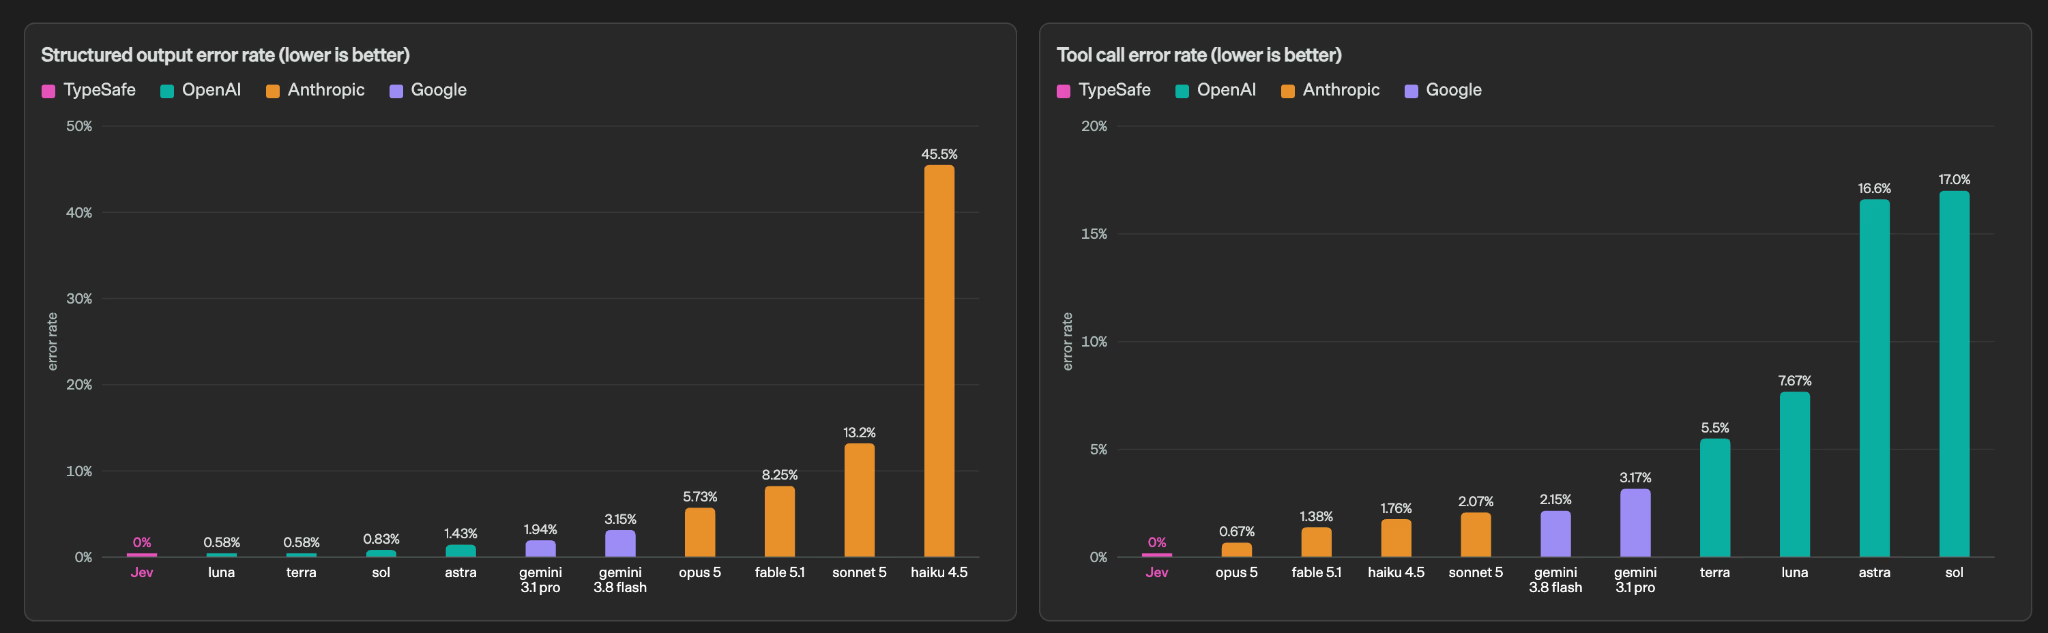
出力は型付けされており、呼び出し前に宣言されます。 各質問の形状を事前に定義します。モデルはその形状内でしか回答できないため、パースするものがなく、スキーマの不一致を検出する必要もありません。TypeSafeはこれを、Jevが「決して型エラーを起こさない」と表現しています。
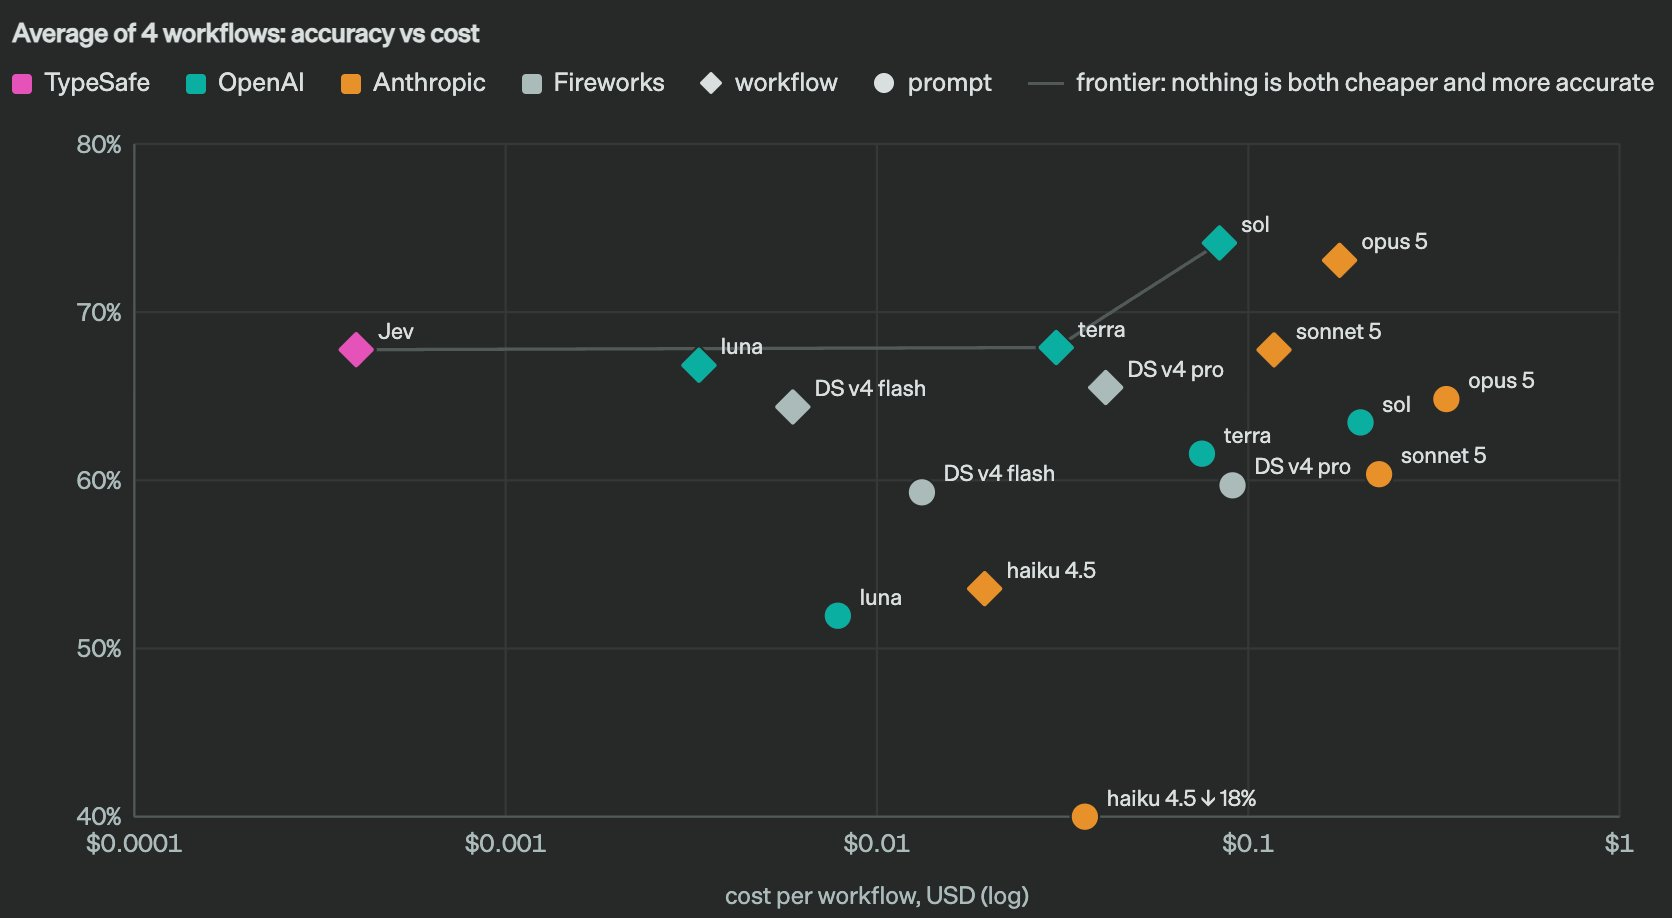
すべての回答には確率が付随します。 はい/いいえの質問はtrueを返しません。`0.97`のような数値を返します。選択肢は、オプション全体の分布を返します。TypeSafeは、これを「Reinforcement Learning for Calibrated Decisions(調整された決定のための強化学習)」と呼ぶ方法でモデルを訓練しました。そして、信頼度が高いほど精度が高いという主張があり、そのため閾値を設定できます。つまり、明確なケースは自動化し、不確実なケースは人間に回すことができます。
質問は1つのリクエスト内で並行して回答されます。 言語モデルは一度に1つのトークンを生成します。Jevは、宣言されたすべての質問を同じ状態に対して一度に評価します。これが、TypeSafeがエンドツーエンドの応答時間を70msから500msと提示する理由です。これらはベンダー独自の数値であり、ベンチマークとしてではなく、あなたのワークロードに対して検証すべき主張として扱ってください。
Jevと言語モデルとの違い
| 言語モデル | Jev | |
|---|---|---|
| 出力 | パースする自由なテキスト | 宣言された型付きの値 |
| サンプリング | シーケンシャル、トークンごと | すべての質問を並行して |
| 信頼度 | デフォルトでは公開されない | すべての回答に確率が付随 |
| 得意なこと | ライティング、チャット、要約 | 意思決定、ルーティング、スコアリング、検証 |
| 入力 | メッセージ | 構造化された状態: 文字列、オブジェクト、または配列 |
| 画像 | 多くの場合サポートされる | 今のところテキストのみ |
トレードオフは明確です。Jevは文字列生成を完全に放棄しています。チャットモデルではなく、ドキュメントを要約することもありません。Jevが適しているのは、アプリケーション内の「スマートなif文」の場所です。例えば、このチケットはどのチームが担当するか、このバグの深刻度はどれくらいか、この返信は安全に送信できるか、ビルドは成功したか、といったケースです。
3つの質問タイプ
Jevの直接APIは3つのプリミティブを公開しています。それぞれが、選択したキーの下のJSONオブジェクトです。
Noul: はい/いいえの確率。 TypeSafeがBoolean型に付けた名前です。回答が「はい」である確率を返し、コードでそれを閾値処理します。
{ "is_urgent": { "type": "noul", "instructions": "Does this message express urgency?" } }
応答: { "type": "noul", "noul": 0.99 }。
Choice: 名前付きセットから1つのオプションを選択。 criteriaはオプション名を説明にマッピングし、最大255オプションを指定できます。回答には、最も可能性の高い選択肢と、完全な分布および信頼度が含まれます。
{ "department": { "type": "choice", "instructions": "Which team should handle this?",
  "criteria": { "billing": "Charges, invoices, payment problems",
                "shipping": "Delivery status, delays, lost packages",
                "returns":  "Exchanges, refunds, damaged items" } } }
応答: { "type": "choice", "choice": "returns", "confidence": 1.0, "probabilities": { "returns": 1.0, "shipping": 0.0, "billing": 0.0 } }。
Score: 順序付けられたスケール上の位置。 criteriaは、2〜10段階のレベル説明の配列で、低い方から順に記述します。スコアは確率加重された位置であり、段と段の間に位置することもあります。
{ "bug_severity": { "type": "score", "instructions": "How severe is the reported issue?",
  "criteria": [ "Cosmetic; no impact to functionality",
                "Broken feature, but a workaround exists",
                "Blocking issue; no workaround" ] } }
応答: { "type": "score", "score": 1.3, "confidence": 0.54, "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }, "legend": { "0": "Cosmetic...", "1": "Broken...", "2": "Blocking..." } }。
命名のちょっとした注意点として、Vercel AI SDKでは、はい/いいえのタイプはbooleanと呼ばれ、回答フィールドはprobabilityです。TypeSafe独自のAPIに対してはnoulです。同じアイデアですが、キーが異なります。
Jevを呼び出す2つの方法
直接。 console.typesafe.ai/settings/keysでキーを取得し、Bearerトークンとともに`POST https://api.typesafe.ai/v1/systemone`を送信します。モデルIDは`jev-latest`で、現在は`jev-1.13.0`に解決されます。`jev-preview`は、公式かどうかにかかわらず、最新のビルドを指します。PythonとJavaScriptのSDKはクイックスタートに記載されていますが、生のエンドポイントは単一のPOSTであり、Apidogで使用する形式です。
Vercel AI Gateway経由。 モデルIDは`typesafe-ai/jev`で、AI SDK(バージョン7以降)の`experimental_evaluate`を使って呼び出します。評価ドキュメントからの注意点として、評価はAI SDKを通じてのみ利用可能であり、GatewayのOpenAI互換またはAnthropic互換のエンドポイントを通じては利用できません。もし、弊社のAI GatewayにおけるGPT-5.6 Solのウォークスルーのように、すでにGateway経由でモデルをルーティングしている場合は、これが自然な経路です。弊社のVercel AI SDKガイドでセットアップについて説明しています。
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: { refunded: { type: 'boolean', instructions: 'Was a refund issued?' } },
});
// result.answers.refunded -> { type: 'boolean', probability: 0.99 }
curlを使った最初のリクエスト
これは、1回の呼び出しですべての3つのタイプを使ってサポートメッセージをトリアージします。
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My card was charged twice for one order and I need this fixed today.",
    "questions": {
      "department": { "type": "choice", "instructions": "Which team handles this?",
        "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
      "urgency": { "type": "score", "instructions": "How urgent is this?",
        "criteria": ["low", "medium", "high"] },
      "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
    }
  }'
応答には、`model`、質問IDでキー付けされた`answers`オブジェクト、および`input_tokens`と`output_tokens`を含む`usage`が含まれています。`answers.department.choice`、`answers.urgency.score`、`answers.wants_refund.noul`を読み取り、閾値を適用してください。
ApidogでJevをテストおよびモックする
確率を返すモデルは、テストのあり方を変えます。文字列をアサートするのではなく、数値が特定の線を越えることをアサートします。Apidogは、これを一度きりのcurlではなく、保存可能で繰り返し実行できるチェックにします。
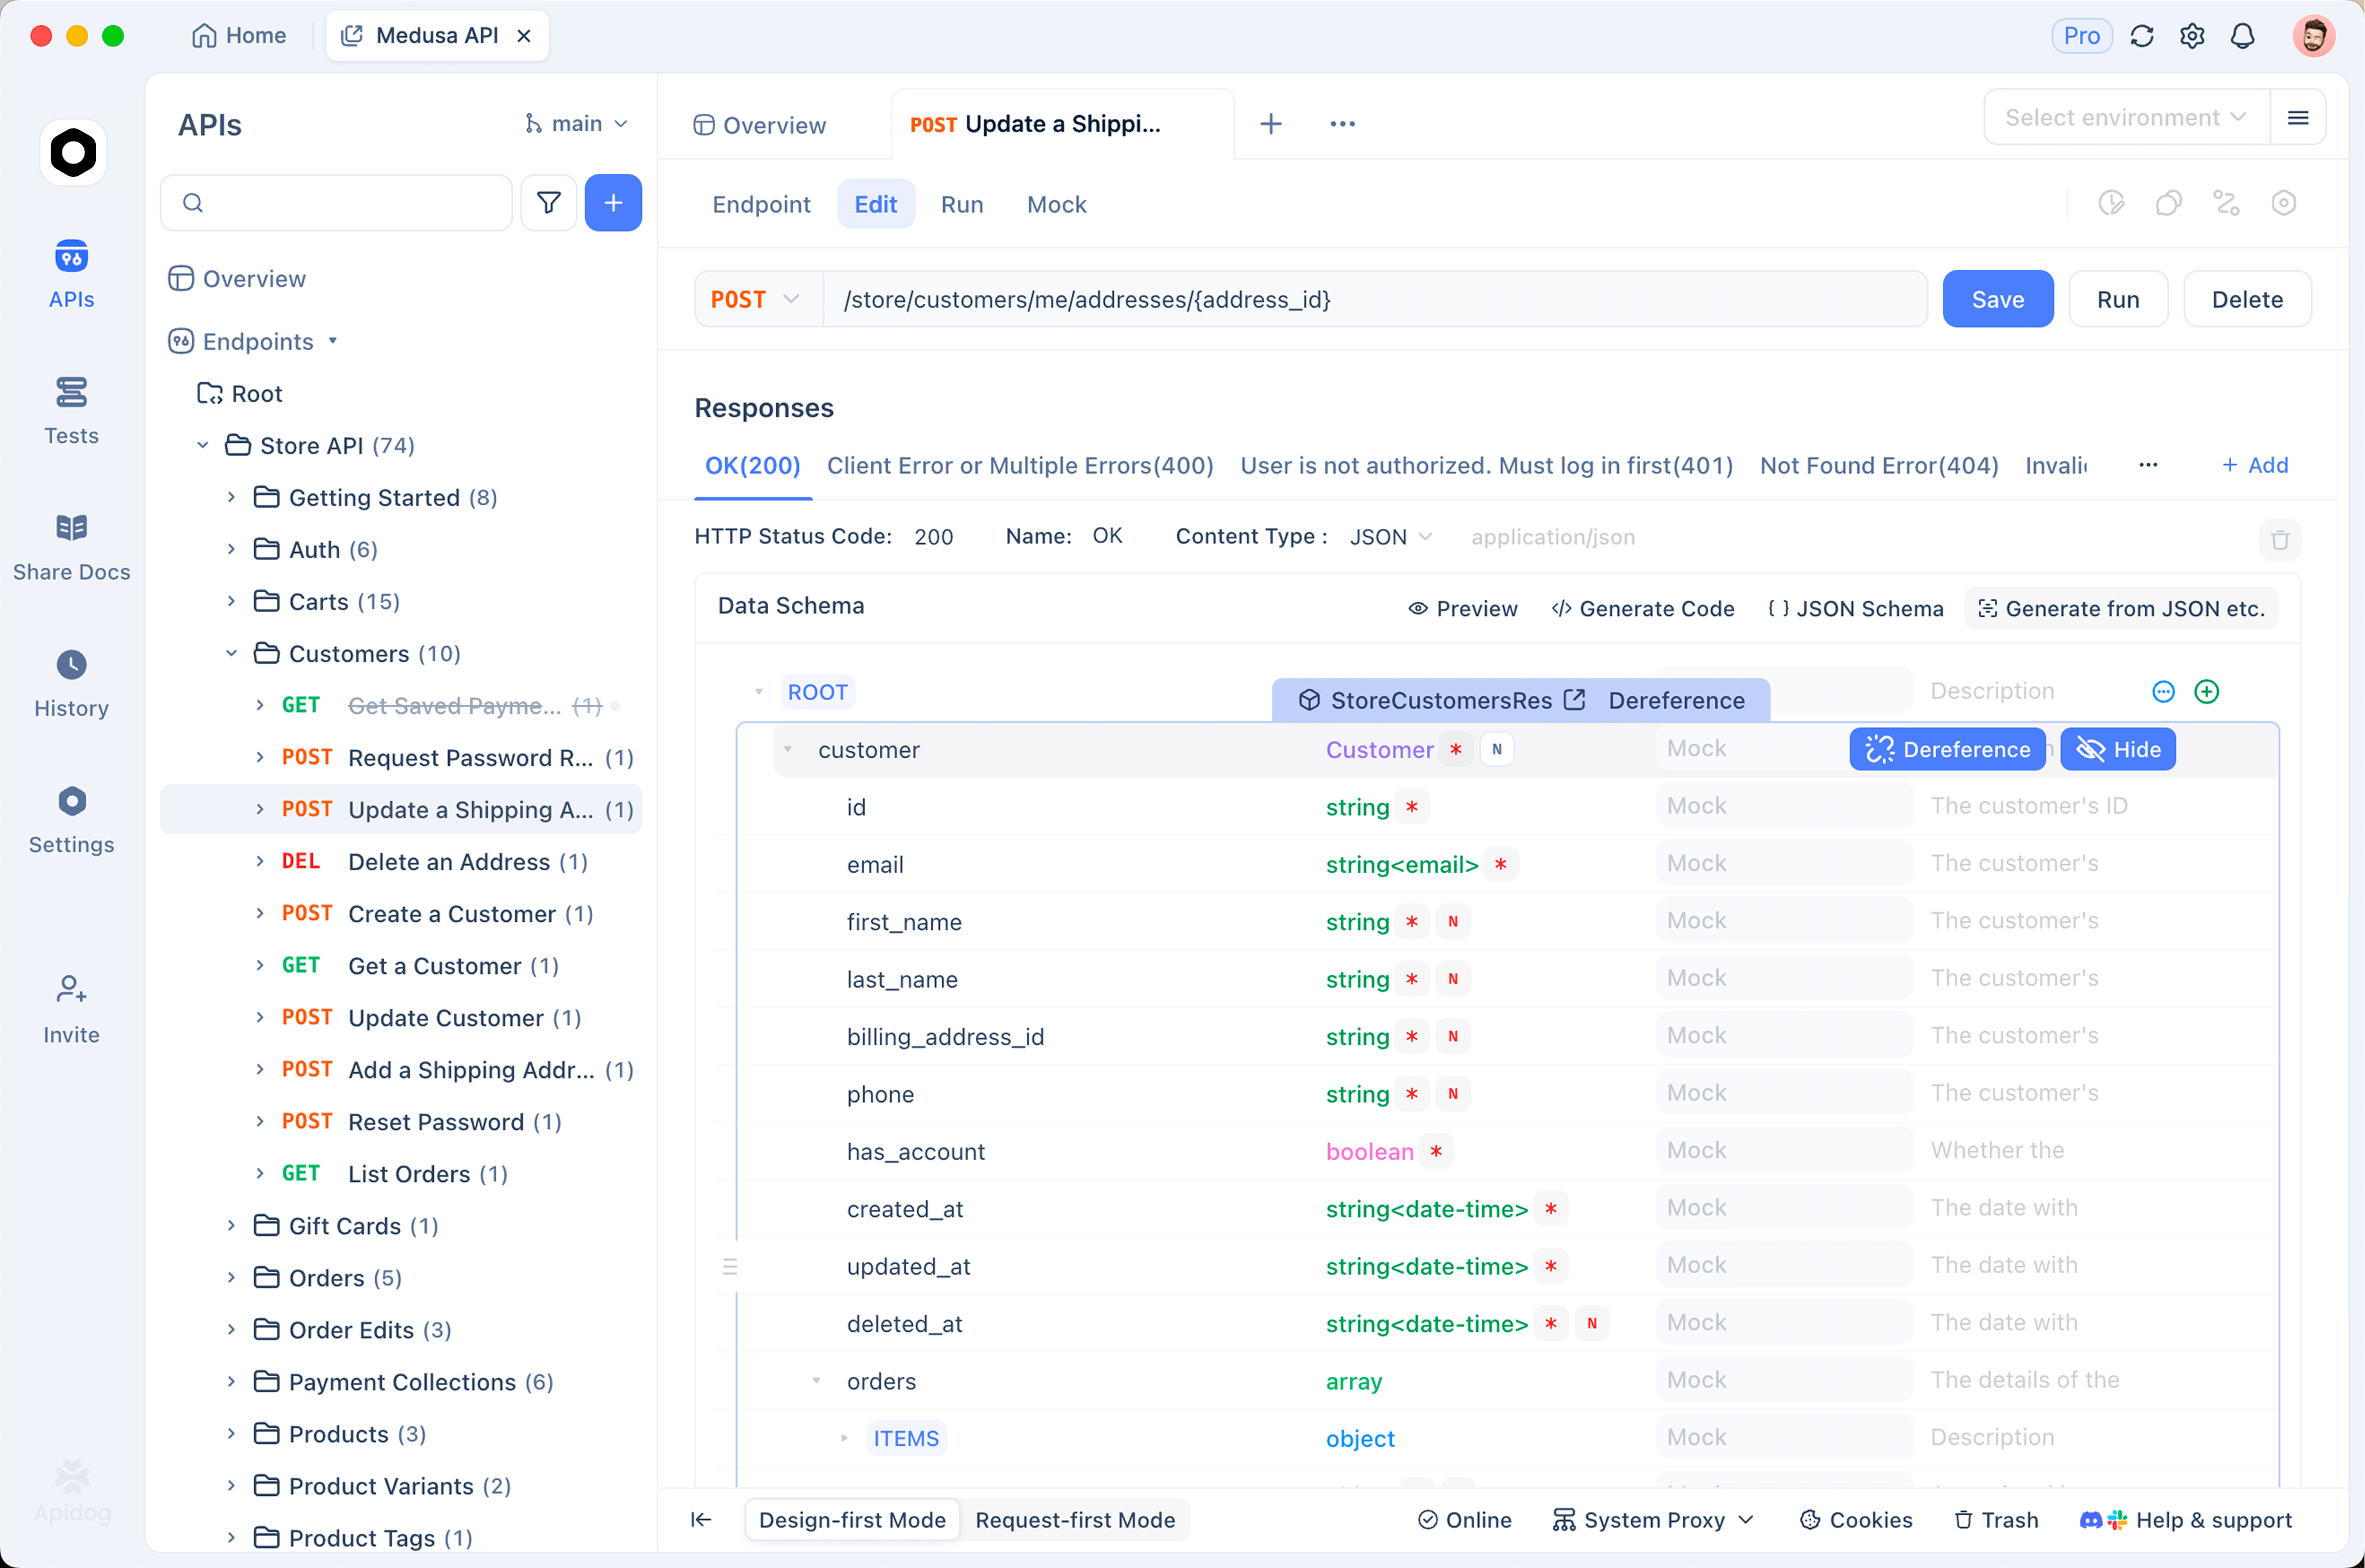
キーを保存。 環境管理を開き、`TypeSafe`という名前の環境を作成し、ローカルフィールドに実際の値を持つ`TYPESAFE_API_KEY`を追加します。これにより、キーはあなたのマシンに残り、チームと同期されることはありません。環境とシークレット変数に関するガイドでスコープルールについて説明しています。
リクエストを作成。 新しいリクエスト、`POST https://api.typesafe.ai/v1/systemone`、認証タイプはBearer Tokenで`{{TYPESAFE_API_KEY}}`を使用し、JSONボディはcurlの例からコピーします。これを送信し、応答パネルで回答を読み取ります。
テキストではなく、決定をアサート。 ポストプロセッサーのアサーションを追加します。例えば、`answers.department.choice`が`billing`と等しいこと、`answers.wants_refund.noul`が`0.9`より大きいこと、`answers.urgency.score`が`1.5`より大きいことなどです。これにより、Jevの動作の回帰や、独自の基準の文言に問題があった場合、チケットを静かに誤ルーティングする代わりにテストが失敗します。
フロントエンド向けにモック。 応答をモックとして保存すると、トークンを消費したりモデルを待ったりすることなく、安定した`answers`オブジェクトに対してチケットUIを構築およびデモできます。形状が宣言されているため、モックと実際の応答が乖離することはありません。
シナリオとして保存。 いくつかの状態、例えば穏やかなメッセージ、怒りのメッセージ、曖昧なメッセージを連結し、曖昧なケースで信頼度が低下することを確認します。これは、あなたの閾値が正しく機能していることを示すチェックです。Apidogをダウンロードしてこれを設定してください。無料プランは4人までのチームをカバーします。
料金、制限、エラー
TypeSafeのモデルページより:
- 料金: 入力トークン100万個あたり0.042ドル。出力トークンは課金されません。Gatewayも同じく入力100万個あたり0.042ドルです。
- レート制限: 1秒あたり25万トークン、1分あたり1,200リクエスト(動的に調整されます)。
- コンテキスト: 1リクエストあたり64kトークン。そのうち32kは`state`と最長の質問用です。
- 入力: テキストのみ。文字列、JSONオブジェクト、またはテキストの配列。画像、音声、ビデオは不可。
- 言語: 英語が最適です。他の言語でも機能しますが、精度は低下します。
エラーはHTTPステータスコードとして返されます。キーがないか無効な場合は`401`、ボディの検証に失敗した場合(1レベルのScore、基準のないChoiceなど)は`422`、レート制限の場合は`429`、サービスが過負荷の場合は`529`です。最後の2つの場合はバックオフして再試行してください。SDKはデフォルトでこれを実行します。
よくある質問
JevはLLMの代替ですか?
いいえ。Jevは、意思決定を求め、そのためにテキストをパースしていたLLM呼び出しの一部を置き換えるものです。生成、チャット、要約には引き続き言語モデルが必要です。
Jevはハルシネーション(幻覚)を起こしますか?
間違った回答を出す可能性はありますが、宣言されたスキーマ外の回答を生成することはありません。TypeSafeの主張は、スキーママッチングが保証されているため、「ハルシネーションを起こした」ラベルは不可能であるというものです。ただし、信頼度の低い間違ったラベルは依然として発生する可能性があり、それが確率が重要である理由です。
「調整済み(calibrated)」とは実際には何を意味しますか?
もしモデルが`0.9`と答えれば、その種の質問に対して約90%の確率で正解であるはずです。これが、閾値を設定し、それ以上のケースを自動化できる理由です。その数値を信頼する前に、自分のデータでテストしてください。Apidogにラベル付けされた状態を伴うシナリオを保存するのは、そのための安価な方法です。
Jevを使用するためにVercelが必要ですか?
いいえ。api.typesafe.aiの直接APIは、Bearerキーがあれば単独で機能します。Vercel AI Gatewayは、すでにAI SDKを使用している場合の利便性であり、`experimental_evaluate`をサポートする唯一の経路です。いずれにしても、宣言された形状の背後にあるJSON Schemaの基本を知っておく価値はあります。
Jevが適合する場面
質問に固定された回答セットがあり、それとともに確率が必要な場合(ルーティング、分類、スコアリング、検証、ガードレールなど)はJevを利用してください。言葉を必要とするすべてのことには言語モデルを使用してください。形状を宣言し、Apidogで閾値をテストし、信頼度で自動化するものを決定しましょう。