
Grok 4.6は、xAIの最先端言語モデルで、2026年8月12日にリリースされました。Grok 4.5を基盤とし、長時間稼働するエージェント、エージェントによるコーディング、インタラクティブまたは視覚的な作業に重点を置いています。50万トークンのコンテキストウィンドウを提供し、入力トークン100万あたり2ドル、出力トークン100万あたり6ドルです。Artificial Analysis Intelligence Indexでは61点を獲得し、OpenAIのGPT-5.6 Solと同スコアで、AnthropicのClaude Fable 5に1点差で迫り、現在インテリジェンスの最前線にあるモデルとしては最も安価です。
これが1段落での回答です。この記事の残りの部分では、Grok 4.5から実際に何が変わったのか、ベンチマークの数値が何を意味するのか、今日どこでこのモデルを使用できるのか、そしてLLM APIを構築しているあなたにとってそれが何を意味するのかを解説します。もし最後の部分があなたに当てはまるなら、Apidogは、クライアントを最初に書くことなくGrok 4.6を試すのに便利な、LLM APIコールを設計、テスト、モックするための無料ワークスペースを提供します。
要約
- リリース日: 2026年8月12日、xAIより。
- 焦点: 長期的なエージェント、多段階コーディング、インタラクティブおよび視覚的作業。xAIによると、このモデルは進行する前により頻繁に自己テストを行い、自身の作業を検証します。
- 仕様: 50万トークンのコンテキストウィンドウ、知識カットオフは2026年2月1日。
- 価格: 入力100万トークンあたり2ドル、出力100万トークンあたり6ドル。高速版は2倍の費用。最初の1週間はGrok BuildおよびCursorで2倍の利用が含まれます。
- ベンチマーク: Intelligence Index 61点 (GPT-5.6 Solと同点)、DeepSWE (54 → 65.9) およびAPEX-Agents (47.1 → 57.5) で4.5から大幅に向上。
- 利用可能場所: xAI API、Grok Build、Cursor、OpenRouter、Vercel、Cloudflare。
Grok 4.6の概要
| 仕様 | Grok 4.6 |
|---|---|
| 開発元 | xAI |
| リリース日 | 2026年8月12日 |
| コンテキストウィンドウ | 500,000トークン |
| 知識カットオフ | 2026年2月1日 |
| 入力/出力価格 | 100万トークンあたり2ドル / 6ドル |
| 高速版 | 2倍の価格 |
| インテリジェンスインデックス | 61 (GPT-5.6 Sol: 61, Claude Fable 5: 62) |
| 利用可能場所 | xAI API, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
Grok 4.5と比較して実際に新しい点
Grok 4.6はアーキテクチャの公開ではなく、トレーニングに関する話です。xAIによると、このモデルはGrok 4.5よりも長い追加トレーニング期間を経ており、主に以下の3つの要素が貢献しています。
- 推論と高度な技術的概念を対象とした、厳選されたモデル生成データ。
- xAIが実際の開発セッションでのトレーニングを開始して以来継続している、コーディング重視の高品質なエンジニアリングデータセット。
- 推論およびドメイン固有の領域全体で再生成された、改善されたオプティマイザとトレーニングレシピ、および教師ありファインチューニングの軌跡。
開発者が気づく行動の変化は、自己検証です。長期間のエージェント実行中、Grok 4.6は未検証の仮定に基づいて突き進むのではなく、次のステップに進む前に自身の作業をチェックし、書いたばかりのテストを実行し、編集したばかりのファイルを再読み込みします。xAIはまた、インタラクティブおよびビジュアルプロジェクトにおける最初の試みも改善されたと報告しています。ダッシュボード、小さなアプリ、UI作業などが、最初の段階でより実用に近いものになります。
もしGrok 4.5のトレーニングアプローチに興味があるなら、Cursorセッショントレーニングが開発者にとって何を意味したかに関する私たちの解説が、このモデルが構築されている系統をカバーしています。
重要な差分を伴うベンチマーク
ベンダーの発表する数値は懐疑的に見るべきですが、4.5から4.6への差分は意味を持つほど大きいです。競合他社の状況を含め、以下の図をご覧ください。
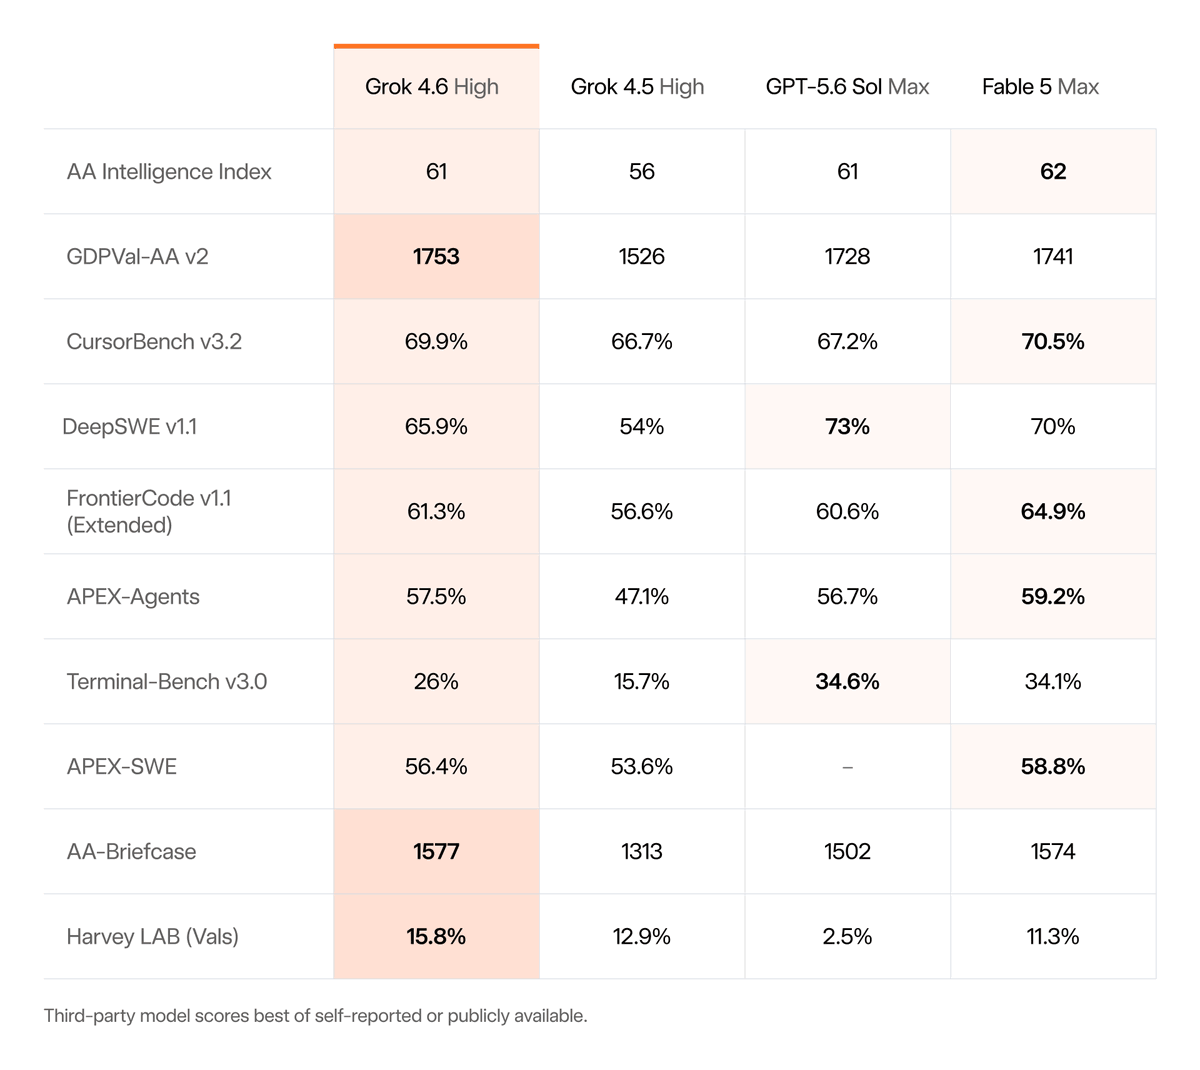
3つの重要なポイント:
- エージェントの性能差が縮まった。APEX-Agentsで10.4ポイント上昇したことで、Grokは「明らかに劣っていた」状態からFable 5 Maxの1.7ポイント差にまで迫り、GPT-5.6 Sol Max (56.7%) をわずかに上回った。
- リポジトリ規模のコーディングが最も改善された。DeepSWEが約12ポイント上昇したことは、複数ファイルの変更でつまずくモデルと競争力のあるモデルとの違いを示しているが、Sol Maxは依然としてそのベンチマークで大差をつけている。
- 独立した数値もこの話を裏付けている。Artificial Analysisは、エージェント評価におけるタスクあたりの平均コストを0.84ドルと測定し、これは最先端モデルの中で最も低く、専門的な知識作業におけるGDPval-AA v2でのEloスコアは1753点だった。
xAIのベンチマーク発表をどのように読み解くべきか、そして前世代にも適用された注意点については、Grok 4.5ベンチマーク分析をご覧ください。
価格: 最先端のバリュープレイ
Grok 4.6はGrok 4.5の価格設定を維持しています。入力トークン100万あたり2ドル、出力トークン100万あたり6ドルです。現在ベンチマークで並ぶモデルと比較すると、その差は歴然です。
| モデル | 出力価格 / 100万トークン |
|---|---|
| Grok 4.6 | $6 |
| Claude Opus 4.8 | $25 |
| GPT-5.6 Sol | $30 |
これは、複合的なインテリジェンスインデックスでGPT-5.6 Solと同等のモデルでありながら、出力側で5倍の価格差があることを意味します。安価なトークンが自動的に安価なタスクを意味するわけではありません。レビューと修正が必要な弱い実行は、トークン料金以上のコストがかかりますが、独立したタスクあたりのコストデータは、その効率が実際の低価格だけでなく、真実であることを示唆しています。
2倍の価格(4ドル/12ドル)の高速版は、レイテンシーに敏感なインタラクティブな利用を目的としています。そして8月19日まで、Grok BuildとCursorのユーザーは、モデルを試すために2倍の利用量が無料で提供されます。
今日Grok 4.6を利用できる場所
- console.x.ai経由のxAI API、OpenAI互換。当社のGrok 4.5 APIガイドが直接適用されます。モデル名を変更するだけです。
- Cursor、モデルオプションとして利用可能。CursorはxAIの発表と並行して独自のローンチノートを公開しました。
- Grok Build、xAI独自のエージェントワークスペース。ローンチ週の2倍利用ボーナス付き。
- OpenRouter、Vercel、Cloudflare、複数のモデルを1つのゲートウェイ経由でルーティングするチーム向け。OpenRouterでは
x-ai/grok-4.6として掲載されています。
ここで消費者向けの別の展開を解きほぐす必要はありません。これは開発者優先のリリースであり、評価する最も迅速な方法はAPIまたは既にこれを搭載しているIDEを介することです。
制限事項と未解決の疑問
リリース週の評価では、見出しの数値と並んで注意点も提示する必要があります。
- ベンチマークはほとんどがベンダー報告です。 Artificial Analysisは概ね一致する独立したスコアを発表していますが、具体的なコーディング数値(DeepSWE、FrontierCode、CursorBench)はxAI自身のローンチテーブルからのものです。Grok 4.5のローンチ数値は独立したテストでは部分的にしか持続しなかったため、ここでも平均への回帰を想定してください。
- コンテキストウィンドウは最先端モデルの中で最小です。 50万トークンはほとんどの実際のワークロードをカバーしますが、GPT-5.6 Solは105万、Claude Fable 5は100万を提供します。もし単一の呼び出しでモノレポ全体や膨大なドキュメントセットを処理する場合、この差は重要です。
- Solは最も困難な領域で依然としてリードしています。 DeepSWEの7ポイントの差は、大規模な既存のコードベース全体での完全自律作業がGPT-5.6 Sol Maxで依然として強力であることを意味し、それは最も経済的に価値のあるエージェントのワークロードです。
- エコシステムの成熟度が遅れています。 xAIプラットフォーム上のバッチ処理、プロンプトキャッシュ層、使用量制御は、OpenAIやAnthropicの同等製品よりも歴史が浅いです。OpenAI互換性はその大部分をカバーしますが、すべてではありません。
これらのどれも失格の理由ではありません。これらはGrok 4.6がどこに位置するかを定義しています。それは、評判に基づいて採用するデフォルトではなく、真剣に評価すべき価格性能比のオプションです。
API開発者にとっての意味
戦略的な見方: 最先端には今、真の価格競争相手が現れました。今回のリリースまでは、GPT-5.6 Solレベルの出力を得るには、出力トークン100万あたり25~30ドルを支払う必要がありました。Grok 4.6はそれを6ドルで実現し、特にエージェントループの計算を変えます。タスクごとに40回のモデル呼び出しを行うエージェントは、出力価格が5倍違うことを即座に実感するでしょう。
実用的な観点から言えば、OpenAI互換APIがあるということは、評価に全速力で取り組む必要はなく、午後のひとときで済むということです。既存のクライアントをhttps://api.x.ai/v1に向け、実際のワークロードを実行して比較してください。Apidogでその比較を設定すれば、GPT-5.6、Claude、Grok 4.6のリクエストを1つのプロジェクトで並行して管理でき、プロバイダーごとの環境や、3つ全ての出力品質、トークン使用量、レイテンシをチェックするアサーションを設定できます。これは、いずれかのモデルに本番ワークロードをコミットする前に役立つ証拠となります。
このモデルのエージェントへの注力は、ツール呼び出しの正確性に対する期待も高めます。Grokとの統合が関数呼び出しを伴う場合、モデルが生成するペイロードをテストし、単に生成されたテキストだけでなく、その正当性を確認してください。
よくある質問
Grok 4.6を一句で表すと? xAIの2026年8月発表の最先端モデルで、長時間稼働のエージェントとコーディングに特化し、50万トークンのコンテキストウィンドウと最先端レベルのベンチマークスコアを持ち、競合他社の出力価格の約5分の1で提供されます。
Grok 4.6はGPT-5.6より優れていますか? Artificial Analysis Intelligence Indexでは両者ともに61点で同点です。GPT-5.6 Sol Maxはリポジトリ規模のコーディング(DeepSWE)でリードしていますが、Grok 4.6はAPEX-Agentsでわずかに優れており、出力トークンあたりのコストは約5分の1です。
Grok 4.5と4.6の違いは何ですか? 価格もAPIも同じですが、モデルは大幅に改善されています。DeepSWEで+11.9点、APEX-Agentsで+10.4点向上し、長時間のタスク中に自己検証を行う新しい傾向が見られます。
Grok 4.6を無料で試すことはできますか? Grok BuildとCursorでは、ローンチ週に2倍の使用量が無料で含まれます。また、Grok 4.5を無料で利用するためのガイドに記載されている方法は、Grok 4.6にもほとんど適用されます。