
GPT-Live-1.1は、OpenAIの全二重音声モデルで、2026年11月20日からAPIで利用可能になりました。話しながら聞き取りを行い、推論やツール呼び出しは任意のバックエンドモデルに委任し、料金は分数課金です。アクティブ時間が1分あたり0.05ドル、スタンバイ時間が1分あたり0.02ドルとなっています。アクセスはRealtime APIではなく、単一のエンドポイントv1/live/sessions経由で行います。
以前の記事「GPT-Liveとは何か」では、開発者がAPIを呼び出せるようになる前のChatGPT音声機能を取り上げました。本ガイドではAPIモデルについて、新機能、料金、セッションの仕組み、そしてGPT-Realtimeとの比較を解説します。
GPT-Live-1.1とは?
GPT-Live-1.1は、別個のバックエンドモデルが思考を担当しながら、リアルタイムで音声会話を行う音声モデルです。音声とテキストを受け取り、音声とテキストを返し、話している間も聞き取りを続けるため、相手は文中で割り込んだり詳細を追加したりできます。モデルIDはgpt-live-1.1で、ストリーミングと関数呼び出しをサポートしています。
GPT-Live-1.1のモデルページでは、「多言語会話向けの全二重音声モデル」と説明されています。全二重(フルデュプレックス)とは、片側が待機するトランシーバー方式とは異なり、電話のように音声が双方向に同時に流れることを意味します。
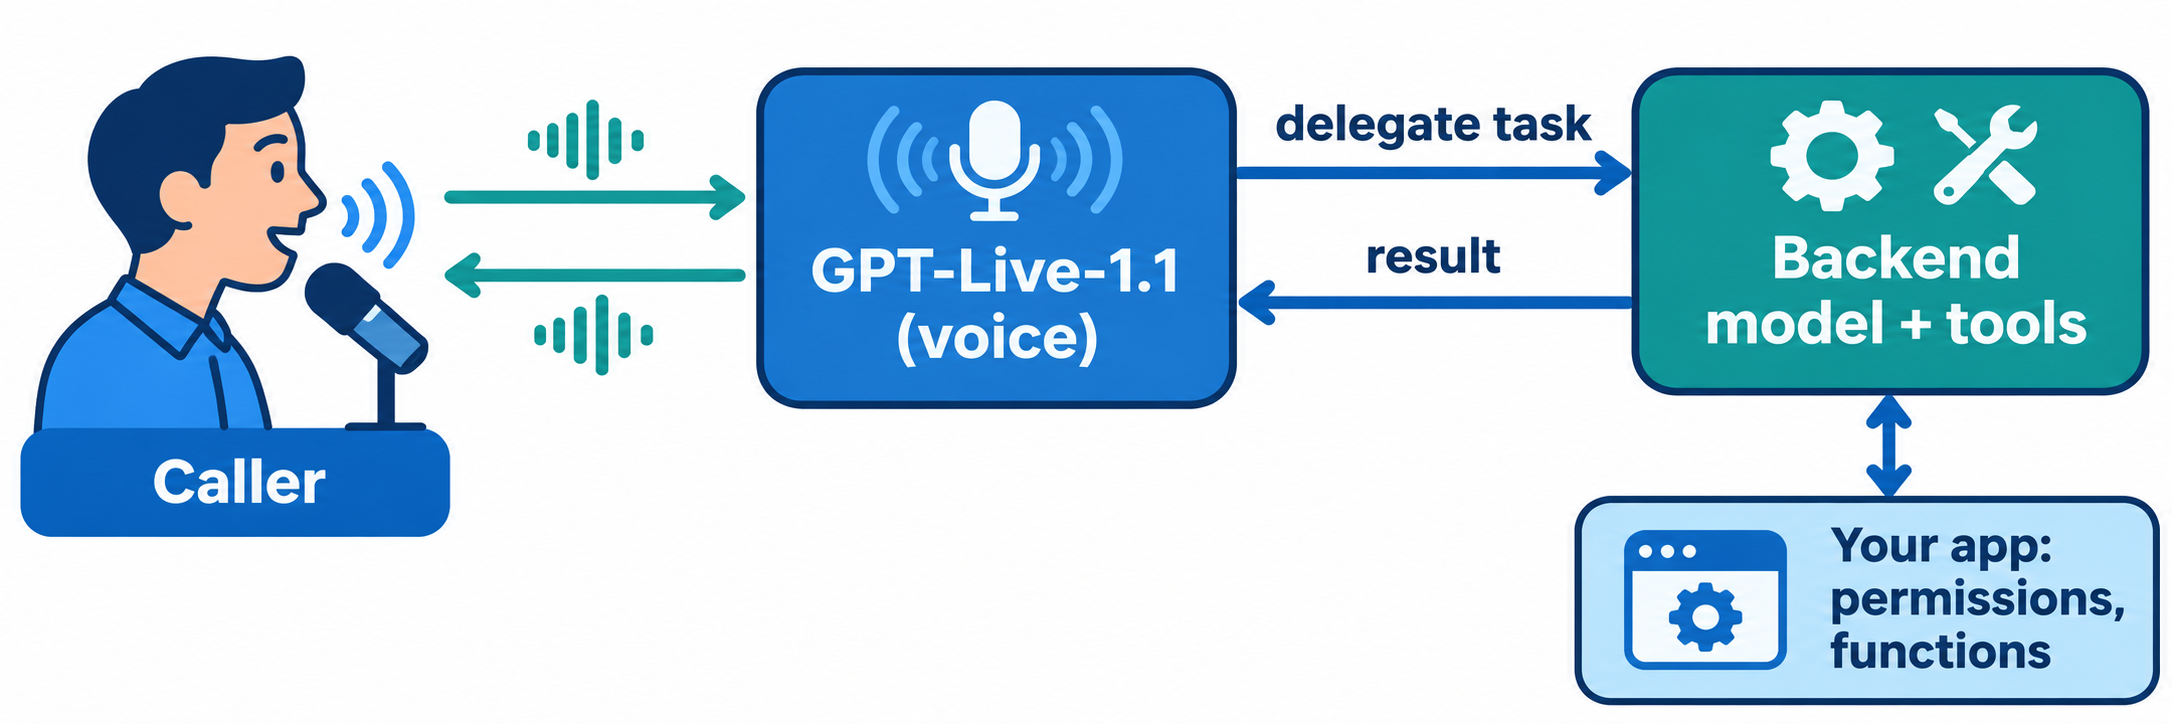
設計のもう一つの柱が委任(デリゲーション)です。GPT-Liveはリクエストに本格的な処理が必要かどうかを判断し、バックエンド(OpenAIのResponsesモデルや独自のエージェント)に処理を送り、バックエンドの実行中も会話を続け、その後結果を音声で説明します。
GPT-Live-1からの変更点
GPT-Live-1.1は、GPT-Live-1と同じエンドポイント、料金、機能セットを維持しています。変更点は音声品質とタスク処理にあります。OpenAIがモデルドキュメントおよびXでの発表に記載している内容は以下の通りです:
| 領域 | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| 音声の文字起こし | ベースライン | モデルページにより、より高精度 |
| 多言語間のアクセントと声 | ベースライン | モデルページにより、より一貫性が向上 |
| アイドルセッション | ページに記載のスタンバイ料金 | スタンバイが新オプションとして発表、$0.02/分 |
| タスク完了 | ベースライン | OpenAIの発表により「タスクをさらに確実に完了」 |
| エンドポイント | v1/live/sessions |
v1/live/sessions |
| 料金(アクティブ) | $0.05/分 | $0.05/分 |
| レート制限 | 同時セッション数 | 同時セッション数の上限が別途設定 |
OpenAIは文字起こしや信頼性の向上に関するベンチマーク数値を公表していないため、実際に測定するまではベンダーの主張として扱うべきです。また、OpenAIの発表ではスタンバイがこのリリースでの新機能とされていますが、GPT-Live-1のページにも現在は同じ0.02ドルのスタンバイ料金が記載されています。
両モデルはエンドポイントと料金を共有しているため、切り替えはセッションのmodelをgpt-live-1.1に設定することから始められます。その後、独自の音声評価を再実行して、自分のトラフィックでの改善を確認してください。
GPT-Live-1.1の料金
GPT-Live-1.1は、トークンではなくセッション時間に基づいて音声セッションの課金が行われます。以下は2026年11月20日時点で確認したOpenAIの料金ページに記載のレートです:
| 項目 | 料金 |
|---|---|
| アクティブセッション時間 | 1分あたり0.05ドル |
| スタンバイセッション時間 | 1分あたり0.02ドル |
| バックエンドモデルとツール | 各モデルの通常料金で別途課金 |
コストを見積もる際に注意すべき課金の詳細がいくつかあります:
- 秒単位の課金。 所要時間は次の丸1分に切り上げられません。
- スタンバイはWebRTCのみ。 低いレートは、推論が一時停止しているWebRTCセッションに適用されます。
- 初期化料金。 WebRTCセッションの作成時にはセットアップ中に15秒分が課金されますが、セッション稼働後は時間料金から相殺されます。
- バックエンドは2つ目の請求。 委任されたResponsesトークンやツール呼び出しにも料金が発生します。
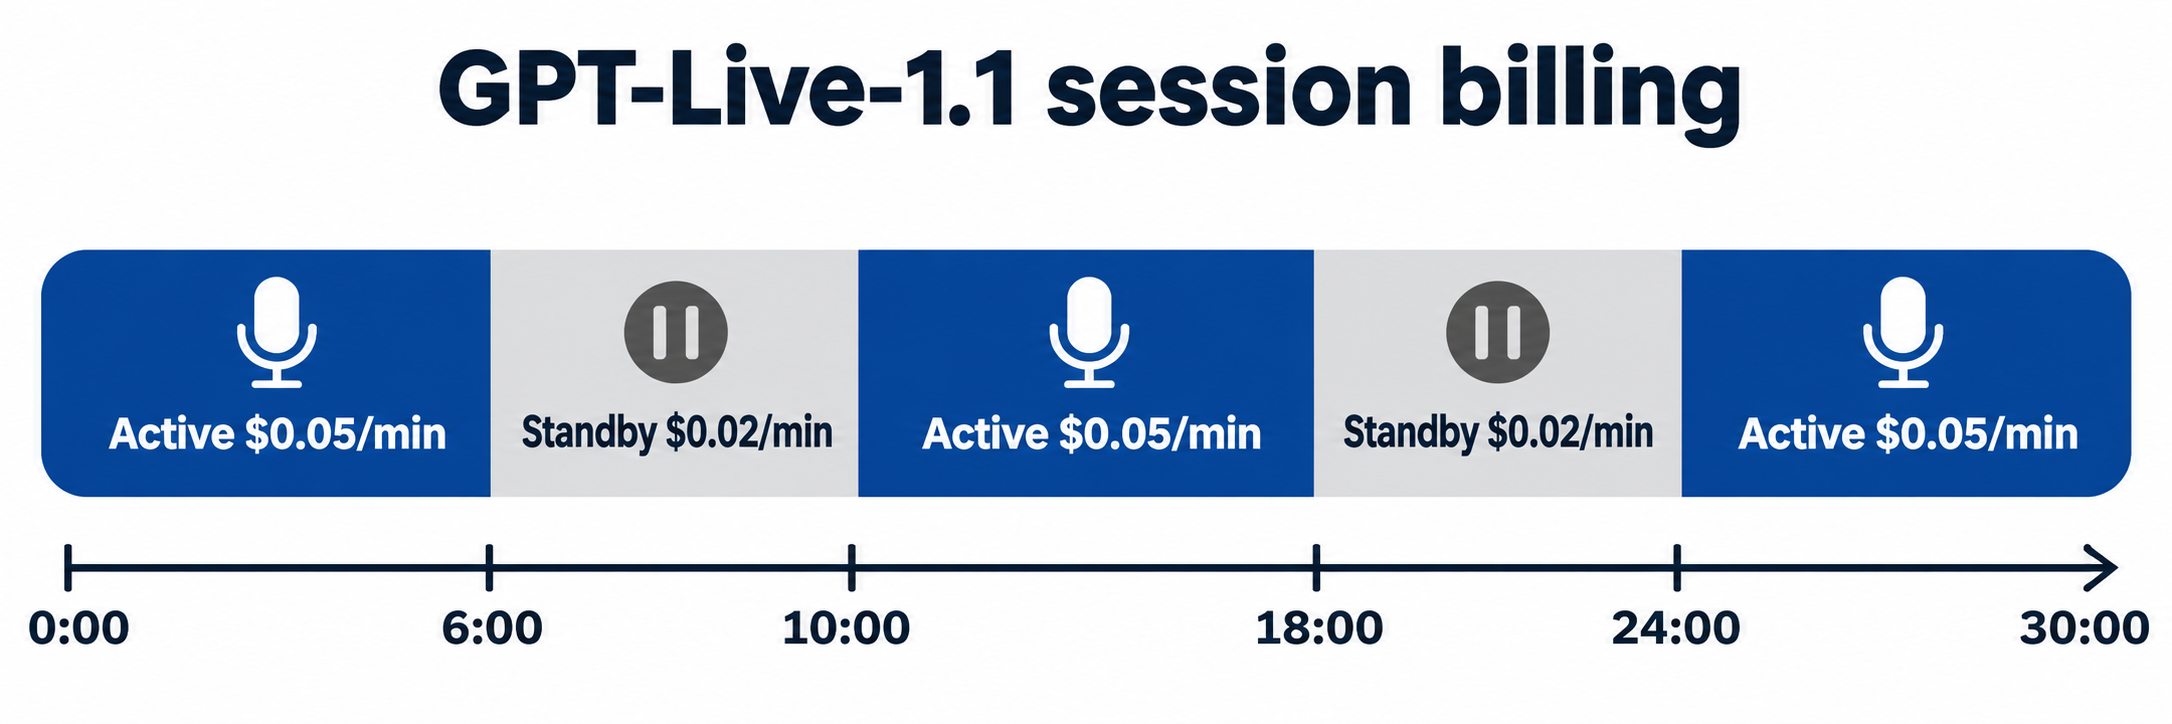
上記タイムラインに基づく計算例:30分間のサポートセッションで、20分がアクティブ、発信者が調べ物をしている間の10分がスタンバイだったとします。音声コストは 20 × $0.05 + 10 × $0.02 = $1.20 です。スタンバイを使わない場合、同じセッションは 30 × $0.05 = $1.50 かかります。さらに、バックエンドモデルが委任されたタスクに費やしたコストを加算してください。
GPT-Live-1.1の仕組み:音声と委任
GPT-Liveアプリケーションは2つの部分で構成されます。スタートガイドでは、以下のように分けられています:
- GPT-Liveが会話を担当。 聞き取り、発話を行い、いつバックエンドに支援を求めるべきかを判断します。話し方と委任のタイミングについての短いプロンプトを与えます。
- バックエンドが委任されたタスクを担当。 推論やツール呼び出しを行い、GPT-Liveが音声で伝えられるよう結果を返します。詳細な指示、ビジネスルール、ツールのワークフローはここに置きます。
- アプリケーションがリスクのある部分を担当。 権限の確認、確認の収集、自社システムに触れる関数の実行、タスクの進捗保存を行います。
セッション作成時に2つの委任モードのいずれかを選択します。セッション途中でのモード切り替えはできません:
| モード | バックエンドを実行する主体 | 選ぶべきケース |
|---|---|---|
| Responses委任 | OpenAIが設定したResponsesモデルを呼び出し、コンテキストと結果を渡す | GPT-Liveにバックエンドへのリクエスト管理を任せたい場合 |
| クライアント委任 | アプリケーションが任意のモデル、エージェント、サービスを実行し、結果を送り返す | 結果の検証、マスキング、結合が必要な場合、またはOpenAI以外のバックエンドを使う場合 |
委任ガイドでは、まずResponses委任から始めることが推奨されています。クライアント委任は、既存のテキストエージェントに音声インターフェースを追加するチームに向いています。
最初のGPT-Live-1.1セッションを作成する
GPT-Liveには専用のエンドポイントがあります。モデルページではv1/live/sessionsがサポート対象として記載され、Chat Completions、Responses、v1/realtimeは非対応とされています。OpenAIは音声にWebRTCを推奨しており、WebSocketsとSIPが代替手段として挙げられています。
クイックスタートのWebRTCフローは、次の5ステップで実行されます:
- ブラウザがマイクへのアクセスを要求し、そのトラックをピア接続に追加します。
- データチャンネルを作成し、SDPオファーを生成します。
- ブラウザがオファーをサーバーに送信します。
- サーバーが
sessionとtransport: { type: "webrtc", sdp }をAPIキーとともにPOST /v1/live/sessionsへ送信します。 - ブラウザが返されたSDPアンサーを適用し、
session.startedを待ちます。
以下はOpenAIのTypeScriptサンプルからのサーバー側の呼び出しで、セッション設定部分のみを抜き出したものです:
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
APIキーはサーバー側に保持し、データチャンネルでsession.startを送信しないでください。HTTPリクエストの時点でセッションは開始されます。OpenAIはまた、会話、委任、バックエンドのツール動作を観察できるローカルサンプルアプリ「OpenAI Live Console」も公開しています。
スタンバイモード:アイドルコストを削減
スタンバイは、誰も話していない間もWebRTC接続を開いたままにし、誰かが話し始めると推論を再開します。接続とセッションIDは維持され、セッション再開時には会話履歴が復元されます。
有効化には、セッションの2つのフィールドを設定します:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"は、推論を開始する前に発話を待ちます。idle_timeout_sは5から60の整数を指定します。入力または出力のトランスクリプトがこの秒数の間なければ、セッションはスタンバイに移行します。vad_thresholdは0から1の範囲で、デフォルトは0.5です。高い値ほど、復帰にはより明確な発話の証拠が必要になります。
状態を追跡するにはsession.pausedとsession.resumedをリッスンし、マイクトラックはアクティブなままにしてください。セッション管理ガイドに記載のトレードオフとして、スタンバイ復帰後の短い発話への最初の応答には時間がかかる場合があります。長い空白が予想される場合は、セッションを閉じて新規に開始する方がスタンバイより低コストになることもあります。
GPT-Live-1.1とGPT-Realtimeの比較
OpenAIの音声エージェントガイドは、アーキテクチャによって選択肢を整理しています。GPT-Liveは、別個のバックエンドを持つ全二重会話に適しています。Realtime APIは、1つのモデルが単一のセッション内で聞き取り、推論、ツール呼び出し、発話を行う構成に適しています。
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| エンドポイント | v1/live/sessions |
v1/realtime |
| 設計 | 音声フロントエンド+委任されたバックエンド | 単一のspeech-to-speechモデル |
| 入力 | 音声、テキスト | テキスト、音声、画像 |
| 課金 | $0.05/分(アクティブ)、$0.02/分(スタンバイ) | トークン単位:音声トークン100万あたり入力$32、出力$64 |
| バックエンドコスト | 別途課金 | トークン価格に含まれる |
| 最適な用途 | 既存のテキストエージェントへの音声追加 | 自己完結型の音声エージェント |
分数課金により、GPT-Liveの音声コストは長時間の通話でも予測しやすくなっています。Realtimeのトークン課金は流れる音声とテキストの量に応じて変動し、推論もひとつの価格にまとめられています。以前の比較の詳細については、GPT-Live vs GPT-RealtimeおよびGPT-Realtime-2 APIガイドをご覧ください。
レート制限とアクセス
GPT-Liveの制限はトークンではなく同時セッション数でカウントされます。GPT-Live-1.1とGPT-Live-1には、推論リージョン全体で適用される個別の上限があります。GPT-Live-1のページでは、Buildティアで50同時セッション、Launchで300、Growで500と記載され、Freeティアは非対応とされています。GPT-Live-1.1のページにはまだ独自の表が公表されていないため、負荷を計画する前に組織の制限ページを確認してください。
Apidog CLIでセッションサーバーをテストする
GPT-Live統合には、自身で管理するHTTPサーフェスがあります。SDPオファーを交換する/api/sessionエンドポイントです。OpenAIのサンプルでは、想定外のオリジンに対して403を、SDPオファーがない場合に400を返します。これらのパスはOpenAIには到達しないため、音声コストゼロで毎回のコミット時にテストできます。Apidog CLIを使えば、コーディングエージェントにテストの作成と実行を任せられます。
CLIをインストールしてログインし、Apidogスキルをエージェントに追加します:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、エージェントに次の1つのプロンプトを与えます:
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
エージェントはスキーマを読み、ペイロードを検証し、エンドポイントとテストケースを作成して実行します:
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
同じapidog runを-r junit付きで実行すればCIに組み込めます。詳細は「CI/CDパイプラインでのApidog CLIの実行」をご覧ください。Claude Codeを使用している場合は、「Claude CodeでのApidog CLIガイド」がセットアップを解説しています。ApidogのFreeプランは最大4ユーザーのチームまで利用できます。
FAQ
GPT-Live-1.1はAPIで利用できますか? はい。OpenAIは2026年11月20日にGPT-Live-1.1をAPIで利用可能にしました。モデルIDはgpt-live-1.1で、v1/live/sessionsエンドポイントで提供されます。以前のGPT-Live API記事はこのリリース前のものです。
GPT-Live-1.1の料金はいくらですか? アクティブ時間1分あたり0.05ドル、スタンバイ時間1分あたり0.02ドルで、秒単位で課金されます。バックエンドモデルとツールの使用は、それぞれの通常料金で別途課金されます。
GPT-Live-1とGPT-Live-1.1の違いは何ですか? GPT-Live-1.1は音声の文字起こしがより正確になり、多言語間でより一貫したアクセントと声を維持し、アイドルセッション向けのスタンバイオプションが追加されました。料金とエンドポイントは同じです。
GPT-Live-1.1は画像を見られますか? 直接は見られません。画像はビジョン対応のバックエンドモデルに送り、その返したテキストをGPT-Liveが使う形になります。
GPT-Live-1.1は関数呼び出しをサポートしていますか? はい。モデルページにはストリーミングと関数呼び出しが記載されています。実際には、ツール呼び出しは委任を通じてバックエンドが処理し、カスタム関数はアプリケーション側が実行します。