
モデルファミリーの中で最も安価なティアは、かつては信頼できないティアでした。分類、要約、リトライのトラフィックをそこに送り、エージェント的なものはすべてフラッグシップモデルに任せ、タスクが複数のステップを必要とした瞬間に、予算モデルが崩壊することを容認していました。
2026年9月22日に発表されたGPT-6 Lunaは、そのティアと同じ価格帯でありながら、そのように振る舞いません。入力トークン100万あたり0.10ドル、出力トークン100万あたり0.50ドルで、100万トークンのコンテキストウィンドウを持ち、OpenAIが公開した数値によれば、エージェント型コーディングベンチマークにおいて、フロンティアモデルの範囲内に入り、タスクあたりのコストはそれらのほんの一部です。
まず確認しておきたいのは、これはすでにフォールバックチェーンに組み込んでいるかもしれないGPT-5.6 Lunaではないということです。同じティア名ですが、新しいモデル、新しい価格、新しいコンテキストウィンドウです。そうでなければ、サイレントな挙動変更をリリースしてしまい、サポートチケットから初めてその事実に気づくことになりかねません。
GPT-6 Lunaの概要
| 項目 | 値 |
|---|---|
| APIモデルID | gpt-6-luna |
| 入力価格 | 100万トークンあたり$0.10 |
| 出力価格 | 100万トークンあたり$0.50 |
| キャッシュされた入力読み取り | 90%割引 |
| コンテキストウィンドウ | 1,000,000トークン |
| 人工分析インテリジェンスインデックス | 37 |
| 発表日 | 2026年9月22日、GPT-6 Solと同時 |
| 利用可能 | ChatGPT WorkとCodex、FreeおよびGoユーザー向けのデスクトップアプリ、およびAPI |
| 利用不可 | リリース時点ではチャットでは利用不可 |
同じファミリー内では、GPT-6 Solは872,000トークンウィンドウとインデックス48で2ドル/10ドル、GPT-6 Astraは10ドル/50ドルです。OpenAIは、Astraが「全体的に我々の最高のモデルであり続けている」と述べており、Lunaは最も賢いモデルとして販売されているわけではありません。タスクあたりのコストが劇的に下がったモデルとして販売されています。
これは新しいモデルであり、ティア名の変更ではありません
GPT-5.6ファミリーはSol、Terra、Lunaでした。GPT-6ファミリーはAstra、Sol、Lunaです。2つの名前は引き継がれましたが、Terraは引き継がれず、Astraが新登場です。OpenAIは、SolとLunaがGPT-6 Astraと同様の手法で訓練されたと説明しており、これは古いモデルと同じ命名規則を共有する新しいモデルであることを意味します。
GPT-6 Terraはありません。GPT-5.6の命名規則に基づいてルーティングラダーを構築していた場合、中間のランクはもはや存在しません。そして、SolとTerra、Lunaを比較した以前の私たちの記事は、現在のガイダンスではなく、歴史として読まれることになります。
価格の系譜は、ティアがどれだけ変化したかを示しています。
| ティア | GPT-5.6定価 | GPT-5.6プロモーション価格 | GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | GPT-6 Terraなし |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
すべての数値は入力トークン100万あたりおよび出力トークン100万あたりのものです。GPT-5.6の行は、当時の当社の記事、GPT-5.6の価格設定、およびGPT-5.6の値下げから引用しています。
OpenAIは、SolとLunaがGPT-5.6の**プロモーション**価格よりも50%安価であると説明しています。「プロモーション」という言葉はOpenAI独自のものであり、主張の意味を変えます。この比較は、GPT-5.6がリリースされたときの価格ではなく、割引価格を基準にしています。GPT-5.6 Lunaの定価1ドル/6ドルと比較すると、GPT-6 Lunaの0.10ドル/0.50ドルは、入力で90%、出力で92%の削減となります。実際の削減は見出しよりも大きく、見出しは割引価格を基準にしています。予算モデルには最初の数字ではなく、2番目の数字を使用してください。
安価なモデルがより大きなコンテキストウィンドウを持つ
これは、ほとんどのローンチ報道が見落とした詳細です。Lunaは1,000,000トークンのコンテキストウィンドウを搭載しています。価格が20倍のSolは872,000トークンを搭載しています。
これは、多くのルーティングコードが内包している前提を覆します。ペイロードが増加したときに、より高価なモデルにリクエストを昇格させるという前提です。GPT-6では、ファミリー内で最大のウィンドウが価格リストの一番下にあります。900,000トークンのドキュメントはSolには収まりませんが、Lunaには収まります。
計算は2つの価格から導き出されます。Lunaのフルウィンドウを一度埋めるには、入力トークンで0.10ドルかかります。Solの872,000トークンウィンドウを一度埋めるには、およそ1.74ドルかかります。Claude Opus 5.5の1Mウィンドウを100万トークンあたり4ドルで埋めるには、4.00ドルかかります。同じ種類のペイロードでも、それを読み取るために支払う金額には40倍の差があります。
OpenAIのキャッシュ機能を追加すると、その差はさらに広がります。GPT-6はキャッシュされた入力読み取りに90%の割引を適用するため、呼び出し間でキャッシュに残る1Mトークンのプレフィックスは、0.10ドルではなく約0.01ドルで再読み取りできます。OpenAIはまた、GPT-6がデフォルトでより高いキャッシュヒット率を達成し、推論の労力やツールの利用可能性を変更してもキャッシュが無効にならず、明示的なブレークポイントによってキャッシュされたプレフィックスの終了場所を制御できると述べています。GitHubは、数十億のリクエストにおいて、新鮮な処理を必要とするプロンプトトークンが50%以上減少したと報告しています。
OpenAIが公開したもの
以下のすべての数値はOpenAIの発表資料からのものです。推論の労力設定は括弧内に示されています。これは、これらのモデルが異なる労力レベルで非常に異なるスコアを出すため、労力設定のないベンチマーク行は利用可能な数値ではないからです。
| ベンチマーク | GPT-6 Luna | 比較点 |
|---|---|---|
| DeepSWE 1.1 | 66.6% (最大) | Claude Opus 5およびClaude Fable 5の「中」レベルと同等で、Opus 5よりタスクあたり93%安価、Fable 5より96%安価 |
| AutomationBench 1.0.6 | 先代モデルを5.4ポイント上回る(高) | タスクあたりのコストが58%低い |
| OSWorld 2.0 オフライン | 最大労力でGPT-5.6 Sol(中)を上回る | およそ10分の1のコストで |
| 事実性 | より高い労力でGPT-5.6 Solと同等 | およそ100分の1のコストで |
DeepSWEの行は注目すべき点です。入力トークン100万あたり0.10ドルのモデルが、エージェント型ソフトウェアエンジニアリングのベンチマークで66.6%を記録し、中程度の労力で2つのフロンティアモデルと同じ領域に位置し、そのうちの1つよりもタスクあたり93%安いというのは、従来の予算ティアとは異なる提案です。これは、Lunaが最も困難な作業においてフロンティアモデルを置き換えるという意味ではありません。しかし、「これを安価なモデルにルーティングする」と「これには高価なモデルが必要だ」という境界線が移動したことを意味します。2026年9月以前に引いていたその境界線は、今では間違った場所に引かれています。
事実性に関する結果は、通常の製品作業において最も重要となる可能性が高いものです。前世代のミドルティアの事実正確性におよそ100分の1のコストで匹敵するという点が、Lunaを内部のバッチジョブだけでなく、ユーザー向けの要約や情報抽出にも利用可能にしています。
ここでのすべての比較はClaude Opus 5を対象としています
これらの行がどのClaudeモデルと比較されているかに注目してください。Claude Opus 5です。
Anthropicは同日、Claude Opus 5.5をOpus 5の5ドル/25ドルに対し4ドル/20ドルで出荷し、人工分析インテリジェンスインデックスで58のトップに立ち、212モデル中1位となりました。OpenAIの発表記事はOpus 5.5が存在する前に書かれたため、Opus 5に対するタスクあたりのコスト比較はすべて、公開後数時間で置き換えられたモデルを基準にしています。
だからといってOpenAIの数値が間違っているわけではありません。実行された比較に対しては正確です。しかし、「Opus 5より93%安い」という情報を、どのOpusを指すかを明記せずに市場の現状として調達文書に持ち込むべきではないことを意味します。LunaとOpus 5.5の直接比較を公表しているベンダーはなく、ソーシャルメディアで出回っている比較は、どちらかの研究所からではなく、個々のテスターからのものです。当社の価格競争の柱となる記事では、これら3つのローンチを1つの表で相互に追跡しています。
レイテンシ:安価なモデルは高速なモデルではない
Artificial Analysisによる第三者測定では、GPT-6 Lunaの出力トークンは毎秒153.9トークン、最初のトークンまでの時間は124.23秒でした。2つの注意点があり、どちらも重要です。これらはベンダーが公開したものではなく、第三者の数値です。そして、これらは利用可能な最も遅く最も高価な構成である最大推論バリアントで測定されています。
両方の注意点があるにせよ、その方向性は考慮に値します。LunaはSol(102.15秒)よりも最初のトークンまでの時間が遅いと測定されています。このファミリーでは、価格とレイテンシは相関していません。最初のトークンが届くまでに2分間の待機があると、デフォルトのHTTPクライアントのタイムアウトが発生し、ロードバランサーがアイドル状態になり、ほとんどのサーバーレスランタイムの実行上限を超えてしまいます。高負荷で同期エンドポイントをLunaにルーティングする場合、統合作業はプロンプト内ではなく、タイムアウトおよびストリーミングレイヤーで行う必要があります。
ルーティングする前に、自身のワークロードでテストしてください
ベンチマーク表は集計値です。あなたのプロンプトはそうではありません。役立つ質問は、Lunaがあなたのトラフィックで、許容できる労力レベルで機能するかどうかであり、その答えを適切に出すには約10分かかります。
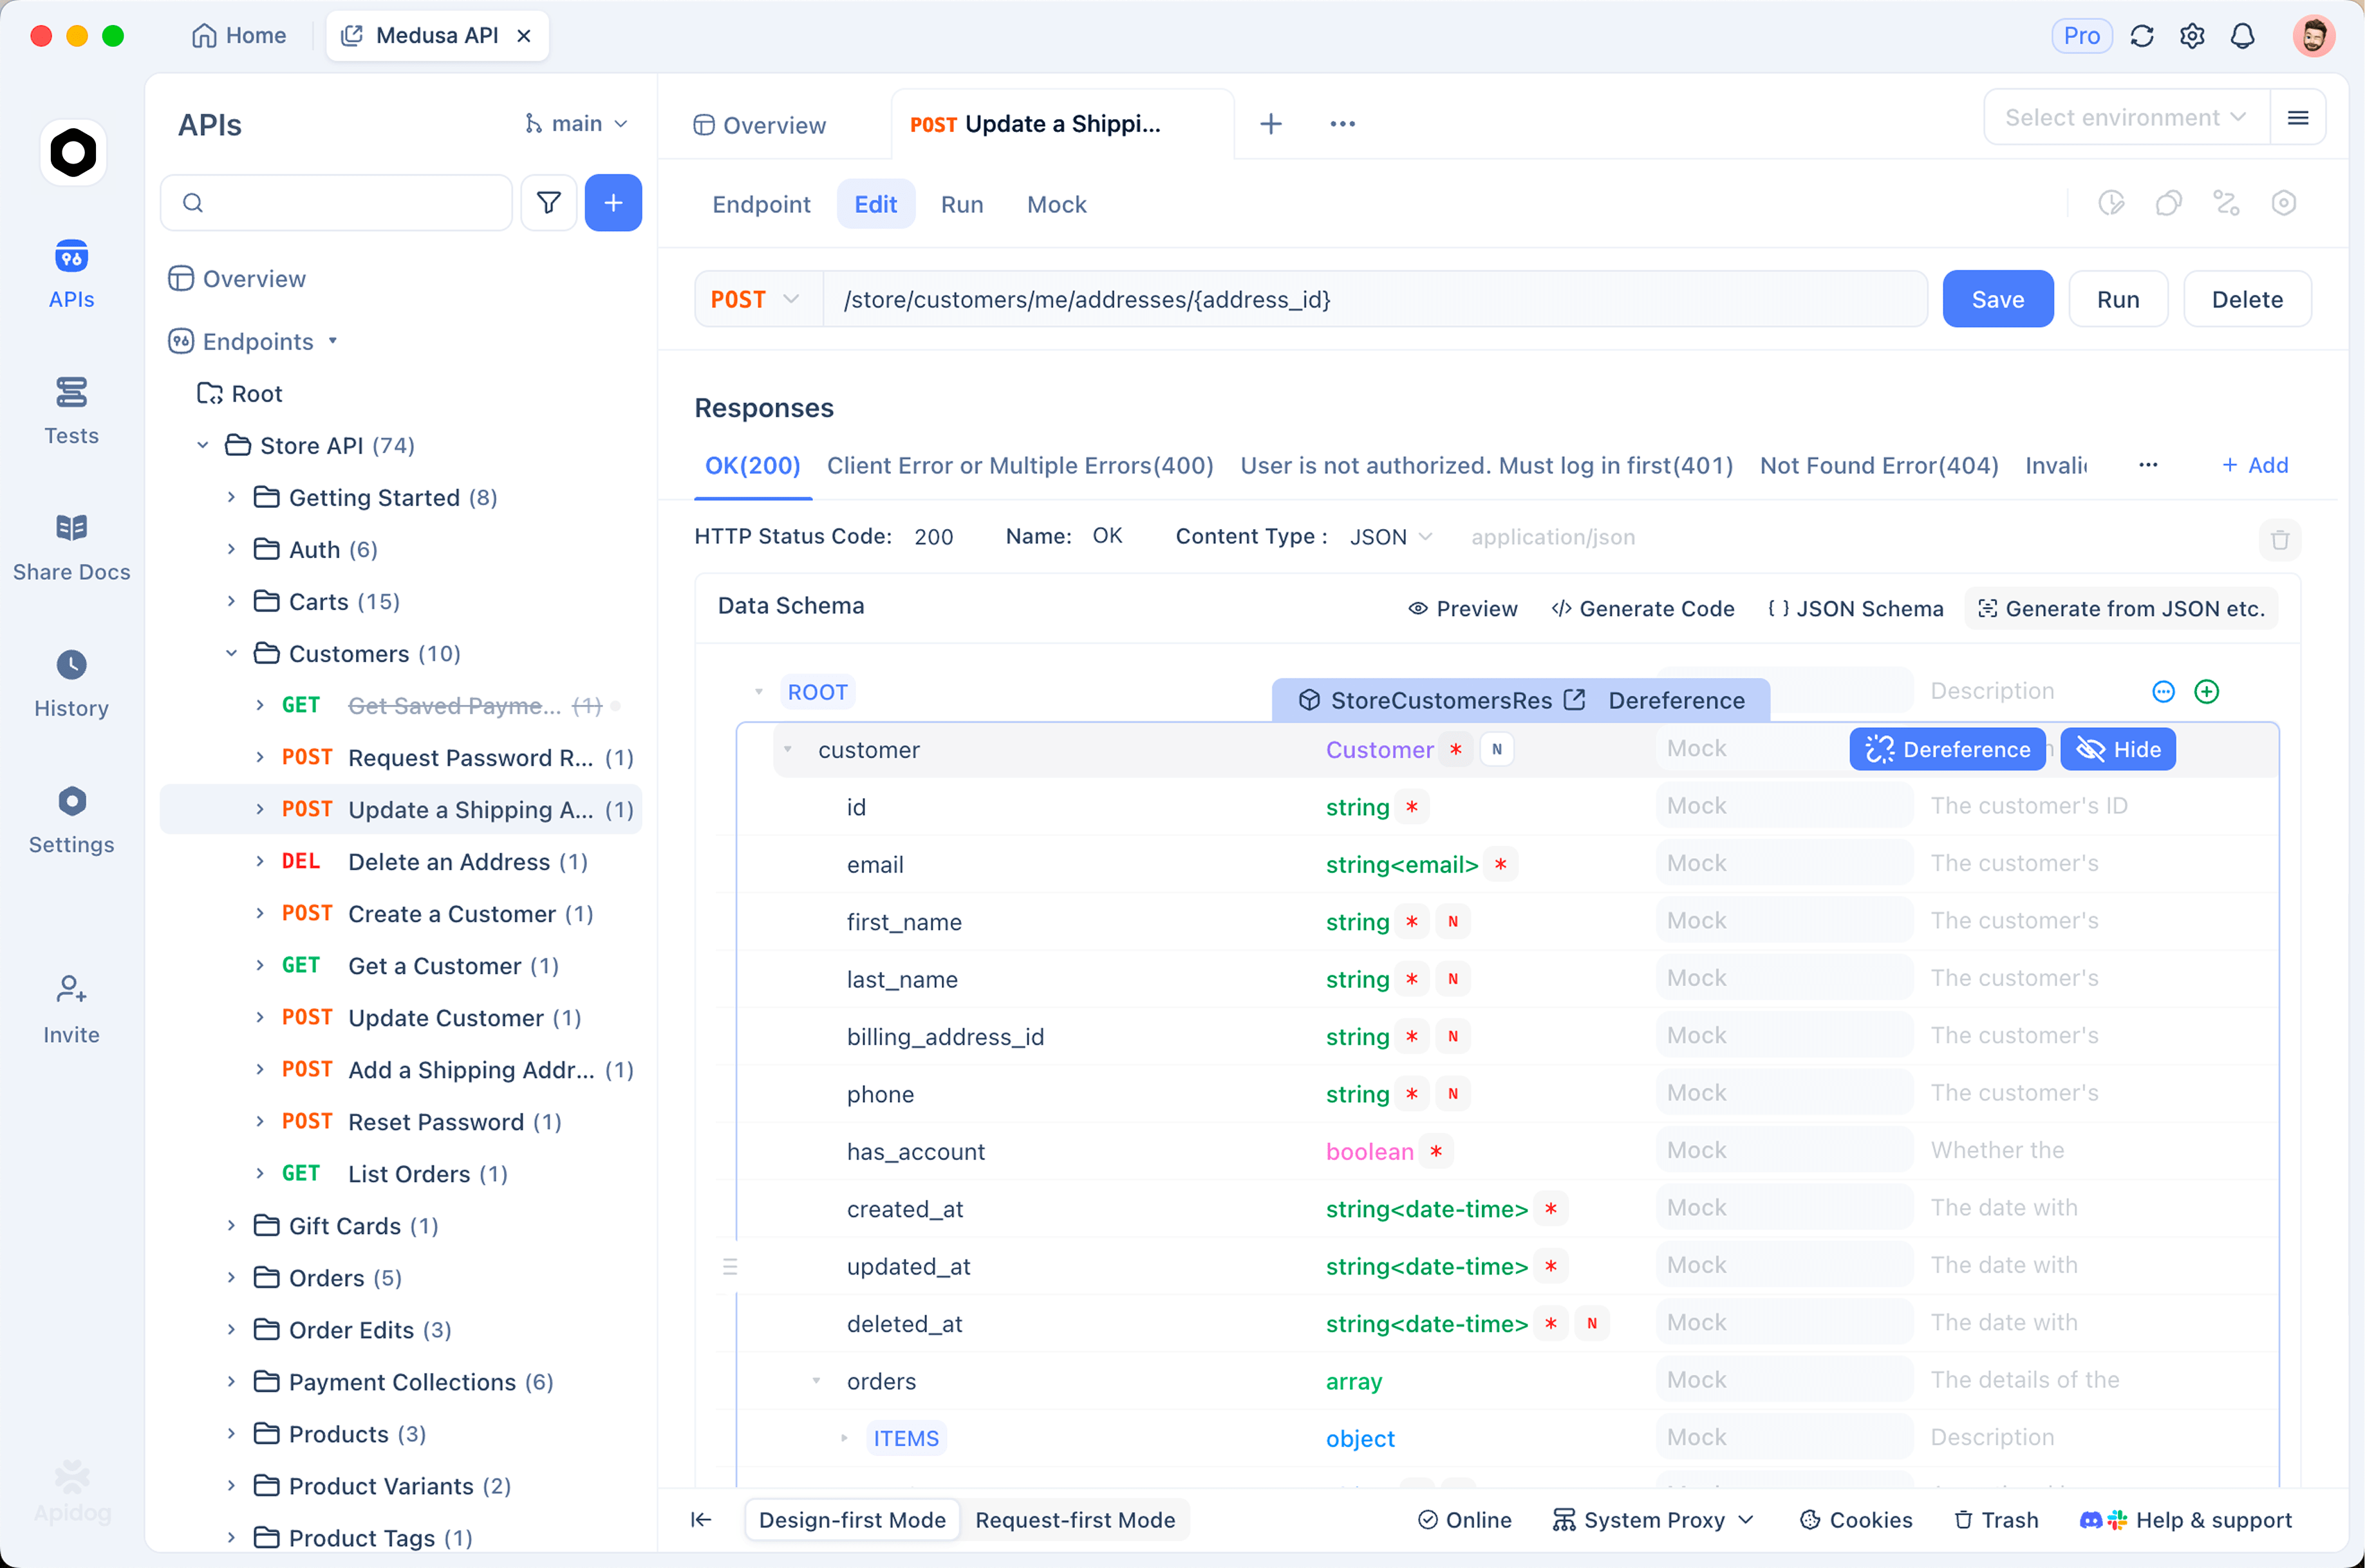
モデルごとに1つのリクエストを設定し、モデルIDをパラメータ化して、同じペイロードをティア全体で実行します。
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
この形式に基づいて構築する前に、エンドポイントとパラメータ名をOpenAIの現在のモデルリファレンスと照合して確認してください。モデルID gpt-6-lunaは、発表資料から確認されている部分です。
Apidogでは、同じリクエストがモデルIDを環境変数とする保存済みエンドポイントとなり、1つのコレクションでLuna、Sol、Astraを重複なくカバーできます。それをテストシナリオとして実行すると、実行ごとの応答時間とトークン使用量が得られます。さらに応答形状のアサーションも可能で、これにより安価なモデルの本当の障害モード、つまり誤った回答ではなく、パーサーが期待するJSONスキーマに準拠しなくなる応答を検出できます。同じシナリオを3つの労力レベルで実行すれば、他の誰かのベンチマークスイートではなく、あなた自身のプロンプトに対するコスト、レイテンシ、信頼性の表が得られます。
Lunaが適切な選択となる場合
ペイロードが大きく、タスクが明確に指定されており、出力をプログラムで検証できる場合はLunaにルーティングしてください。文書抽出、仕様解析、ログトリアージ、テスト生成、大量分類、および1Mウィンドウがチャンキングパイプラインを不要にするあらゆるバッチジョブはすべて適格であり、長いプレフィックスが呼び出し間で安定している場合にはキャッシュ割引が累積されます。
安価に回答を確認できない作業や、自身のトラフィックで最初のトークンまでの時間を測定するまではレイテンシに敏感なものには、高価なティアを維持してください。Lunaは境界線を動かしました。しかし、それを消し去ったわけではありません。