
Firecrawl Localは、Webサイトをスクレイピング、クロール、マッピングしてクリーンなMarkdownに変換する、単一のRustバイナリです。`cargo install firecrawl-local`でインストールでき、APIキー・データベース・キュー・コンテナを必要とせずに、Firecrawl v2 APIを`localhost:3002`で提供できます。検索や一部の機能は引き続きFirecrawl Cloudを利用しますが、オフにすることも可能です。
以下では、ローカルマシンで動作するもの、クラウドに送信されるもの、インストール方法、提供されるAPIルート、制限事項、そしてコーディングエージェントがApidog CLIでローカルAPIをテストする方法を説明します。
Firecrawl Localとは?
Firecrawl Localは、Firecrawlのオープンソース版オンデバイスエディションです。 Webページを取得し、ホスト版Firecrawl APIと同じHTMLクレンジングコードで整形して、Markdown・HTML・リンクを返す単一のバイナリです。CLIとして、AIエージェント向けのMCPサーバーとして、あるいはFirecrawl v2 APIのローカルコピーとして動作します。
Firecrawlは2026年11月18日、Xのローンチ投稿でこれを発表しました。コードはFirecrawlリポジトリのapps/localフォルダにあります。パッケージはcrates.ioにfirecrawl-localとして公開されており、リポジトリのライセンスはAGPL-3.0です。
Firecrawlは、セルフホスト版Firecrawlより37倍高速で、メモリ使用量は230分の1(アイドル時11 MB)だと主張しています。ただしREADMEにはベンチマーク手法が公開されていないため、これらはベンダーの主張として受け止めてください。
ホスト版APIやFirecrawl CLIをご存じなら、要はシンプルです。同じ呼び出しが、あなたのマシン上で返ってくるのです。
Firecrawl Localの仕組み:1つのバイナリ、10個のコマンド
すべての機能は`firecrawl-local`のサブコマンドとして提供されています。READMEに記載された全リストは次のとおりです。
| コマンド | 動作 | 実行場所 |
|---|---|---|
scrape <urls...> |
1つ以上のURLをスクレイピング | ローカルマシン |
crawl <url> |
開始URLからリンクをたどる | ローカルマシン |
map <url> |
サイトマップと開始ページからサイトのURLを一覧化 | ローカルマシン |
serve |
Firecrawl v2 APIをlocalhostで提供 | ローカルマシン |
mcp |
Firecrawl MCPサーバーをstdio経由で実行 | ローカルマシン(一部ツールはクラウド) |
init |
このマシンのAIツールにMCPサーバーを追加 | ローカルマシン |
search <query> |
Webを検索 | Firecrawl Cloud |
find-tools <query> |
Alexandriaのデータプロバイダーを検索 | Firecrawl Cloud(要サインイン) |
data <provider> <capability> |
Alexandriaのデータプロバイダーを実行 | Firecrawl Cloud(要サインイン) |
login |
ブラウザでFirecrawlにサインイン | Firecrawl Cloud |
日常的な用途のほとんどは次の3つのコマンドでカバーできます。
# 1ページをMarkdownで出力
firecrawl-local scrape https://example.com --markdown

# 最大50ページをクロールし、ページごとにMarkdownファイルを保存
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# サイト上のすべてのURLを一覧化
firecrawl-local map https://firecrawl.dev
`--markdown`を付けない場合、`scrape`はFirecrawl APIのJSONを出力します。`--format`は`markdown`、`html`、`rawHtml`、`links`を受け付けます。PDFやOffice文書もローカルでパースされます。
JavaScriptを多用するページでは、すでにインストールされているChromeまたはChromiumを操作します。Chromeがない場合でも静的ページは処理できますが、ブラウザが必要なページでは警告が返されます。Chromeをいつ使用するかは`--browser auto|never|always`で決められます。
ローカルで動くものとFirecrawl Cloudで動くもの
スクレイピング、クロール、マッピング、文書パースはローカルマシンで実行され、Firecrawlには何も送信されません。 一方、次の3つの機能はFirecrawl Cloudに送られます。ノートパソコンにはインデックスやネットワーク、データがないためです。
- 検索。 ローカルマシンには検索インデックスがありません。キーなしでも検索できますが、レート制限があります。
- ローカルマシンを拒否するページ。 サイトがプレーンなフェッチとローカルブラウザの両方をブロックした場合、Firecrawl Cloudが取得します。アカウントは不要です。
- Alexandriaデータプロバイダー。 これらはFirecrawl Cloud上で動作し、無料アカウントが必要です。詳細はFirecrawl Alexandria解説記事をご覧ください。
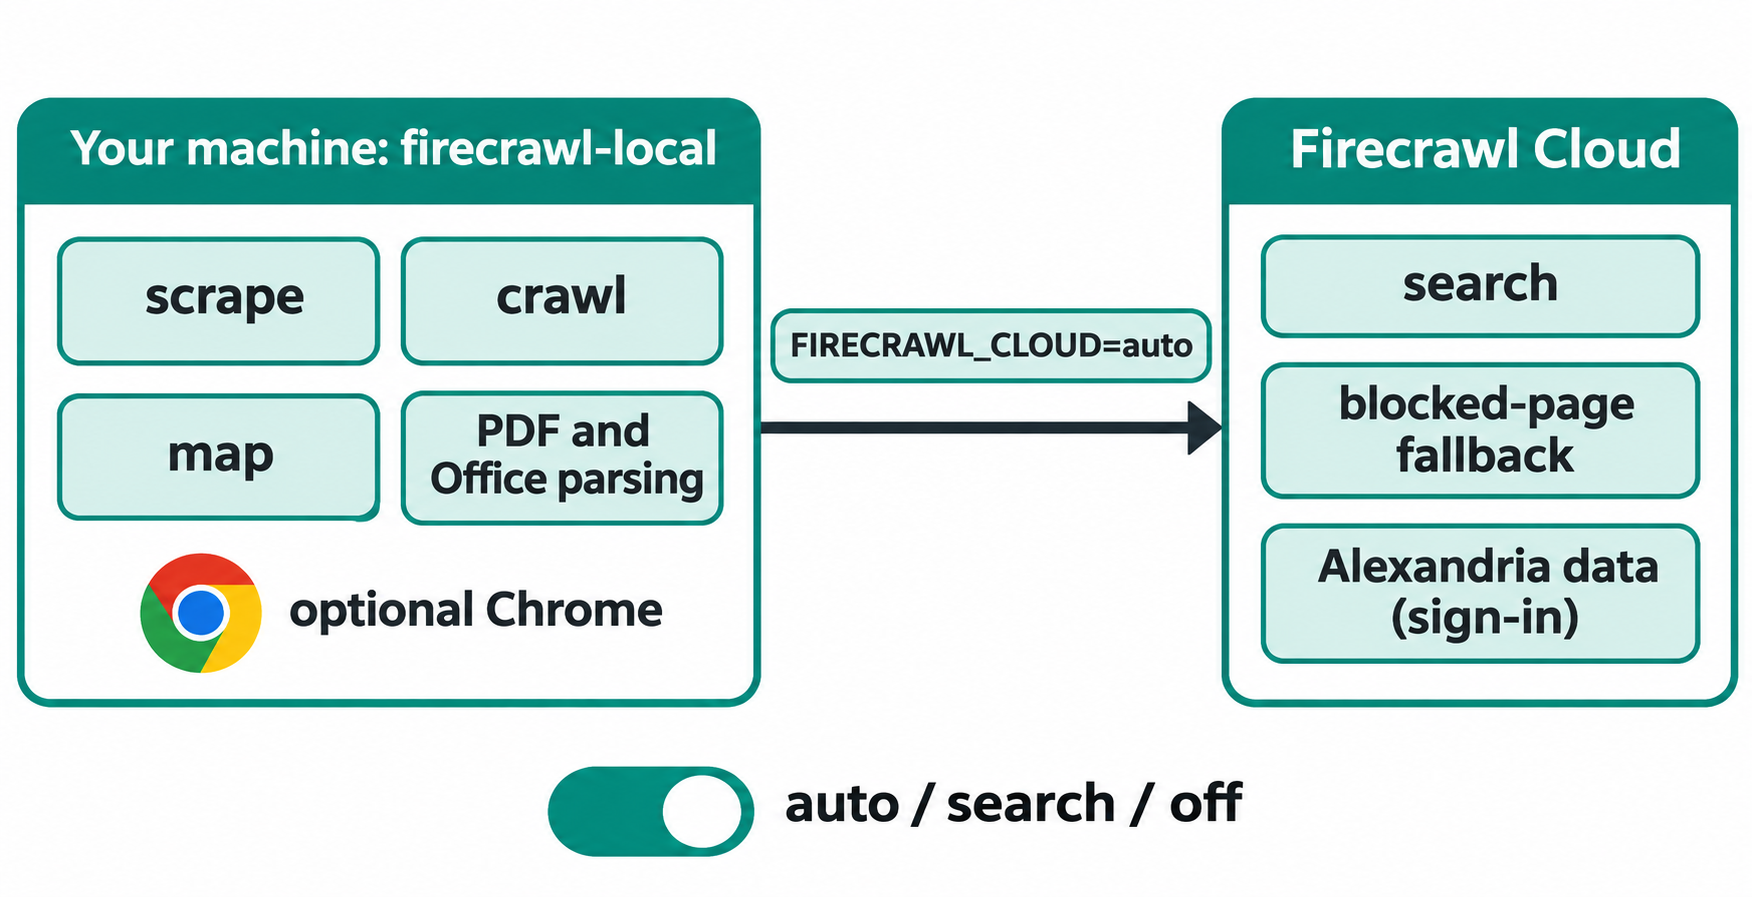
`FIRECRAWL_CLOUD`環境変数でこの引き渡しを制御できます。
| 値 | 効果 |
|---|---|
auto(デフォルト) |
検索、ブロックされたページのフォールバック、Alexandriaがすべて動作 |
search |
検索のみFirecrawl Cloudに送信 |
off |
Firecrawl Cloudには何も送信しない |
認識できない値は`off`として扱われます。クラウドで取得された結果には`"source": "firecrawl-cloud"`が付与されます。クラウドでも失敗した場合は`"blocked": true`が返ります。
クラウド呼び出しにはランダムなインストールIDと呼び出し元ツール名が付与され、Firecrawlはこれでインストール数を集計しています。
Firecrawl Localのインストール方法
RustとCコンパイラが必要です。手順は次のとおりです。
- ビルドツールをインストールします。 macOSでは`xcode-select --install`を実行します。DebianやUbuntuでは`build-essential`をインストールしてください。
- ChromeまたはChromiumを追加(任意)。 JavaScriptレンダリングページやスクリーンショットが必要な場合に導入します。
- Node.js 22以降を追加(任意)。 MCPサーバーを使う場合に必要で、`npx`経由で`firecrawl-mcp` npmパッケージを実行します。
- サインイン(任意)。 Alexandriaプロバイダーを使う場合は`firecrawl-local login`でサインインします。
バイナリをcrates.ioからインストールします。
cargo install firecrawl-local
firecrawl-local --version
代わりに最新コードからビルドする場合は、リポジトリをクローンして`apps/local`で`cargo build --release`を実行します。
Firecrawl Local API:localhost:3002で提供されるv2ルート
`firecrawl-local serve`はポート3002でFirecrawl v2 APIを提供します。ローカルルートにはAPIキーは不要です。
firecrawl-local serve

# 別のターミナルで
curl -s http://localhost:3002/v2/scrape \
  -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"]}'
以下のルートはローカルマシンで動作します。
| ルート | 動作 |
|---|---|
POST /v2/scrape |
1つのURLをスクレイピング |
POST /v2/map |
サイトのURLを一覧化 |
POST /v2/crawl、GETおよびDELETE /v2/crawl/{id} |
クロールの開始、状態確認、キャンセル |
POST /v2/batch/scrape、GETおよびDELETE /v2/batch/scrape/{id} |
バッチスクレイプの開始、状態確認、キャンセル |
GET /health |
ヘルスチェック |
その他の`/v2`ルート(`/v2/search`など)は、`FIRECRAWL_CLOUD`の設定に反しない限りFirecrawl Cloudに転送されます。v0およびv1のルートは提供されません。
既存のコードは、設定を1か所変えるだけで移行できます。Firecrawl SDKのAPI URLを`http://localhost:3002`に向けるだけです。スクレイパーやRAGパイプラインのコードはそのままに、試行錯誤の間はクラウドクレジットを消費せずに済みます。スクレイピングパイプライン全般については、Firecrawl Webスクレイピングガイドをご覧ください。
AIエージェント向けMCPサーバーとして使うFirecrawl Local
`firecrawl-local init`は、検出されたすべてのAIツールにFirecrawl LocalをModel Context Protocolサーバーとして登録します。Claude Code、Claude Desktop、Cursor、Windsurf、Gemini CLI、Codexを認識し、各設定ファイルを事前にバックアップします。`--dry-run`で変更内容をプレビューでき、`--agent cursor`で特定のツールのみにセットアップできます。
エージェントには標準のFirecrawl MCPツールが提供されます。scrape、crawl、map、batch scrapeはローカルで動作し、それ以外はFirecrawl Cloudに送られます。
信頼できないサイトをエージェントが閲覧する場合は、`firecrawl-local mcp --public-only`で登録してください。そうしないと、隠し命令を含むページによってエージェントが内部ネットワーク上のURLを開かされる可能性があります。
Firecrawl Localの制限事項
Firecrawl Localは完全なFirecrawlサーバーではありません。READMEには足りない機能が記載されています。
- ローカルでは`json`や`summary`形式が使えません。 モデルが必要なため、ローカルスクレイプでは警告付きでスキップされます。
- ブラウザの`actions`が使えません。 クリック、スクロール、入力の各ステップは無視されます。
- スクリーンショットにはChromeが必要です。
- ジョブはメモリ上に存在します。 クロールとバッチジョブは開始から1時間で期限切れとなり、`serve`を停止すると失われます。
- v0およびv1 APIルートは提供されません。
キュー、ワーカー、すべての形式が必要な場合は、`apps/api`にあるフルサーバーが引き続き存在します。詳細はFirecrawlのセルフホスティングガイドで解説されています。
知っておくべきセキュリティのデフォルト設定
`serve`は他プログラムからのリクエストを受け付けるため、コマンドごとにデフォルト設定が異なります。
scrape、crawl、map、mcpはキーボードの前にいる人のために動作するため、`localhost`やプライベートネットワークにアクセスできます。`scrape`、`crawl`、`mcp`は`--public-only`を受け付け、これらのアドレスを拒否できます。serveは`127.0.0.1`にバインドし、`--allow-private`を渡さない限りlocalhostやプライベートターゲットを拒否します。`--host`で別のアドレスにバインドするには`--token`が必要です。- リンクローカルアドレスとクラウドメタデータアドレスは常にブロックされます。 リダイレクトやDNS解決後も同様です。
Chromeはヘッドレスかつサンドボックス化され、使い捨てプロファイルで実行されます。クロール時には、Firecrawl LocalはRobots Exclusion Protocolに従って`robots.txt`を読み取ります。サイト所有者は`FirecrawlLocal`として指定できます。
Firecrawl Localの対象ユーザー
- スクレイパーやRAGパイプラインを開発する開発者で、クラウドのボリューム課金前に無料で高速に試行錯誤したい方。
- コーディングエージェントのユーザーで、すべてのページを第三者経由せずにClaude Code、Cursor、Codex内でWeb読取を行いたい方。
- データに関するルールがあるチームで、`FIRECRAWL_CLOUD=off`を使い、取得内容をマシン上に留めたい方。
`json`抽出、ブラウザアクション、長時間稼働のクロールジョブに依存している場合は、あまり適していません。エージェント向けの検索だけが必要な場合は、Claude向けオープンソースWeb検索のまとめをご覧ください。
コーディングエージェントにApidog CLIでローカルAPIをテストさせる
`serve`が動けば、`localhost:3002`に本物のHTTP APIができあがります。パイプラインに接続する前に、ルートがコードの期待どおりに応答するか確認しましょう。リクエストを手作業でクリックする代わりに、コーディングエージェントへApidog CLIと1つのプロンプトを渡してください。
セットアップは1回だけです。
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
次に、エージェントにこう依頼します。
バックグラウンドでfirecrawl-local serveを起動して。ローカルルート
(POST /v2/scrape、POST /v2/map、GET /health)用のOpenAPI 3ファイルを
作成し、Apidogプロジェクト<id>にインポートして。
http://localhost:3002を指す環境を作成し、/healthが200を返し、
https://example.comに対して/v2/scrapeがsuccess: trueかつ
空でないdata.markdownを返すことを検証するテストケースを追加して。
その後テストを実行し、失敗があれば要約して。
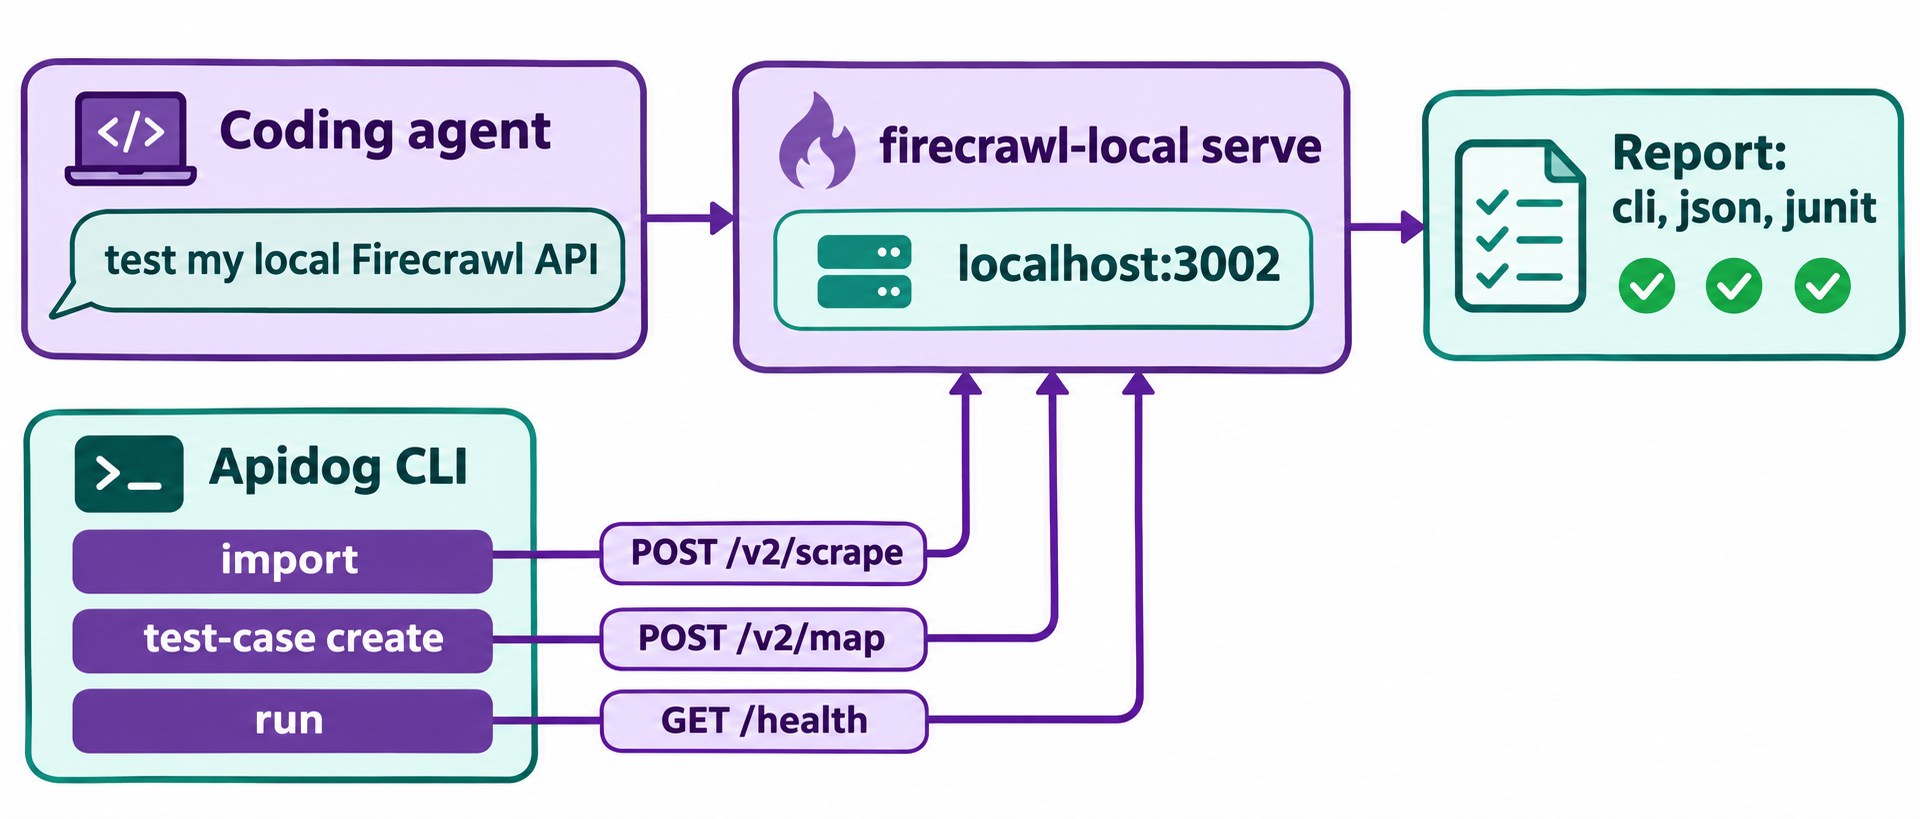
エージェントはスキーマを読み、ペイロードを検証し、次のようなコマンドを実行します。
firecrawl-local serve &
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file ./case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Apidog CLIはローカルマシンからリクエストを送信するため、`localhost:3002`に到達できます。`-r cli,json`を`-r junit`に変えれば、同じ実行をCIに組み込めます。設定方法はApidog CLI CI/CDガイド、エージェント側の手順はClaude CodeでのApidog CLIで解説しています。Apidogの無料プランは最大4ユーザーのチームまでカバーします。
FAQ
Firecrawl Localは無料ですか? バイナリはAGPL-3.0のオープンソースで、ローカルのスクレイピング、クロール、マッピングにAPIキーは不要です。検索、ブロックされたページのフォールバック、AlexandriaはFirecrawl Cloudに送られ、Alexandriaには無料アカウントが必要です。
既存のFirecrawl SDKコードをFirecrawl Localで使えますか? はい、ローカルルートについては使えます。SDKのAPI URLに`http://localhost:3002`を設定してください。scrape、map、crawl、batch scrapeはローカルで動作します。v0およびv1ルートは提供されません。
Firecrawl Localがクラウドを呼び出さないようにするには? `FIRECRAWL_CLOUD=off`を設定してください。検索とブロックされたページのフォールバックは動作しなくなり、明示的な`login`を除いて何もマシン外に出ません。
Firecrawl Localはセルフホスト版Firecrawlとどう違うのですか? セルフホスト版Firecrawlは`apps/api`にあるフルサーバーで、キュー、ワーカー、すべての形式を備えています。Firecrawl Localはより軽量な単一バイナリで、`json`および`summary`形式、ブラウザアクション、永続ジョブを省いています。