
Together AI、Fireworks AI、Groq はいずれも同じ売り文句を掲げています。既存の OpenAI クライアントのベース URL を新しいものに差し替え、キーを入れ替えるだけで、オープンウェイトモデルを格段に安く使えるというものです。その売り文句は本当です。本当でないのは、これらの無料枠を比較するのが三つの数字を横に並べるだけで済むという話です。というのも、三つのプロバイダーのうち二つは、固定の数字をそもそも公表していないからです。
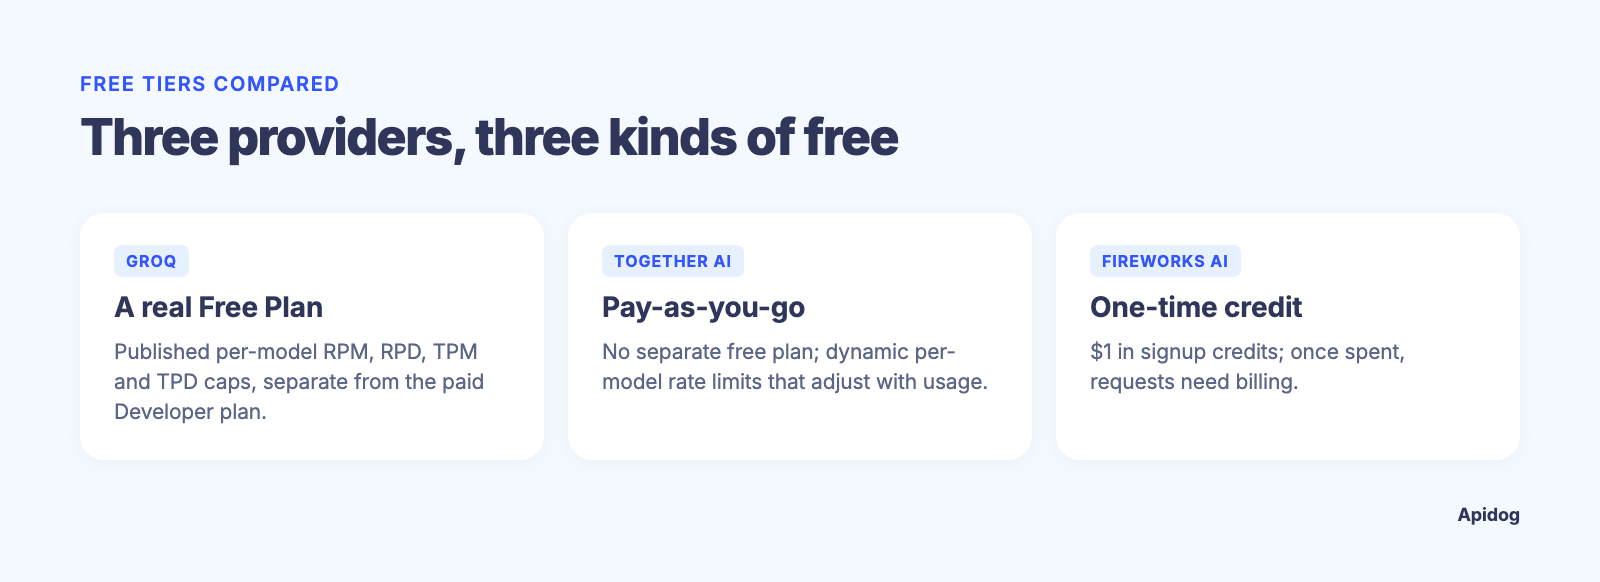
Groq は例外です。Groq のレート制限ページは、隣にある Developer Plan タブへ向かう途中で多くの読者が読み飛ばしてしまうタブの中で、モデルごとの実際の Free Plan の数字を公表しています。Together AI は自社ドキュメントの中で、公表できる固定のモデル別制限は存在しないと明言しています。上限は利用状況に応じて動きます。Fireworks AI は無料アクセスを、プラン階層ではなく一度限りのクレジット残高に結び付けています。三つとも設計が異なるため、「どの無料枠が大きいか」という記事は、それを一つの数字に還元することが今もできません。
TL;DR
Groq、Together AI、Fireworks AI はいずれも OpenAI 互換のエンドポイントを公開しているため、切り替えはベース URL と API キーの変更だけで、書き直しは不要です。Groq はアクセスを Free Plan と有料の Developer Plan に分けており、他の二つと違ってモデルごとの実際の Free Plan の数字を公表しています。たとえば gpt-oss-120b と gpt-oss-20b では 30 RPM / 1K RPD / 8K TPM / 200K TPD です。Together AI は固定の無料枠の数字を公表しておらず、そのドキュメントには、制限は稼働中のキャパシティと直近の成功した利用状況に応じて動的に変動すると書かれています。Fireworks AI は、新規アカウントに継続的な無料枠ではなく、一度限りのクレジット残高(料金ページによると $1)を付与します。見出しの数字よりも重要な判断材料は、実際にどのモデルが必要か、そして上限に達したときに各プロバイダーの上限がどう振る舞うかです。Apidog を使えば、一つのリクエストを保存して環境ごとにベース URL とキーを差し替えられるので、表を信じるのではなく、三つすべてを自分で測定できます。
一つの API 形状、三つのキー
三つのプロバイダーはいずれも、意図的に OpenAI Chat Completions のスキーマを模倣しています。だからこそ、これらのツールの移行ガイドは毎回同じ内容になります。base_url を変更し、Authorization ヘッダーを変更し、残りのコードはそのままにするだけです。Groq の OpenAI 互換ベースは https://api.groq.com/openai/v1/ です。Together AI のベースは https://api.together.ai/v1 で、これはクイックスタートのドキュメントで直接確認できます。Fireworks AI のベースは https://api.fireworks.ai/inference/v1 で、OpenAI 互換性ガイドに記載されています。
この共通の形状があるからこそ、直接対決のテストを行う価値があります。四つ目、五つ目のプロバイダーを投入するコストは、設計変更ではなく数分です。この種のマルチプロバイダー構成を管理する仕組みについては、Apidog で環境をまたいでベース URL を管理する方法で扱っており、ルーティングの選択肢をより広く検討しているなら、OpenRouter の代替案のまとめで、これら三つがその全体像のどこに位置するかを解説しています。
各無料枠について実際に確認できること
以下は、2026年9月時点で各プロバイダーが公開している情報のみに基づいて作成した比較です。プロバイダーが数字を開示していない箇所は、推測せずにその旨を表に記載しています。
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| 無料アクセスの形態 | Free Plan(有料の Developer Plan とは別) | サインアップ時から従量課金。「無料プラン」という別名はなし | 一度限りのサインアップクレジット |
| ドキュメント化された無料枠 | モデルごとに公表:gpt-oss-120b/gpt-oss-20b は 30 RPM、1K RPD、8K TPM、200K TPD。compound は 30 RPM、250 RPD、70K TPM(Groq のレート制限より、2026-09-15 閲覧) |
固定の数字としては非公表。組織ごとに動的と説明 | Fireworks の料金ページによると無料クレジット $1 |
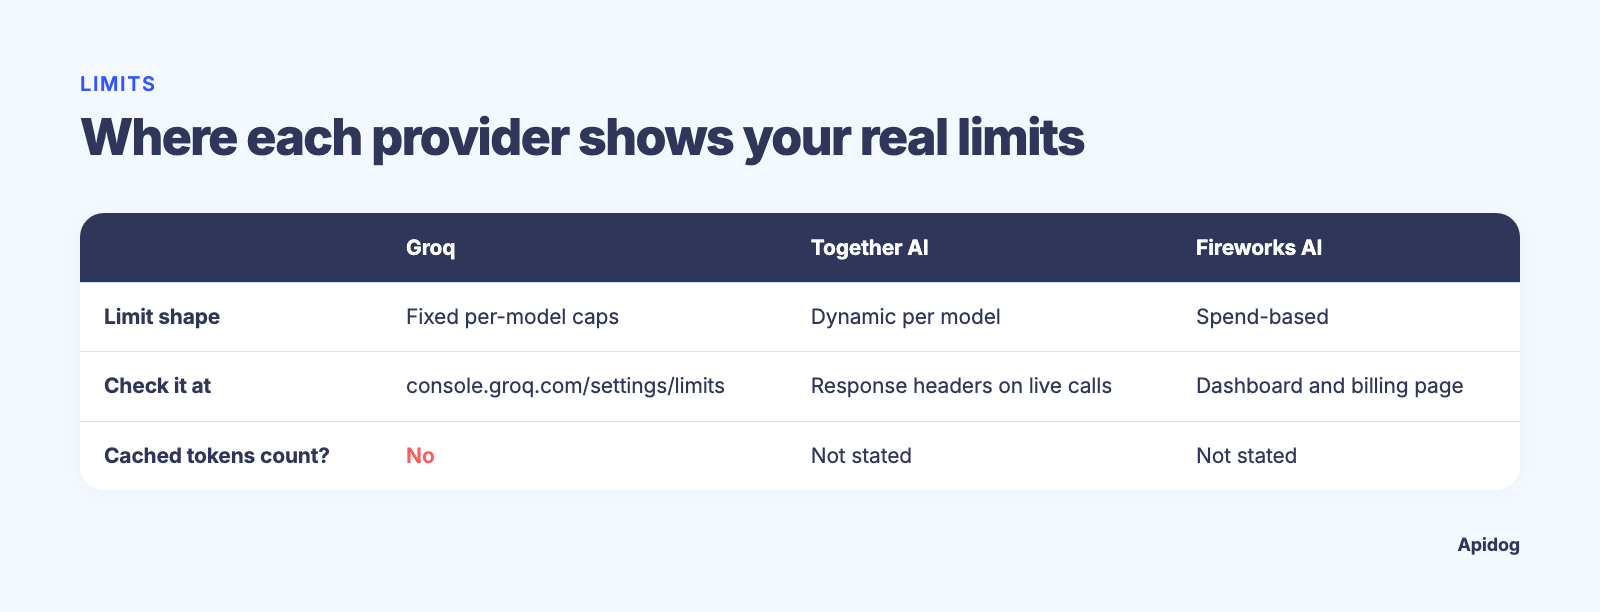
| 制限の形 | モデルごとの RPM/RPD/TPM/TPD 上限。組織レベルで適用 | モデルごとの動的レート。稼働中のキャパシティと直近の成功した利用状況に応じて調整 | 支出ベース。クレジットを使い切ると、リクエストには課金の有効化が必要 |
| 自分の数字を確認する場所 | console.groq.com/settings/limits |
実際の呼び出しのレスポンスヘッダー、例:x-ratelimit-reset |
アカウントのダッシュボードと課金ページ |
| キャッシュされたトークンは制限にカウントされるか | Groq 自身のドキュメントによると、いいえ | 確認したページには記載なし | 確認したページには記載なし |
仕様表の要約ではなく、実際に元のページを読むと、二つの点が際立ちます。第一に、上記の Groq の Free Plan の数字は公表されているデフォルト値です。同じページにはより高い上限を持つ Developer Plan タブもあり、自分の数字が異なる場合の権威は console.groq.com/settings/limits です。第二に、Together AI のレート制限は表形式ではありません。同社自身のレート制限ページには、「モデルごとの固定制限は公表されていない」と明記されており、上限は「継続的で成功したトラフィック」に応じて上昇するとされています。これは静的な無料枠の行とは大きく異なるモデルであり、「Together の無料 RPM はいくつか」という問いに対する正直な答えは、表から引っ張ってきた数字ではなく「レスポンスヘッダーを確認してください」なのです。
確認可能な数字を伴う単一プロバイダーの詳細解説を、一度に一製品ずつ読みたい場合は、姉妹記事であるGroq API 無料枠とCerebras API 無料枠をご覧ください。本記事はハブであり、あの二つがプロバイダーごとの掘り下げを完全に行っています。
リクエスト対トークン、固定対動的
これら三つの本当の設計上の違いは、無料枠の大きさではなく、上限の形です。
Groq のモデルは、他の場所でレート制限を扱ったことのあるほとんどの開発者にとっておなじみのものです。時間枠ごとの固定上限を RPM、RPD、TPM、TPD に分け、API キーごとではなく組織レベルで適用します。つまり、一つの Groq アカウントで三つのサービス用に三つのキーを作成すると、それらは一つのプールを共有します。トークンベースの上限を扱ったことがない場合は、GPT API のレート制限に関する一般的なガイドで、これと同じ RPM/TPM 構造をより詳しく扱っています。
Together AI のモデルは、バースト的なトラフィックを硬い壁で罰するのではなく、安定した成功トラフィックに報いるものです。静かなアカウントと、負荷が高く行儀の良いアカウントでは同じ上限にはなりません。上限はアカウント自身の直近の履歴と、その瞬間のモデルの稼働中キャパシティに応じて調整されるからです。ワークロードが安定しているなら良い知らせであり、トラフィックが本質的にバースト的なら、まさに未知数です。
Fireworks AI は、新規ユーザーにとってレート制限の設計をほぼ回避しています。無料期間をリクエストレートの時間枠ではなく、ドル残高に結び付けているのです。API を呼び出す速さで上限が決まるのではなく、残高が尽きるまでに呼び出しにかかるコストで上限が決まります。これにより、計画上の問いは「1分あたり何リクエストか」から「このモデルのトークン単価で $1 で何トークン買えるか」へと変わり、それは選ぶモデルに完全に依存します。
これらは、「無料」枠がどのような利用から保護すべきかについての異なる賭けです。継続的なボリュームか、バースト的な急増か、総支出か。どれに対して構築していても、最終的には 429 に遭遇します。プロバイダーがその瞬間をどう通知するかは、引き金となった数字と同じくらい重要です。レート制限超過のトラブルシューティングガイドでは、そうしたレスポンスヘッダーの読み方と、問題を悪化させないリトライロジックの組み方を解説しています。
5分で自分で証明する
このデータの多くがログイン画面の背後や実際のレスポンスヘッダーの中にあることを踏まえると、本当の答えにたどり着く最速の道は、別の仕様表記事ではなく、コーディングエージェントに三つすべてに対して実行させる一つのテストです。Apidog CLI なら、それは一つのプロンプトです。一度セットアップします:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
トークンは Apidog のアカウント設定、API Access Token から取得します。次にエージェントに一つのプロンプトを与えます:
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
エージェントが実行するコマンドは、Apidog CLI 2.2.7 で確認したものです:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
プロバイダーの切り替えは、書き直しではなく環境 ID になりました。ヘッダーは、Together AI の動的な上限がリアルタイムで表れる場所であり、Groq の組織が公表されている Free Plan の表と一致するかを確認できる場所でもあります。比較にはレイテンシも含めましょう。技術的には無料でも遅いモデルは、それを回避するために費やす時間を数えれば、実際には安くありません。これで三つのマーケティングページが、自分のアカウントから得た一つの比較可能なデータセットになります。より大きなエージェント構築の中でこの比較を継続的に実行しますか?AI エージェント向け API テストツールのガイドでそれを扱っており、Cursor での Apidog CLIでエージェントのセットアップを示しています。
どの無料枠があなたのユースケースに合うか
今日確認できる情報のみに基づいた、いくつかの正直な推奨事項です:
- ログインせずに読める予測可能なモデル別上限: Groq は実際の Free Plan の数字を公表しており(
gpt-ossモデルで 30 RPM / 1K RPD / 8K TPM / 200K TPD)、llama-3.1-8b-instant、llama-3.3-70b-versatile、およびopenai/gpt-ossモデルにわたる 131,072 トークンのコンテキストウィンドウが、一つのエンドポイントで幅広いオープンウェイトのワークロードをカバーします。 - 安定した行儀の良いトラフィックで、レート制限の追跡に関心がない: Together AI の動的モデルはそのパターンに合います。継続的で成功した利用が、初日に設定された数字で上限を決めるのではなく、時間とともに自分の上限を引き上げます。
- セットアップの摩擦がゼロで、支出の壁に当たることに抵抗がない: Fireworks AI のクレジットベースの無料アクセスは、最初の呼び出しから実際のトークン単価を試せます。本当の問いがリクエスト数ではなくスケール時のコストである場合に有用です。
三つはいずれもオープンウェイトモデルの異なるサブセットをホストしており、あるプロバイダーでタスクに合うモデルが別のプロバイダーには存在しない場合があります。
FAQ
Together AI、Fireworks AI、Groq はすべて OpenAI SDK を使っていますか? はい。三つとも OpenAI 互換エンドポイントをドキュメント化しているため、ベース URL とキーを変更すれば、標準の openai クライアントライブラリがどれに対しても機能します。
どのプロバイダーの無料枠が最大ですか? 直接比較できる形では答えられません。Groq はモデルごとの実際の Free Plan の数字を公表しており(gpt-oss-120b/gpt-oss-20b で 30 RPM / 1K RPD / 8K TPM / 200K TPD)、Together AI は固定の数字を一切設定しておらず、Fireworks AI は無料アクセスを枠ではなく一度限りのクレジット残高に結び付けています。自分の数字が異なる場合は console.groq.com/settings/limits を確認してください。
レート制限は API キーごと、それともアカウントごとに適用されますか? Groq の場合、制限は組織レベルで適用されるため、一つのアカウントの複数のキーは同じプールを共有します(同社のレート制限ドキュメントによる)。Together AI と Fireworks AI は、確認したページではこれを明示していません。別の前提を置く前に、自分のダッシュボードで確認してください。
これらのプロバイダーのいずれかでレート制限に達するとどうなりますか? HTTP 429 レスポンスが返ります。詳細は異なります。ほとんどの OpenAI 互換 API が返すリトライヘッダーの読み方と、推測ではなくバックオフロジックを組む方法については、レート制限超過ガイドをご覧ください。
すべてのドキュメントページを自分で読むよりも速く比較する方法はありますか? 上記のように、コーディングエージェントに三つの環境に対して一つの Apidog CLI テストケースを実行させてください。Apidog CLI での20分は、この記事を含むどの比較表よりも、あなたの実際のワークロードについて多くのことを教えてくれます。