
Qwen 3.8 27B をローカルで実行するには、Ollama をインストールして ollama pull qwen3.8:27b を実行し、続けて ollama run qwen3.8:27b を実行します。デフォルトのビルドは 18 GB の 4 ビットダウンロードなので、VRAM 24 GB の GPU、またはユニファイドメモリ 32 GB の Mac があると安心です。重みは Apache-2.0 ライセンスなので、モデル自体は無料です。コストがかかるのはハードウェアと電気代だけです。
これが手短なまとめです。このガイドの残りの部分では、使う価値のある 4 つのランナー(Ollama、LM Studio、llama.cpp、MLX)、各量子化に必要なメモリ量、実際のハードウェアで期待できる速度、そしてローカルエンドポイントの起動後にコーディングエージェントへ Apidog CLI でテストさせる方法を解説します。
このファミリーが初めてという方は、Qwen 3.8 とはで 2.4 兆パラメータの Max フラッグシップを紹介しています。このガイドが扱うのは、デスクに置ける小型のdense モデルという兄弟分です。
Qwen 3.8 27B とは?
Qwen 3.8 27B は、Alibaba の Qwen チームが 2026 年 8 月に Apache-2.0 ライセンスでリリースした、270 億パラメータの dense な視覚言語モデルです。テキスト・画像・動画を読み込み、デフォルトで回答前に思考を行い、ネイティブで 262,144 トークンのコンテキストウィンドウを備え、YaRN スケーリングにより 100 万トークンまで拡張できます。
公式モデルカードには以下のスペックが記載されています:
| スペック | Qwen 3.8 27B |
|---|---|
| パラメータ | 27B dense(Hub ではビジョンエンコーダを含む 28B と記載) |
| レイヤー | 64。Gated DeltaNet と Gated Attention ブロックのハイブリッド |
| コンテキスト | ネイティブ 262,144、YaRN で最大 1,000,000 |
| 入力 | テキスト、画像、動画 |
| 思考モード | デフォルトでオン。reasoning_effort は xhigh、medium、low から選択 |
| その他 | マルチトークン予測(MTP)レイヤー |
| ライセンス | Apache-2.0 |
Qwen 自身のベンチマーク表では、SWE-bench Pro で 61.7、Terminal Bench 2.1 で 73.0、GPQA Diamond で 89.2 を記録しています。これらはベンダー公表値です。Qwen 3.8 ベンチマーク徹底解説では、この表の読み方(Qwen が社内で実施した項目の見分け方を含む)を説明しています。
ローカル実行で重要な理由:4 ビットの 27B dense モデルならコンシューマー GPU 1 枚に収まり、ツール呼び出し、ビジョン、思考モードがすべて 1 つのファイルに含まれています。
Qwen 3.8 27B にはどれくらいの RAM/VRAM が必要?
目安として、量子化ファイルのサイズに加えて KV キャッシュとランタイム用に 3〜6 GB を見込んでください。デフォルトの Q4_K_M なら、GPU では VRAM 24 GB、Mac では 32 GB が必要です。
以下は unsloth の量子化リポジトリの GGUF ファイルサイズです(2026 年 11 月 9 日時点で確認):
| 量子化 | ファイルサイズ | 現実的なハードウェア |
|---|---|---|
| UD-IQ2_XXS | 7.27 GB | 16 GB Mac または 12 GB GPU。品質劣化が顕著 |
| UD-Q3_K_XL | 13.1 GB | 16 GB GPU、24 GB Mac |
| UD-Q4_K_M | 16.5 GB | 24 GB GPU、32 GB Mac(最適バランス) |
| UD-Q5_K_M | 19.8 GB | 短いコンテキストなら 24 GB GPU、32 GB Mac |
| UD-Q6_K | 22 GB | 32 GB GPU、48 GB Mac |
| Q8_0 | 29 GB | 48 GB GPU、64 GB Mac |
画像入力を使いたい場合は、ビジョンプロジェクター(mmproj-F16.gguf)がさらに 928 MB 追加されます。Ollama のデフォルトタグ qwen3.8:27b が 18 GB なのは、ビジョン機能がバンドルされているためです。
コンテキスト長は隠れたコストです。llm-speed の計算によると、Q4_K_M は 32,000 トークンのコンテキストで約 21.9 GB になります。そのため、Q4 の実用最低ラインは 24 GB カードであり、メモリに余裕がない限り 262K のフルウィンドウを読み込むべきではありません。
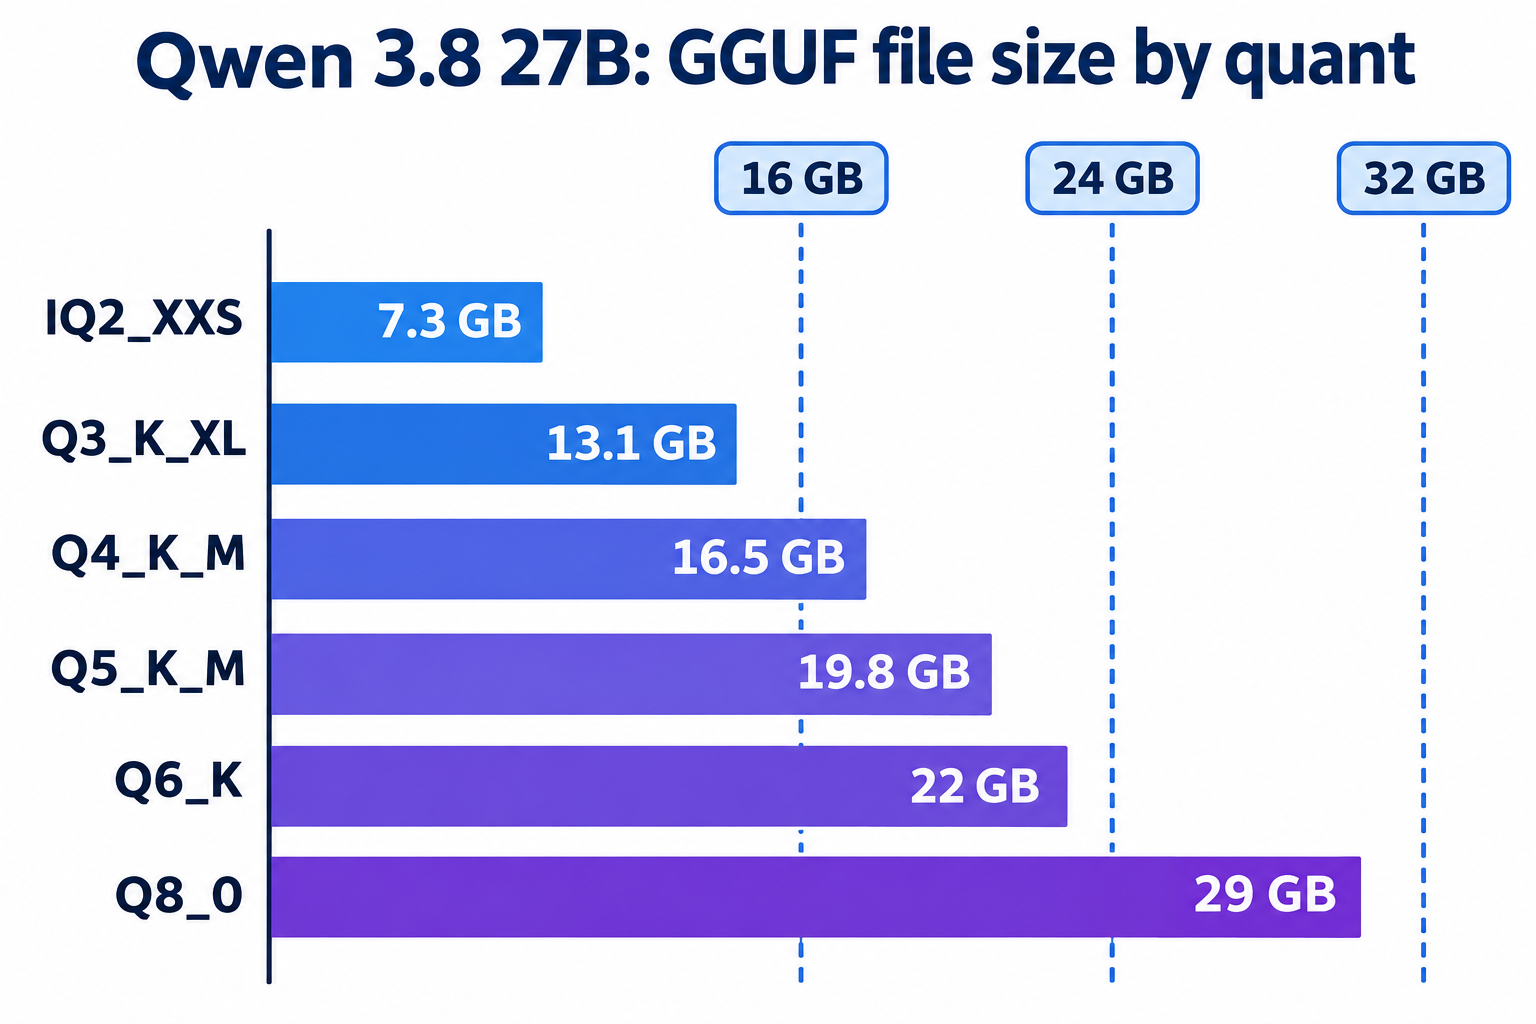
Mac の場合、macOS はユニファイドメモリの一部をシステム用に確保することに注意してください。24 GB の Mac でも技術的には Q4_K_M を読み込めますが、コンテキストやブラウザに使える余地はほとんど残りません。その場合は Q3_K_XL を選ぶのがおすすめです。
Qwen 3.8 27B はローカルでどのくらい速く動く?
RTX 3090 や 4090 では Q4_K_M × llama.cpp でおよそ毎秒 38〜44 トークン、RTX 5090 では 65〜75 トークンが期待できます。M3 Ultra 搭載の Mac Studio では毎秒 25〜27 トークン程度のデコード速度です。
私たち自身はベンチマークを取っていません。以下は llm-speed が公表した実測値で、記載されたハードウェアとランタイムによるものです:
| ハードウェア | 量子化 / ランタイム | デコード (tok/s) | プリフィル (tok/s) |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M、llama.cpp | 38.6(短いチャット、4K ctx) | 482 |
| RTX 4090 24 GB | Q4_K_M、llama.cpp | 43.4(短いチャット、4K ctx) | 448 |
| RTX 5090 32 GB | Q4_K_M、llama.cpp | 75.2(短いチャット、4K ctx) | 563 |
| L40S 45 GB | Q4_K_M、llama.cpp | 34.3(短いチャット) | 569 |
| M3 Ultra 96 GB | Q4_K_M、llama.cpp | 25.2(短いチャット) | 45 |
| M3 Ultra 96 GB | 4-bit、MLX 0.31.3 | 27.3(短いチャット) | 12 |
GPU ではコンテキストが長くなってもデコード速度はほとんど低下しません:4090 は 33,133 トークンのプロンプト後も 39.0 tok/s を維持しました。Mac が後れを取るのはプリフィルです。11,827 トークンのプロンプトで M3 Ultra は約 283 tok/s だったのに対し、4090 では約 2,000〜3,000 tok/s でした。つまり大きなコードベースでは、最初のトークンが出るまで数十秒かかるということです。
思考モードも時間を消費します。Simon Willison がローカルの Qwen 3.8 27B に生のモデル重みからゲームを特定させたところ、1 つの回答に 46 分と 43,506 の推論トークンがかかりました。日常のタスクでは、reasoning_effort を low に下げるか、思考モードをオフにしましょう。
Ollama で Qwen 3.8 27B を実行する
Ollama はどの OS でも最速の導入手段です。ollama.com からインストールして、以下を実行します:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
Apple Silicon では qwen3.8:27b-mlx タグを試してみてください。同じ 18 GB で MLX バックエンドを使用します。
Ollama のデフォルトコンテキストは小さく、長いエージェントセッションでは問題になります。サーバー起動前に引き上げておきましょう:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
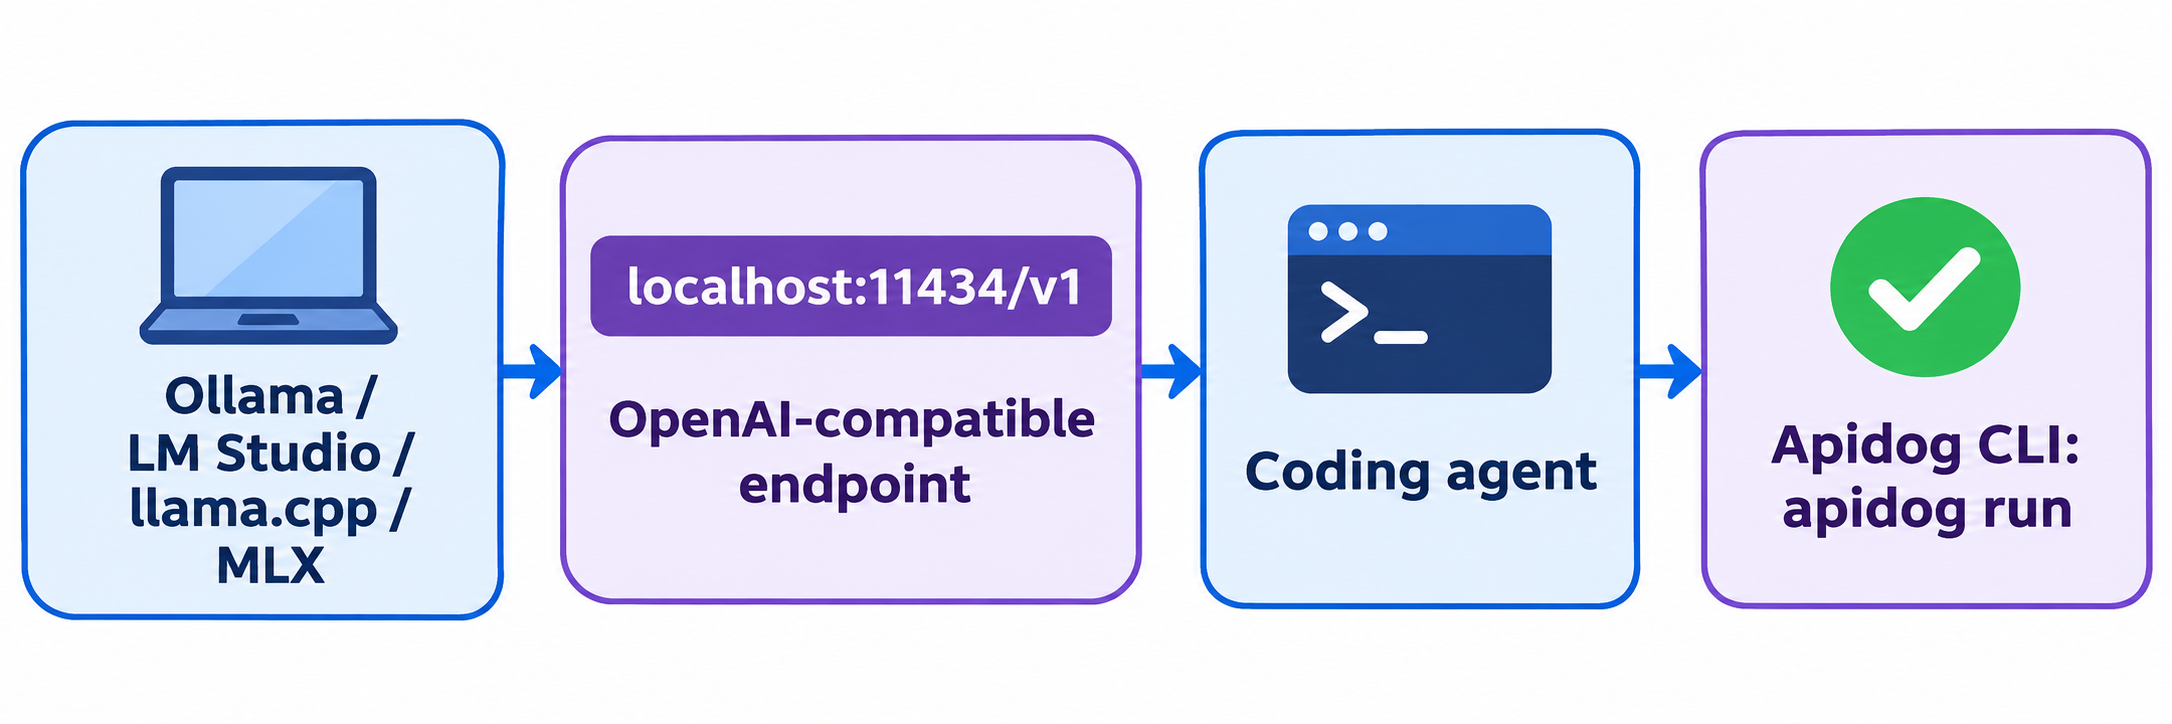
Ollama は http://localhost:11434/v1 で OpenAI 互換 API も公開しているため、ベース URL を変えるだけでどの OpenAI SDK でも動作します:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
コーディングエージェントの中で使いたい場合にも、Ollama は起動ショートカットを用意しています:ollama launch claude --model qwen3.8 でローカルモデルに対して Claude Code が起動し、ollama launch opencode --model qwen3.8 なら OpenCode で同様に起動します。
LM Studio で実行する
GUI とモデルごとのロード設定が欲しいなら、LM Studio がおすすめです。Qwen 3.8 27B を検索し、Q4_K_M(16.8 GB)の lmstudio-community/Qwen3.8-27B-GGUF ビルドをダウンロードしてロードします。
重要な設定が 1 つあります:モデルをロードするときにコンテキスト長を引き上げてください。Simon Willison はデフォルトの 8,192 トークンコンテキストでは長いプロンプトでエラーになり、より大きなウィンドウでロードし直す必要がありました。
その後、Developer タブを開いてローカルサーバーを起動するか、ターミナルから lms server start を実行します。OpenAI 互換エンドポイントは http://localhost:1234/v1 にあります。
llama.cpp で実行する
llama.cpp は最も柔軟な制御が可能で、上記のベンチマーク結果の大半はこのランタイムによるものです。macOS または Linux では:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf は Hugging Face から量子化モデルを直接ダウンロードし、--jinja はモデルのチャットテンプレートを適用し(ツール呼び出しと思考モードに必要)、-c はコンテキストを設定、-ngl 99 はすべてのレイヤーを GPU に置きます。サンプリングの値は Qwen が思考モード向けに推奨しているものです。非思考モードでは、モデルカードは temperature 0.7、top_p 0.8、top_k 20、presence_penalty 1.5 を推奨しています。
特定のリクエストだけ思考モードをオフにするには、ボディに "chat_template_kwargs": {"enable_thinking": false} を送ります。
Mac で MLX を使って実行する
MLX は Apple 純正の配列フレームワークで、Apple Silicon ではデコード速度が最も速いランタイムであることが多いです。mlx-lm をインストールし、mlx-community の 4 ビット変換版を使用します:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server は OpenAI 互換の /v1/chat/completions ルートを公開します。mlx-community の org では、メモリと品質や速度をトレードしたい場合に備えて、8 ビット、mxfp4、MTP の各バリアントも公開されています。
Apidog CLI でコーディングエージェントにローカルエンドポイントをテストさせる
どのランナーも同じ OpenAI 互換の形状で提供されますが、思考ブロック、ツール呼び出し、タイムアウトの処理はそれぞれ異なります。localhost にアプリを向ける前に、コーディングエージェントに Apidog CLI で再現可能なテストを構築させておきましょう。そうすれば、壊れたテンプレートやコンテキスト上限の問題は、タスクの途中ではなく数秒で検出できます。
一度だけセットアップします:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
その後、Claude Code、Codex、Cursor のいずれかに次の 1 つのプロンプトを与えます:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
エージェントは各ペイロードのスキーマを読み、JSON を検証し、リソースを作成してテストケースを実行します:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
長めの --timeout-request がここでは重要です:思考モードの 27B モデルは Mac では数分かかることがあります。ベース URL を http://localhost:1234/v1 や :8080/v1 に切り替えれば、同じテストケースで LM Studio、llama.cpp、MLX を確認できます。さらなるエージェント設定については、Claude Code での Apidog CLI と apidog run コマンドリファレンスを参照してください。Apidog の Free プランは最大 4 ユーザーまで利用できます。
ローカル実行 vs ホステッド Qwen 3.8 API
ローカル実行ではプロンプトが自分のマシンから出ず、オフラインで動作し、トークンごとの課金もありません。その代わりに速度とスケールで劣ります:ホステッドエンドポイントは、はるかに大きな Qwen 3.8-Max を 1M コンテキストで、プリフィルの待ち時間なしに提供します。フラッグシップが必要な場合は、Qwen 3.8 API ガイドや無料でアクセスする方法を参照してください。どちらのサイズでエージェント的コーディングを行う場合も、Qwen 3.8 でコーディングがハーネスの設定を比較しています。
FAQ
Qwen 3.8 27B はローカルで無料で実行できますか? はい。重みは Hugging Face で Apache-2.0 ライセンスであり、Ollama、LM Studio、llama.cpp、MLX はすべて無料です。支払うのはハードウェアと電気代だけです。
16 GB の Mac で Qwen 3.8 27B を実行できますか? 短いコンテキストでの UD-IQ2_XXS(7.27 GB)のような 2 ビット量子化であれば可能ですが、品質は目に見えて低下します。快適な構成は Q4_K_M を実行する 32 GB の Mac です。
Qwen 3.8 27B は RTX 3090 で動きますか? はい。Q4_K_M なら 24 GB に収まり、16K〜32K のコンテキストの余地もあり、llm-speed は llama.cpp で毎秒約 38 トークンを計測しています。
思考モードをオフにするには? llama.cpp または vLLM では "chat_template_kwargs": {"enable_thinking": false} を送るか、reasoning_effort を low に下げます。非思考モードでは Qwen が temperature 0.7、top_p 0.8 を推奨しています。
ローカルモデルは画像に対応していますか? はい。Ollama の 18 GB タグにはビジョン機能が含まれています。llama.cpp の場合は、モデルに加えて mmproj-F16.gguf ファイルをダウンロードしてください。
Qwen 3.8 27B と Qwen 3.8-Max の違いは? Max は Alibaba の API 経由で提供される 2.4 兆パラメータの mixture-of-experts フラッグシップです。27B は GPU 1 枚か 32 GB の Mac に収まる dense モデルです。