
NVIDIAの新しいNemotron 3.5 Transcribeは1台のGPUで実行でき、1時間の録音を40言語で文字起こしできます。分単位の課金も、音声を誰かに送信する必要もありません。Hugging Face Open ASR Leaderboardでトップのオープンウェイトモデルであり、商用利用しやすいOpenMDW-1.1ライセンスで提供され、NVIDIAはリリース日の2026年10月28日にBF16、FP8、NVFP4の重みを公開しました。
このガイドでは、必要なハードウェア、実行する3つの方法(vLLM、SGLang-Omni、Transformers)、公式モデルカードの正確なコマンド、そしてつまずきやすい設定について説明します。すべてのコマンドは2026年10月29日にモデルカードからコピーしたものです。
モデルは初めてですか? 無料ガイドで、何ができるかとランキングでの位置を説明しています。GPUがない場合は、ホスト型APIが1分あたり0.002ドルです。
なぜローカルで実行するのか
- 分単位の課金なし。 DeepInfraの1分あたり0.002ドルでは、10,000時間で1,200ドルかかります。自分のGPUなら電気代だけです。
- プライバシー。 顧客通話、医療のディクテーション、法的記録がネットワークの外に出ません。
- 全機能セット。 vLLMの経路では、単語タイムスタンプ、話者ダイアリゼーション、翻訳、コンテキストプロンプトをサポートします。ホスト型エンドポイントの一部はその一部しか公開していません。
- ファインチューニング。 NVIDIAのローンチ記事では、医療向けファインチューニングでWERが30.8%から11.8%に下がったことが示されています。それは重みがなければできません。
ハードウェア:何で実行するか
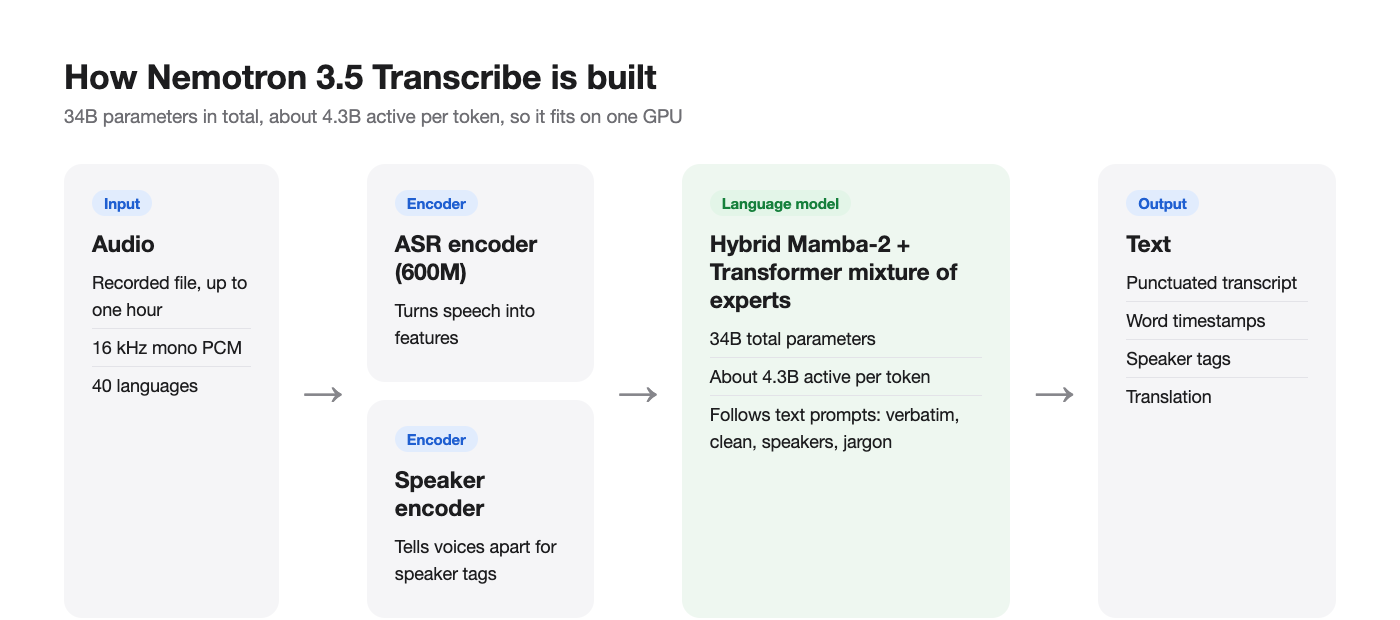
このモデルは合計34Bパラメータで、アクティブは約4.3Bです。そのため、トークンあたりの計算量は小さくても、重みは大きくなります。NVIDIAの参考ターゲットはBF16のH100 80 GB 1台です。モデルカードの互換性表は次のとおりです:
| GPU | 精度 | ランタイム |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | NVFP4 のみ | vLLM 0.32.0, Transformers, GGML |
カードに合ったチェックポイントを選んでください:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
RTX 4090のような24 GBカードはリストに載っておらず、Apple Siliconはサポートされていません。オペレーティングシステムはLinux、またはWSL2経由のWindowsです。GGMLはネイティブWindowsでも動作しますが、NVIDIAのローンチ記事によると、NeMo-Speech.cppのローカルビルドはまだ「近日公開」だそうです。
オプション1:vLLMサーバー(推奨)
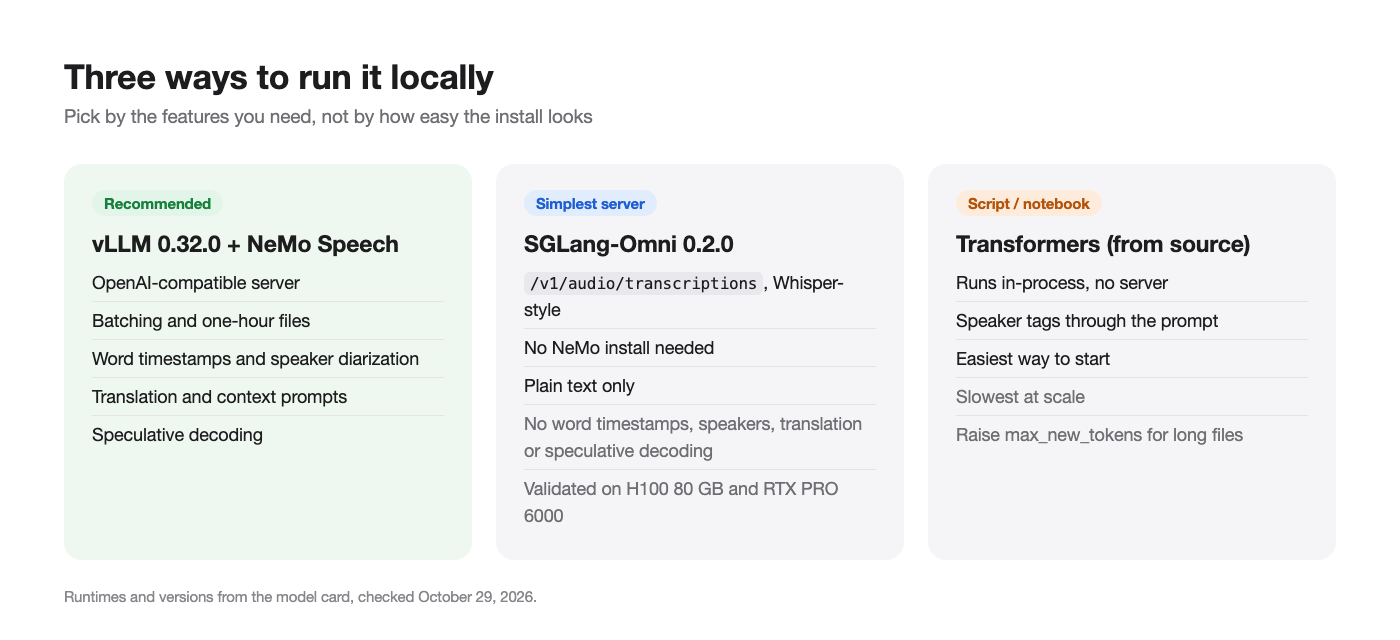
vLLMは、バッチ処理、1時間のファイル、投機的デコーディング、単語タイムスタンプを備えたOpenAI互換エンドポイントを提供します。vLLM 0.32.0と、モデルのvLLMプラグインを提供する最新のNeMo Speechメインブランチが必要です。
インストール
モデルカードではuvとPython 3.13を使用しています:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV(av)は、システムFFmpegなしでM4Aやその他の圧縮形式をデコードできるようにします。OpenCVは、vLLMがそれを必要とし、NeMoの依存関係設定では除外されているために含まれています。
サーバーを起動する
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
理解しておく価値のあるフラグ:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600は、vLLMの音声制限を600秒から1時間に引き上げます。これを忘れると長いファイルが失敗します。VLLM_USE_V2_MODEL_RUNNER=0はV1ランナーを維持します。単語タイムスタンプにはこれが必要です。--speculative-configは、8つのドラフトトークン(MTP8)によるマルチトークン予測を有効にします。H100では、NVIDIAはMTP8でバッチ英語のRTFx 270、MTP2で410を測定したので、レイテンシよりスループットを重視する場合は"num_speculative_tokens":2を試してください。--middleware ... ctc_timestamp_middlewareと--trust-request-mm-kwargsにより、リクエストで単語タイムスタンプを要求できます。- 設定は80 GBのH100を対象としています。他のカードでは、
--gpu-memory-utilization、--max-model-len、--max-num-seqsを下げてください。
サーバーは127.0.0.1:8000で待ち受けます。ネットワーク上の他のマシンからアクセスするには、--host 0.0.0.0を追加してください。
ファイルを送信する
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
テキスト指示は任意のタスクプロンプトに置き換えられます。複数の声がある会議の場合:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
単語タイムスタンプのリクエストにはルールがあります。1リクエストにつき1つの録音、stream=false、n=1です。レスポンスには、単語、開始時刻と終了時刻(秒)、話者タグを含むctc_timestampsオブジェクトが含まれます。
オプション2:単純な文字起こしにはSGLang-Omni
ファイル全体からテキストだけが必要なら、SGLang-Omni 0.2.0の方が簡単で、NeMoも不要です。BF16またはFP8チェックポイントで、H100 80 GB 1台とRTX PRO 6000 Blackwell 1台で検証済みです。
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
この/v1/audio/transcriptionsルートは、OpenAIのWhisper APIが使う形と同じなので、既存のWhisperクライアントコードは多くの場合、新しいベースURLだけで済みます。トレードオフとして、この統合では単語タイムスタンプ、話者ラベル、翻訳、投機的デコーディングはありません。
オプション3:スクリプト内のTransformers
ノートブックや単発のジョブでは、ソースからインストールしたHugging Face Transformersを使ってプロセス内で実行します:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
始めるには最も簡単な方法で、大規模に実行するには最も遅い方法です。長いファイルではmax_new_tokensを増やしてください。濃密な1時間で約20,000トークンを生成することがあります。
自分のGPUではどれくらい速いのか?
NVIDIAの見出しの数字は、RTX PRO 6000 Blackwell 1台で毎秒2,238秒の音声、NVFP4重みとDFlash2投機的デコーディングを使用し、30秒のクリップを0.13秒で返すというものです。脚注を読んでください。これらの数値は最適化されたNIMによるもので、そのサービングの変更はまだオープンソースではありません。モデルカードによると、オープンなvLLM統合は約2倍遅くなると予想されています。
BF16でのH100バッチ英語文字起こしについて、モデルカードには次のRTFx数値(計算1秒あたりの音声秒数)が記載されています:
| 投機的デコーディング | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
最も遅い行でも、バッチ処理では1時間の音声を15秒未満のGPU時間で処理します。DFlash2ドラフトモデルが必要な場合、vLLM 0.32.0にはモデルカードの小さなパッチが必要で、DFlash2は単語タイムスタンプを無効にし、MTPと組み合わせるべきではないことに注意してください。
よくある問題と修正
- 長いファイルが10分で切れる。
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600をスキップしています。 - レスポンスにタイムスタンプがない。
VLLM_USE_V2_MODEL_RUNNER=0、--middlewareフラグ、そしてリクエストにstream=falseと録音1つがあることを確認してください。 - 小さいカードでメモリ不足。 FP8またはNVFP4チェックポイントに切り替え、
--max-num-seqsを下げてください。 - 文字起こしの末尾でフレーズが繰り返される。 モデルカードは最終出力に生成ループのガードレールを推奨しています。
max_tokensを制限し、繰り返しを削除してください。 - 名前のスペルが間違っている。 プロンプトに
Context terms: <names>を追加してください。 - 文字起こしに背景の声が入る。 モデルカードの実験的な近接場プロンプトを試してください。NVIDIAのテストでは、混合音声のWERが27.32%から4.78%に下がりました。
vLLM自体が初めてなら、vLLM解説でリクエストのバッチ処理とGPUメモリ管理の方法を説明しています。
コーディングエージェントにApidog CLIでローカルサーバーをテストさせる
ローカルモデルは、vLLMのアップグレード、プロンプトの調整、チェックポイントの交換を通じてエンドポイントが正しいままでなければ役に立ちません。コーディングエージェントにApidog CLIでそれを管理させ、同じマシンからhttp://127.0.0.1:8000に対してチェックを実行させましょう。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、エージェントに1つのプロンプトを与えます:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
エージェントはスキーマを読み、ペイロードを検証し、ケースを作成して実行します:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
サーバーをアップグレードするたびに実行するか、CI/CDパイプラインでのApidog CLIで示されているようにapidog run ... -r junitをCIに組み込んでください。エージェントの設定については、Claude CodeでのApidog CLIを参照してください。
よくある質問
RTX 4090でNemotron 3.5 Transcribeを実行できますか? NVIDIAの互換性リストにはありません。リストにある最小のコンシューマーカードは、NVFP4チェックポイントのRTX 5090です。
Macで動作しますか? 2026年10月29日時点で、Apple Siliconをサポートする公式ランタイムはありません。
商用製品でのローカル利用は無料ですか? OpenMDW-1.1ライセンスは商用利用と非商用利用を許可しています。出荷前に、帰属表示の条件についてライセンス本文を読んでください。
ライブ音声を文字起こしできますか? いいえ。録音ファイル用のオフラインモデルです。NVIDIAはライブ用途向けに別のNemotron 3.5 ASR Streamingモデルを提供しています。
vLLMとSGLang-Omniではどちらが速いですか? NVIDIAは直接比較を公開していません。タイムスタンプ、話者、翻訳が必要な場合はvLLMを、最も単純なテキスト専用サーバーが必要な場合はSGLang-Omniを使ってください。
他のローカルモデルと比べてどうランク付けされますか? 10月28日のOpen ASR Leaderboardで、すべてのオープンウェイトモデルをリードしています。最高のオープンソース音声テキスト変換モデルのリストでは、Qwen3-ASR、Granite Speech、Canary-Qwen、Voxtral、Whisperと比較しています。
実行する
GPUに合ったチェックポイントをダウンロードし、1時間の音声制限とタイムスタンプミドルウェアを使ってvLLMを起動し、OpenAIクライアント経由でWAVファイルを送信してください。次に、エージェントにローカルエンドポイントに対してApidogチェックを実行させ、実際の録音を任せる前に、アップグレードのたびにまだ文字起こしできることを証明しましょう。