
ERNIE 5.5 Flash をローカルで実行するには、vLLM 0.32.0 と Baidu の vLLM-ERNIE プラグインをインストールし、マルチGPUノード上でデータ並列とエキスパート並列を有効にして vllm serve baidu/ERNIE-5.5-Flash-Base を実行します。ポート8000でOpenAI互換サーバーが起動します。ただし注意点があります。現時点で公開されているオープンウェイトはBaseモデル、つまりチャットモデルではなくテキストの続きを生成する事前学習チェックポイントです。
以下では、ダウンロード可能なもの、Baiduが公表しているハードウェア要件、正確な serve コマンド、エンドポイントのテスト方法を解説します。記載されているすべてのコマンドと数値は、BaiduのHugging Face モデルカードとvLLM-ERNIE リポジトリから引用し、2026年11月12日時点で確認したものです。
このモデルが初めての方は、まずERNIE 5.5 Flash とはをご覧ください。GPUクラスタなしでチャットモデルを使いたい場合は、ERNIE 5.5 Flash API ガイドの方が手軽です。
今ローカルで実行できるものは?
実行できるのは、Hugging Face で FP8 と BF16 で公開されている ERNIE 5.5 Flash Base です。これはトークンごとに140億パラメータがアクティブになる2,800億パラメータのスパースな MoE(Mixture-of-Experts)モデルで、33.5兆トークンで学習されています。チャット向けにチューニングされた ERNIE 5.5 Flash Preview は現時点でAPI専用で、Baidu はそのウェイトを「近日中に」Apache 2.0 で公開すると述べています。
自己ホスト環境における2つのリリースの比較は以下のとおりです:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| 種別 | 事前学習完了時点のチェックポイント | 最初のポストトレーニング済み(チャット・推論・エージェント)モデル |
| ウェイト | Hugging Face と ModelScope、FP8 と BF16 | 2026年11月12日時点で未公開 |
| 呼び出すエンドポイント | /v1/completions(テキストの継続生成) |
推論とツールに対応したチャット completions |
| ライセンス | ERNIE 5.5 Flash Base Model License v1.0 | 公開時に Apache 2.0 を予定 |
| 現時点での利用先 | 自前のGPU | Qianfan API、OpenRouter |
現時点で、Baidu の ERNIE-5.5-Flash コレクションには2つの Base チェックポイントのみが存在し、vLLM-ERNIE の README ではチャットモデルは「Coming soon」とされています。Preview リリース記事に日付の記載はありません。
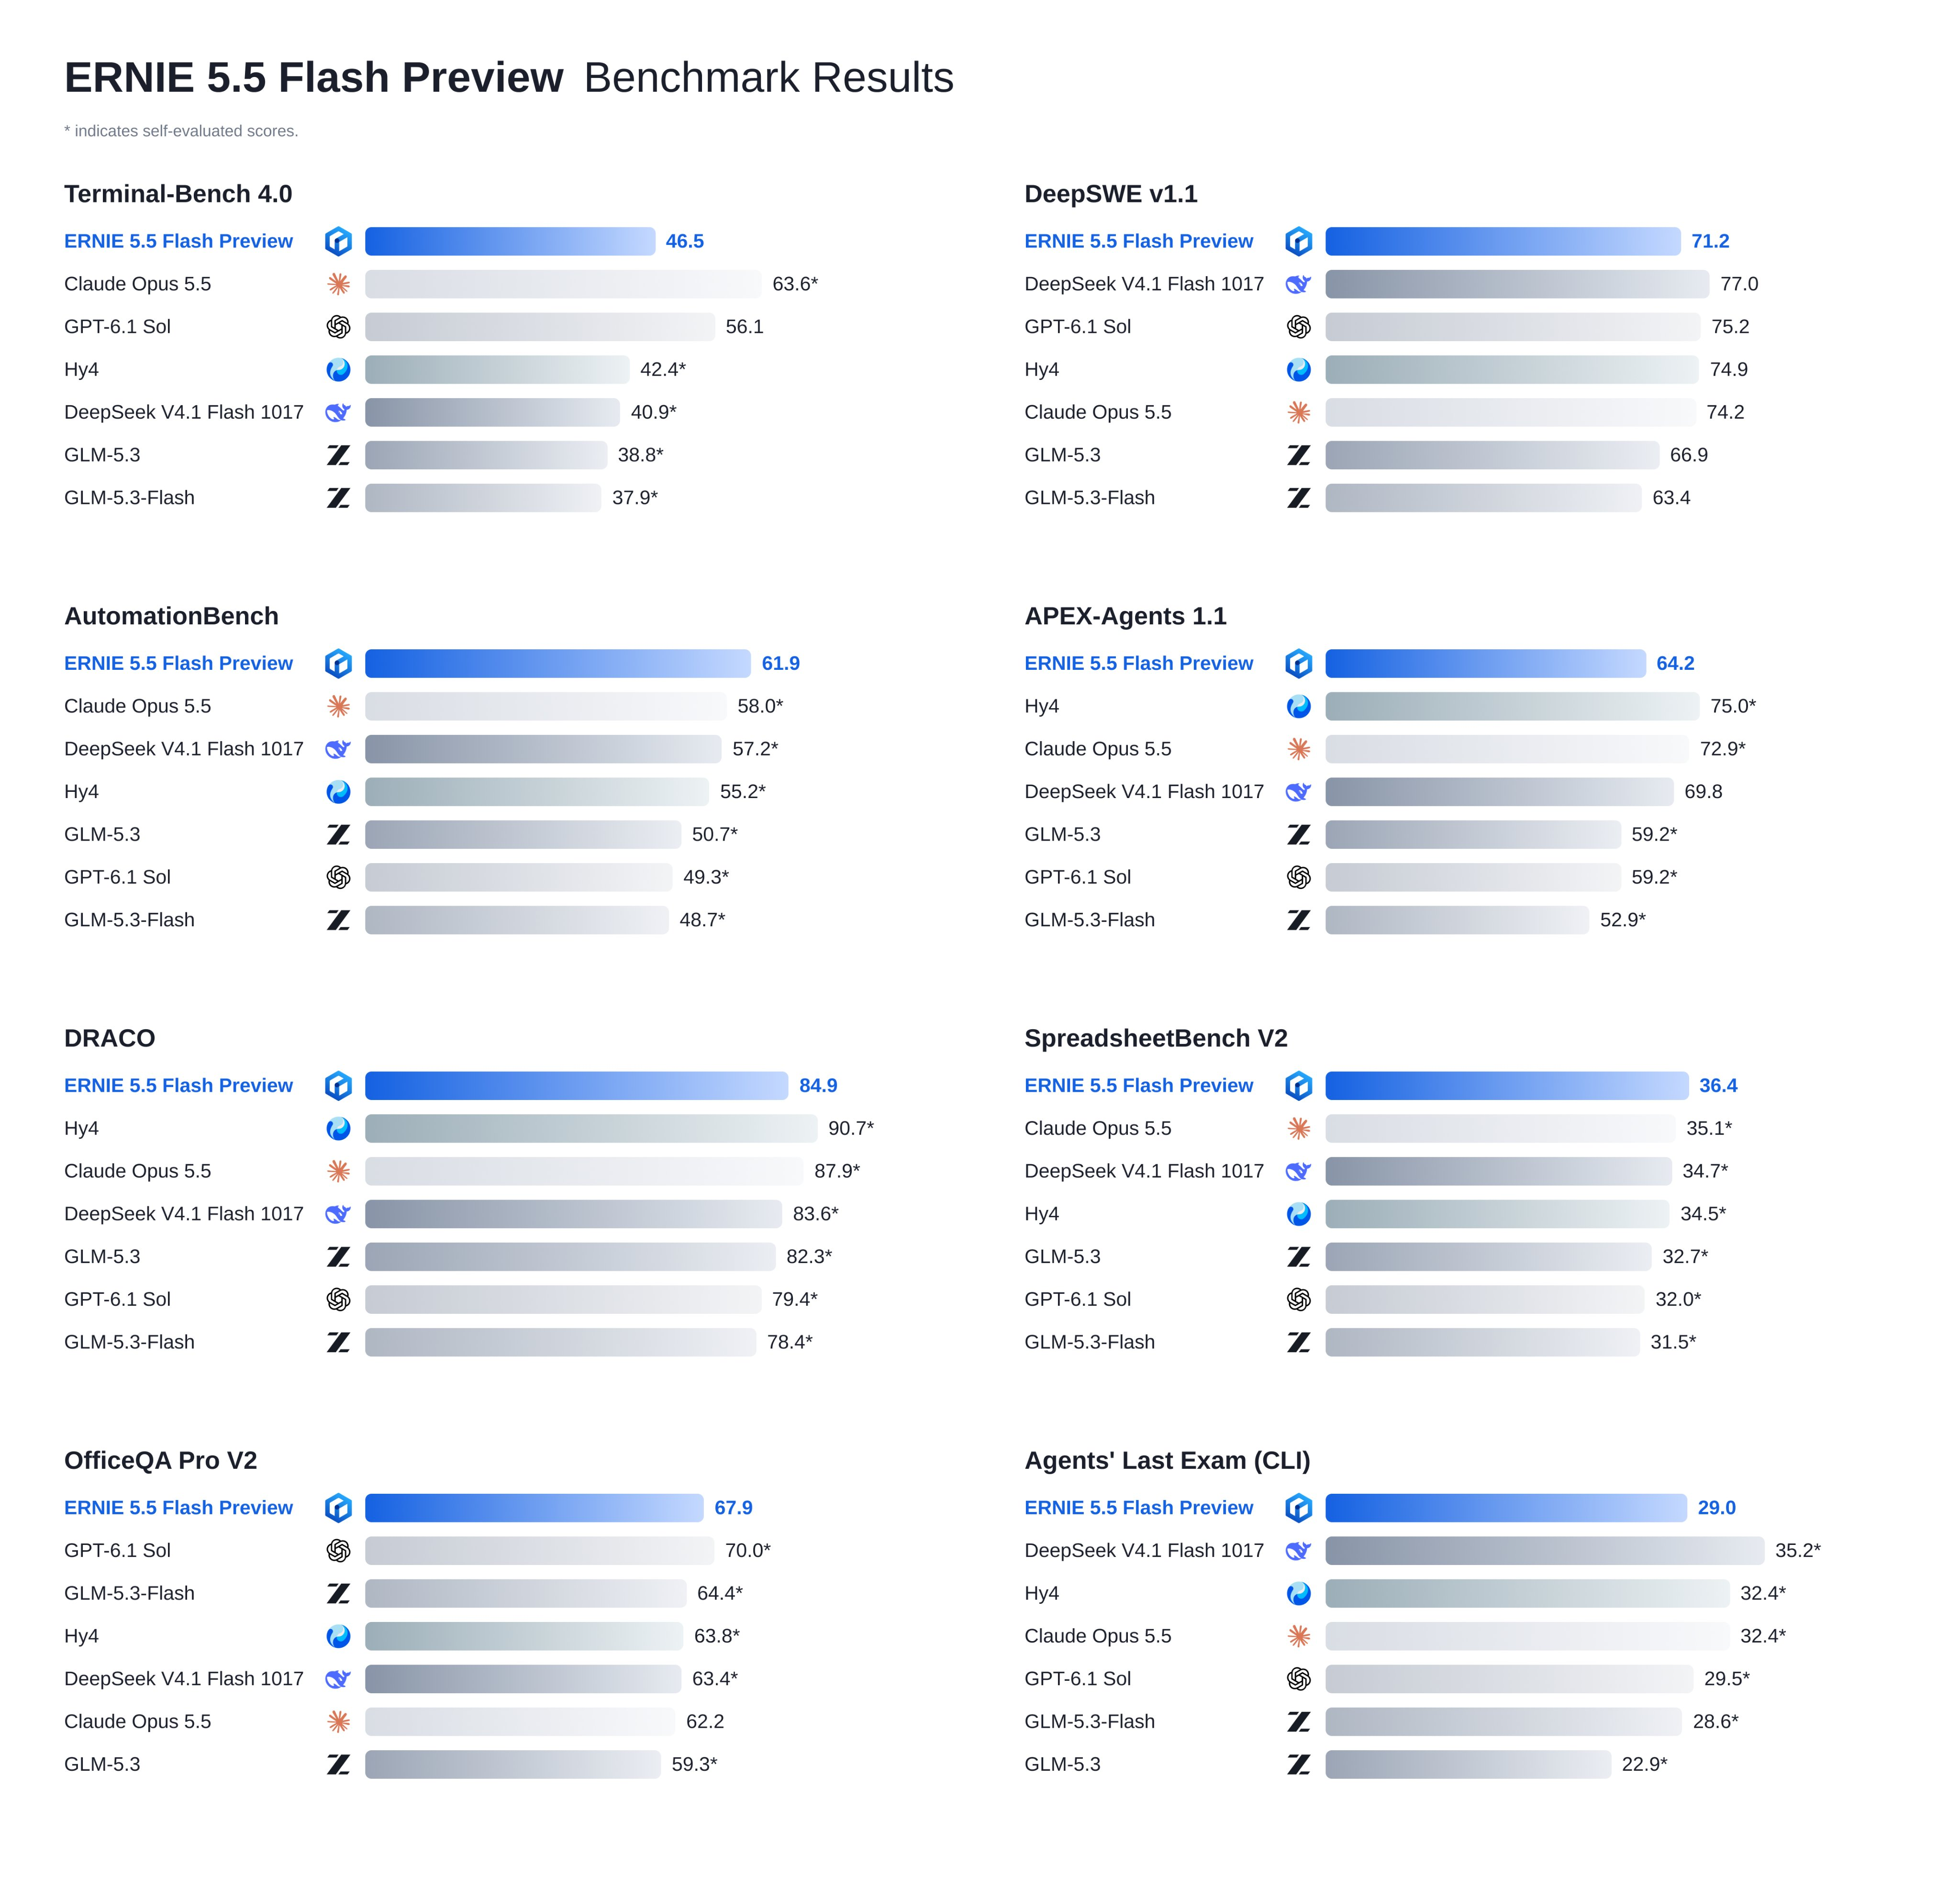
今すぐコーディングアシスタントが欲しいなら、ローカルの Base モデルでは実現できません。ファインチューニングや few-shot 研究の出発点が欲しいなら、Base はまさにそのために作られたものです。
ERNIE 5.5 Flash のハードウェア要件
FP8 ウェイトは約280 GB、BF16 ウェイトは約560 GBのGPUメモリを必要とします。つまりこれはマルチGPUサーバー向けの作業であり、ラップトップでは無理です。vLLM-ERNIE の README にはウェイトを格納できる最小GPU枚数が記載されており、プラグインは NVIDIA GPU でのみ動作します。
| カードあたりのGPUメモリ | FP8(約280 GBのウェイト) | BF16(約560 GBのウェイト) |
|---|---|---|
| 288 GB | 2 GPU | 4 GPU |
| 192 GB | 4 GPU | 8 GPU(または 2ノード × 4 GPU) |
| 80 GB | 8 GPU | 2ノード × 8 GPU |
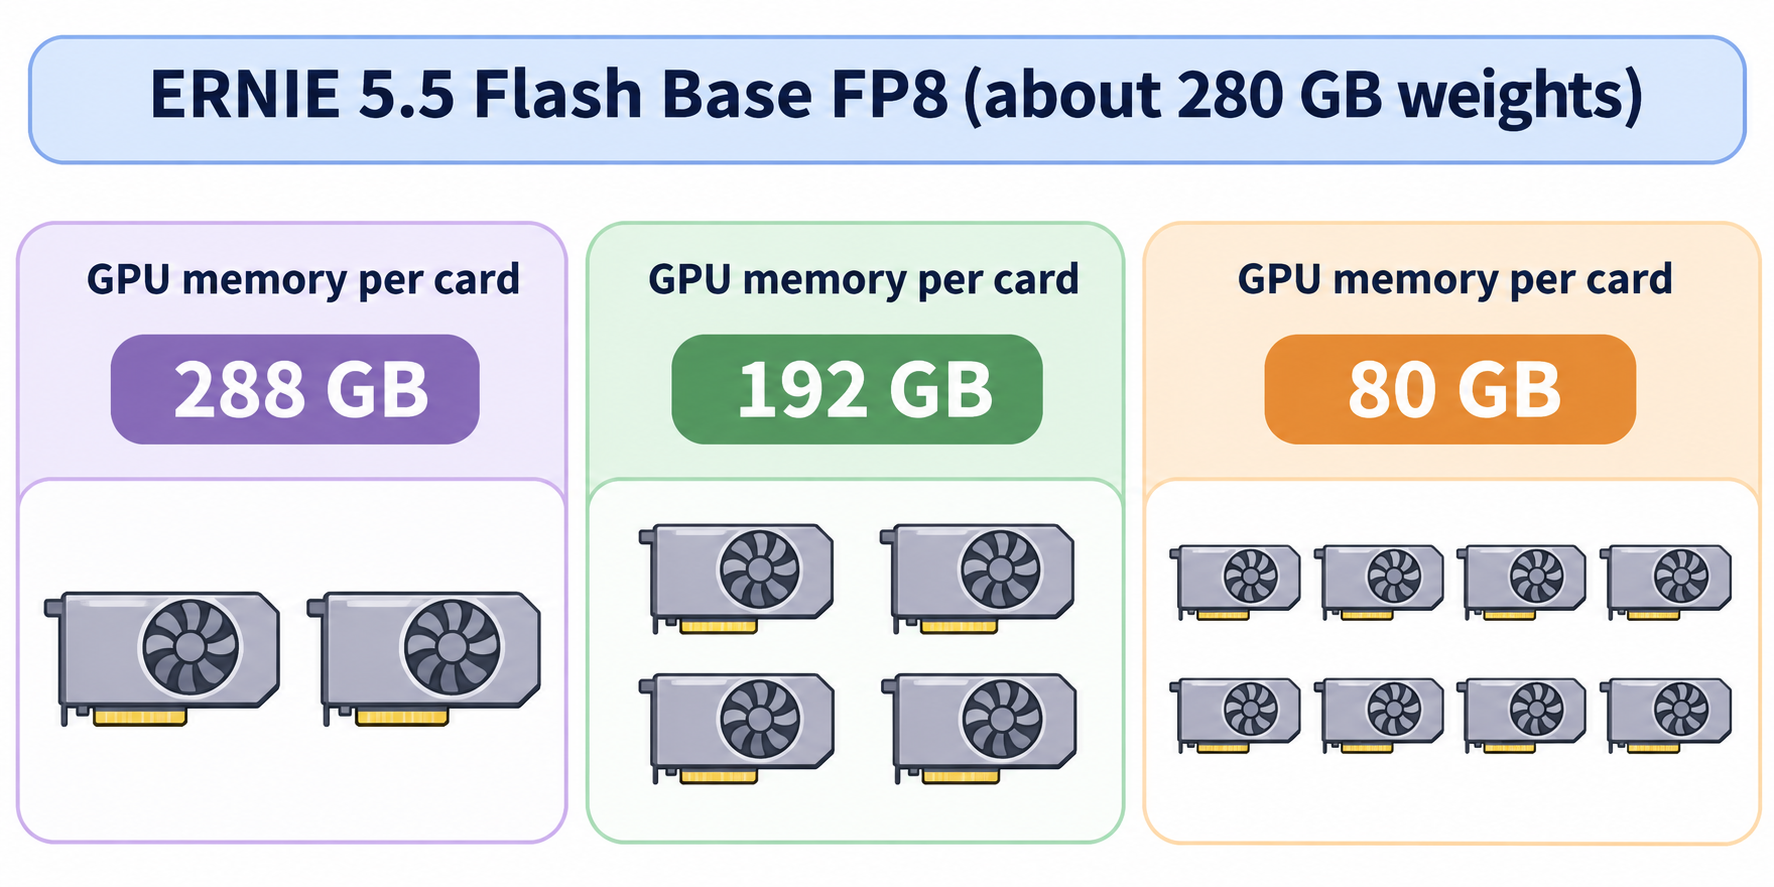
これらはウェイトをロードするための最低要件です。KVキャッシュには追加の余裕が必要で、そのため搭載カードによって処理可能なコンテキスト長が変わります:
- 80 GB GPU:8 GPUでFP8をサーブする場合、
--data-parallel-size 8と--gpu-memory-utilization 0.93を指定します。最大262,144トークンが収まりますが、100万トークンは収まりません。 - 100万トークンのコンテキスト:Baidu の値は184 GiB メモリのGPU向けで、100万トークンのプリフィルには数十GBの一時メモリが必要なため、使用率は0.85に下げられています。
- アーキテクチャが重要:FP8 のコマンドでは
--moe-backend hummingを渡します。これは Blackwell GPU 上でFP8ウェイトによるモデルの SiTU アクティベーションをサポートします。Hopper GPU ではこのフラグを外し、vLLM のデフォルトの MoE カーネルを使ってください。
ここでの「ローカル」とは、自分が管理するハードウェア、つまりレンタルした8 GPUノード、オンプレミスサーバー、ラボのクラスタを意味します。
vLLM と ERNIE プラグインのインストール
vLLM は標準では ERNIE 5.5 アーキテクチャ(Ernie5_5_MoeForCausalLM)に対応していません。Baidu はこれを、公開されている vLLM 0.32.0 の wheel をそのまま(修正なしで)使って動作するプラグインとして提供しています。Python 3.12 の環境を作成し、両方をインストールしてください:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
プラグインは、すべての vLLM プロセスで vLLM の vllm.general_plugins エントリポイントを通じてロードされます。後で vllm serve が Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported というエラーを出す場合は、vllm を実行している環境にプラグインがインストールされていないか、VLLM_PLUGINS が設定されているのに ernie が含まれていないかのどちらかです。
Hugging Face の代わりに ModelScope からウェイトを取得するには、VLLM_USE_MODELSCOPE=True を設定します。リポジトリ名は両ハブで同じです。vLLM 自体が初めての方は、vLLM の概要でサーバーとそのOpenAI互換APIを解説しています。
ERNIE 5.5 Flash 向けの vLLM serve コマンド
以下は vLLM-ERNIE の README にある FP8 のコマンドで、128K の学習コンテキストで ECHO スペキュレーティブデコーディングを有効にした1台の4 GPUノード向けのものです:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Baidu のノートに基づき、各選択肢の効果は以下のとおりです:
- データ並列アテンション+エキスパート並列 MoE(
--data-parallel-size 4 --enable-expert-parallel)は、最も多くのKVキャッシュを保持し、最高のスループットを発揮します。テンソル並列(--tensor-parallel-size2、4、8)は低同時実行数ではレイテンシを下げますが、保持できるKVキャッシュは少なくなります。 - FP8 KVキャッシュ(
--kv-cache-dtype fp8)はキャッシュをFP8で保存します。autoはBF16のままです。 - ECHO スペキュレーティブデコーディングは、モデル自身の最終層を組み込みのドラフトモデルとして再利用します。ここでは2ステップのドラフトを行いますが、1や3でも動作します。
--speculative-configを外せばドラフトなしでサーブできます。
モデルカードには、スペキュレーティブ設定なしでポート30000を使う短いバリエーションも掲載されています。
セキュリティを確保してください。これらのコマンドは認証なしで 0.0.0.0 にバインドします。Baidu の README は、ネットワークが信頼できない限り --api-key <key> を追加するか 127.0.0.1 にバインドするよう指示しています。ポートを公開する前に、いずれか一方を必ず実施してください。
BF16 と 100万トークンのコンテキスト
BF16 は2台の4 GPUノード(DP8+EP8)で --data-parallel-size 8、--data-parallel-size-local 4、--data-parallel-address ${HEAD_IP}、--data-parallel-hybrid-lb を指定して実行し、2台目のノードでは --data-parallel-start-rank 4 を追加します。完全なコマンドは README からコピーしてください。ノード間のネットワークインターフェースもそこで指定されています。
フルの1,048,576トークンウィンドウを使うには、--max-model-len 1048576 と --gpu-memory-utilization 0.85 を渡し、各ランクのKVキャッシュに100万トークンのリクエスト全体が収まるように --max-num-seqs を下げてください。
OpenAI互換エンドポイントの呼び出し
vLLM はOpenAIスタイルのルートを公開しますが、Base モデルにはチャットテンプレートがないため、生のプロンプトで /v1/completions を呼び出します。few-shot で使う場合は、プロンプトに例を入れ、1つの回答の終わりで止まるようにします:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
Baidu の README では、completion のテキストとして 36 が返ってくるとされています。ここでつまずきやすい3つのポイントがあります:
- 貪欲デコーディングには
"temperature": 0を渡す。モデルのgeneration_config.jsonはdo_sample=false、temperature=1.0、top_p=0.95を設定しています。vLLM は temperature と top_p は適用しますがdo_sampleは無視するため、上書きしないとサンプリングが行われます。 <|ERNIE_MASK|>を自分で追加しない。トークナイザが completion プロンプトの先頭に(トークンID 2として)付与します。- モデル名を一致させる。BF16 ウェイトをサーブする場合は
baidu/ERNIE-5.5-Flash-Base-BF16を使ってください。
base_url を http://<host>:8000/v1 に向け、chat completions ではなく completions を呼び出せば、どの OpenAI SDK でも動作します。
Base か Preview か、どちらを使うべきか
その上で学習を行う予定なら Base を、今すぐ動くアシスタントが必要なら Preview を使ってください。Base は完全な制御権と、サーバーからデータが一切出ない環境を提供します。Preview はチャット、推論、ツール呼び出しを提供しますが、Qianfan か OpenRouter 経由のみです。
Preview のウェイトが公開されても、プラグインはすでにそれに対応しています。README には「Coming soon」とマークされた追加フラグが記載されています:--reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice、さらにスペキュレーティブデコーディング用の DSpark ドラフトモデルです。推論過程は reasoning_content に、ツール呼び出しは message.tool_calls に返されるようになるため、今構築したのと同じサーバーが、ウェイトの交換と3つのフラグ追加だけでチャットバックエンドになります。
ライセンスももう一つの違いです。Base は Apache 2.0 ではなく、ERNIE 5.5 Flash Base Model License Agreement v1.0 の下で提供されます。その上で製品を作る前にライセンス全文をお読みください。2026年11月12日時点での内容は以下のとおりです:
- 非商用利用は無料で、事前通知も不要です。
- 関連製品の年間収益が5000万米ドルまでの場合、商用利用でもライセンス料は無料ですが、「Powered by ERNIE」の表示と、Baidu への一度限りの通知が必要です。
- 年間収益が5000万米ドルを超える場合は、先に Baidu からの別途書面による許諾が必要です。
- ライセンスの「Territory(適用地域)」には、欧州連合、英国、韓国は含まれません。
より少ないGPUで自己ホストできる小規模なオープンウェイトモデルについては、GLM-5.3 の自己ホストガイドをご覧ください。
Apidog CLI でコーディングエージェントにエンドポイントをテストさせる
新規の vLLM デプロイには、フラグを変更するたびに再実行できるスモークテストが必要です:ステータス、レスポンススキーマ、トークン毎秒です。curl を打ち直す代わりに、それをコーディングエージェントと Apidog CLI に任せましょう。
まず CLI を一度セットアップします:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、Claude Code、Codex、Cursor に1つのプロンプトを渡します:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
エージェントはペイロードスキーマを読み、検証し、テストケースを書いて実行します:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
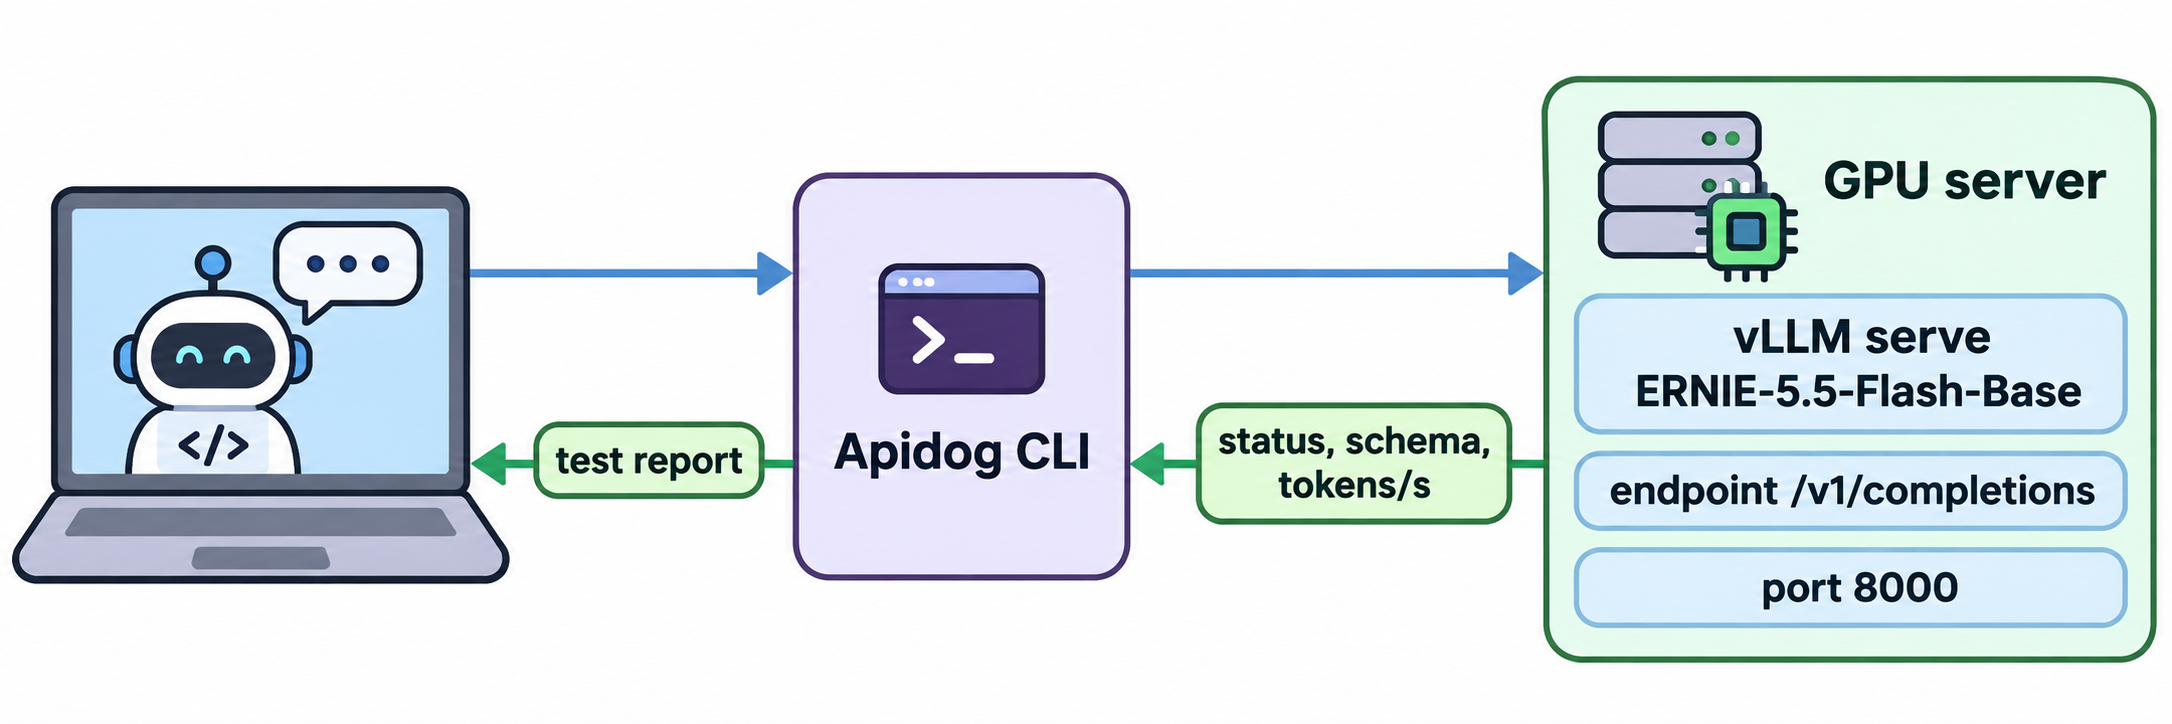
CLI はポート8000に到達できるマシンから実行してください。サーバーで --api-key を設定した場合は、エージェントに環境変数として保存させ、Bearer トークンとして送るように指示します。--tensor-parallel-size の変更、スペキュレーティブデコーディングの無効化、--max-model-len の引き上げの後には、同じテストケースを再実行すれば同一条件での比較が得られます。-r junit を追加すれば、同じ実行を CI に組み込めます。エージェントのセットアップ手順の詳細は、Claude Code での Apidog CLI をご覧ください。Apidog の Free プランは最大4ユーザーまで利用できます。
FAQ
ERNIE 5.5 Flash はコンシューマーGPU1枚で実行できますか? できません。FP8 ウェイトは約280 GBあり、Baidu が挙げている最小構成は288 GBのGPU2枚です。80 GBのカードなら8枚必要です。そのハードウェアがない場合は、API 経由で Preview を利用してください。
ERNIE 5.5 Flash Preview のウェイトは入手可能ですか? 2026年11月12日時点ではまだです。Baidu は「近日中に」Apache 2.0 でオープンソース化すると述べており、vLLM-ERNIE プラグインではチャットモデルが「Coming soon」とされています。Hugging Face にあるのは Base のウェイト(FP8 と BF16)のみです。
Base モデルで /v1/chat/completions が失敗するのはなぜですか? Base にはチャット学習もチャットテンプレートもありません。Baidu は生のテキストプロンプトで /v1/completions 経由で提供しています。プロンプトに few-shot 例を入れ、stop シーケンスを使ってください。
vLLM は ERNIE 5.5 をネイティブにサポートしていますか? vLLM コアでは未対応です。vLLM 0.32.0 の上に Baidu の vLLM-ERNIE プラグインが必要です。NVIDIA GPU でのみ動作します。SGLang も、モデルカードに記載されている専用 Docker イメージ経由でこのモデルをサーブできます。
ERNIE 5.5 Flash Base は商用利用できますか? 条件付きで可能です。年間収益が5000万米ドルまでの製品は、「Powered by ERNIE」の表記と Baidu への一度限りの通知により、ライセンス料なしで利用できます。それを超える場合は書面による許諾が必要で、ライセンスの適用地域にはEU、英国、韓国は含まれません。