
llama-modchipを使えば、GPUなしでDeepSeek V4 Flashをローカルで実行できます。llama-modchipはオープンソースのllama.cppパッチ群で、284Bモデルを1.71ビット/重みで56.56 GiBのGGUFに縮小します。64 GB RAM搭載の16コアAMD Zen 5ノートPCチップでは、プリフィル約44トークン/秒、デコード9〜15トークン/秒で、スワップはゼロです。
このガイドでは、必要なハードウェア、コマンド、品質面のトレードオフ、そしてコーディングエージェントでローカルエンドポイントをテストする方法を解説します。
llama-modchipが実際に行っていること
llama-modchipは、疎なMixture-of-ExpertsモデルをシステムRAM内で完全に実行するための、ggmlおよびllama.cppのカーネルパッチ、量子化トランスコーダー、ランタイムツール群です。v2.4.0リリースは2つのモデルサイズを対象としています。64 GBマシンでの284B DeepSeek-V4-Flashと、16〜32 GBマシンでの30B MoEモデルです。
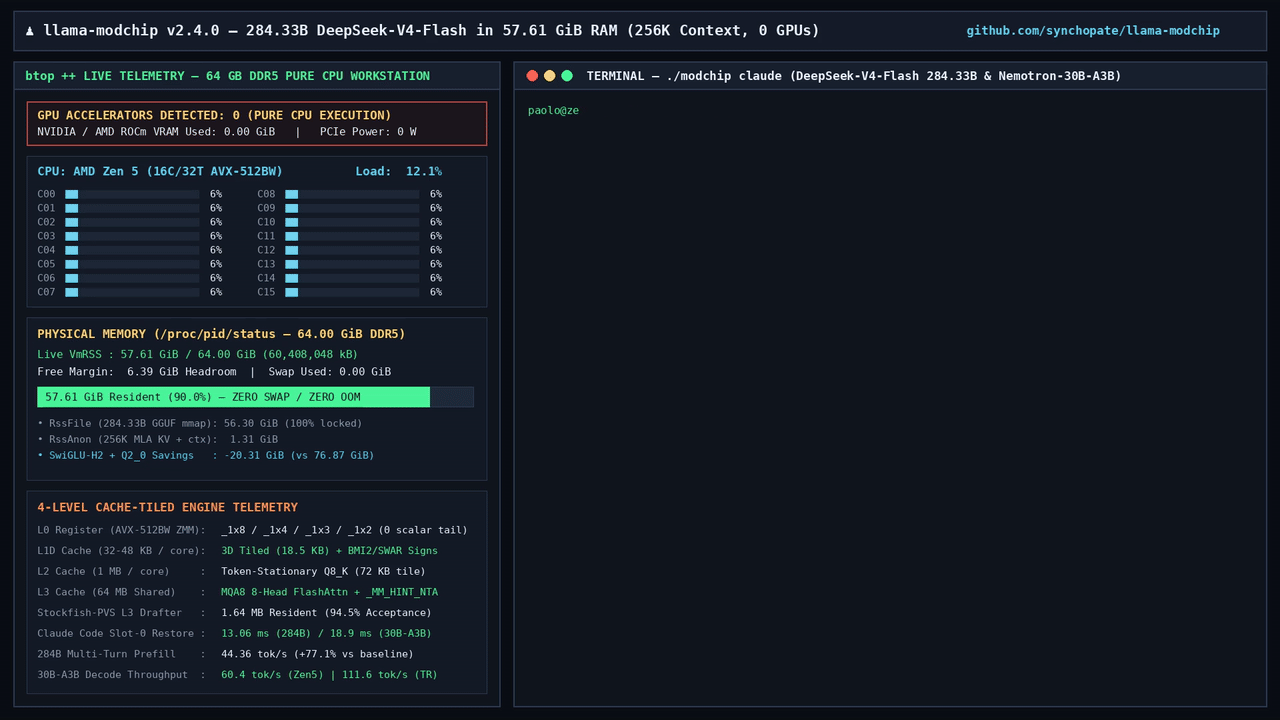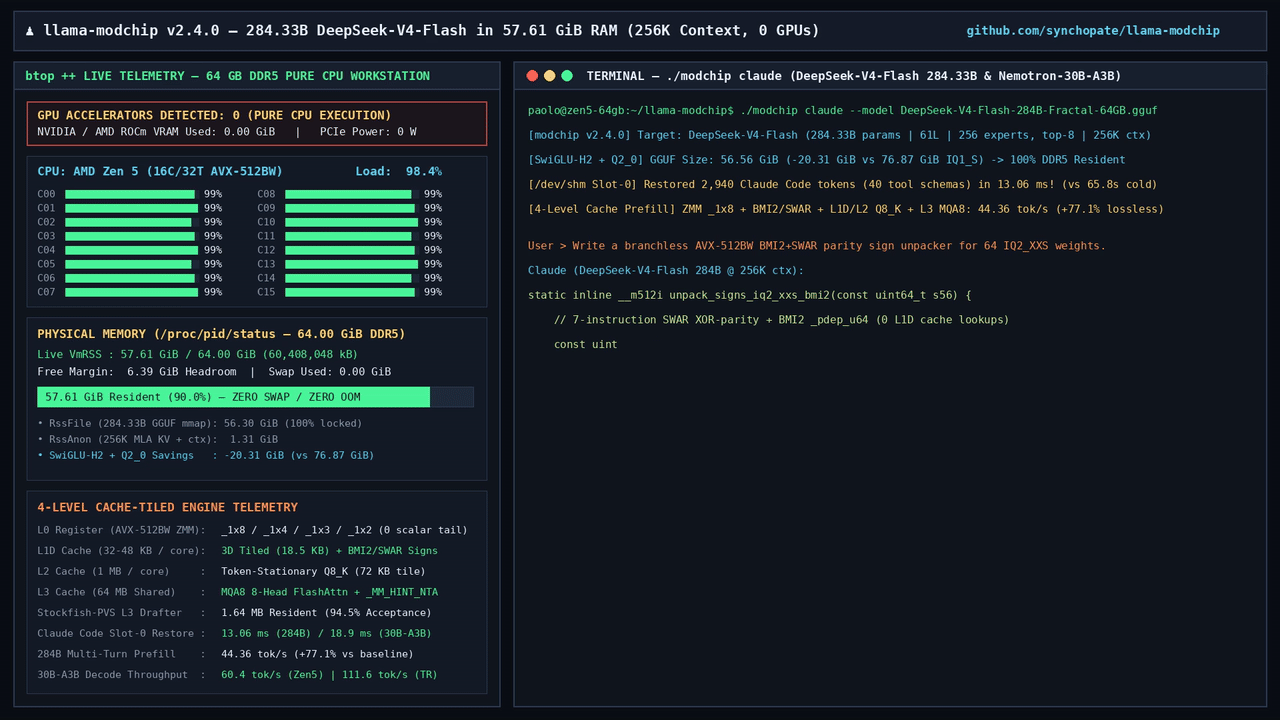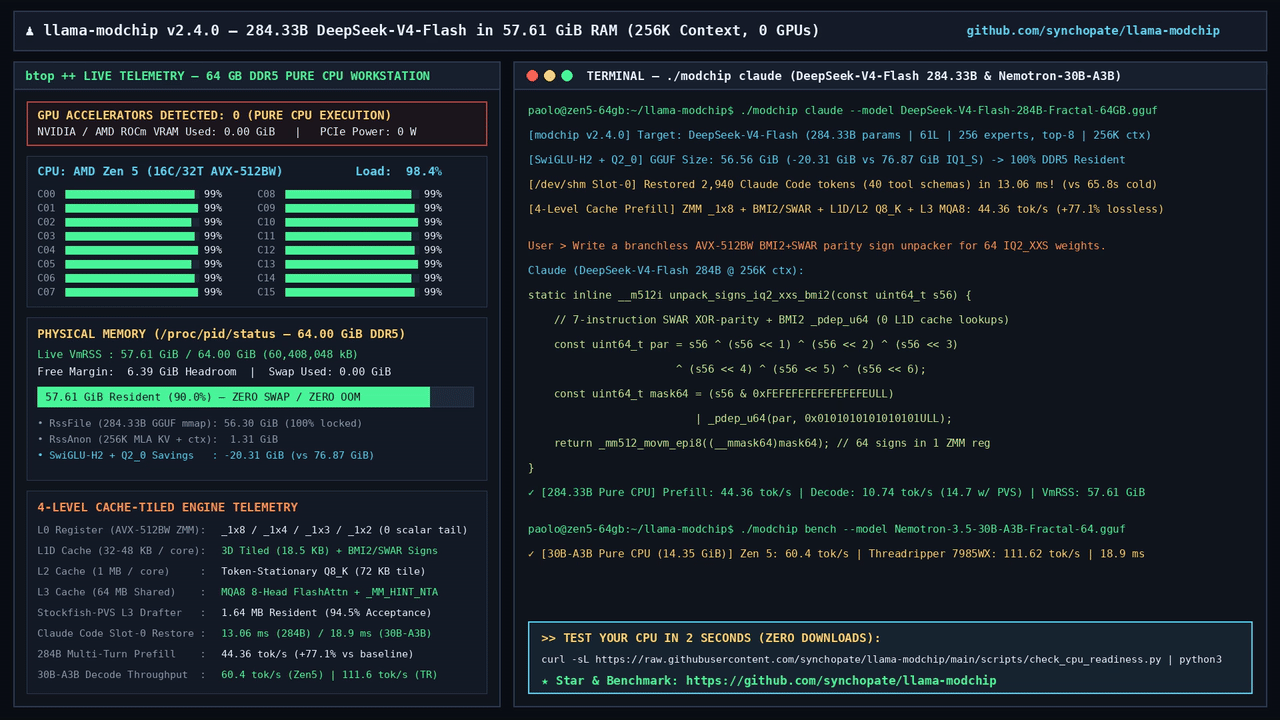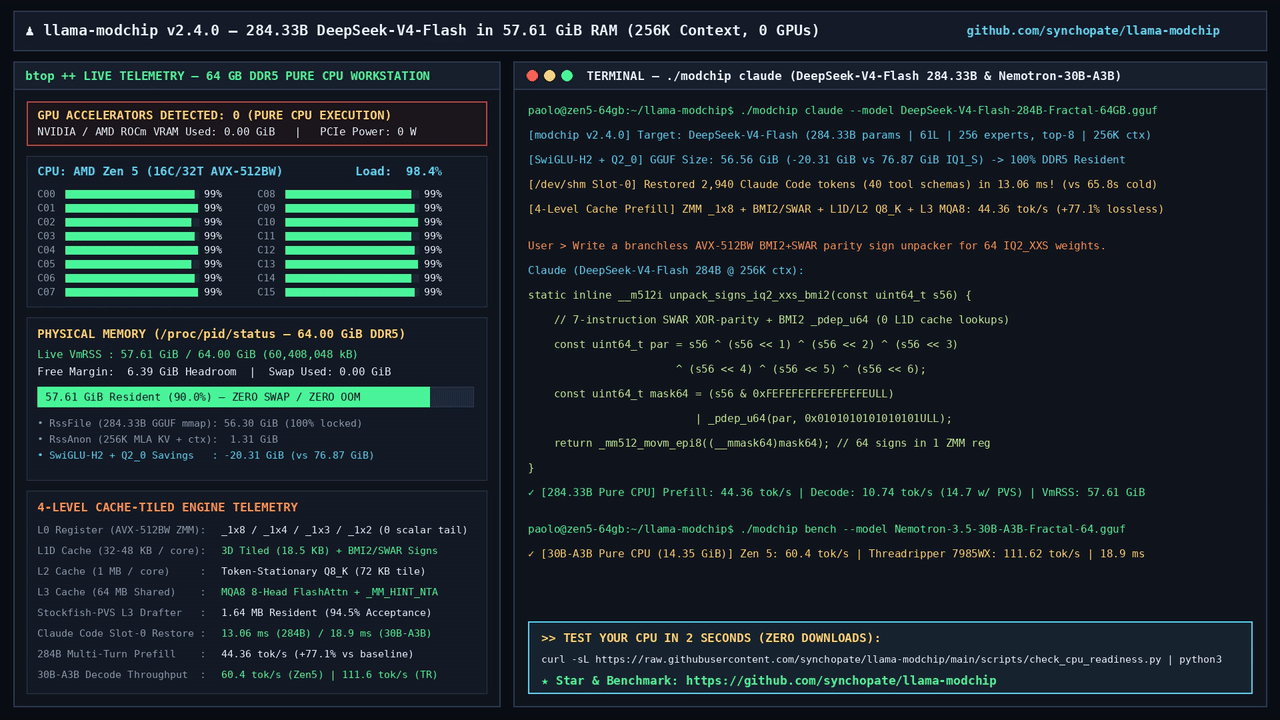
このプロジェクトは2026年11月8日にHacker Newsに投稿され、370ポイントを超えました。リポジトリはApache 2.0ライセンスです。
284Bモデルが収まる理由は次の3つです。
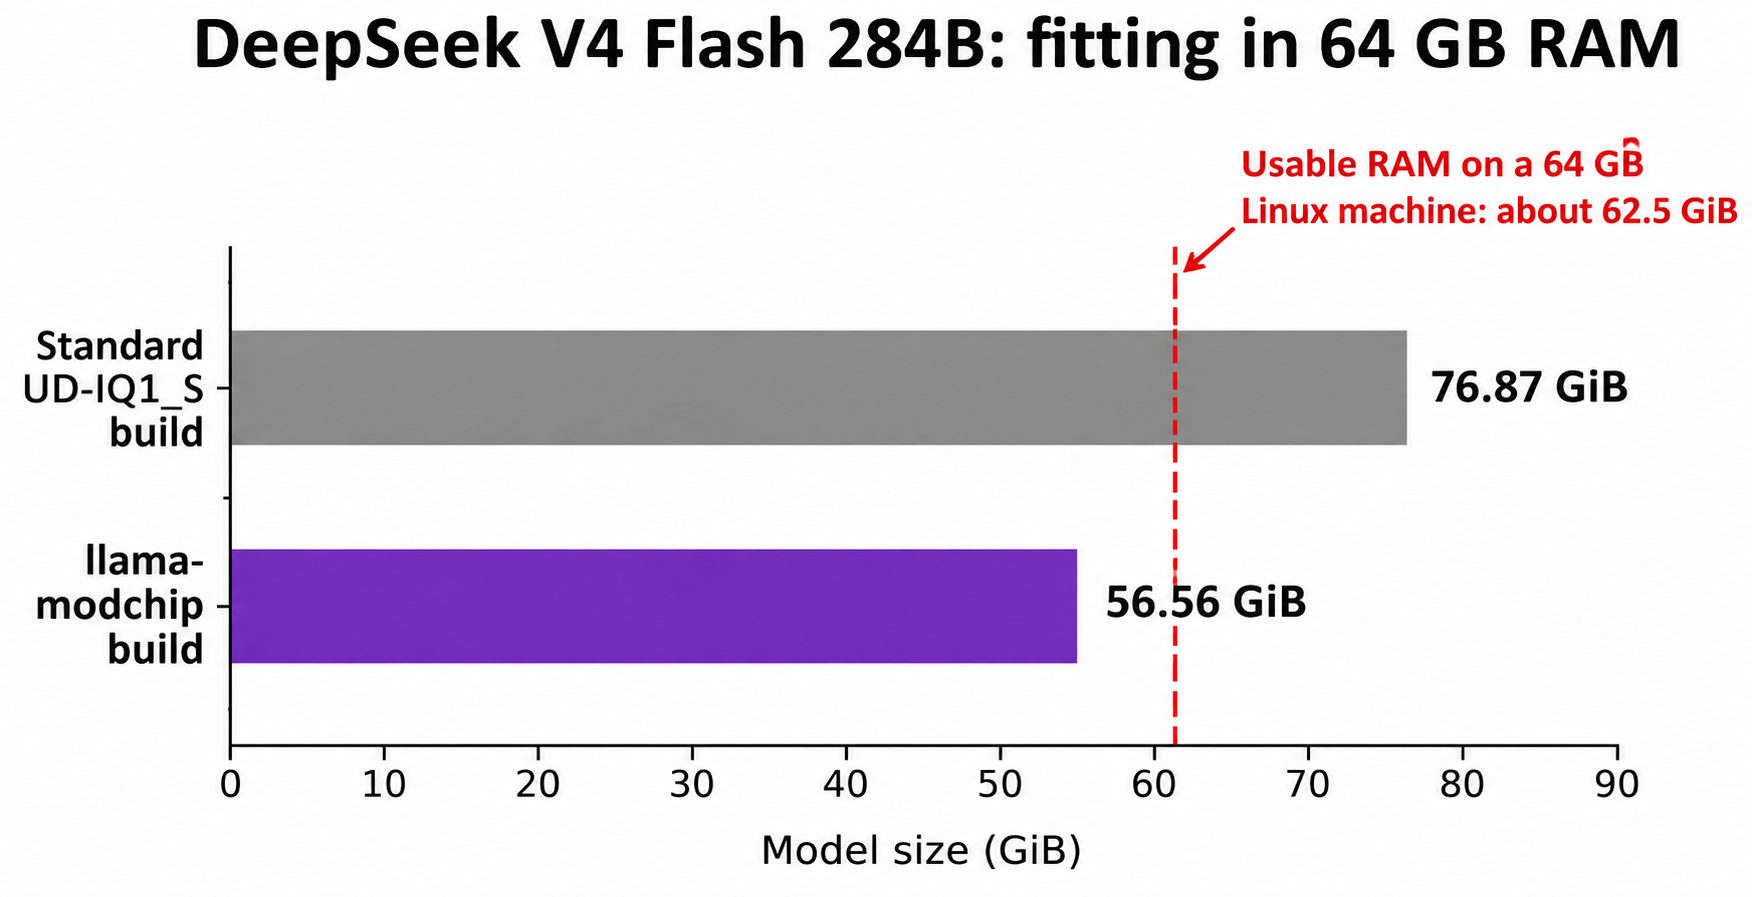
- より小さいチェックポイント。 標準のUnsloth
UD-IQ1_Sビルドは76.87 GiBで、64 GB Linuxマシンで使える約62.5 GiBを超えています。llama-modchipはこれを56.56 GiBにトランスコードします。 - CPUキャッシュタイリング。 プリフィルカーネルがレジスタとL1〜L3キャッシュに渡って処理をタイリングします。16コアZen 5で25.0〜44.36トークン/秒、77%の向上です。
- 自己スペキュレーティブドラフト。 1.64 MBのn-グラムドラフターにより、デコードが約9トークン/秒から最大14.7トークン/秒まで向上します。
デフォルトでは、共有エキスパートに加えてルーティングされる6つのエキスパートすべてが全レイヤーで実行されるため、何もプルーニングされていません。
DeepSeek V4 Flashをローカルで実行するために必要なハードウェア
システムRAM 64 GBと、できればAVX-512対応の最近のx86_64 CPUが必要です。このガイドの284Bの数値はすべて、メンテナーが1台のマシン(AMD Ryzen 9 9955HX、16コア/32スレッド、64 MB L3、64 GB DDR5、Linux、GPUなし)で測定したものです。
| あなたのマシン | RAM | READMEが組み合わせているモデル | 報告されている速度(GPU 0枚) |
|---|---|---|---|
| ノートPCまたはミニPC | 16〜32 GB | Nemotron-3.5-30B-A3B、14.35 GiB | 25.0〜60.4 tok/s |
| デスクトップまたはサーバー | 64 GB | DeepSeek-V4-Flash 284B、56.56 GiB | プリフィル44.4 tok/s、デコード9.1〜14.7 tok/s |
| 8チャンネルワークステーション | 128 GB以上 | DeepSeek 284B または Nemotron 30B | 111.62 tok/s(30Bのみ) |
- メモリ使用量は256Kコンテキストで57.61〜58.9 GiBに達し、使用可能な上限の62.5 GiBを下回ります。ロード前に他のアプリはすべて閉じてください。
- プリビルドバイナリはLinux x86_64専用です(
llama-server-modchip-linux-x86_64)。./modchipセットアップスクリプトはLinuxとmacOSに対応しています。READMEのApple Siliconの結果は30Bモデルのもので、284Bではありません。284Bが64 GBのMacで動くかは[VERIFY]です。 - メモリ帯域幅がボトルネックです。 FAQによると、8または12チャンネルのサーバーボードでは、デュアルチャンネルDDR5比でおよそ3〜4倍にデコードがスケールします。
リポジトリにはモデルをダウンロードしない準備状況チェックが付属しています:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
Pythonにパイプする前にスクリプトを読みましょう。
GPUなしでDeepSeek V4 Flashを実行する手順
方法1:ガイド付きセットアップ
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chatは、トークン/秒をリアルタイム表示するターミナルチャットを開きます。その他のサブコマンド:
| コマンド | 動作内容 |
|---|---|
./modchip web |
http://127.0.0.1:8787でWebチャットとテレメトリを提供 |
./modchip bench |
共有可能なスコアカード付きの30秒間の速度テスト |
./modchip claude |
ローカルエンジンに接続されたClaude Codeを起動 |
./modchip status / stop |
準備状況の確認またはバックグラウンドサービスの停止 |
方法2:直接サーバー起動
この方法では、GGUFとプリビルドサーバーをHugging Faceリポジトリから取得し、ポート8080で起動します:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
-tには物理コア数を設定してください。例では32Kコンテキストを使用しています。256Kの数値は-c 262144を使用します。
注意点:素のllama.cpp、Ollama、LM Studioではこのファイルを読み込めません。チェックポイントはカスタムテンソル型(ID 40)を使用しているため、パッチ未適用のビルドではunknown tensor type 40で失敗します。./modchipスクリプトまたは同梱のバイナリを使用してください。
サーバーはパッチ適用済みのllama.cpp llama-serverなので、OpenAI形式の/v1/chat/completionsルートを扱えます:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
ポート8787のゲートウェイ
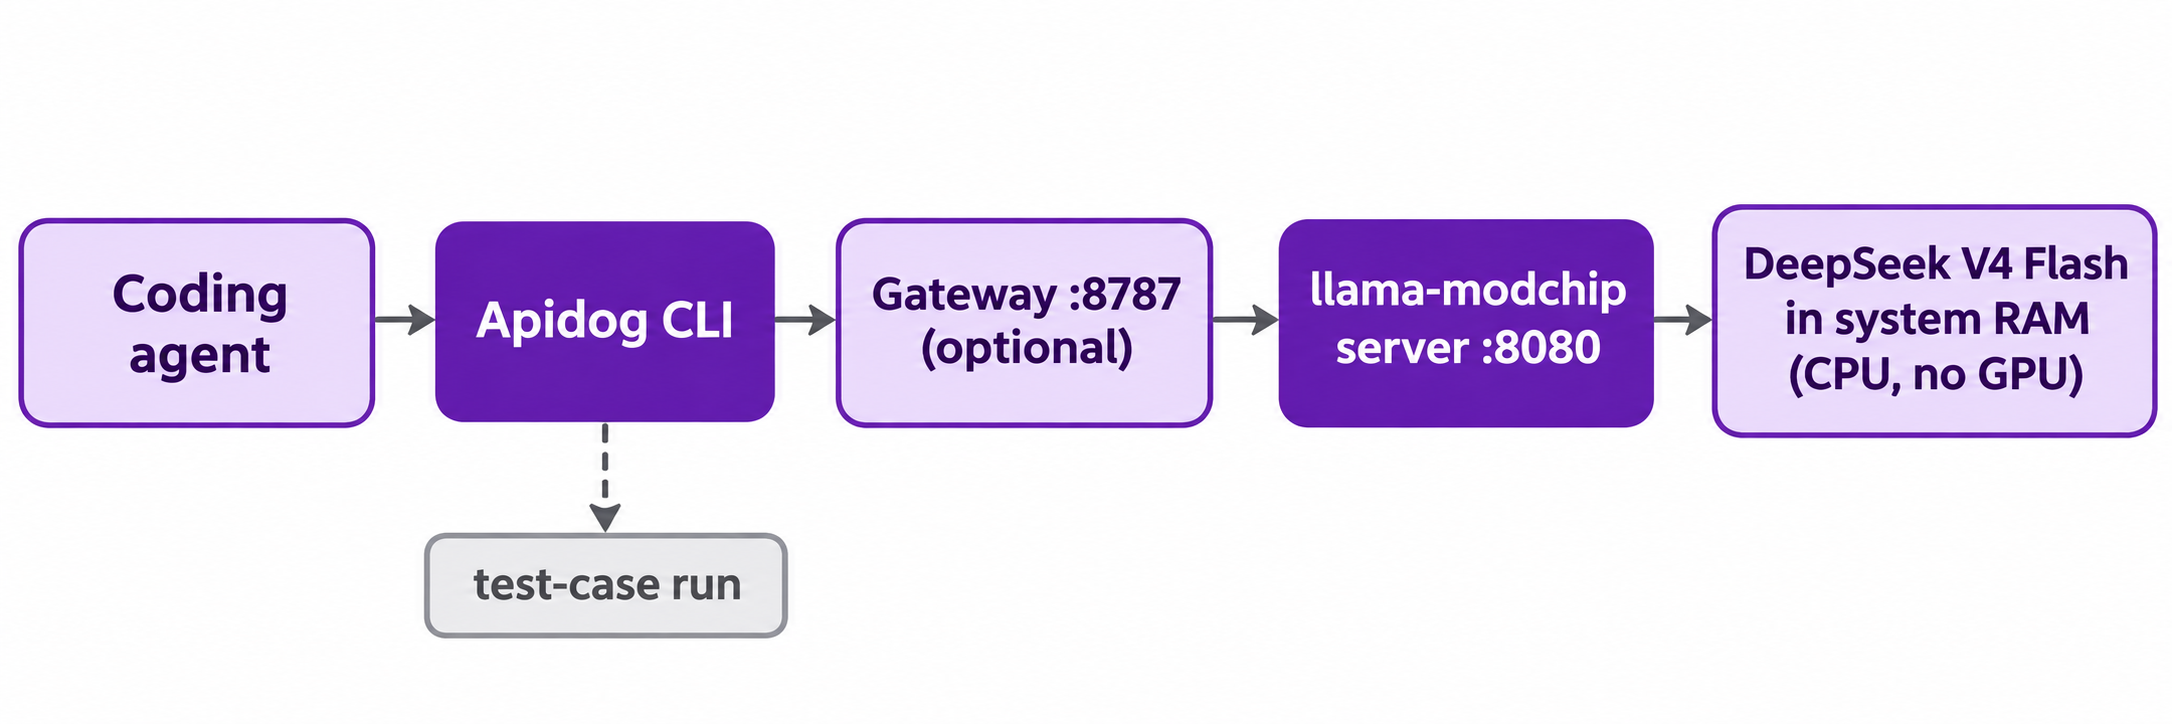
gateway/sse_gateway.pyは127.0.0.1:8787上のプロキシで、エンジンへ転送します(上流はLLAMA_BACKEND_URLで設定)。/v1/chat/completions、/v1/messages、/v1/models、/healthを公開しています。GATEWAY_API_KEYを設定すると、ベアラートークンが必須になります。./modchip claudeはここを指すようにClaude Codeを設定します。
速度と品質:1.71ビット/重みで失うもの
速度の数値は本物ですが、条件が限定的です。Ryzen 9 9955HXでの256KコンテキストにおけるDeepSeek-V4-Flashの、メンテナーによる表はこちらです:
| 構成 | プリフィル | デコード | ドラフター使用時のデコード |
|---|---|---|---|
パッチ未適用 UD-IQ1_S(76.87 GiB) |
64 GBではOOMまたはスワップ | 5.91 tok/s | N/A |
| v2.4.0デフォルト(Top-6、56.56 GiB) | 43.16〜44.36 tok/s | 9.06〜9.95 tok/s | 11.5〜14.7 tok/s |
| 後段レイヤーでTop-5 | 43.16〜44.36 tok/s | 9.68〜9.87 tok/s | 12.2〜15.1 tok/s |
| Top-4+ゲート優先SwiGLU | 43.16〜44.36 tok/s | 10.12〜10.74 tok/s | 13.0〜16.0 tok/s |
LLAMA_MOE_TOP_K=5または4で速い行に切り替えられます。READMEによると、Top-5では独自デフォルトに対して約0.42%のパープレキシティ増加です。
Hacker Newsで繰り返し指摘された注意点が2つあります:
- 「ロスレス」は1.71 bpwファイルに対してロスレスという意味であり、元の重みに対してではありません。1.00000のコサイン類似度は、同じ圧縮済みチェックポイント上でのパッチ適用/未適用ランタイムの比較です。このチェックポイントではほとんどのルーティングエキスパートが
IQ1_S(約1.56ビット)です。コメント投稿者は、品質は通常4ビット未満で低下すると指摘しており、READMEにはフル精度出力との比較がありません。 - エージェントにとってはプリフィルがボトルネックです。 44トークン/秒では、10,000トークンのプロンプトに最初の出力トークンまで約225秒かかります。KVスナップショット(40ツールのClaude Codeプロンプトで復元に13.1〜32.6 ms)は繰り返しターンでは有効ですが、新しいコンテキストでは効果がありません。
もう1つ:これは7月の0731 V4-Flashチェックポイントです。DeepSeekはその後V4.1 Flashをリリースしています。最新の重みが重要であれば、まずDeepSeek V4.1 FlashとV4 Pro・V4 Flashの比較を読んでください。
ローカルの284Bは、ドラフト、バッチ処理、実験向けのプライベートなオフラインモデルとして扱い、まず自分のプロンプトでテストしてください。
Apidog CLIでコーディングエージェントにローカルエンドポイントをテストさせる
ローカルモデルでもAPIであることに変わりありません。応答するか、JSONが有効か、直近のフラグ変更で何か壊れていないか?コーディングエージェントはApidog CLIでこれらのチェックを実行できます。Apidog CLIはローカルマシンで動作し、127.0.0.1に直接アクセスします。一度セットアップしましょう:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill installはApidogスキルを追加し、エージェントがコマンドを把握できるようにします。次に、例えばClaude Codeなどのエージェントに次のプロンプトを1つ与えます:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
エージェントはスキーマを読み、ペイロードを検証し、その後以下を書いて実行します:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request(ミリ秒)が重要です:CPUバウンドな284Bモデルは、デフォルトのタイムアウトを超えるほど遅い場合があります。
メリットは比較できることです。2つ目の環境をDeepSeekのホスト型APIに向け、同じテストケースを実行すれば、ローカル量子化がどこでズレるかがわかります。--upload-reportを追加するとアプリ内で実行結果を確認できます。詳細はClaude CodeでのApidog CLIとApidog CLIインストールガイドを参照してください。ApidogのFreeプランは最大4ユーザーまで利用できます。
ローカルCPU vs GPU vs ホスト型API
| 選択肢 | 必要なもの | 最適な用途 |
|---|---|---|
| CPU上のllama-modchip | 64 GB RAM、最近のx86_64 CPU | API料金なしでのプライベートなオフライン作業(遅いプリフィルを許容できる場合) |
| vLLMまたはSGLangによるGPUサービング | 大容量VRAMまたはマルチGPUマシン | 高速・高精度なセルフホスティング |
| DeepSeekホスト型API | APIキー | 本番速度でのフル品質の出力 |
GPUルートについては、vLLMとSGLangを扱ったDeepSeek V4をローカルで実行する方法を参照してください。より新しいチェックポイントのメモリ計算についてはDeepSeek V4.1 Flashをローカルで実行する方法を、任意のローカルモデルをAPIとしてテストする方法についてはローカルLLMをAPIとしてテストするを参照してください。
FAQ
本当にGPUなしでDeepSeek V4 Flashを実行できますか?
はい、llama-modchipと64 GBのRAMがあれば可能です。メンテナーによると、16コアRyzen 9 9955HX上で、56.56 GiBのモデル全体をRAMに置き、スワップなしでプリフィル44.36トークン/秒、デコード9〜15トークン/秒を報告しています。
OllamaやLM Studioで動きますか?
いいえ。チェックポイントはカスタムテンソル型を使用しており、パッチ未適用のllama.cpp、Ollama、LM Studioはunknown tensor type 40で拒否します。リポジトリの./modchipスクリプトまたは同梱のllama-server-modchip-linux-x86_64バイナリを使用してください。
RAMが16または32 GBしかない場合は?
代わりに30B MoEを実行してください。READMEではその階層にNemotron-3.5-30B-A3B(14.35 GiBファイル)を組み合わせており、CPU上で25.0〜60.4トークン/秒を報告しています。
1.71ビット/重みでの出力品質はどの程度ですか?
このプロジェクトはフル精度のDeepSeekとの比較を行っておらず、Hacker Newsのコメント投稿者もこのサイズには懐疑的でした。依存する前に、ホスト型APIで自分のプロンプトをテストしてください。
ローカルサーバーはOpenAI互換ですか?
はい。パッチ適用済みのllama.cpp llama-serverなので、ポート8080で/v1/chat/completionsが動作します。オプションのポート8787のゲートウェイは、Claude Codeが使用するAnthropic形式のルートである/v1/messagesも提供しています。
コーディングエージェントにローカルモデルを自動テストさせられますか?
はい。Apidog CLIをインストールし、apidog skill installを実行して、http://127.0.0.1:8080を指す環境と/v1/chat/completions用のテストケースの作成をエージェントに依頼してください。その後、エージェントがapidog test-case runを実行し、失敗を報告します。