
QwenCloudの従量課金(トークン単価)APIにおけるQwen4-Maxの価格は、シンガポールリージョンで入力100万トークンあたり1.50ドル、出力100万トークンあたり4.50ドル、キャッシュ済み入力は100万トークンあたり0.075ドルです。Thinkingモードと非Thinkingモードの料金は同じで、入力長による段階的な価格設定もありません。コーディングツールに定額の月額料金を支払いたい場合は、同じモデルがToken Planで月額6ドルから利用できます。
以下では、料金表、実際のタスクコスト、キャッシュによる節約、Token Planと従量課金の比較、そして競合モデルの価格を紹介します。このモデルが初めての方は、まずQwen4-Maxとは何かをご覧ください。
Qwen4-Max APIの100万トークンあたりの価格
Qwen4-Maxは100万トークン単位で課金され、入力、出力、キャッシュ書き込み、キャッシュ読み取りにそれぞれ異なるレートが設定されています。出力には、推論(「thinking」)トークンと回答の両方が含まれます。Alibabaはシンガポール(インターナショナル)の料金列と、それより安い北京/グローバルの料金列を公開しています。
| 課金項目(100万トークンあたり) | シンガポール(インターナショナル) | 北京/グローバル |
|---|---|---|
| 入力 | $1.50 | $1.413 |
| 出力(thinking + 回答) | $4.50 | $4.24 |
| キャッシュ書き込み(TTL 5分) | $1.875 | $1.767 |
| キャッシュ書き込み(TTL 1時間) | $3.00 | $2.827 |
| キャッシュ読み取り(明示的・暗黙的ヒット) | $0.075 | $0.071 |
出典:QwenCloudの料金ドキュメントおよびQwen4-Maxのモデルページ(いずれも2026年11月16日時点で確認)。ドキュメントによると、グローバルデプロイはフランクフルト、香港、東京、米国(バージニア)に展開されています。
請求額を左右するいくつかのルールがあります:
- Thinkingトークンは出力として課金される。
enable_thinkingを有効にすると、すべての推論トークンが100万トークンあたり4.50ドルで課金されます。 - 長文コンテキストの追加料金はない。 90万トークンのリクエストも、9Kトークンのリクエストとトークン単価は同じです。
- キャッシュ読み取りは入力価格の5%。 0.075ドルは1.50ドルに対して95%の割引で、繰り返し使われるプレフィックスに適用されます。
- 制限: コンテキストは100万トークン、入力は最大991Kトークン(thinking使用時は983K)、出力は最大393Kトークン、毎分500万トークンまで。
モデルIDはqwen4-maxです。まだAPIを呼び出したことがない方は、Qwen4-Max APIガイドでAPIキー、ベースURL、最初のリクエスト方法を解説しています。
実際のQwen4-Maxタスクのコスト
トークン単価だけでは実感しづらいものです。Alibabaはローンチ記事で具体的な数字を1つ示しています。同社のWork360エージェントベンチマークでは、タスクあたりの平均コストがQwen3.8-Maxの4.43ドルからQwen4-Maxでは1.67ドルに低下し、62%削減されました。またAlibabaは、Work360においてQwen4-MaxがXhighの努力レベルで約24%、Highで約35%少ないトークンを使用したと報告しています。これらはベンダー公表の数値なので、実際のワークロードの見積もりではなく、傾向として捉えるべきです。
簡単な計算で自分のコストを見積もることもできます。シンガポールの表示価格による計算例を3つ紹介します:
- 短いチャットの呼び出し。 入力2,000トークン、出力500トークンの場合:2,000 × $1.50/1M + 500 × $4.50/1M = $0.003 + $0.00225 = $0.0053。1,000回の呼び出しで約5.25ドルです。
- thinkingを有効にした同じ呼び出し。 500トークンの回答の前に、モデルが6,000トークンの推論を行うとします。出力は6,500トークンになるため、呼び出しのコストは $0.003 + $0.02925 = $0.032で、約6倍になります。
- 長文ドキュメントへの質問。 入力30万トークン、出力2,000トークンの場合:$0.45 + $0.009 = $0.459(キャッシュなし)。30万トークンのドキュメントがキャッシュヒットすれば約0.032ドルです。
例2は意外に思われるかもしれません。回答が短くても、thinkingが請求額を支配することがあるのです。品質あたりのコストの詳細な数字については、Qwen4-Maxベンチマーク解説をご覧ください。
キャッシュレートがQwen4-Maxの請求額をどう変えるか
コンテキストキャッシュこそ、Qwen4-Maxの価格が大きく動くところです。QwenCloudは従量課金API上のqwen4-maxに2つのモードを提供しており、Chat Completions、DashScope、Anthropic互換APIではリクエストごとにどちらか一方のみ使用できます。
| モード | 仕組み | 価格 | ヒットは保証される? |
|---|---|---|---|
| 暗黙的キャッシュ | 自動で無効化不可。1,024トークン以上の共通プレフィックスを再利用 | ヒット時100万トークンあたり$0.075 | いいえ。有効性は不定 |
| 明示的キャッシュ | cache_controlでブレークポイントを指定 |
書き込み$1.875(5分)または$3(1時間)、読み取り$0.075 | はい。キャッシュが有効な間 |
コンテキストキャッシュのドキュメントによると、明示的な5分キャッシュはヒットのたびにタイマーがリセットされるため、頻繁に動作するエージェントループではキャッシュが温まり続けます。
次に、エージェントセッションを例に取ります。20万トークンのシステムプロンプトにツール定義とリポジトリのコンテキストを加えたものを50ターンで再利用し、各ターンで入力2Kトークン、出力3Kトークンとします。
- キャッシュヒットなし: 10.1M入力トークン × $1.50 + 150K出力トークン × $4.50 = $15.83。
- ターン2以降で暗黙的キャッシュヒット: 最初の202Kトークンは通常価格($0.30)、9.8Mトークンはキャッシュ価格$0.075($0.74)、98Kトークンは新規($0.15)、出力($0.68)= 合計$1.86。
- 明示的な5分キャッシュ: 最初の通常価格のプレフィックスの代わりに$0.375の書き込み、同じ読み取りと出力 = 約$1.94。しかもヒットは保証されます。
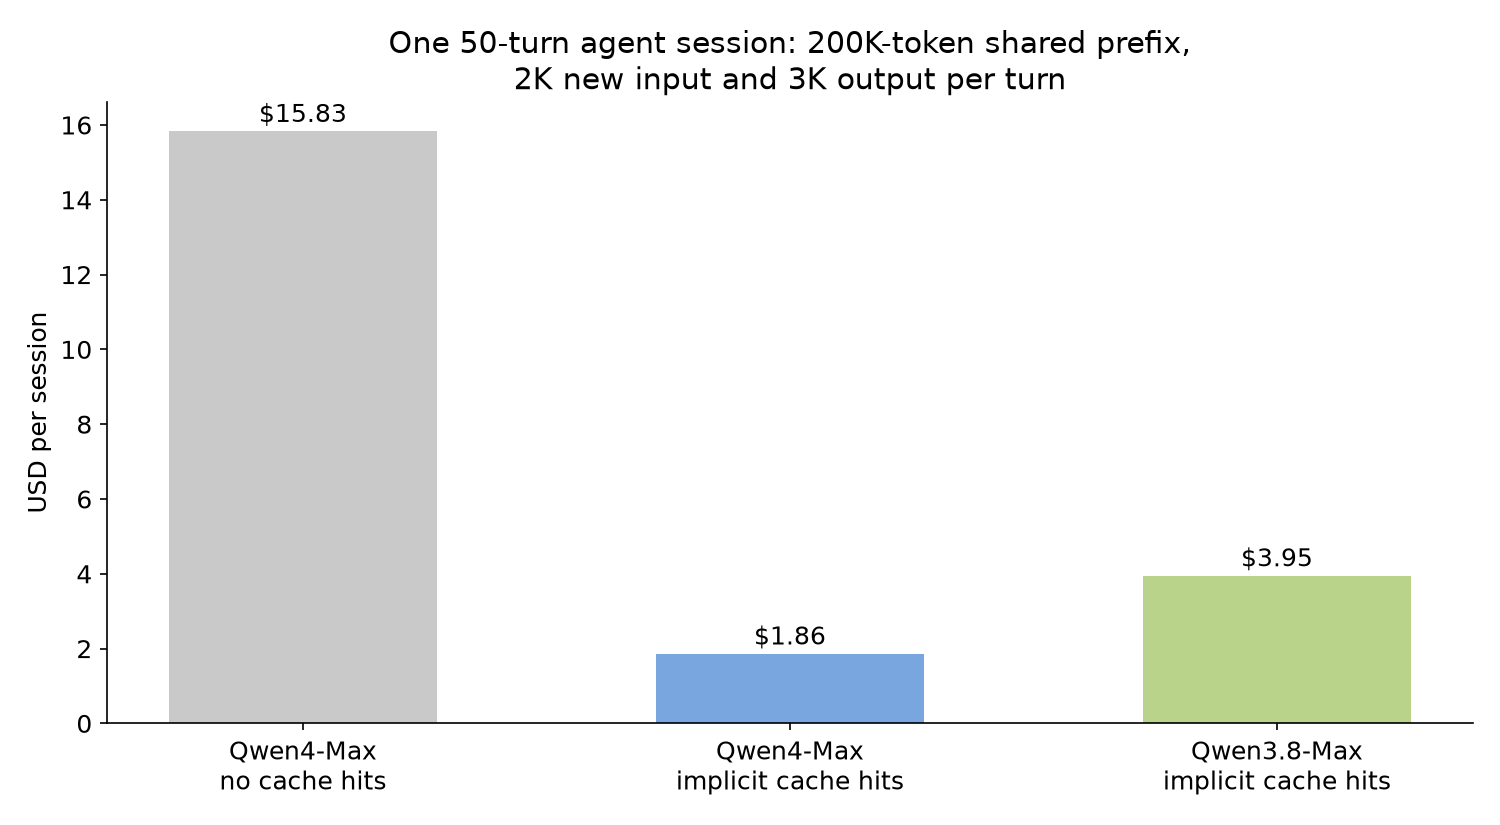
同じセッションをQwen3.8-Max(入力$2、暗黙的キャッシュ$0.25、出力$6のレート)で実行すると、$3.95になります。Alibabaが主張する「キャッシュ済み入力での最大の値下げ」がここに現れています。Qwen3.8-Maxの暗黙的ヒットは$0.25ですが、Qwen4-Maxは$0.075です。
確実なヒットが必要な場合は明示的キャッシュを、それ以外は暗黙的キャッシュを使いましょう。結果はusage.prompt_tokens_details.cached_tokensとcache_creation_input_tokensで確認できます。ベンダー間のキャッシュ経済性を比較したい場合は、Claude Opus 5.5のプロンプトキャッシュのコスト計算で同じ手法を使っています。
Qwen4-Maxにバッチ割引はあるか
ありますが、1つのリージョン限定です。QwenCloudのBatch APIは通常、入力と出力をリアルタイム価格の50%で課金します。qwen4-maxの場合、バッチのドキュメントでは中国北部2(北京)のみに記載されており、Batch Fileの価格は100万トークンあたり入力$0.707、出力$2.12です。北京のBatch Chatは$1.413/$4.24と記載されています。
バッチはコンテキストキャッシュに対応しておらず、他の割引との併用もできず、無料枠の対象外です。キャッシュヒット率が高い場合は、リアルタイムAPIの方がバッチより安くなることがあります。
Qwen4-Maxの従量課金とToken Planの比較
Token Planは、Claude Code、Cursor、Qwen Code、Codex、Qoderといったコーディング・エージェントツール向けのQwenCloudの月額サブスクリプションです。トークンではなくクレジットで課金され、専用のsk-sp-APIキーを使用します。qwen4-maxは対応モデルリストに含まれています。個人プランは、2026年11月16日時点のToken Planのドキュメントによると以下の通りです:
| プラン | 月額料金 | 月間クレジット | 同時実行エージェント数 |
|---|---|---|---|
| Lite | $6(期間限定の新規ユーザー価格$3) | 20,000 | 1〜2 |
| Essential | $10(期間限定の新規ユーザー価格$5) | 45,000 | 2〜3 |
| Standard | $18 | 80,000 | 3〜4 |
| Pro | $43 | 200,000 | 6〜8 |
追加のクレジットパックは、20,000クレジットで15ドルです(同時に最大5個まで)。クレジットが尽きると呼び出しはブロックされ、従量課金へのフォールバックはありません。
選び方:
- Token Planを選ぶべきなのは、コーディングエージェント経由で1人が毎日モデルを使い、固定の月額費用を望む場合です。
- 従量課金を選ぶべきなのは、製品、バックエンドジョブ、バッチ、ファインチューニング、または変動の激しいトラフィックの場合です。使った分だけ支払い、毎分500万トークン(TPM)の制限も維持できます。
Qwen4-Maxリクエストあたりのクレジット消費は固定のトークン換算ではないため、実際に1日使ってみてコンソールで確認してください。クレジットがどのくらい持つかを含め、プランの詳細はQwen4-Max Token Plan:その費用と価値で解説しています。
Qwen4-MaxとQwen3.8-Maxおよび競合フラグシップモデルの価格比較
Qwen4-Maxは、前世代モデルと比べて入力、出力、キャッシュ読み取り、5分キャッシュ書き込みのすべてで安くなっています(Qwen3.8-Maxのキャッシュ書き込みは$2.50の一括価格。Qwen4-Maxの1時間書き込みは$3)。以下は、標準表示価格における他のフラグシップモデルとの比較です。いずれも2026年11月16日時点で各ベンダーのページから確認したものです。
| モデル | 入力 / 1M | キャッシュ済み入力 / 1M | 出力 / 1M |
|---|---|---|---|
| Qwen4-Max(シンガポール) | $1.50 | $0.075 | $4.50 |
| Qwen3.8-Max | $2.00 | $0.25(暗黙的)、$0.17(明示的読み取り) | $6.00 |
| DeepSeek V4 Pro(ピーク時/オフピーク時) | $1.32 / $0.66 | $0.044 / $0.022 | $3.96 / $1.98 |
| OpenAI gpt-5.6-sol | $4.00 | $0.40 | $20.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
出典:Qwen3.8-Maxモデルページ、DeepSeekの料金、OpenAI APIの料金、Claudeの料金。
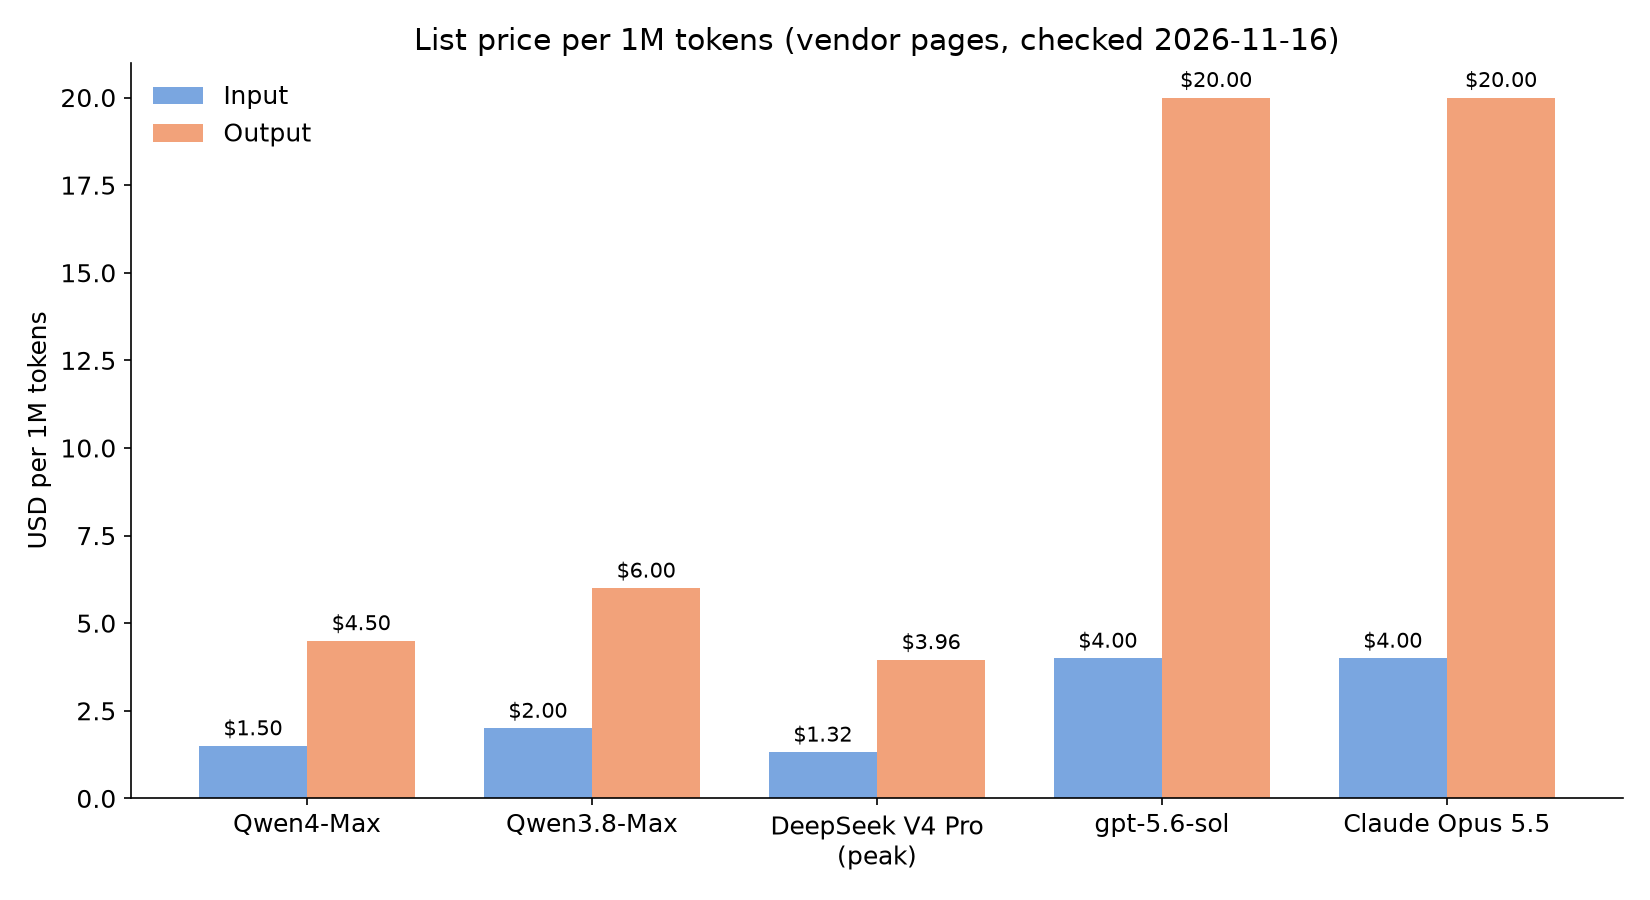
エージェント用途では出力が最大のコスト項目になることが多く、Qwen4-Maxの出力$4.50は、gpt-5.6-solとClaude Opus 5.5の$20を大きく下回っています。DeepSeek V4 Proはトークン単価でより安く、特にオフピーク時がそうです。タスク完了あたりのコストは、各モデルがワークロードにどれだけのトークンを使うかによって変わります。Qwen3.8-Max側の詳細については、Qwen 3.8料金ガイドとQwen4-Max vs Qwen 3.8比較をご覧ください。
Apidog CLIでコーディングエージェントにQwen4-Maxのコストを測らせる
信頼できるコスト見積もりは、自分のプロンプトで測定したusageだけです。コーディングエージェント(Claude Code、Codex、Cursorなど)にApidog CLIを使ってその検証を構築・実行させましょう。セットアップは一度だけです:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
その後、エージェントに次のプロンプトを1つ与えます:
In Apidog project <projectId>, create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable for my DashScope API key. Add a POST /chat/completions endpoint for model
qwen4-max and two test cases: one with enable_thinking true, one false. Assert
status 200, a non-empty choices array and a usage object. Run both and report
prompt_tokens, completion_tokens and cached_tokens side by side.
エージェントは、何かを書き込む前に各ペイロードの構造をCLIスキーマと照合し、その後ケースを実行します:
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-thinking.json
apidog test-case create --project <projectId> --file case-thinking.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
2つのcompletion_tokensの数値を比較し、100万トークンあたり$4.50を掛ければ、それが自分のプロンプトにおけるthinkingの追加コストです。apidog runコマンドに--upload-reportを付けるとApidogアプリで実行結果を確認でき、CI/CDでのApidog CLI実行で示されているように、同じコマンドを-r junit付きでCIに組み込むこともできます。CLIが初めての方は、Apidog CLIインストールガイドとCodexでのApidog CLIを使えば数分で実行を開始できます。ApidogのFreeプランは最大4ユーザーまで利用可能です。
FAQ
Qwen4-Maxの100万トークンあたりのコストはいくらですか? シンガポールリージョンでは入力$1.50、出力$4.50で、キャッシュ読み取りは$0.075です。北京/グローバルはやや安く、$1.413と$4.24です。
Qwen4-Maxではthinkingモードは高くつきますか? レート自体は同じですが、推論トークンは100万トークンあたり$4.50の出力として課金されるため、長い推論は呼び出しのコストを増大させます。
Qwen4-MaxはQwen3.8-Maxより安いですか? はい。入力は$2から$1.50に、出力は$6から$4.50に、暗黙的キャッシュヒットは100万トークンあたり$0.25から$0.075に下がりました。Alibabaによると、Work360のタスクあたりコストも$4.43から$1.67に低下しています。
Qwen4-Maxを無料で使えますか? QwenCloudは支払い情報の登録後、シンガポールリージョンで新モデルに無料枠(通常は90日間有効な100万トークン)を提供しています。コンソールのFree Tierページでqwen4-maxを確認し、$0で使えるすべての方法についてはQwen4-Max無料アクセスガイドをご覧ください。
Qwen4-Maxはバッチ価格に対応していますか? 北京リージョン限定です。Batch Fileは100万トークンあたり入力$0.707、出力$2.12で、コンテキストキャッシュは利用できません。
Qwen4-MaxにはToken Planと従量課金のどちらを選ぶべきですか? Token Planは、コーディングツールを毎日使う1人には月額$6から適しています。従量課金は、アプリ、バックエンドジョブ、バッチ処理に向いています。