
Qwen4-Maxのベンチマーク結果を一文でまとめると、こうなります。Alibabaのチャートでは、Qwen4-Maxは両モデルが掲載されている15項目すべてでQwen3.8-Maxを上回り、16項目中4項目で全体1位を獲得しています。ただし、その数値の大部分はAlibaba自身による実行結果です。Work360では52.69対47.74、タスクあたりの平均コストは$4.43から$1.67に低下しています。
ベンチマークの有用性は「誰がどのように実行したか」という問いに答えられるかどうかで決まります。このガイドでは、Alibabaが2026年11月16日に公開したすべてのスコアを取り上げ、自己申告とサードパーティのものに分類し、最後にQwen4-Max APIで独自の検証を行う方法を紹介します。基本情報については、まずQwen4-Maxとはとアクセス方法をご覧ください。
Qwen4-Maxのベンチマークスコア一覧
Alibabaの発表記事では、16のベンチマークでQwen4-MaxをQwen3.8-Max-0902、Opus 5.5、GPT-6.1 Sol、GPT-6 Astra、Kimi K3.1と比較しています。
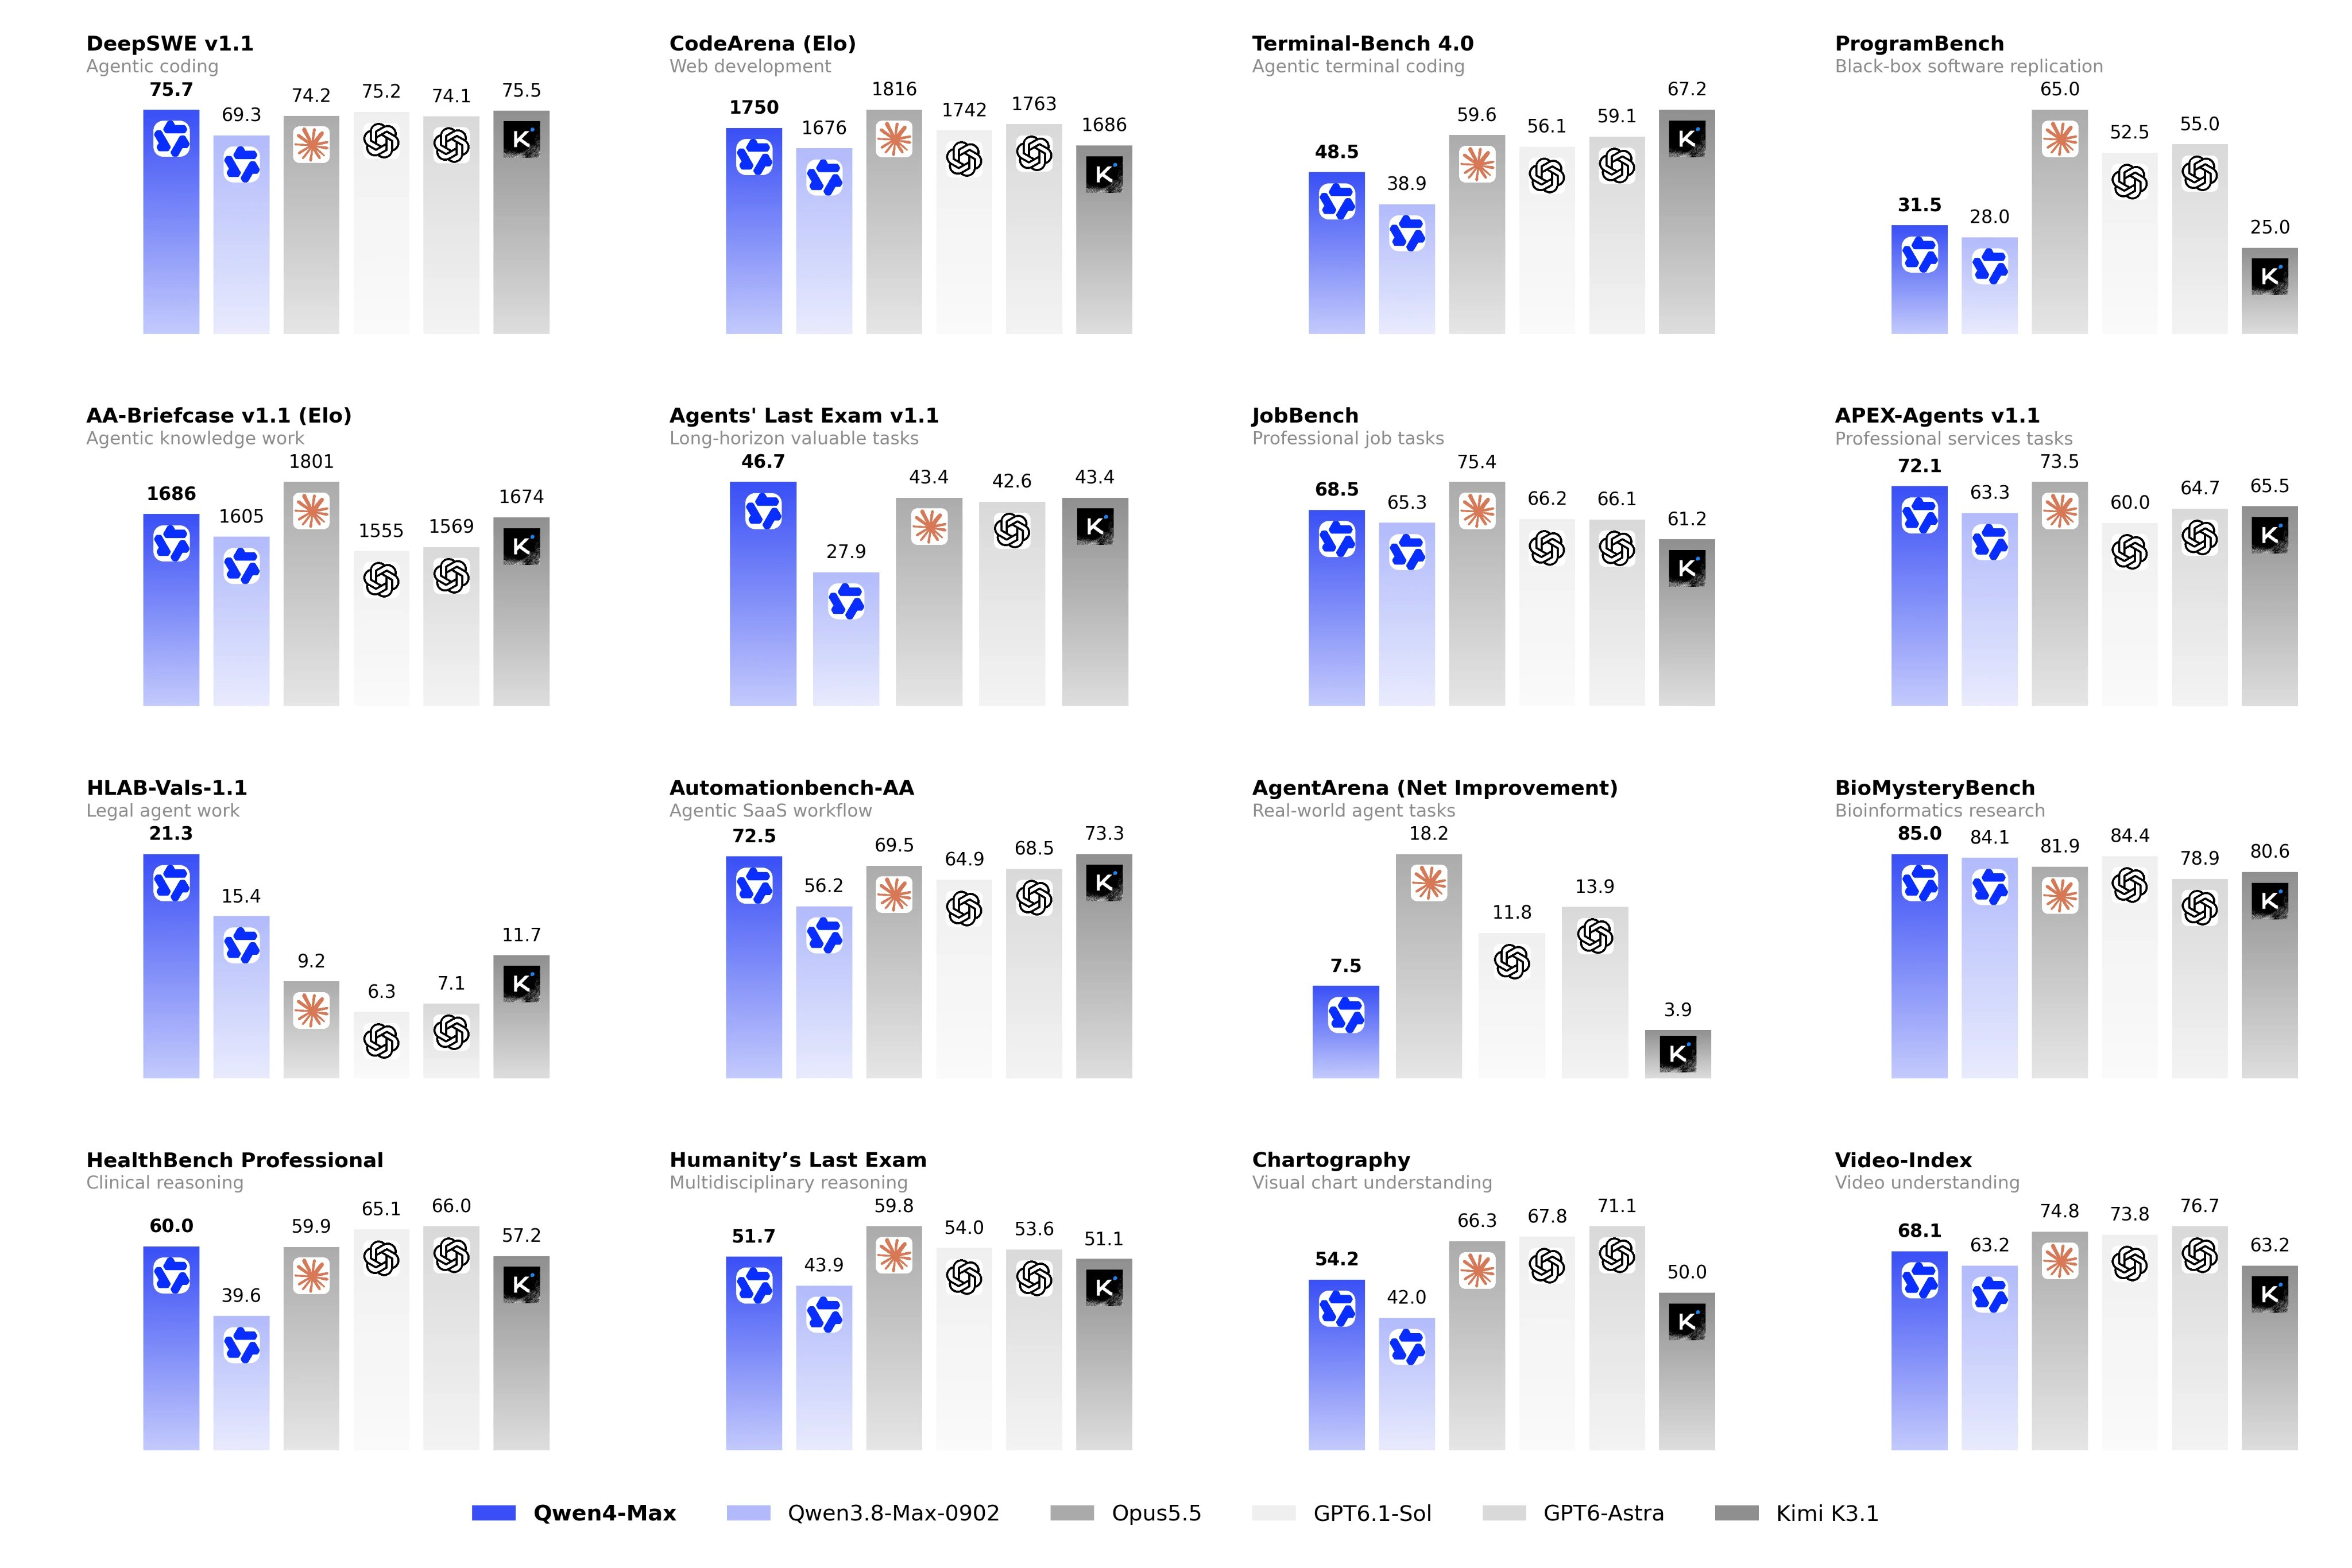
太字はチャート内の最高スコアを示します。「Alibaba」という記載は、そのテストの脚注に外部リーダーボードが引用されていないことを意味し、Alibaba自身の実行結果として扱うべきです(JobBenchとChartographyの脚注にはAlibabaのテスト設定の説明しか記載されていません)。
自己申告 vs サードパーティ:各テストを誰が実行したか
16のスコアのうち10件は自己申告です。6件は他者が運営する公開リーダーボードから引用されています。この区別が、最も有効なフィルターとなります。
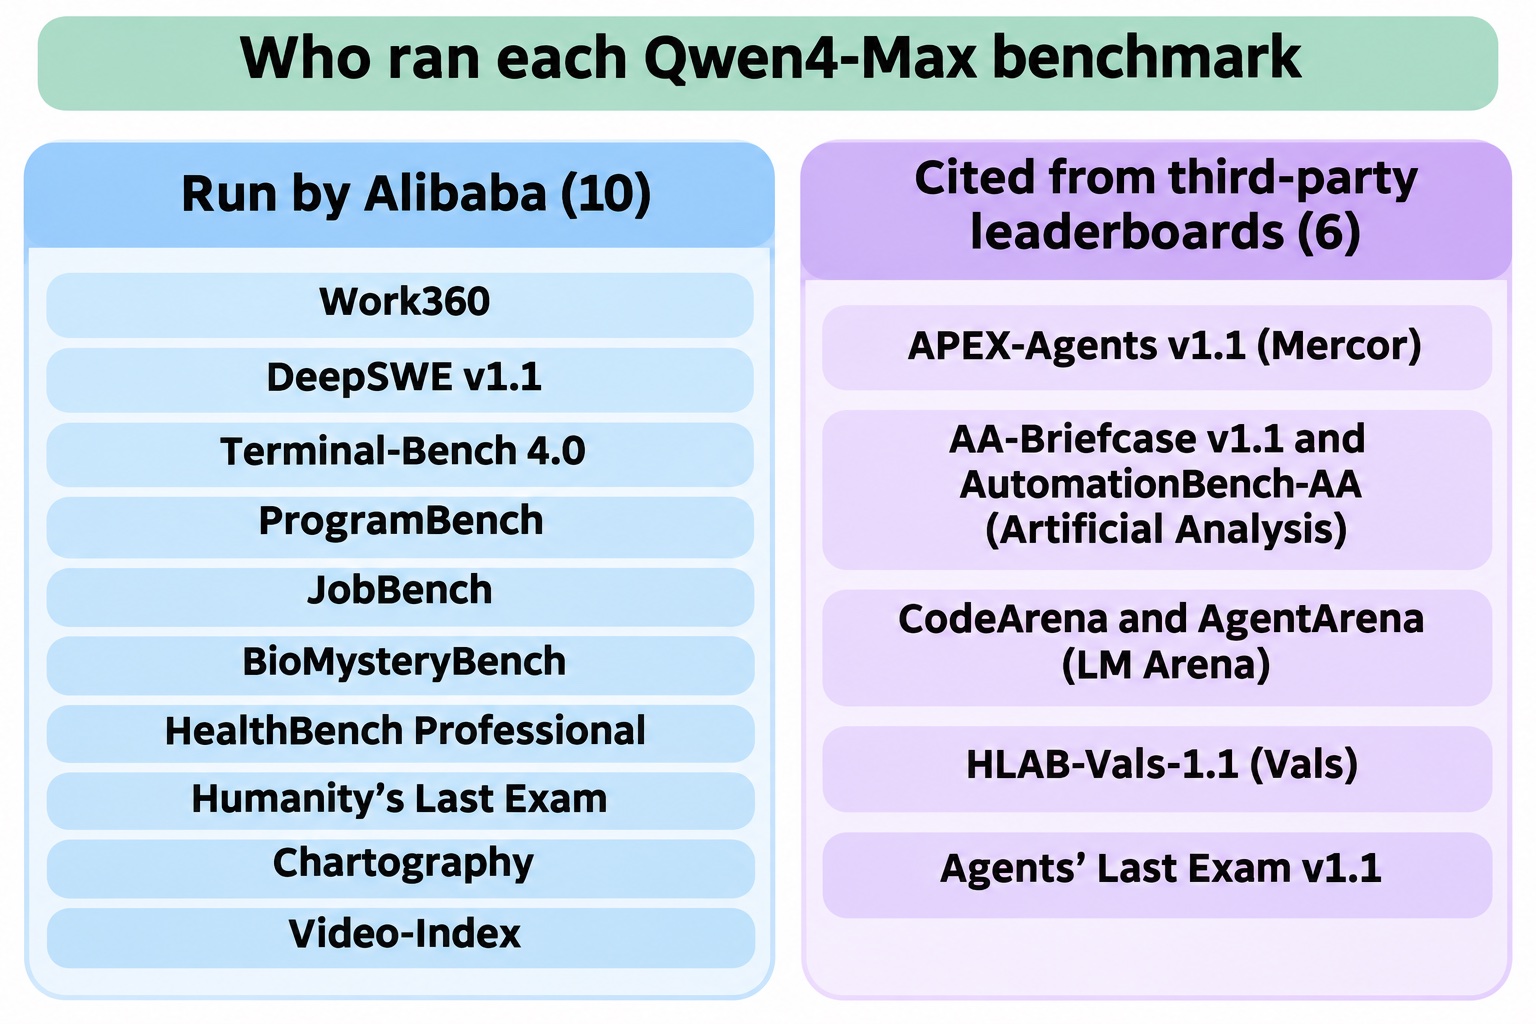
発表記事の脚注によると、サードパーティのグループは以下の通りです。
- APEX-Agents v1.1: Mercor APEX-Agentsリーダーボードから引用
- AA-Briefcase v1.1とAutomationBench-AA: Artificial Analysisから引用
- CodeArenaとAgentArena: LM Arenaから引用
- HLAB-Vals-1.1: Vals Indexから引用
- Agents’ Last Exam v1.1: 独自のリーダーボードから引用
今すぐ確認できる独立した数値が1つあります。Vals Index(バージョン2.2、2026年11月15日更新)では、Qwen 4 Maxが全体で63.20%、11位、テストあたり$9.33と掲載されています。これは、71.31%で首位のClaude Fable 5.2を筆頭とする10モデルの後ろに位置し、Kimi K3.1 Pro(62.52%)とQwen 3.8 Max 0902(59.05%)をわずかに上回る結果です。ヘッドラインのチャートよりも控えめな姿です。
Work360:Alibaba独自の業務ベンチマーク
Work360は、26のドメイン、182のサブドメイン、721の専門分野にまたがる、複雑な業界タスク向けのAlibaba独自ベンチマークです。Qwen4-Maxは52.69を獲得し、Qwen3.8-Maxの47.74から向上しました。
この数値は慎重に読む必要があります。ベンチマークを設計しモデルを実行したのはAlibaba自身であり、公開されている比較はQwen4-MaxとQwen3.8-Maxの2モデルのみ、しかも現時点で公開リーダーボードは存在しません。つまりこれは他社モデルとの順位ではなく、世代間の比較数値です。
Work360が教えてくれるのはコストの数値です。タスクあたりの平均コストが$4.43から$1.67に、62%低下しました。これはタスクあたりのトークン数減少と価格引き下げの合わせ技です。Qwen4-Maxの価格は、QwenCloudモデルページで入力トークン100万あたり$1.50、出力トークン100万あたり$4.50と公表されています。詳細はQwen4-Max料金ガイドをご覧ください。
Terminal-Bench 4.0とトークン効率
Terminal-Benchは、エージェントがターミナル上で実際のタスクを完了できるかを測定するものです。Alibabaの報告によると、Qwen4-Maxはバージョン4.0で48.5を達成し、Qwen3.8-Maxの38.9から向上しました。Alibaba独自のチャートでは、Qwen以外の4モデルは56.1から67.2の間に位置し、いずれもこれを上回っています。
より大きな主張は効率性です。Alibabaによると、Terminal-Bench 4.0ではトークン使用量がXhigh設定で約48%、High設定で約49%減少し、Work360では約24%(Xhigh)、35%(High)減少しています。スコア対トークンのチャートはその概要を示しています。
- Work360では、High設定のQwen4-Maxが、タスクあたり約96Kトークン対約165Kトークン(チャート読み取り値のため概算)で、Xhigh設定のQwen3.8-Maxをすでにわずかに上回っています。
- Terminal-Bench 4.0では、Xhigh設定のQwen4-Maxがタスクあたり約150Kトークンで48.5に到達する一方、Xhigh設定のQwen3.8-Maxは約290Kトークンで約38にとどまっています。
トークン単位で課金されるなら、より少ないトークンでより高いスコアというのは理想的な方向です。ただし、これも自己申告です。
知っておくべき注意点: 公開されているTerminal-Benchリーダーボードは現在、バージョン4.1がデフォルト表示になっており、11月16日時点でQwen4-Maxはそこに掲載されていません。Qwen3.8-Max-0902は4.1で27.0%(Claude Codeをmax effortで使用して実行)を示しており、Alibabaの4.0チャートの38.9と異なります。バージョンもハーネスも異なるため単純な引き算はできませんが、セットアップ次第でスコアが大きく変わることを示しています。
Qwen4-Maxが勝つところ、負けるところ
チャート内の他のフロンティアモデルと比較すると、結果はまちまちです。
首位(16項目中4項目): DeepSWE v1.1(75.7、Kimi K3.1に0.2ポイント差)、Agents’ Last Exam v1.1(46.7)、HLAB-Vals-1.1(21.3)、BioMysteryBench(85.0、GPT-6.1 Solに1ポイント未満の差)。
僅差の2位: APEX-Agents v1.1(72.1 vs 73.5)、AutomationBench-AA(72.5 vs 73.3)、AA-Briefcase(1686 vs 1801 Elo)。
大きく後れを取る: ProgramBench(31.5 vs 65.0)、Terminal-Bench 4.0(48.5 vs 67.2)、AgentArena(7.5 vs 18.2)、Chartography(54.2 vs 71.1)、Humanity’s Last Exam(51.7 vs 59.8)。
4つの首位のうち、Agents’ Last ExamとHLAB-Valsの2つはサードパーティのリーダーボード由来で、チャートの中で最も信頼性の高い主張と言えます。コーディングは割れる結果です。DeepSWEでは僅差の首位、ProgramBenchとTerminal-Benchでは大きな差を付けられています。長時間動くターミナルエージェントを使っているなら、乗り換える前に自分でテストしましょう。前世代からの変化点については、Qwen4-Max vs Qwen 3.8をご覧ください。
セキュアコーディングと事前学習の数値
セキュアコーディング。 Last Secure Code Benchの「セキュリティヒントなしでコードを再構築」設定で、機能性と脆弱性の両方をチェックした場合、関数レベルの合格率はQwen3.8-Maxの22.0%から31.8%に上昇しました。関数・ファイル・リポジトリの3レベルすべてに合格したコードの割合は、8%から14.7%に向上しています。ただし、関数レベルの出力の約3分の2は依然としてチェックに不合格のため、セキュリティレビューは依然としてユーザーの仕事です。
事前学習。 知識・コード・QA・STEMにわたる社内評価では、Qwen4-Max-BaseはQwen3.8-Max-Baseより約5%から13%低いbits per byteを示しながら、アクティブ化するパラメータ数は25%少なくなっています。Alibabaは、この比較に含まれる2つのチェックポイント(GLM-5.3とKimi-K3.1-Pro)はポストトレーニング済みであり、結果に偏りが出る可能性があると注記しています。
まだ足りないもの
- ほとんどのテストの評価設定。 発表記事には、どのエフォートレベル(HighまたはXhigh)やどのエージェントハーネスで各バーが得られたかの記載がありません。
- 分散。 エラーバーや実行回数の記載がありません。Terminal-Benchのようなリーダーボードは約3〜4ポイントの誤差を報告しており、上記の一部の差よりも大きい数値です。
- Terminal-BenchとWork360の独立した実行。 どちらもまだ公開リーダーボードに掲載されていません。
Apidog CLIで独自のQwen4-Maxベンチマークを実行する
あなたのプロンプトやスキーマを使った公開ベンチマークは存在しません。最も手早く誠実な検証は、自分のリクエストを小規模なスイートとして用意し、毎回同じ方法で実行し、トークン使用量を記録してタスクあたりの独自コストを計算できるようにすることです。
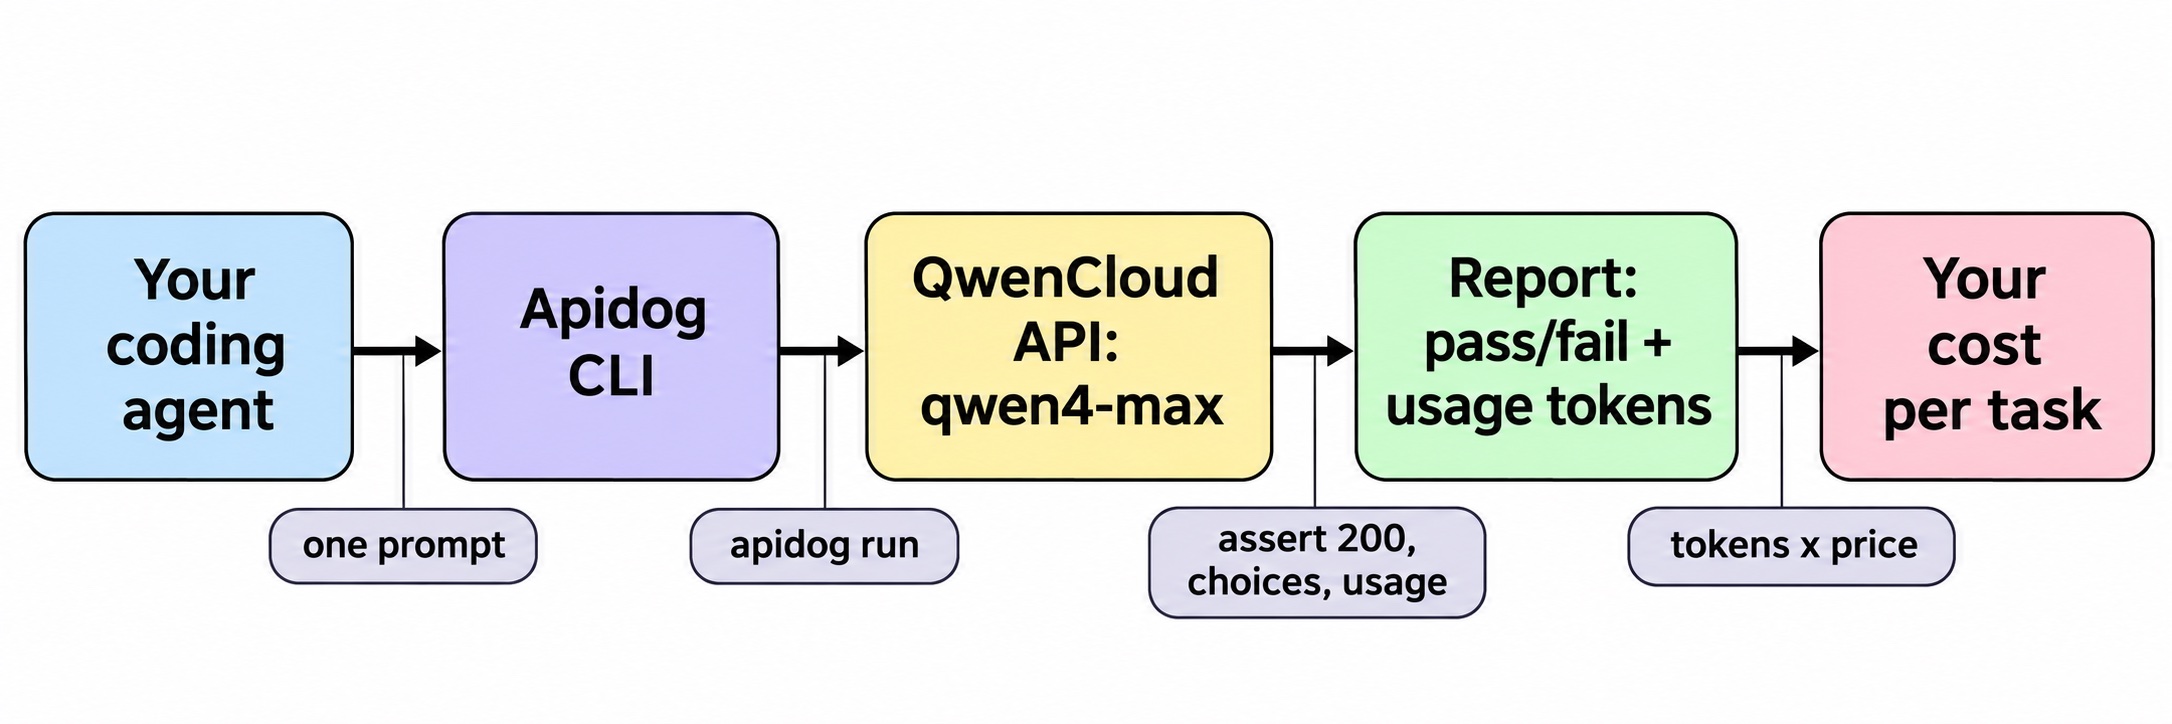
セットアップはApidog CLIを使ってコーディングエージェントに任せましょう。一度インストールします。
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill installでエージェントにCLIを覚えさせます。トークンの詳細はインストールガイドを参照してください。その後、次の1つのプロンプトを渡します。
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
エージェントは何かを書く前に各ペイロードの構造を確認します。以下のすべてのフラグは、Apidog CLI 2.2.12のapidog <command> --helpに基づいています。
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-dはプロンプトファイルの各行につき1回のイテレーションを実行し、--env-varは実行時にキーを渡すため、キーがプロジェクトに保存されることはありません。エージェントはapidog-reports内のJSONレポートから各usageブロックを読み取ります。プロンプトトークンに$1.50、完了トークンに$4.50(100万トークンあたり)を掛ければ、Alibabaの$1.67と比較できる独自のタスクあたりコストが得られます。
環境を切り替えれば、同じスイートを現在使用中のモデルに対して実行できます。また、2〜3回繰り返して、発表チャートには見えない分散を確認しましょう。同じapidog runコマンドは-r junitでCIに組み込めます。詳細はCI/CDガイドをご覧ください。エージェントを使ったステップバイステップのセットアップについては、Claude CodeでのApidog CLIをご覧ください。ApidogのFreeプランは最大4ユーザーまで利用できます。
FAQ
Qwen4-Maxのベンチマークは独立したものですか? ほとんどはそうではありません。Alibabaのチャートにある16のスコアのうち10はAlibaba自身の実行結果です。残り6はサードパーティのリーダーボードから引用されています。APEX-Agents(Mercor)、AA-BriefcaseとAutomationBench-AA(Artificial Analysis)、CodeArenaとAgentArena(LM Arena)、HLAB-Vals(Vals)、Agents’ Last Examです。
Work360とは何ですか? 26のドメインにわたる複雑な業界タスク向けの、Alibaba独自のベンチマークです。Qwen4-Maxは52.69を獲得し、Qwen3.8-Maxの47.74を上回りました。公開比較にはこの2モデルのみが掲載されています。
Qwen4-MaxのTerminal-Bench 4.0の結果はどうですか? Alibabaは38.9から48.5への向上を、トークン量は約半分で達成したと報告しています。チャート内の他のフロンティアモデルは56.1から67.2のスコアです。
Qwen4-MaxはQwen3.8-Maxより実行コストが安いですか? AlibabaのWork360評価では、タスクあたりの平均コストが$4.43から$1.67に低下しました。定価は入力トークン100万あたり$1.50、出力トークン100万あたり$4.50です。サブスクリプションの選択肢はToken Planガイドを、無料で使う方法はQwen4-Maxを無料で使うをご覧ください。
Qwen4-Maxの発表におけるLive Deliveryとは何ですか? 使える初版を早期にリリースし、ユーザーの指示に従いながら改善を続けるエージェントワークフローです。ベンチマークではありません。詳細はQwen Live Deliveryプラグインガイドをご覧ください。