
Qwen4-Max APIが、従量課金(トークン単位)モデルとしてID qwen4-max でQwenCloud上に公開されました。お住まいのリージョンで従量課金キーを作成し、OpenAI SDKのエンドポイントを https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1(シンガポール)に設定するだけで、すぐに呼び出せます。料金は入力トークン100万あたり1.50ドル、出力トークン100万あたり4.50ドルで、コンテキスト長は100万トークンです。
本ガイドでは、APIキーの取得、ベースURL、思考モード、ビジョン、ツール、構造化出力、キャッシュ、Anthropic互換ルート、レート制限、エラーについて解説します。すべてのコード例は2026年11月16日時点で閲覧した QwenCloudドキュメント に準拠しています。
背景情報については、Qwen4-Maxとは何かをご覧ください。従量課金ではなくサブスクリプションでの利用については、Qwen4-Maxのすべての利用方法 および トークンプランガイド を参照してください。
Qwen4-Max APIでできること
Qwen4-Max APIは、AlibabaのフラッグシップモデルをQwenCloud経由で提供するもので、OpenAI互換・Anthropic互換・DashScopeの各エンドポイントを備えています。テキスト・画像・動画の入力に対応し、デフォルトで回答前に思考(reasoning)を行い、関数呼び出し、構造化出力、コンテキストキャッシュ、バッチ処理、Web検索、ファインチューニングをサポートします。
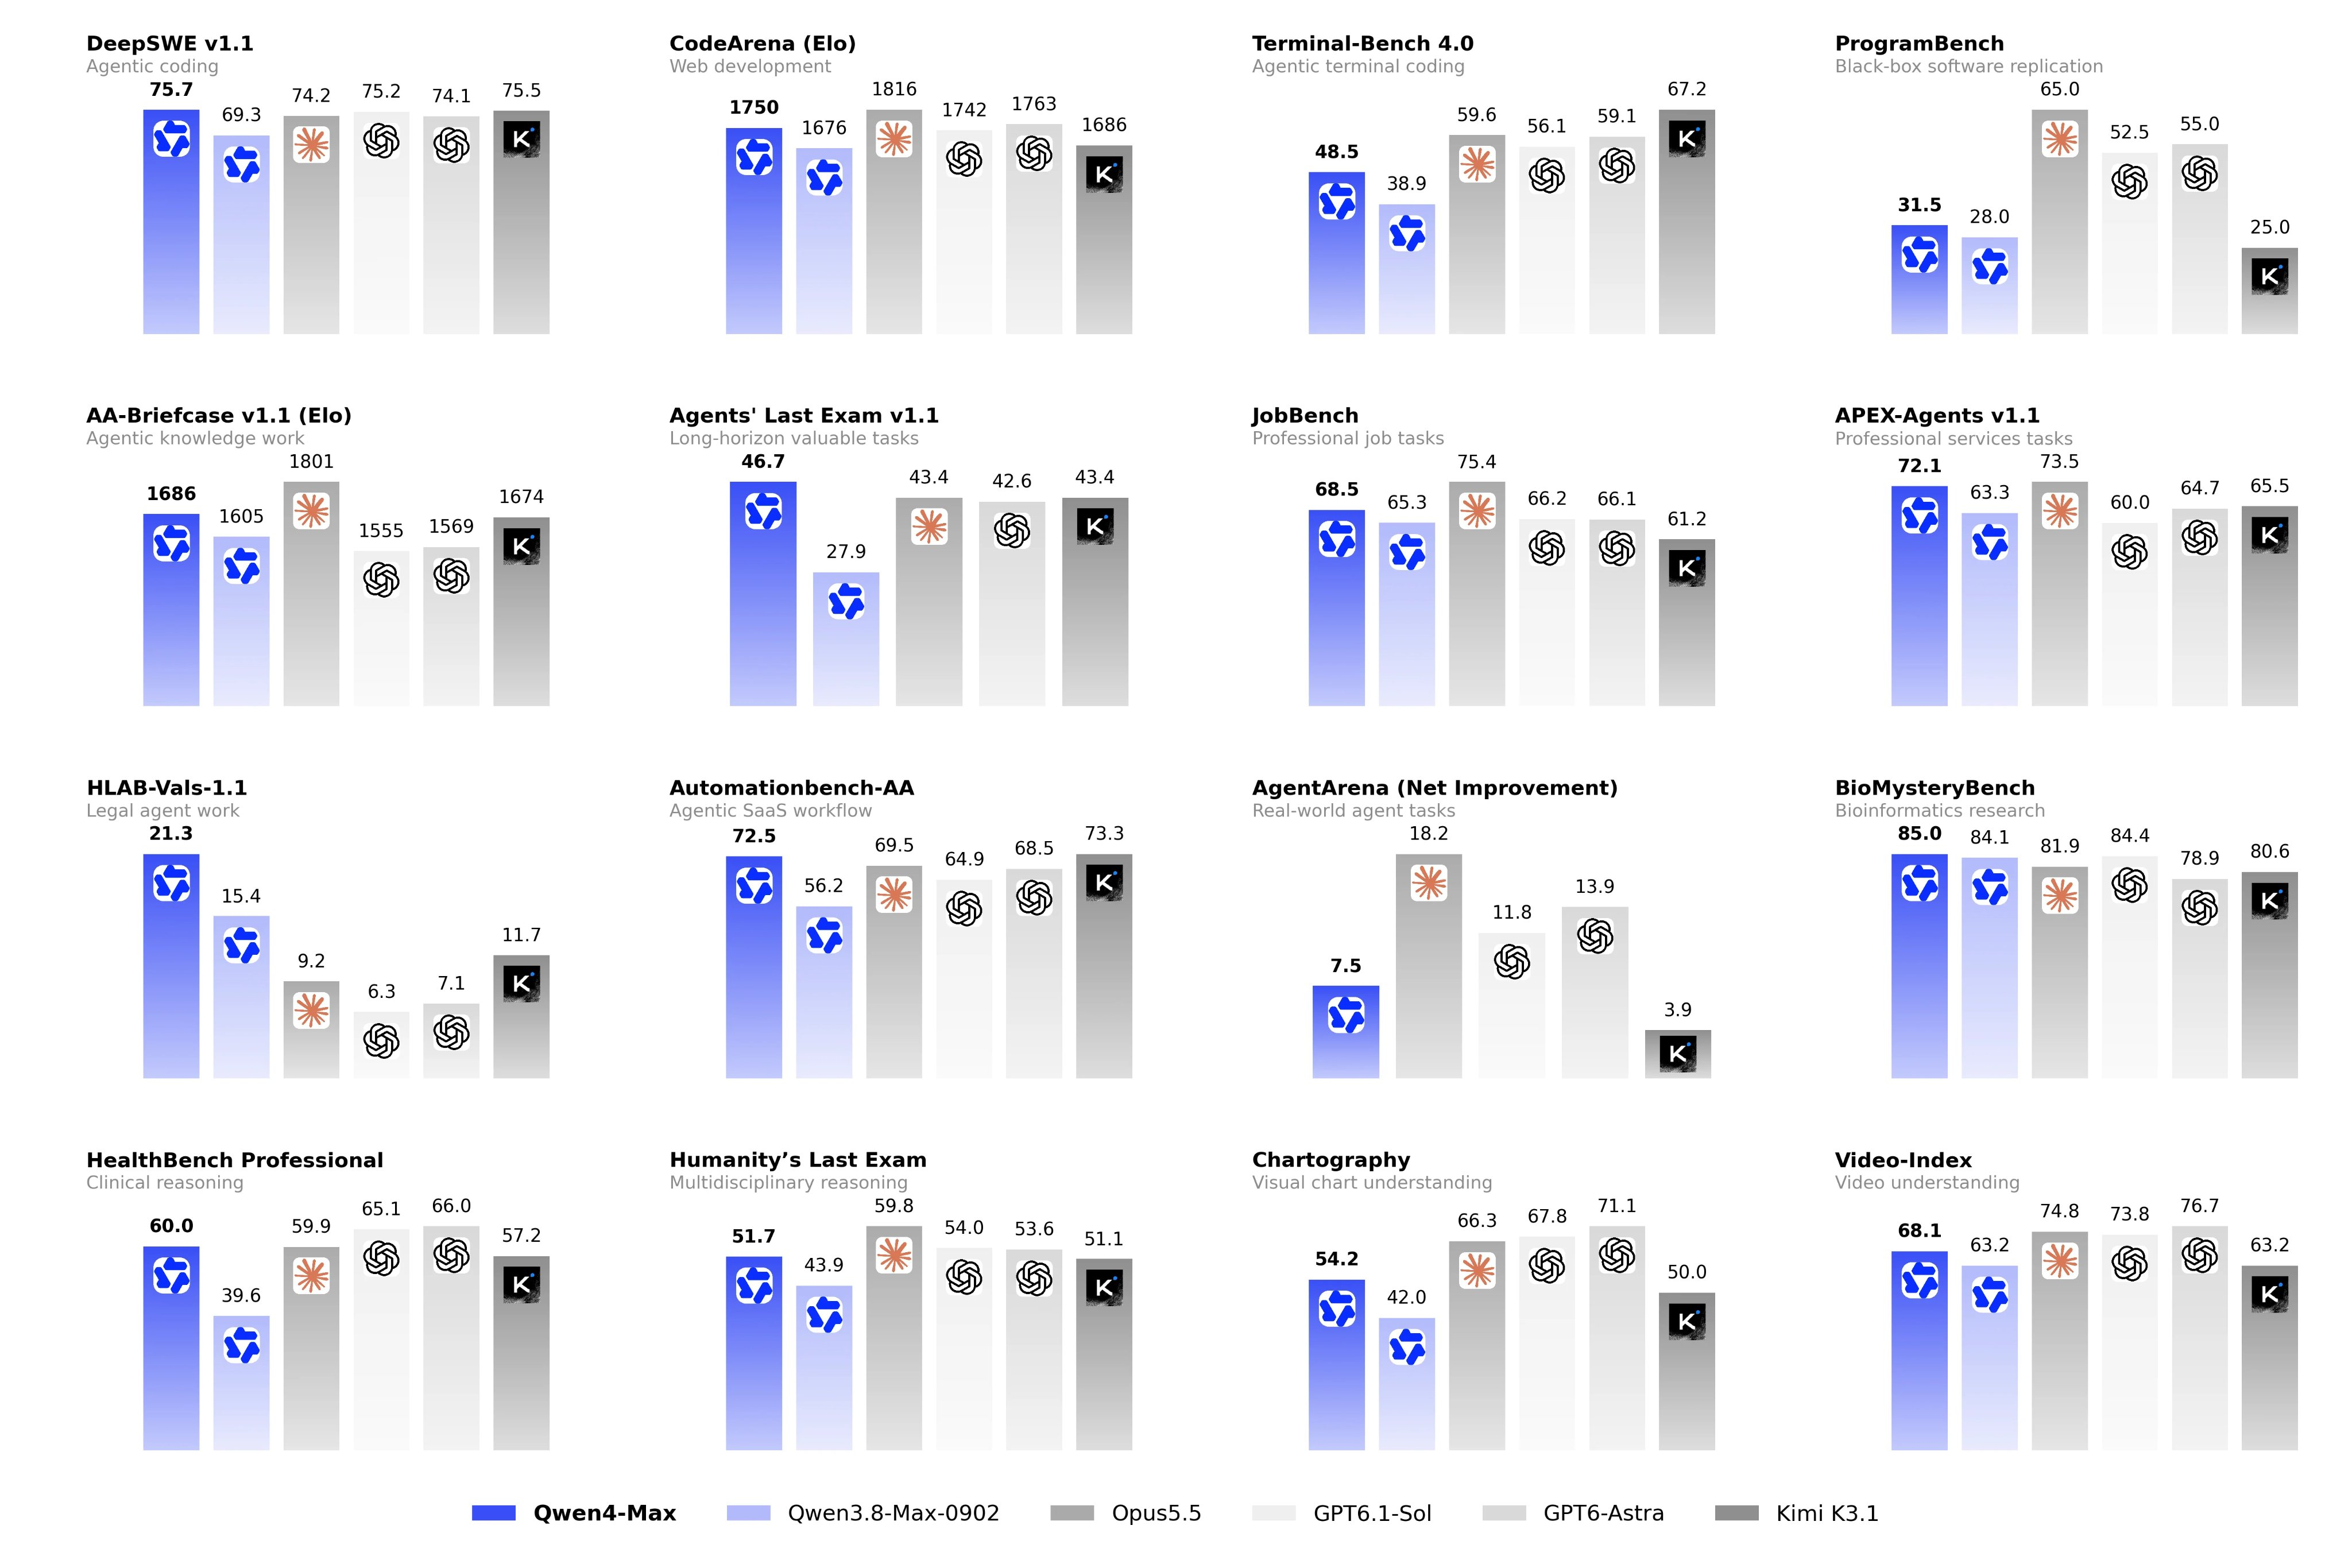
qwen4-maxモデルページ に記載されているスペックは以下のとおりです。
| 項目 | 値 |
|---|---|
| モデルID | qwen4-max |
| 入力料金 | 100万トークンあたり1.50ドル |
| 出力料金 | 100万トークンあたり4.50ドル |
| 暗黙的キャッシュ入力/明示的キャッシュ読み取り | 100万トークンあたり0.075ドル |
| 明示的キャッシュ作成 | 100万トークンあたり1.875ドル(5分)または3ドル(1時間) |
| コンテキストウィンドウ | 100万トークン |
| 最大入力 | 99.1万トークン(思考モード有効時は98.3万トークン) |
| 最大出力 | 39.3万トークン |
| 最大推論トークン | 26.2万トークン |
| スループット | 500万TPM |
思考トークンは出力トークンとして課金されます。料金の詳細な内訳については、Qwen4-Max料金ガイド をご覧ください。
APIキーの取得とベースURLの選択
APIキーはリージョンに紐づいており、キーの種類はエンドポイントと一致している必要があります。
- QwenCloudコンソール を開き、右上のセレクターでリージョンを選択します。
- API Keys に移動し、Create API key をクリック、説明を入力して Generate Key をクリックします。
- キーは一度しか表示されないため、すぐにコピーしてください。新規の従量課金キーは
sk-ws-で始まります。 - エクスポートします:
export DASHSCOPE_API_KEY="sk-ws-..."。
すべてのリージョンでドメインは {region}.maas.qwencloudapi.com という形式です。シンガポールは ap-southeast-1、フランクフルトは eu-central-1、東京は ap-northeast-1、米国(バージニア)は us-east-1 です。続いてプロトコルのパスを追加します。
| プロトコル | ベースURL(シンガポール) |
|---|---|
| OpenAI互換(Chat Completions、Responses) | https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 |
| Anthropic互換 | https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic |
| DashScope HTTP | https://ap-southeast-1.maas.qwencloudapi.com/api/v1 |
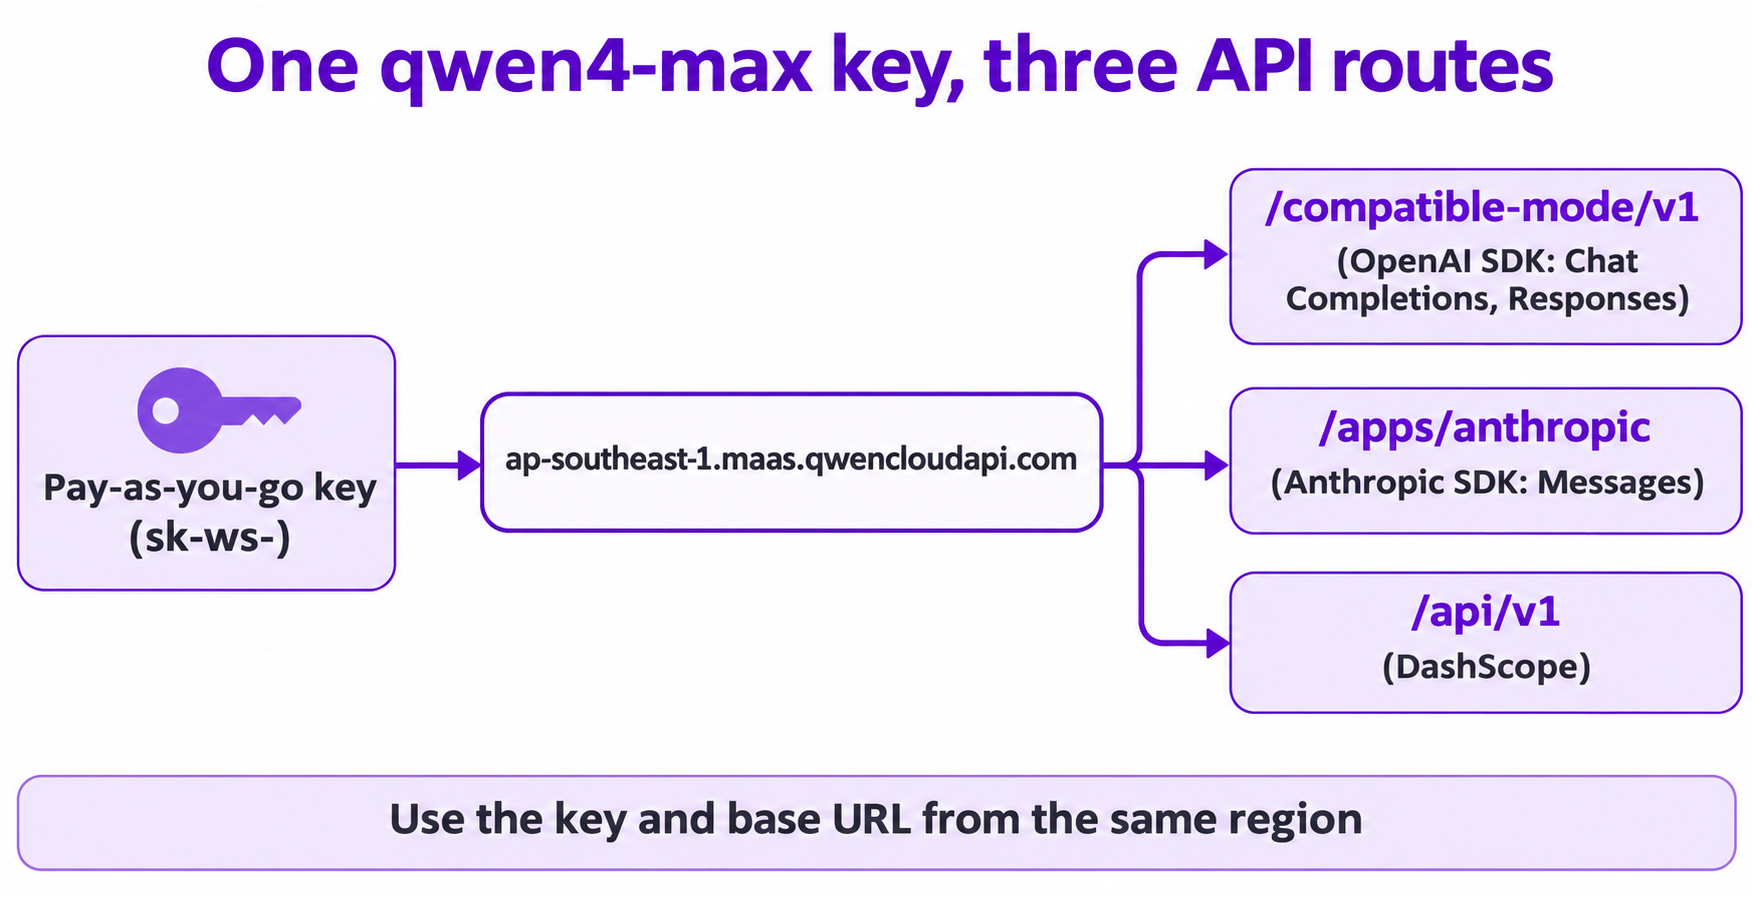
トークンプランのキー(sk-sp-)は token-plan.maas.qwencloudapi.com でのみ動作し、従量課金キーは自分のリージョンのドメインでのみ動作します。混在させると401エラーになります。詳しくは リージョンとエンドポイント を参照してください。
最初のQwen4-Max API呼び出し
OpenAI SDKをインストールし(pip install openai)、ドキュメントのクイックスタートを実行します。
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.getenv("DASHSCOPE_API_KEY"),
  base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1"
)
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Summarize the benefits of solar energy in three bullet points."}]
)
print(completion.choices[0].message.content)
qwen4-max では思考モードがデフォルトで有効になっているため、この呼び出しでも推論トークンが消費されます。長いプロンプトの場合は、ストリーミングを使うか、クライアントのタイムアウトを180秒以上に設定してください。
思考モードとreasoning_contentのストリーミング
Qwen4-Maxはハイブリッド思考モデルです。ドキュメントに記載されたデフォルト値は enable_thinking=true、reasoning_effort=high、thinking_budget=131072 です。推論の強度レベルは low、high、xhigh で、none を指定すると思考モードがオフになります。
推論と回答を2つのフェーズとしてストリーミングする例(モデルページのサンプルを改変):
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
messages = [{"role": "user", "content": "Who are you"}]
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True)  # phase 1: thinking
    if delta.content:
        print(delta.content, end="", flush=True)            # phase 2: answer
3つの重要なルールがあります。
max_completion_tokensで出力を制限する。 思考モード有効時、max_tokensは1〜32,768の値のみ受け付けます(範囲外は400エラー)。max_completion_tokensは推論+回答を合わせて制限でき、この上限の制約を受けません。extra_bodyで推論の深さを調整する。 難しい問題には{"enable_thinking": True, "reasoning_effort": "xhigh"}を、コストを抑えたい簡単な問題には"low"を指定します。- マルチターンの会話では推論を保持する。
qwen4-maxはデフォルトでpreserve_thinkingが有効なため、過去の推論は各アシスタントメッセージのreasoning_contentフィールドに格納して送り返してください。content内に入れてはいけません。
思考をスキップしたい場合は、{"enable_thinking": False} を渡します。
画像と動画の入力
画像は image_url パート、動画は video_url パートとして送信します。以下はドキュメントのビジョンサンプルをモデル qwen4-max 向けに変更したものです。
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{
    "role": "user",
    "content": [
      {"type": "image_url", "image_url": {"url": "https://example.com/invoice.jpg"}},
      {"type": "text", "text": "Describe what you see in this image"},
    ],
  }],
)
動画の場合は、{"type": "video_url", "video_url": {"url": "..."}, "fps": 2} を使用します。ローカルファイルはBase64のData URIとして渡せます。
ビジョンガイド によると、URL画像は1枚20MBまで最大2,048枚、Base64画像は250枚まで、リクエストあたり64MBまで送信できます。画像の詳細度(detail)はデフォルトで「high」に設定されており、より多くの入力トークンを消費します。
関数呼び出し
他のOpenAI互換モデルと同様に、tools 配列を渡します。
tools = [{
  "type": "function",
  "function": {
    "name": "get_current_weather",
    "description": "Useful when you want to check the weather for a specific city.",
    "parameters": {
      "type": "object",
      "properties": {"location": {"type": "string", "description": "City or county, such as Singapore or New York."}},
      "required": ["location"],
    },
  },
}]
completion = client.chat.completions.create(model="qwen4-max", messages=messages, tools=tools)
message.tool_calls を読み取り、関数を実行し、tool メッセージを追加してから再度呼び出します。
思考モードでは、tool_choice は "auto" または "none" のみ受け付けます。関数を強制したい場合は、先に思考モードを無効化してください。また、思考モード有効時は reasoning_content をツールの結果と一緒に送り返さないと、精度が低下します。
構造化出力
qwen4-max は厳密なJSON Schemaモードをサポートしています。
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Extract the name and age: Ana is 31."}],
  response_format={
    "type": "json_schema",
    "json_schema": {
      "name": "user_info",
      "strict": True,
      "schema": {
        "type": "object",
        "properties": {"name": {"type": "string"}, "age": {"type": "integer"}},
        "required": ["name", "age"],
        "additionalProperties": False,
      },
    },
  },
)
より緩い {"type": "json_object"} モードでは、メッセージ内に「JSON」という語が含まれていないと、APIはリクエストを拒否します。画像や動画を入力した場合は json_object にフォールバックするため、マルチモーダル呼び出しではスキーマは強制されません。
コンテキストキャッシュとバッチ
キャッシュ。 設定なしでは、暗黙的キャッシュがプレフィックスのマッチを行いますが、ヒットは保証されません。決定論的なヒットが必要な場合は、Qwen4の明示的キャッシュ を使用します。コンテンツブロックに "prompt_cache_breakpoint": {"mode": "explicit"} を付与し(メッセージの content は配列である必要があります)、TTLを extra_body={"prompt_cache_options": {"mode": "explicit", "ttl": "5m"}} で設定します。TTLは 5m または 1h で、キャッシュ対象のプレフィックスは最低1,024トークンが必要です。読み取りは100万トークンあたり0.075ドルで、通常の入力より95%安くなります。
バッチ。 バッチガイドによると、入力と出力はリアルタイム価格の50%で課金され、結果は24時間以内に返却されます。ただし qwen4-max の場合、Batch Fileはシンガポール以外の1リージョンで実行され、コンテキストキャッシュに対応していません。パイプラインをバッチ前提で設計する前に、バッチガイド を確認してください。
Anthropic互換ルート
すでにAnthropic SDKで構築済みですか? ベースURLとキーを変更するだけで済みます。
import anthropic
import os

client = anthropic.Anthropic(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic",
)
message = client.messages.create(
    model="qwen4-max",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Who are you?"}],
    thinking={"type": "disabled"},
)
print(message.content)
このサンプルはドキュメントのサンプルと同様、思考モードをオフにしています。ベースURLは /apps/anthropic で終わるようにしてください。/v1/ を追加すると /v1/v1/... となり404エラーになります。こちらのルートでも思考モードはデフォルトで有効であり、思考モード有効時は max_tokens が思考バジェットを超えている必要があります。推論の強度は output_config.effort(low、high、xhigh)で指定し、このルートでは組み込みの web_search と web_fetch ツールも利用可能です。
Qwen4-Max APIのレート制限
レート制限ページ からの情報です。
| リージョン | RPM | TPM |
|---|---|---|
| シンガポール | 動的 | 動的ティア:500万、1,000万、2,000万 |
| フランクフルト、東京、米国(バージニア)およびその他のグローバルスコープのリージョン | 30,000 | 5,000,000 |
制限はアカウント・リージョンごと、さらに秒単位(RPS = RPM / 60)でも適用されるため、バースト発生時には1分あたりの総量以内でもスロットリングされることがあります。
無料クォータページ によると、無料クォータはシンガポールリージョンでのみ提供され、モデルごと(通常は100万トークン)、有効期間90日、支払い情報の登録が必要です。qwen4-max が対象かは明記されていないため、コンソールのFree Tierページを確認するか、Qwen4-Maxを無料で使う方法 をご覧ください。
Qwen4-Max APIのよくあるエラー
| コード | 意味 | 対処法 |
|---|---|---|
401 InvalidApiKey |
キーとベースURLのリージョンが異なる、またはトークンプランのキーを従量課金エンドポイントで使用した | URLと同じリージョンで作成したキーを使用する |
400 InvalidParameter |
多くの場合、思考モード有効時に max_tokens が1〜32,768の範囲外 |
max_completion_tokens に切り替える |
403 AllocationQuota.FreeTierOnly |
支払い設定前に無料クォータを使い切った | Free Tierページで支払い情報を追加する |
404 ModelNotFound |
呼び出したリージョンで qwen4-max が提供されていない |
そのリージョンのモデル価格を確認する |
429 Throttling |
RPMまたはTPMの上限に到達した | バックオフして再試行するか、負荷を秒単位で分散させる |
Apidog CLIでコーディングエージェントにQwen4-Max APIをテストさせる
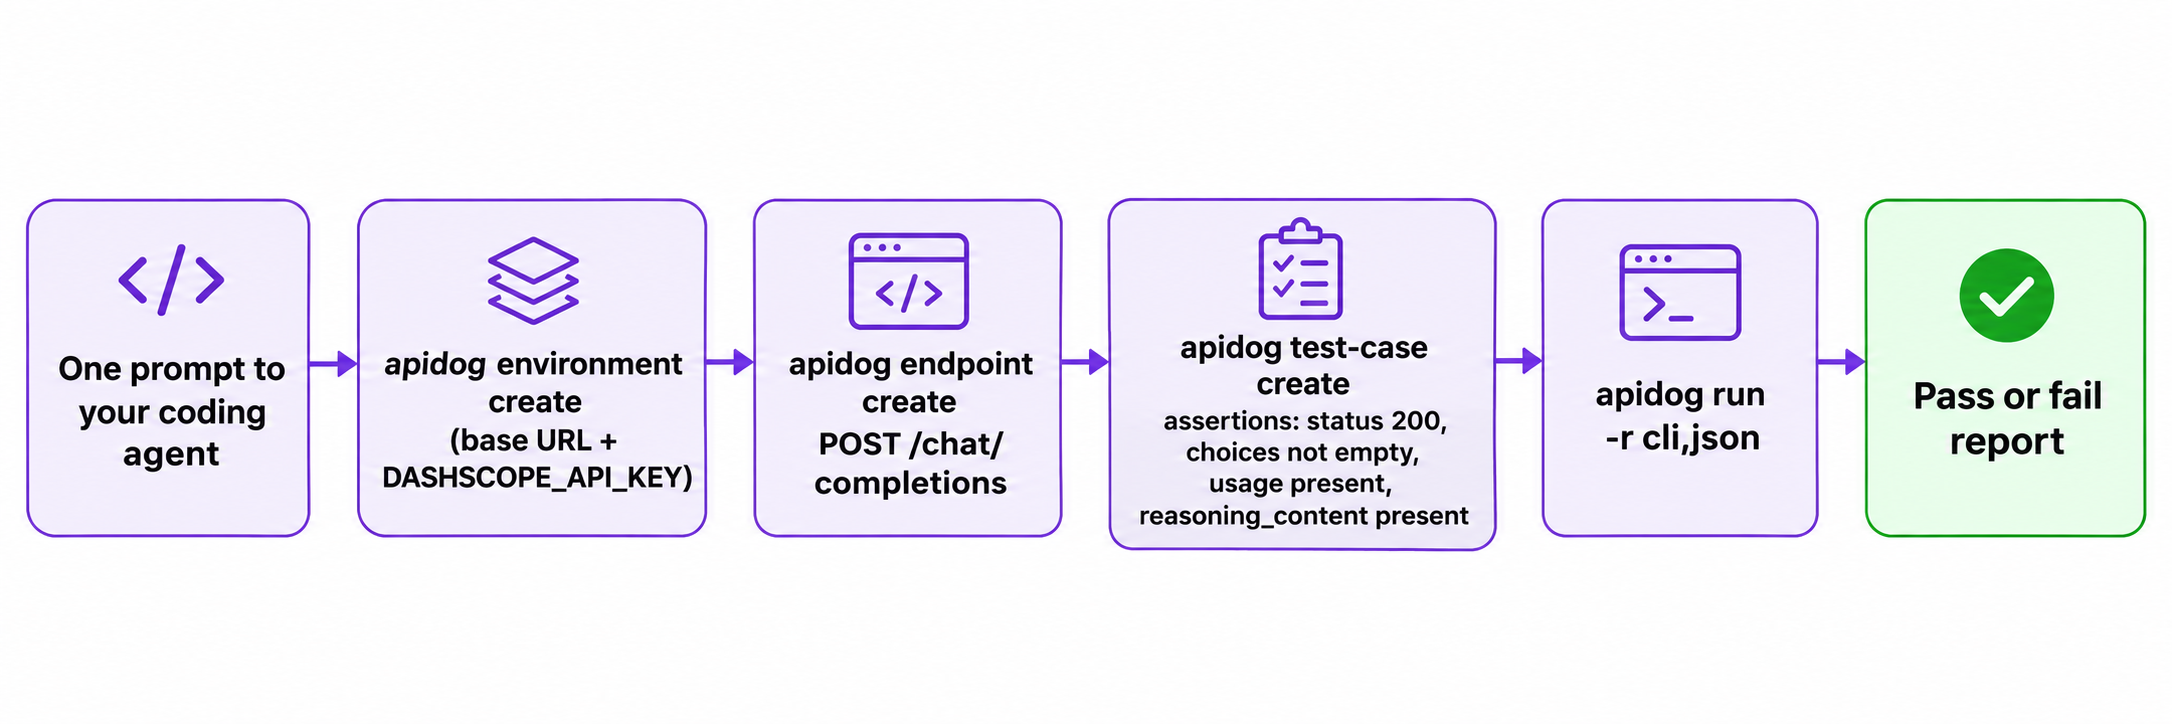
コーディングエージェントが統合コードを書くなら、回帰テストも書かせましょう。Apidog CLI を使えば、エンドポイントの保存、キーの管理、アサーションの実行をエージェントに行わせられます。
まず一度だけセットアップします。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
その後、エージェントに次の1つのプロンプトを与えます。
In Apidog project <projectId>, create an environment "Qwen Singapore" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable DASHSCOPE_API_KEY. Add POST /chat/completions with a Bearer auth header,
model qwen4-max and enable_thinking true. Create a test case asserting status 200,
a non-empty choices array, a usage object, and reasoning_content present on the
first choice's message. Run it and summarize any failures.
エージェントは各ペイロードのスキーマを読んでからコードを書き、テストケースを実行します。
apidog environment create "Qwen Singapore" --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
cli レポーターは合否を出力し、json はエージェントが読めるレポートを書き出します。同じ apidog run ... -r junit をCIに組み込む方法は Apidog CLI CI/CDガイド を、さらに多くのプロンプト例は Claude CodeでのApidog CLI をご覧ください。ApidogのFreeプランでは最大4ユーザーまで利用できます。
FAQ
Qwen4-Max APIのモデルIDは何ですか?
安定版のIDは qwen4-max です。以前の qwen4-max-preview IDは、2026年11月11日に開始したプレビュー期間中、トークンプラン専用でした。
Qwen4-Max APIはOpenAI互換ですか?
はい。Chat CompletionsおよびResponses APIには、OpenAI SDKを /compatible-mode/v1 のベースURLで使用できます。Anthropic互換エンドポイントやDashScope APIも利用可能です。
Qwen4-Max APIで思考モードをオフにするには?
extra_body={"enable_thinking": False} を渡します。reasoning_content は失われますが、レイテンシと出力トークンが減少します。モデル比較については、Qwen4-Max vs Qwen3.8 をご覧ください。
Qwen4-Max APIの料金はいくらですか?
入力トークン100万あたり1.50ドル、出力トークン100万あたり4.50ドルです。キャッシュ読み取りは100万トークンあたり0.075ドルです。
トークンプランのキーを従量課金APIで使えますか?
いいえ。トークンプランのキー(sk-sp-)は token-plan.maas.qwencloudapi.com でのみ動作し、従量課金キーは自分のリージョンのドメインでのみ動作します。