
Alibabaは2026年8月上旬にQwen 3.8-Maxをリリースしました。もし本番環境でqwen3.7-maxをすでに運用しているなら、重要な決断を迫られるでしょう。この新しいモデルは、エージェント機能と研究ベンチマークで大幅な性能向上を記録し、画像入力を追加し、より低い定価で提供され、そしてAlibabaが前身モデルでは決して行わなかった「オープンウェイト」という約束を伴います。
しかし、その決断は「新しいモデルが勝つ」というほど単純ではありません。Qwen 3.7-Maxは現在、期間限定の50%割引を実施しており、絶対的な価格で3.8-Maxよりも安くなっています。ベンチマークの差が劇的なものもあれば、実質的にゼロのものもあります。この記事では、重要な変更点をすべて解説し、今すぐ切り替えるべきか、待つべきか、あるいは完全に下のティアに移行すべきかを判断できるよう支援します。
新しいモデルの全体像をまず把握したい場合は、当社のQwen 3.8-Max解説記事から始めてください。前フラッグシップモデルの背景については、Qwen 3.7がもたらしたものをご覧ください。
数値を見る前に、方法論について一言。以下の各ベンチマーク数値は、Alibabaが公式Qwen 3.8リリース投稿で発表した自社テーブルからのものです。これは実際に役立ちます。両モデルが同じベンダーテストで評価されたため、独立した検証がまだ保留中であっても、差分は内部的に一貫しています。ほとんどのコーディング関連の項目はClaude Codeハーネスで実行され、いくつかのベンチマークはQwen社内ベンチマークです。
簡潔にまとめると
| 変更点 | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| ターミナルベンチ 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQAダイヤモンド | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| 定価(100万トークンあたり) | $2.5イン / $7.5アウト | $2イン / $6アウト |
| 現在の価格(プロモーション) | $1.25イン / $3.75アウト | $2イン / $6アウト |
| 画像入力 | なし | あり |
| 公開されたアーキテクチャ | 非公開 | 合計2.4兆、アクティブMoE 950億 |
| オープンウェイト | 未リリース | 「来週」(約8月10日)に公開予定 |
| コンテキストウィンドウ | 100万トークン | 100万トークン |
それでは詳細を見ていきましょう。
ベンチマークの差分:真の飛躍
主要な改善点は、エージェント機能に関連する作業に集中しています。これは、モデルが計画し、実行し、自己修正する長期間にわたるタスクです。
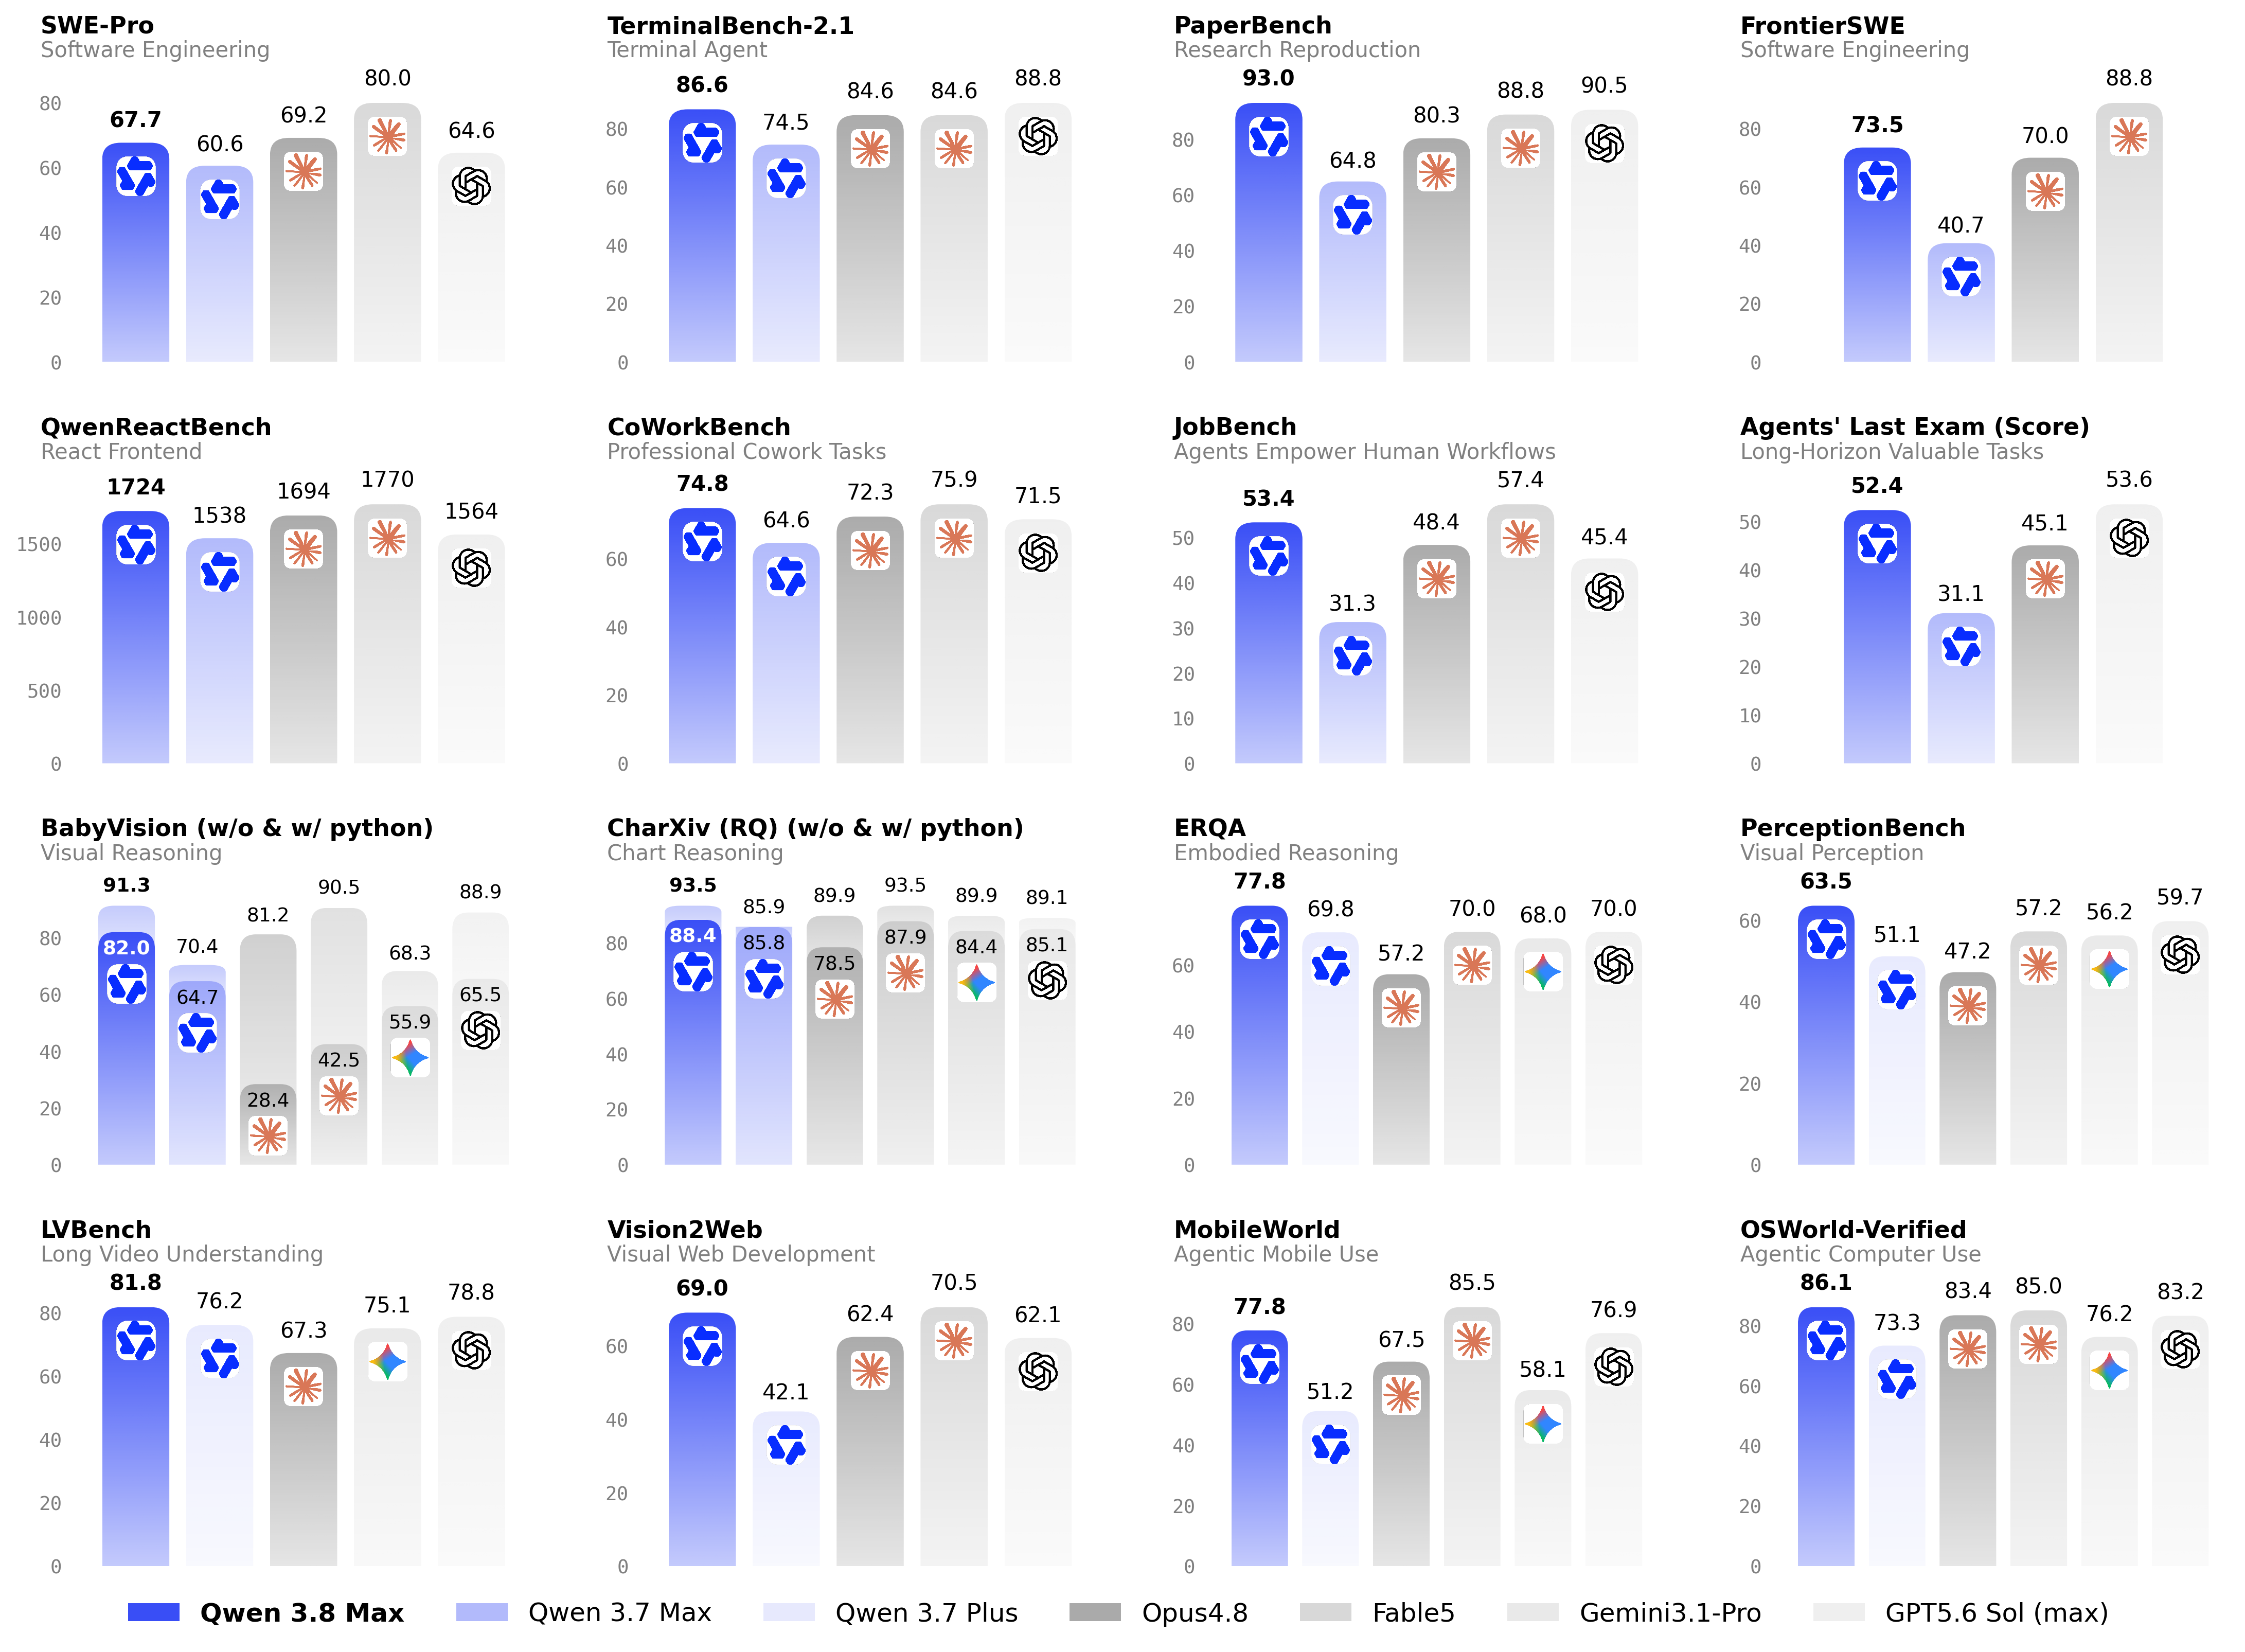
ターミナルベンチ 2.1:74.5から86.6へ。これはターミナル駆動のエージェントタスクで12ポイントの飛躍であり、Qwenを明らかに後れを取っていた状態から真に競争力のあるレベルに引き上げました。同じ表で、AlibabaはClaude Opus 4.8とFable 5をそれぞれ84.6と評価しており、3.8-Maxはこの項目で両者を上回っています。GPT-5.6 Solは依然として88.8でリードしています。
SWE-bench Pro:60.6から67.7へ。実世界のソフトウェアエンジニアリングタスクで7ポイントの向上。これは意味のある進歩ですが、正直に言うと、同じ表ではFable 5が80.0であり、これは追いついているのであって追い越したわけではありません。SWE-bench Proのパフォーマンスがあなたの主要な購入基準であるなら、最先端はまだ別のところにあります。
PaperBench:64.8から93.0へ。この表で最大の差分であり、AI研究論文の再現において28ポイントの飛躍を遂げました。また、Alibabaの比較におけるあらゆるライバルモデルを上回る、3.8-Maxにとって最高のフラッグシップ項目でもあります。もしあなたのワークロードが研究の再現、長文の技術文書、または多段階の科学的推論を含む場合、この数値は注目すべきです。
IFBench:79.1から82.8へ。指示追従性能が約4ポイント向上しました。注目すべきは、3.7-Maxがすでにこの分野で強かったこと(同じテストで79.1はOpus 4.8とFable 5を上回っていた)であり、これは弱点を修正するのではなく、既存のリードをさらに広げるものです。
GPQAダイヤモンド:92.4から92.6へ。実質的に横ばいです。大学院レベルの科学QAは、3.7-Maxにとってすでに飽和状態に近く、新しいモデルもこれを動かしませんでした。もしあなたのワークロードがGPQAのようなものであれば、アップグレードによって品質面で得るものはありません。
HLE:41.4から43.6へ。「人類最後の試験」は2ポイント向上しましたが、依然として最先端には及びません。同じ表でFable 5は53.3、GPT-5.6 Solは47.2を記録しています。Qwen 3.8-Maxは多くの場所で差を縮めていますが、ここはそうではありません。
このパターンは、エージェント機能と研究ベンチマークでの大幅な向上、指示追従性能での漸進的な向上、飽和状態にある知識ベンチマークでの変化なし、そして最も難しい推論評価における継続的なギャップを示しています。ハーネスや社内ベンチマークに関する詳細を含む完全な表については、当社のQwen 3.8ベンチマーク詳細解説をご覧ください。
アーキテクチャ:Alibabaがついにその数値を公開
Qwen 3.8-Maxは、Qwen 3.5のアーキテクチャ基盤上に構築された、順方向パスあたり950億のアクティブパラメータを持つ2.4兆パラメータの混合エキスパートモデルです。これはおおよそ4%のアクティベーション比率であり、サービス費用に影響します。つまり、2.4兆ではなく950億の計算に対して料金を支払うことになります。
3.7-Maxとの対照は、この情報の開示そのものです。AlibabaはQwen 3.7-Maxについて、比較可能なスケール数値を一切公開していませんでした。パラメータ数、アクティベーション比率、エキスパート構成など、すべてが非公開でした。3.8-Maxでは、Model Studioのモデルドキュメントとリリース投稿でアーキテクチャが明記されており、これによりキャパシティ計画とコストモデリングがはるかに推測に頼らないものになります。
オープンウェイト競争の文脈で言うと、Kimi K3は合計2.8兆、アクティブ1040億で動作します。Qwen 3.8-Maxは、両方の軸でより小規模です。
マルチモーダル:3.7-Maxにはなかった機能
Qwen 3.7-Maxはテキストモデルです。Qwen 3.8-Maxはネイティブで画像入力を受け付け、AlibabaはGemini 3.1 ProおよびGPT-5.6 Solと競合するほとんどの項目でリードする、別のマルチモーダルベンチマーク表を公開しました。
Alibabaのマルチモーダル表で際立っているスコアは、MathVisionが95.2、LogicVistaが91.9、コンピューター使用タスクにおけるOSWorld-Verifiedが86.1です。その表には比較対象となる3.7-Maxの列はありません。なぜなら、それが不可能だからです。古いモデルは画像を受け付けません。
実用的に言えば、これまで別のビジョンモデルにルーティングする必要があったワークロード(スクリーンショットの理解、文書画像、UI自動化、グラフ抽出など)を、テキストトラフィックと同じモデルIDで実行できるようになることを意味します。リリース投稿では、長文文書や動画の理解もデモンストレーションされていますが、これらは個別のAPI入力タイプではなくブログで示された機能であるため、具体的なケースについてはAPIドキュメントで確認してください。
価格:新モデルは安い、ただし今は例外
ここでアップグレードの費用計算が面白くなります。
Qwen 3.8-Maxは、100万トークンあたり入力$2 / 出力$6でリリースされ、100万コンテキスト全体で単一のフラットティアです。Qwen 3.7-Maxの定価は$2.5 / $7.5です。つまり、新しい、より高性能なモデルは、前身モデルの定価を20%下回っています。フラッグシップモデルの世代交代では、このようなことはほとんど起こりません。
しかし、一つ注意点があります。Alibabaは現在、3.7-Maxで期間限定の50%プロモーションを実施しており、これにより実効レートは$1.25 / $3.75となります。今日の価格で比較すると、古いモデルの方が新しいモデルよりも38%安いです。すべての料金は公式Model Studio価格ページで確認できます。
考慮すべき点が2つあります。
- プロモーションは終了する可能性があります。 Alibabaはこれを期間限定と明記しており、終了日は公開していません。もし$1.25 / $3.75を前提にアーキテクチャを設計した場合、あなたの予算の前提には見えない有効期限があることになります。定価で言えば、3.8-Maxの方が安いモデルです。
- 思考トークンが実際の請求額を膨らませる。 Qwen 3.8-Maxはデフォルトで
reasoning_effort: xhighに設定されており、思考トークンは出力として請求されます。リクエストあたりの実効コストは、表示されている価格を大幅に上回る可能性があります。当社のQwen 3.8価格ガイドでは、キャッシュエコノミクスとタスクあたりのコスト計算について詳しく解説しています。
どちらのMaxモデルも予算に合わない場合は、$0.4 / $1.6(現在20%オフ)のqwen3.7-plusが引き続きバリューティアとなります。Plus対Maxの比較では、Plusで十分なケースについて説明しています。
オープンウェイト:Maxクラス初の試み
Qwen-Maxクラスのモデルでオープンウェイトが提供されたことはありません。Qwen 3.7-Maxもそうではありませんでしたし、Alibabaもそれを匂わせることはありませんでした。Qwen 3.8-Maxはこのパターンを破ります。リリース投稿では、Hugging FaceとModelScopeで「来週」(おおよそ8月10日頃)ウェイトを公開すると約束されています。
本稿執筆時点(2026年8月3日)では、ウェイトはダウンロードできません。この約束は約束として受け止めてください。前例は心強いものです。Kimi K3のウェイトはリリースから11日後に提供されましたし、Alibabaはより小規模なQwenモデルで長年のオープンウェイトの実績があります。しかし、量子化されていても2.4兆パラメータのダウンロードは、マルチノードのセルフホスティングプロジェクトとなるため、ほとんどのチームにとって実用的な影響は、サードパーティがホストするアクセスと価格圧力であり、自身のラックでモデルを稼働させることではありません。
オープンウェイトがあなたの調達またはコンプライアンスの要件にとって重要であれば、それだけで3.7対3.8の問題は解決するかもしれません。一方のモデルには(おそらく)それが存在し、もう一方には決して存在しないでしょう。
変わらなかった点
アップグレードに関する投稿は過剰な宣伝をしがちなので、明確に述べる価値があります。
- コンテキストウィンドウ:両方とも100万トークン。拡張はありません。長文コンテキストのために3.7-Maxを選択していた場合、3.8-Maxは同じ100万トークンを維持し、ウィンドウ全体でフラットな価格が適用されます。
- アクセスパス:同じ。両モデルとも、OpenAI互換のエンドポイントを持つAlibaba Cloud Model Studioを通じて提供されます。切り替えはモデルIDの変更(
qwen3.7-maxからqwen3.8-maxへ)であり、移行プロジェクトではありません。3.8-MaxはさらにAnthropic互換のAPIサーフェスを追加しており、もしお使いのツールがそのプロトコルに対応している場合は、Apidogのようなクライアントで試す価値があります。 - 推論コントロール:正式対応。
reasoning_effortは、3.8-Maxで文書化されサポートされているパラメータで、enable_thinkingおよびpreserve_thinkingとともに3つのレベル(デフォルトでxhigh、medium、low)があります。3.7-Maxで暗黙的な推論動作を中心にプロンプトを調整していた場合、今は代わりに明示的な設定が可能になります。
アップグレードすべきか?3つの誠実な道筋
今すぐアップグレードすべき場合:あなたのワークロードがエージェント機能に重きを置いているか、研究主導型である場合。ターミナルベンチ(74.5から86.6)とPaperBench(64.8から93.0)の差分は、本番環境で体感できる種類の飛躍であり、さらに画像入力と低価格というボーナスも得られます。ターミナルを操作したり、技術的な作業を再現したり、スクリーンショットを処理したりするエージェントを構築しているなら、アップグレードの理由は明確です。
3.7-Maxのプロモーションを利用すべき場合:あなたのワークロードが横ばいの領域にある場合。GPQAスタイルの知識タスクは0.2ポイントしか動きませんでした。あなたのトラフィックがQ&A、要約、または一般的なチャットであり、3.7-Maxがすでに品質基準を満たしているなら、$1.25 / $3.75は、これまでいずれのMaxモデルも提供した中で最高のトークンあたりのお得な取引です。毎月プロモーションの状況を再確認するカレンダーリマインダーを設定し、フォールバック価格が3.7-Maxの定価ではなく、3.8-Maxの$2 / $6であることを認識しておいてください。
qwen3.7-plusに移行すべき場合:あなたが価格重視で、タスクが定型的なものである場合。$0.4 / $1.6で、3.8-Maxの入力と比較して5倍安く、分類、抽出、テンプレート生成のようなタスクでは、Maxクラスの能力はしばしば過剰な投資となることがあります。
コミットする前に切り替えをテストする
ベンダーのベンチマークは、たとえ内部的に一貫していても、モデルがあなたのプロンプトに対してどのように動作するかを予測するものではありません。これを解決する安価な方法は、実際のワークロードで並行して比較することです。
Apidogでは、数分でこれを設定できます。一つのコレクションをModel StudioのOpenAI互換エンドポイントに向け、次にモデルID変数のみが異なる2つの環境を作成します。一つはqwen3.7-max、もう一つはqwen3.8-maxに設定します。同じリクエストセットを両方に対して実行し、ワンクリックで環境を切り替えて、レスポンスビューアから出力、レイテンシ、トークン使用量を比較します。両モデルは同じAPIサーフェスを共有しているため、一つのコレクションで両方をカバーでき、代表的な本番プロンプトをテストシナリオとして保存し、Alibabaがアップデートをリリースしたり、プロモーション価格が変更されたりするたびに再実行できます。
これにより、「アップグレードすべきか?」というベンチマーク議論は、午後には証拠に基づく結論へと変わります。Apidogを無料でダウンロードし、本番環境の設定を変更する前に、あなた自身のトラフィックで比較を実行してみてください。
よくある質問
Qwen 3.8-MaxはQwen 3.7-Maxより安いですか?
定価でははい、100万トークンあたり$2 / $6に対し、$2.5 / $7.5です。今日の実際の価格ではいいえ、3.7-Maxの期間限定50%プロモーションにより$1.25 / $3.75となり、3.8-Maxを38%下回っています。プロモーションの終了日は公開されていません。完全なコスト内訳は、当社のQwen 3.8価格ガイドで確認できます。
qwen3.7-maxからqwen3.8-maxに切り替えるためにコードを変更する必要がありますか?
基本的な使用では、いいえ。両モデルは同じOpenAI互換のModel Studioエンドポイントを通じて提供されるため、切り替えはモデルIDの交換で済みます。3.8-Maxはデフォルトでxhighに設定されており、思考トークンは出力として請求されるため、reasoning_effortを明示的に設定することをお勧めします。画像を送信する場合、それは3.8-Max専用の機能であり、標準の画像入力メッセージ形式が必要です。
Qwen 3.7-Maxにはオープンウェイトがありますか?
いいえ、Alibabaのこれまでの経緯から、これからも公開されることはないでしょう。Qwen 3.8-Maxは、オープンウェイトが約束された初のMaxクラスモデルであり、2026年8月10日頃にHugging FaceとModelScopeで公開される予定です。8月3日現在、まだダウンロードはできません。
Qwen 3.8-Maxは現在、ClaudeやGPTより優れていますか?
項目によって異なりますし、これらがAlibaba自身の数値であることを忘れないでください。彼らの表では、3.8-Maxはターミナルベンチ2.1でOpus 4.8とFable 5を上回り、PaperBenchとIFBenchでは全てのモデルをリードしています。SWE-bench ProではFable 5(67.7対80.0)に大きく遅れをとり、HLEでは最先端のすべてのモデルに後れを取っています。まだ独立したベンチマーク数値は存在しないため、第三者による評価が出るまで最終的な判断は保留してください。