
JevはTypeSafe AIのシステムワンモデルです。プログラムの状態と型付きの質問を送信すると、散文ではなく、調整された確率を伴う決定を返します。(これはモデルとしてのJevであり、ストリーマーのFaZe JevやJEVワクチンではありません。)重みは非公開で、APIのみ提供されており、jev-latestとしてPOST https://api.typesafe.ai/v1/systemoneで利用できます。したがって、「Jevをローカルで実行する」はJevそのものを意味するものではありません。それはOpenJevに率いられた、公開モデルでそのアイデアを再現する、数日前に生まれたばかりのコミュニティプロジェクトの集まりを意味します。モデル自体が初めての方は、まずJevとは何かを読んでください。この記事では、模倣品について解説します。
これはまとめであり、現実の確認です。それぞれのREADMEが何を主張し、どの程度忠実で、どのようなハードウェアを必要とし、TypeSafe APIをテストするのと同じ方法でApidogのローカルHTTPエンドポイントを介してそれらのいずれかをテストする方法について説明します。どれも第三者によってベンチマークされたものではなく、TypeSafeによって提供されたものでもありません。
「Jevをローカルで実行する」が意味すること
TypeSafeのローンチポストでは、RLCD(Reinforcement Learning for Calibrated Decisions)でトレーニングされたモデル、3つのプリミティブ(noul、choice、score)、70msから500msの応答時間、および無料出力で入力トークン100万件あたり0.042ドルの費用について説明されています。これらはベンダーの主張であり、トレーニングレシピは未公開です。コミュニティのスレッドでは、Jevが100%合成データでトレーニングされたとされています。これは未検証の噂として扱ってください。
レシピが秘密であるため、すべての「オープンJev」は次の3つのいずれかの近道を取ります。
- 凍結されたチャットモデルからロジットを読み取る。 小さなQwenに多肢選択式の質問を投げかけ、生成をスキップし、次のトークンのロジットをオプションごとに確率に変換します。OpenJevとmini-jevがこれを行います。
- 小さなスコアラーをゼロからトレーニングする。 唯一の仕事が1回のパスでコンテキストに対するN個のオプションをスコアリングするモデルです。これがjevlikeです。
- デコーディングエンジンを変更する。 ベースモデルを維持し、制約された候補に対してすべてのフィールドを並行して評価します。これがHugging FaceのApple SiliconエンジンとvLLMプルリクエストです。
これらはいずれもRLCDを再現していません。それが正直な見出しです。
OpenJev: 1台の3090で凍結されたQwenからロジットを読み取る
OpenJevは「自宅の3090でJevのようなものを実行できるか?」と問いかけ、MITライセンスのPythonパッケージでそれに答えています。READMEは慎重に「オープンモデルでそのインターフェースパターンを再現するものであり、Jevの未公開モデルやトレーニングを再現するものではない」と述べています。
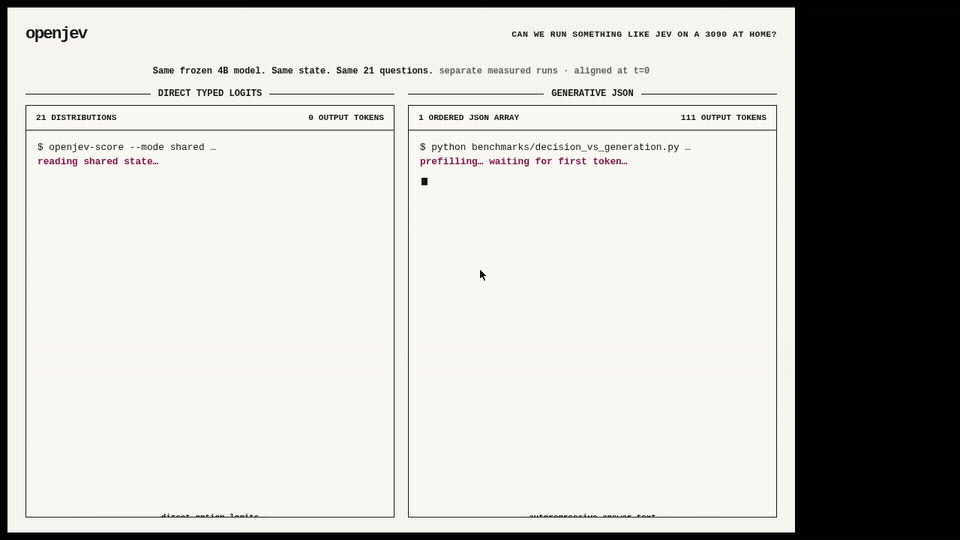
メカニズムは、宣言されたオプションのロジットを読み取る1回の順方向パスであり、回答トークンはサンプリングされません。基準とオプションは各リクエストとともに到着するため、タスクごとにファインチューニングされるものはありません。プライマリモデルはQwen3.5-4Bです。
1つのRTX 3090とQwen3.5-4BでのREADMEの報告数値:
- 直接型付きロジット:21組の確率で1.023秒。オートリグレッシブなJSON配列では5.332秒、つまり5.21倍遅い。
- 102行のTypeSafeサブセットでは、モーダル一致率が0.845。公開されているJevでは0.883。
入力はid、state、question、および{id, description}のoptions配列を含むJSONLです。出力はオプションごとの確率です。リポジトリにはHTTPサーバーはありません。openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonlを実行するか、openjev.comでWebGPUデモを試すことができます。ハードウェア:CUDAとBF16で4Bモデルを保持できるGPU。
欠けているもの:noulまたはscoreプリミティブがなく、確率はRLCDで調整された信頼度ではなく、オプションのロジットに対するソフトマックスです。
mini-jev: ローカルサーバーによる事前登録された研究
mini-jevは製品というよりも実験です。そのキャッチフレーズ:「凍結されたQwen3-4BでJevスタイルのインターフェースがどのように見えるか。JSONを生成する代わりにオプション文字のロジットを読み取る。」これはCLINC150インテント分類でQwen3-4B-Instruct-2507を実行し、文法制約付きJSON生成とオプション文字のロジット読み取りを比較します。
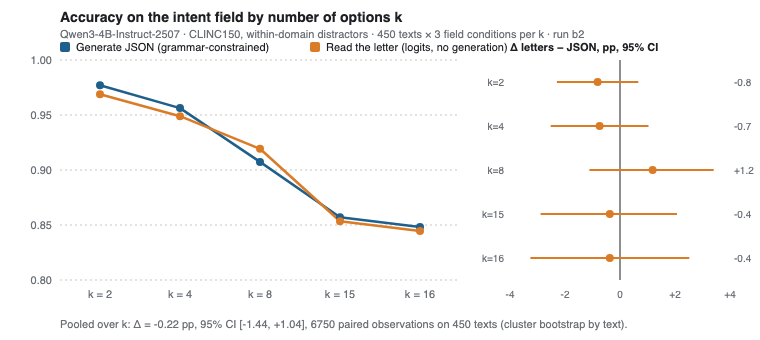
6,750組の観察から得られた結果は、JSONの精度が0.909、文字の精度が0.907で、95%信頼区間が[-1.44, +1.04]の範囲内で-0.22ポイントの差でした。文字読み取りは32トークンのテキストで約4倍高速でした。
READMEでは、その用語をTypeSafeの用語にマッピングしています。choiceとnoulは「凍結されたモデルでこの研究が測定するもので、文字読み取りとブール値として。score(順序尺度)は測定されませんでした」と説明されています。これを「用語の対応であり、彼らのモデルの再現ではない」とし、すべてのプロジェクトがコピーすべき注意書きを追加しています。「文字の共有は、調整された確率ではなく、信頼度のギャップを伴うランキングである」と。
HTTPデモが同梱されています。MINIJEV_DEVICE=mps uv run python demo/server.pyは127.0.0.1:8765をPOST /runで提供し、schemaとtextを受け取り、フィールドごとのletter、p、gap、answerを返します。Apple SiliconまたはNVIDIA GPUで約8.5GBのメモリが必要です。MITライセンスで、執筆時点で11スターです。
jevlike: ゼロから作成されたオプションスコアラー
jevlikeは「リバースエンジニアリングされたJevのようなモデル」として共有されています。READMEには「TypeSafeはその設計を公開していません。このリポジトリは、同じ入力と出力の形状を持つ独立したスターターモデルです」と書かれています。作者はさらに「Jevと同等の品質を示したり、TypeSafeのプライベートなトレーニング方法を再現したりしたわけではない」と付け加えています。
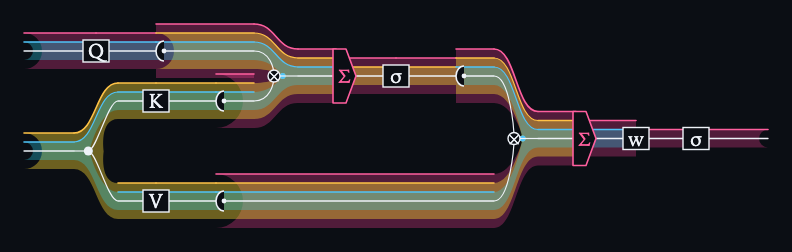
デザインは小さいです。各オプションは、コンテキストトークンに注意を払うクエリベクトルを受け取ります。共有ドット積が各ペアをスコアリングし、ソフトマックスがスコアを確率に変換します。デフォルトのエンコーダーはゼロから学習されたバイト埋め込みで、オプションで凍結されたHugging Faceエンコーダーも使用できます。
報告された数値:合成メニューで約98%、凍結されたQwen2.5-0.5Bエンコーダーを使用した場合のWikispeediaでは8%シャッフル制御に対して26%、「400トークンを強制的に書き込む小さなデコーダーよりも約100倍高速」なワンパス。CPU、MPS、またはCUDAで動作します。MITライセンスで、764スターです。
忠実度はグループ内で最も低いです。独自のラベルでトレーニングするため、これは自分で構築した分類器であり、任意の基準を渡せる決定モデルではありません。noulもscoreもなく、キャリブレーションの主張も、HTTPサーバーもありません。
並列制約デコーディング:Apple Siliconエンジン
Hugging Face Spaceのparallel-constrained-decodingは、「Typesafe.ai Jevのオープンソース代替品」として流通していますが、そのREADMEにはJev、TypeSafe、RLCDは一度も言及されていません。そのタイトルは「Parallel Constrained Decoding for Apple Silicon」であり、mlx-community/Qwen2.5-1.5B-Instruct-4bitを対象とした構造化抽出のためのMLX推論エンジンで、任意のmlx-lmデコーダーを入れ替えることができます。
その手法:コンテキストをKVキャッシュに一度プリフィルし、それをすべてのスキーマフィールドにブロードキャストし、フィールドごとに有効な候補トークンIDのみを評価し、そのセットに対してソフトマックスを行い、コード内でJSONを組み立てます。READMEはM4 Maxでの結果を報告しています。4フィールドの不正トリアージで、オートリグレッシブでは420msに対し並列では75ms(5.6倍)、28フィールドのサポートトリアージでは1,900msに対し270ms(7.0倍)でした。自由テキストをサンプリングしないことから、100%のスキーマ妥当性を主張しています。
uvicornを介してポート8000でHTTPを提供し、parsed_jsonとフィールドごとの信頼度を含むfield_telemetryを返します。要件:M1以降のMac、macOS 14+。Apache 2.0。精度に関する数値はなく、レイテンシーのみです。「キャリブレーション済み」とは、トレーニングされたキャリブレーションではなく、候補に対する正確なソフトマックスを意味します。
vLLM PR 57250: DiffusionGemmaのJevライクモード
9月16日にオープンし、まだオープンのままのvLLMプルリクエスト #57250は、DiffusionGemmaを作者が「キャリブレーションされた多肢選択マシン」と呼ぶものに変えます。これは、シングルデザイントークンの回答スロットを持つシードされたキャンバスで、ステップ制限で読み取られ、logprobsとエントロピーから信頼度を得ます。新しいvllm_xargsフィールドにはdiffusion_seed_canvas、diffusion_max_steps、diffusion_read_onlyが含まれ、例のstructured_server.pyはスキーマをキャンバスに変換します。
このPRでは、シングルキャンバス読み取りで1秒あたり8.7リクエスト、32並列で54リクエスト、言語分類コーパスで約90%の精度が報告されています。レビュアーは、レースコンディションテストの欠如と無制限のスレッド生成をブロック要因として指摘しました。マージされるまでは、デプロイするものではなく、読むべき設計です。
それぞれの忠実度は?
| Project | Base | Primitives | Calibration | HTTP server | Hardware |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B, frozen | choice | softmax over option logits | No (CLI + browser demo) | RTX 3090 class, CUDA |
| mini-jev | Qwen3-4B-Instruct, frozen | choice, noul | ranking with a gap | Yes, port 8765 | 8.5 GB memory, MPS or CUDA |
| jevlike | encoder you train | choice | none claimed | No | CPU, MPS, or CUDA |
| MLX engine | Qwen2.5-1.5B-Instruct-4bit | schema fields | softmax over candidates | Yes, port 8000 | Apple Silicon, macOS 14+ |
| vLLM PR | DiffusionGemma | yes/no, choice, scale | logprobs plus entropy | Yes, OpenAI-compatible | vLLM-class GPU, unmerged |
各行は、ロジットを読み取る凍結モデルまたは自己学習モデルです。これにより、Jevの形状、つまり型付きの回答、オプションごとの確率、1回の順方向パスが得られます。しかし、RLCDがそれらの確率を正直なものにするというJevの核心的な主張は得られません。OpenJevの0.845対0.883は、実際のモデルに対する唯一の比較であり、作者自身の評価です。セットアップは、Kimi K3をローカルで実行するためのガイドに合致しています。重み、GPUまたはMシリーズMac、ローカルポートが必要です。
Apidogで本物のJev APIのようにそれらのいずれかをテストする
ローカルでの再現の目的は、統合を書き換えることなく実際のAPIと交換することなので、テストでは同じボディを両方に送信する必要があります。これらのプロジェクトのどれもJevの{model, state, questions}スキーマをネイティブに解釈しません。実行するものの前に薄いアダプターを置いてください。Jevのボディを受け入れ、ツールを呼び出し、choice、probabilities、confidenceキーを持つ{"answers": {...}}を返す40行のFastAPIアプリです。これでApidogは一つの契約を見ることになります。
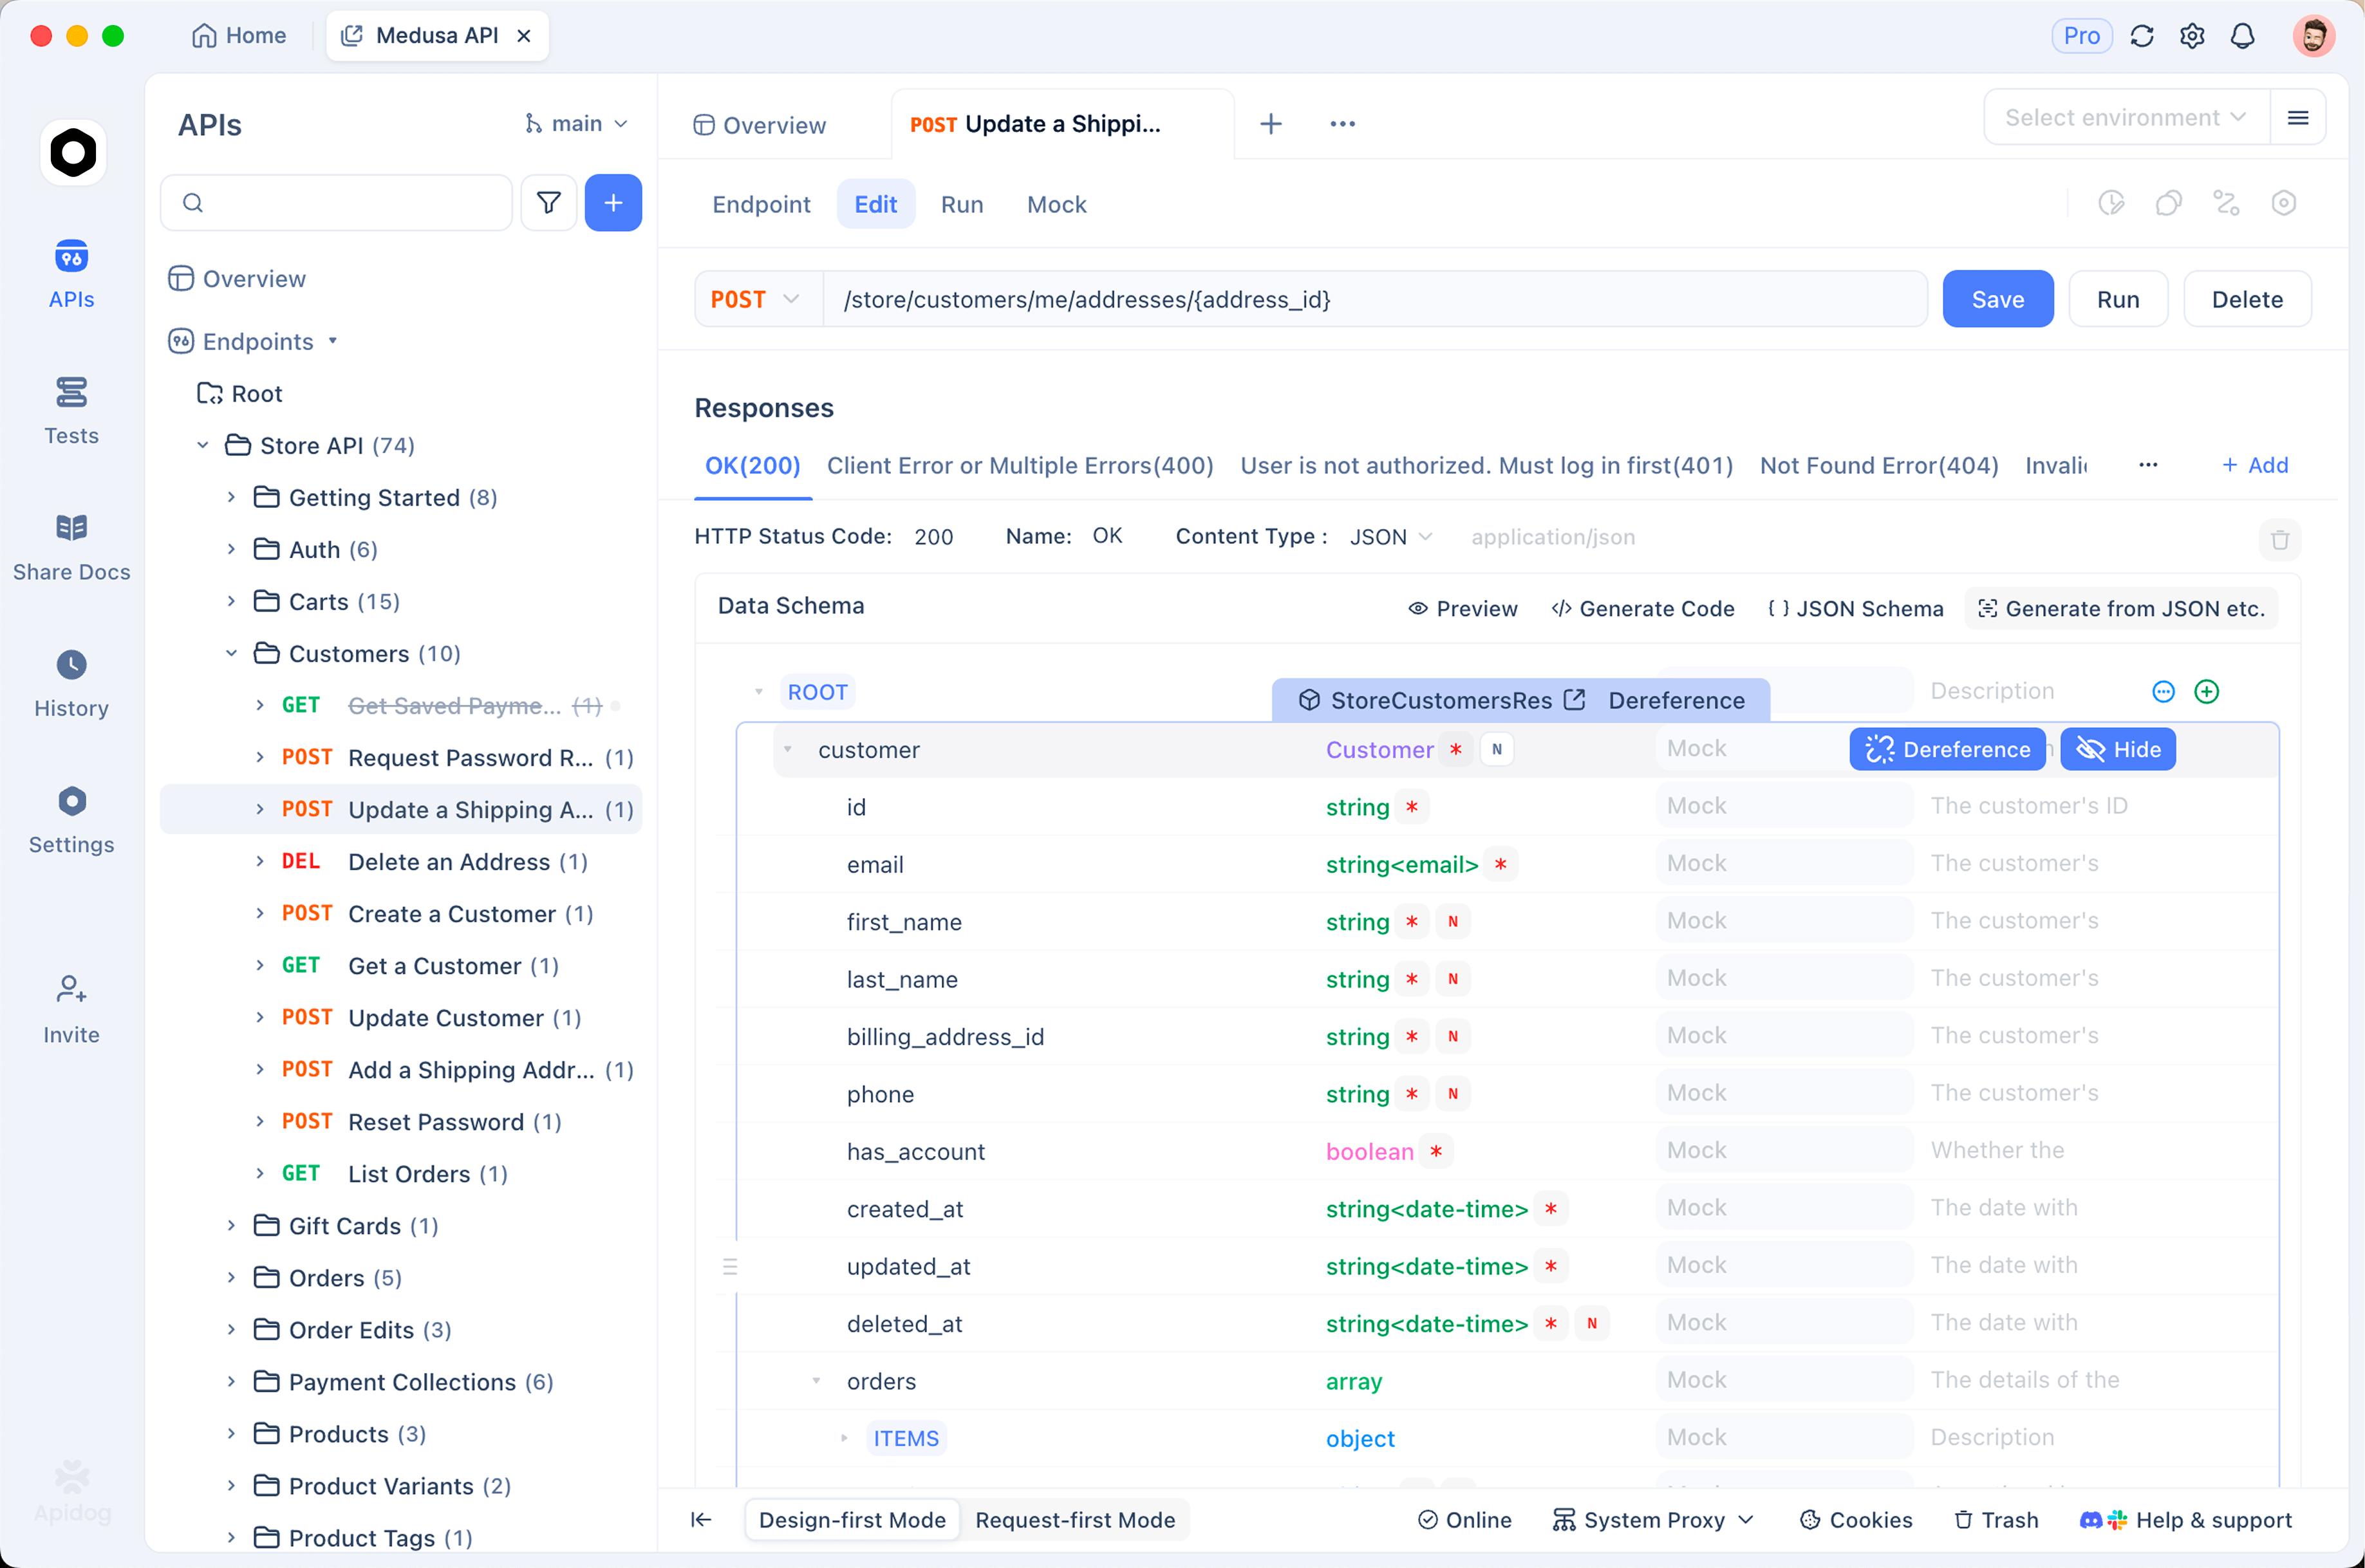
2つの環境、1つのリクエストセット。 BASE_URL = http://localhost:8765とキーなしでLocal reproductionを作成し、BASE_URL = https://api.typesafe.aiとローカルフィールドにTYPESAFE_API_KEYを設定してチームメンバーに同期されないようにします(スコープルールはこちら)。すべてのリクエストは{{BASE_URL}}/v1/systemoneとBearer {{TYPESAFE_API_KEY}}を使用します。ローカルサーバーはヘッダーを無視します。
Jevボディを送信します。 jev-latestに送るのと同じ状態と質問を含むPOST {{BASE_URL}}/v1/systemoneを使用します。
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
確率フィールドをアサートします。 後処理アサーションを追加します。answers.department.choiceがbillingに等しいこと、answers.department.probabilities.billingが0.7より大きいこと、answers.wants_refund.noulが0.8より大きいことを確認します。環境のドロップダウンを切り替えて、同じシナリオをTypeSafeに対して実行します。2つの実行間のギャップが、どのREADMEテーブルよりも価値のある忠実度を示す数値となります。
ローカル実行をモックとして保存し、フロントエンドが安定したanswersオブジェクト(GPU時間を一切使用しない)に対して構築されるようにします。Apidogをダウンロードして設定してください。無料プランは4ユーザーまで対応しています。チャットモデルについても同様のパターンがローカルLLMをAPIとしてテストするで説明されています。
よくある質問
OpenJevはJevと同じですか?
いいえ。OpenJevは凍結されたQwen3.5-4Bからオプションのロジットを読み取り、その旨をREADMEに記載しています。JevはTypeSafeがRLCDでトレーニングしたクローズドモデルです。OpenJevは、作者自身の評価によると、102行のサブセットにおいてJevとのモーダル一致率が0.845であると報告しています。
最初にどれを試すべきですか?
Macをお使いで今すぐHTTPエンドポイントが必要な場合はmini-jev、NVIDIA GPUをお持ちでJevに最も近い公開比較を求める場合はOpenJevです。jevlikeは、トレーニング用のラベル付きデータがある場合にのみ選択してください。
凍結モデルから調整済み確率を得られますか?
ロジットを読み取るだけではできません。mini-jevのREADMEが述べているように、オプションのトークンに対するソフトマックスは、ギャップのあるランキングです。キャリブレーションにはトレーニング、またはラベル付けされたセットに対する温度スケーリングのような事後ステップが必要ですが、これらはいずれも提供されていません。
これらのいずれかを実行する方がTypeSafeに支払うよりも安価ですか?
出力無料、入力トークン100万件あたり0.042ドルという価格で、Jevはすでに最も安価なLLM APIプロバイダーの最下層に位置しています。GPU時間を考慮すると、ローカル実行はコストではなく、プライバシーとオフライン使用の面で優れています。
まとめ
OpenJev、mini-jev、jevlike、MLXエンジン、そしてvLLM PRはすべて、あるアイデアを証明しています。それは、決定には生成されたテキストが不要であり、1回のパスでロジットを読み取る方が高速であるということです。しかし、どれもそれらが調整されていることを証明しておらず、Jevそのものでもありません。Jevの形をしたアダプターの背後で1つを実行し、TypeSafeを指す2番目の環境を維持し、アサーションにその差を判断させましょう。