OpenAIとAnthropicは2026年7月以降、API価格を大幅に引き下げており、その値下げは両社の価格ページに掲載されています。GPT-5.6 Lunaは一晩で80%下落し、GPT-6.1 SolはGPT-5.6 Solの$5/$30に対して$2/$10でリストされ、Claude Opus 5.5はキャッシュ読み取りを60%削減し、Claude Haiku 5.5はHaiku 4.5の10分の1でリストされています。あなたのコストモデル、ルーティングルール、予算アラートが9月より前のものであれば、それらは今や間違っています——ほとんどはあなたにとって有利な方向に。以下では、検証済みの変更前/変更後の価格、リクエストごとの計算、依然として請求額を膨らませる落とし穴、そしてコーディングエージェントにトークン予算をテストへと変えさせる方法を扱います。
きっかけはMax WoolfのエッセイOpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?とそのHacker Newsスレッドです。市場側については2026年9月のAIモデル価格戦争で扱いました。本記事は、チームが何を変えるべきかについてです。
検証済みの変更前/変更後の価格
100万トークンあたりの米ドル(入力 / 出力 / キャッシュ入力)、標準ティア、長コンテキスト閾値未満。OpenAIの行は2026-10-26に読んだOpenAI API pricing pageによるもので、「変更前」の価格はそのページのアーカイブコピーからのものです。Anthropicの行はClaude pricing docsによるもので、旧モデルと新モデルが並べて掲載されています。
| Model change | Before | After | Change | When |
|---|---|---|---|---|
| GPT-5.6 Luna (price cut) | $1 / $6 / $0.10 | $0.20 / $1.20 / $0.02 | -80% across the board | 2026-07-30 |
| GPT-5.6 Terra (price cut) | $2.50 / $15 / $0.25 | $2 / $12 / $0.20 | -20% | 2026-07-30 |
| GPT-5.6 Sol (promotional) | $5 / $30 / $0.50 | $4 / $20 / $0.40 | -20% in, -33% out | 2026-08-21 |
| GPT-5.6 Sol list to GPT-6.1 Sol | $5 / $30 / $0.50 | $2 / $10 / $0.10 | -60% in, -67% out, -80% cache | 2026-09-29 |
| GPT-5.6 Luna to GPT-6 Luna | $0.20 / $1.20 / $0.02 | $0.10 / $0.50 / $0.01 | -50% in, -58% out | 2026-09-22 |
| Claude Opus 5 to Opus 5.5 | $5 / $25 / $0.50 | $4 / $20 / $0.20 | -20% in/out, -60% cache | 2026-09-22 |
| Claude Fable 5 to Fable 5.1 | $10 / $50 / $1 | $10 / $50 / $0.25 | -75% cache only | Sept 2026 |
| Claude Sonnet 5 to Sonnet 5.5 | $2 / $10 / $0.20 | $2 / $10 / $0.10 | -50% cache only | Sept-Oct 2026 |
| Claude Haiku 4.5 to Haiku 5.5 | $1 / $5 / $0.10 | $0.10 / $0.50 / $0.01 | -90% (prompts up to 100K) | Oct 2026 |
同一モデルでの値下げはGPT-5.6の行のみで、残りはより安価な後継モデルであるため、品質とトークン数は異なります。Sonnet 5の$2/$10というローンチ価格は恒久的なものとなり、ドキュメントには$3/$15への予定された移行は「行われない」と記されています。GPT-5.6 Solの割引はプロモーションで、「少なくとも2026年11月21日までは利用可能」です。値下げ前のLunaとTerraの価格は2026年7月29日のアーカイブされたOpenAI価格ページにあります。
モデル別の詳細:GPT-5.6の値下げ、GPT-6 Solの価格、Claude Haiku 5.5の価格。
なぜ価格が下がったのか
唯一の一次情報による理由はAnthropicから出ています:Claude Opus 5.5の発表では、このモデルは「Opus 5よりも提供に必要なコンピュートが少なく、その価格はそれを反映している」と述べ、典型的なワークロードで40%低いコストを見積もっています。OpenAIのページには理由がありません。残りは意見です:
- 競争、低いスイッチングコスト。Woolfは、モデルは今や近い代替物になっていると主張します:切り替えはハーネス内のトグルか、ルーターを通した新しいモデル文字列です。多くのプロバイダーが提供するオープンウェイトモデル(彼は10月24日にOpenRouterで1つのDeepSeek Flashバリアントに対して29社を数えた)が下限を設定します。
- 報復の応酬。値下げは両社の間で交互に行われ、両社は9月22日に安価なフラッグシップを投入しました。
- IPOのタイミング。Woolfは両社がIPOに近づいていると噂されていると指摘し、そのタイミングを奇妙に感じています。それは動機についての憶測です。
- 効率性。多くのHNコメンターはより単純な説明をしています:より良いキャッシュ、より小さなモデル、より安価な提供。
WoolfはまたVercel AI Gatewayのデータを引用しています:トークンあたりのコストは2026年4月の水準の43.3%に下がった一方で、総支出は増加しました。トークンが安くなっても、その使い方を変えない限り請求額はほとんど減りません。
値下げが変えるもの:リクエストごとの計算例
キャッシュ多用型のエージェントの1ターン
コーディングエージェントの1ターンを取り上げます:キャッシュから読み取る会話が100,000トークン、新しい入力トークンが2,000、出力トークンが1,000。
| Model | Cache reads | New input | Output | Turn cost |
|---|---|---|---|---|
| GPT-5.6 Sol (list) | $0.050 | $0.010 | $0.030 | $0.090 |
| GPT-5.6 Sol (promo) | $0.040 | $0.008 | $0.020 | $0.068 |
| GPT-6.1 Sol | $0.010 | $0.004 | $0.010 | $0.024 |
| Claude Opus 5 | $0.050 | $0.010 | $0.025 | $0.085 |
| Claude Opus 5.5 | $0.020 | $0.008 | $0.020 | $0.048 |
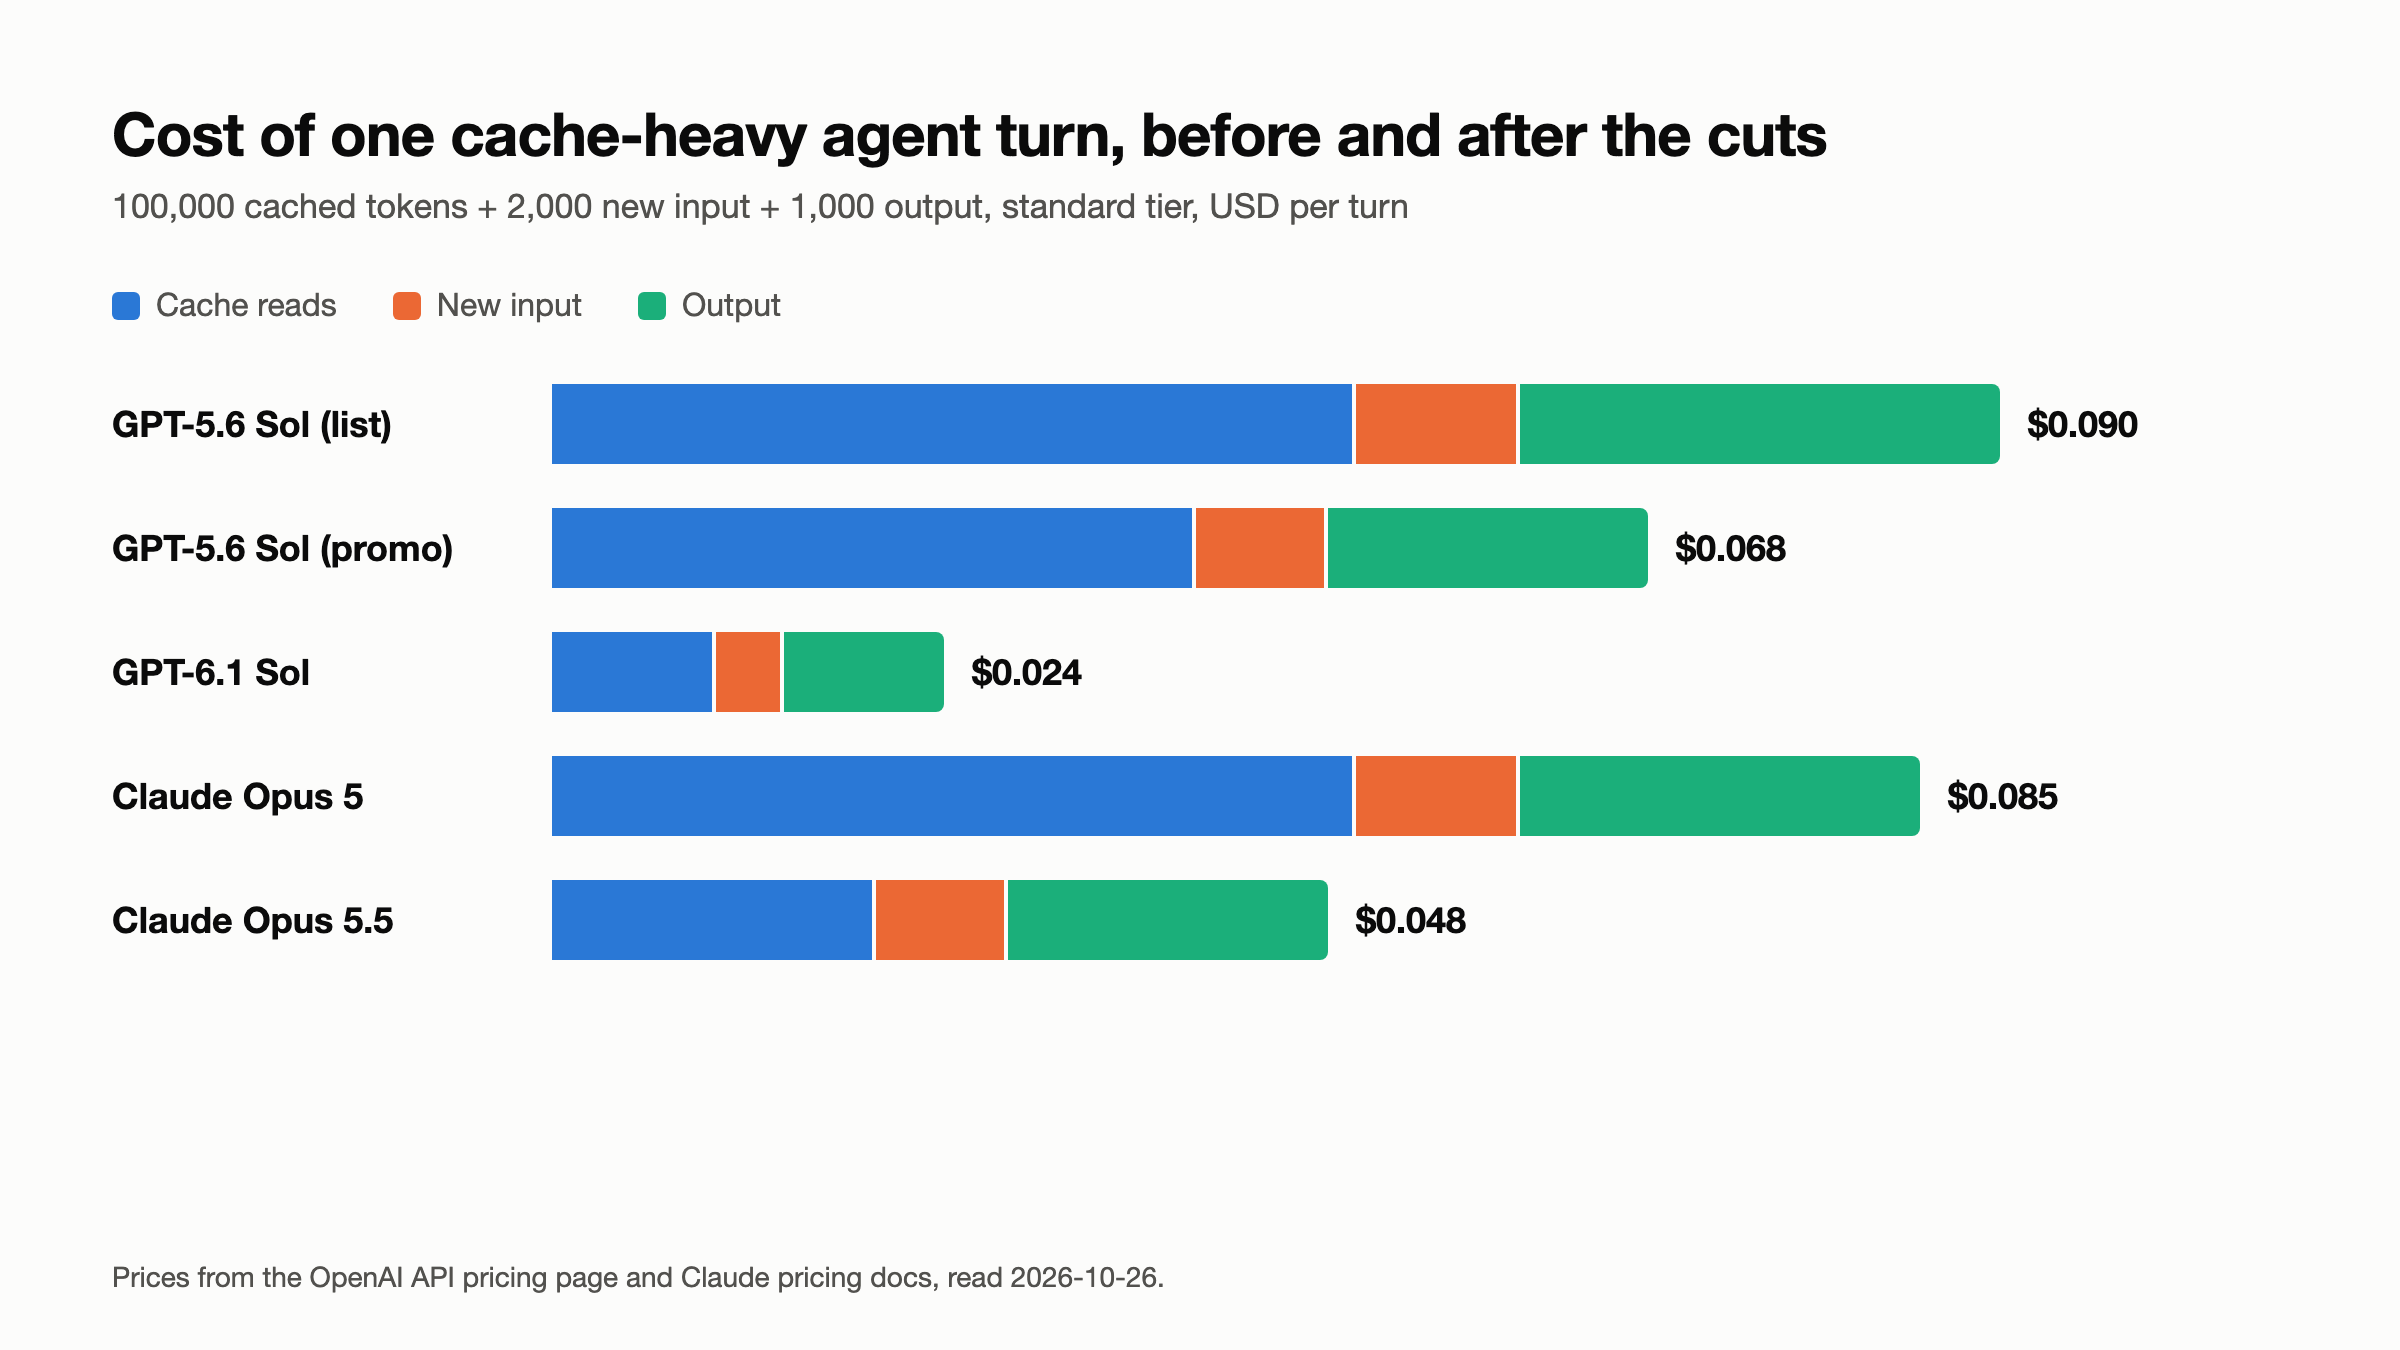
このターンではGPT-6.1 SolはGPT-5.6 Solのリスト価格より73%低く、Opus 5.5はOpus 5より44%低く、Anthropicの40%に近い数字です。旧モデルではキャッシュ読み取りがターンの半分以上を占めていたため、エージェントにとって重要な数字は今やキャッシュ読み取り価格です。だからこそFable 5.1のキャッシュのみの削減は、変わらない$10/$50が示唆する以上に重要です。私たちのOpus 5.5キャッシュの損益分岐点計算とGPT-6プロンプトキャッシュガイドをご覧ください。
変えるべきこと:モデルはリストの入力価格ではなく、実際のキャッシュヒット率での1ターンあたりのコストでランク付けしましょう。
高ボリュームの分類器
次にルーターまたは分類器:1日100万リクエスト、各1,500入力トークンと200出力トークン、キャッシュなし。
- 7月30日以前のGPT-5.6 Luna:15億入力×$1 + 2億出力×$6 = $2,700/日
- GPT-6 Luna:$150 + $100 = $250/日
- Claude Haiku 4.5:$1,500 + $1,000 = $2,500/日
- Claude Haiku 5.5:$150 + $100 = $250/日
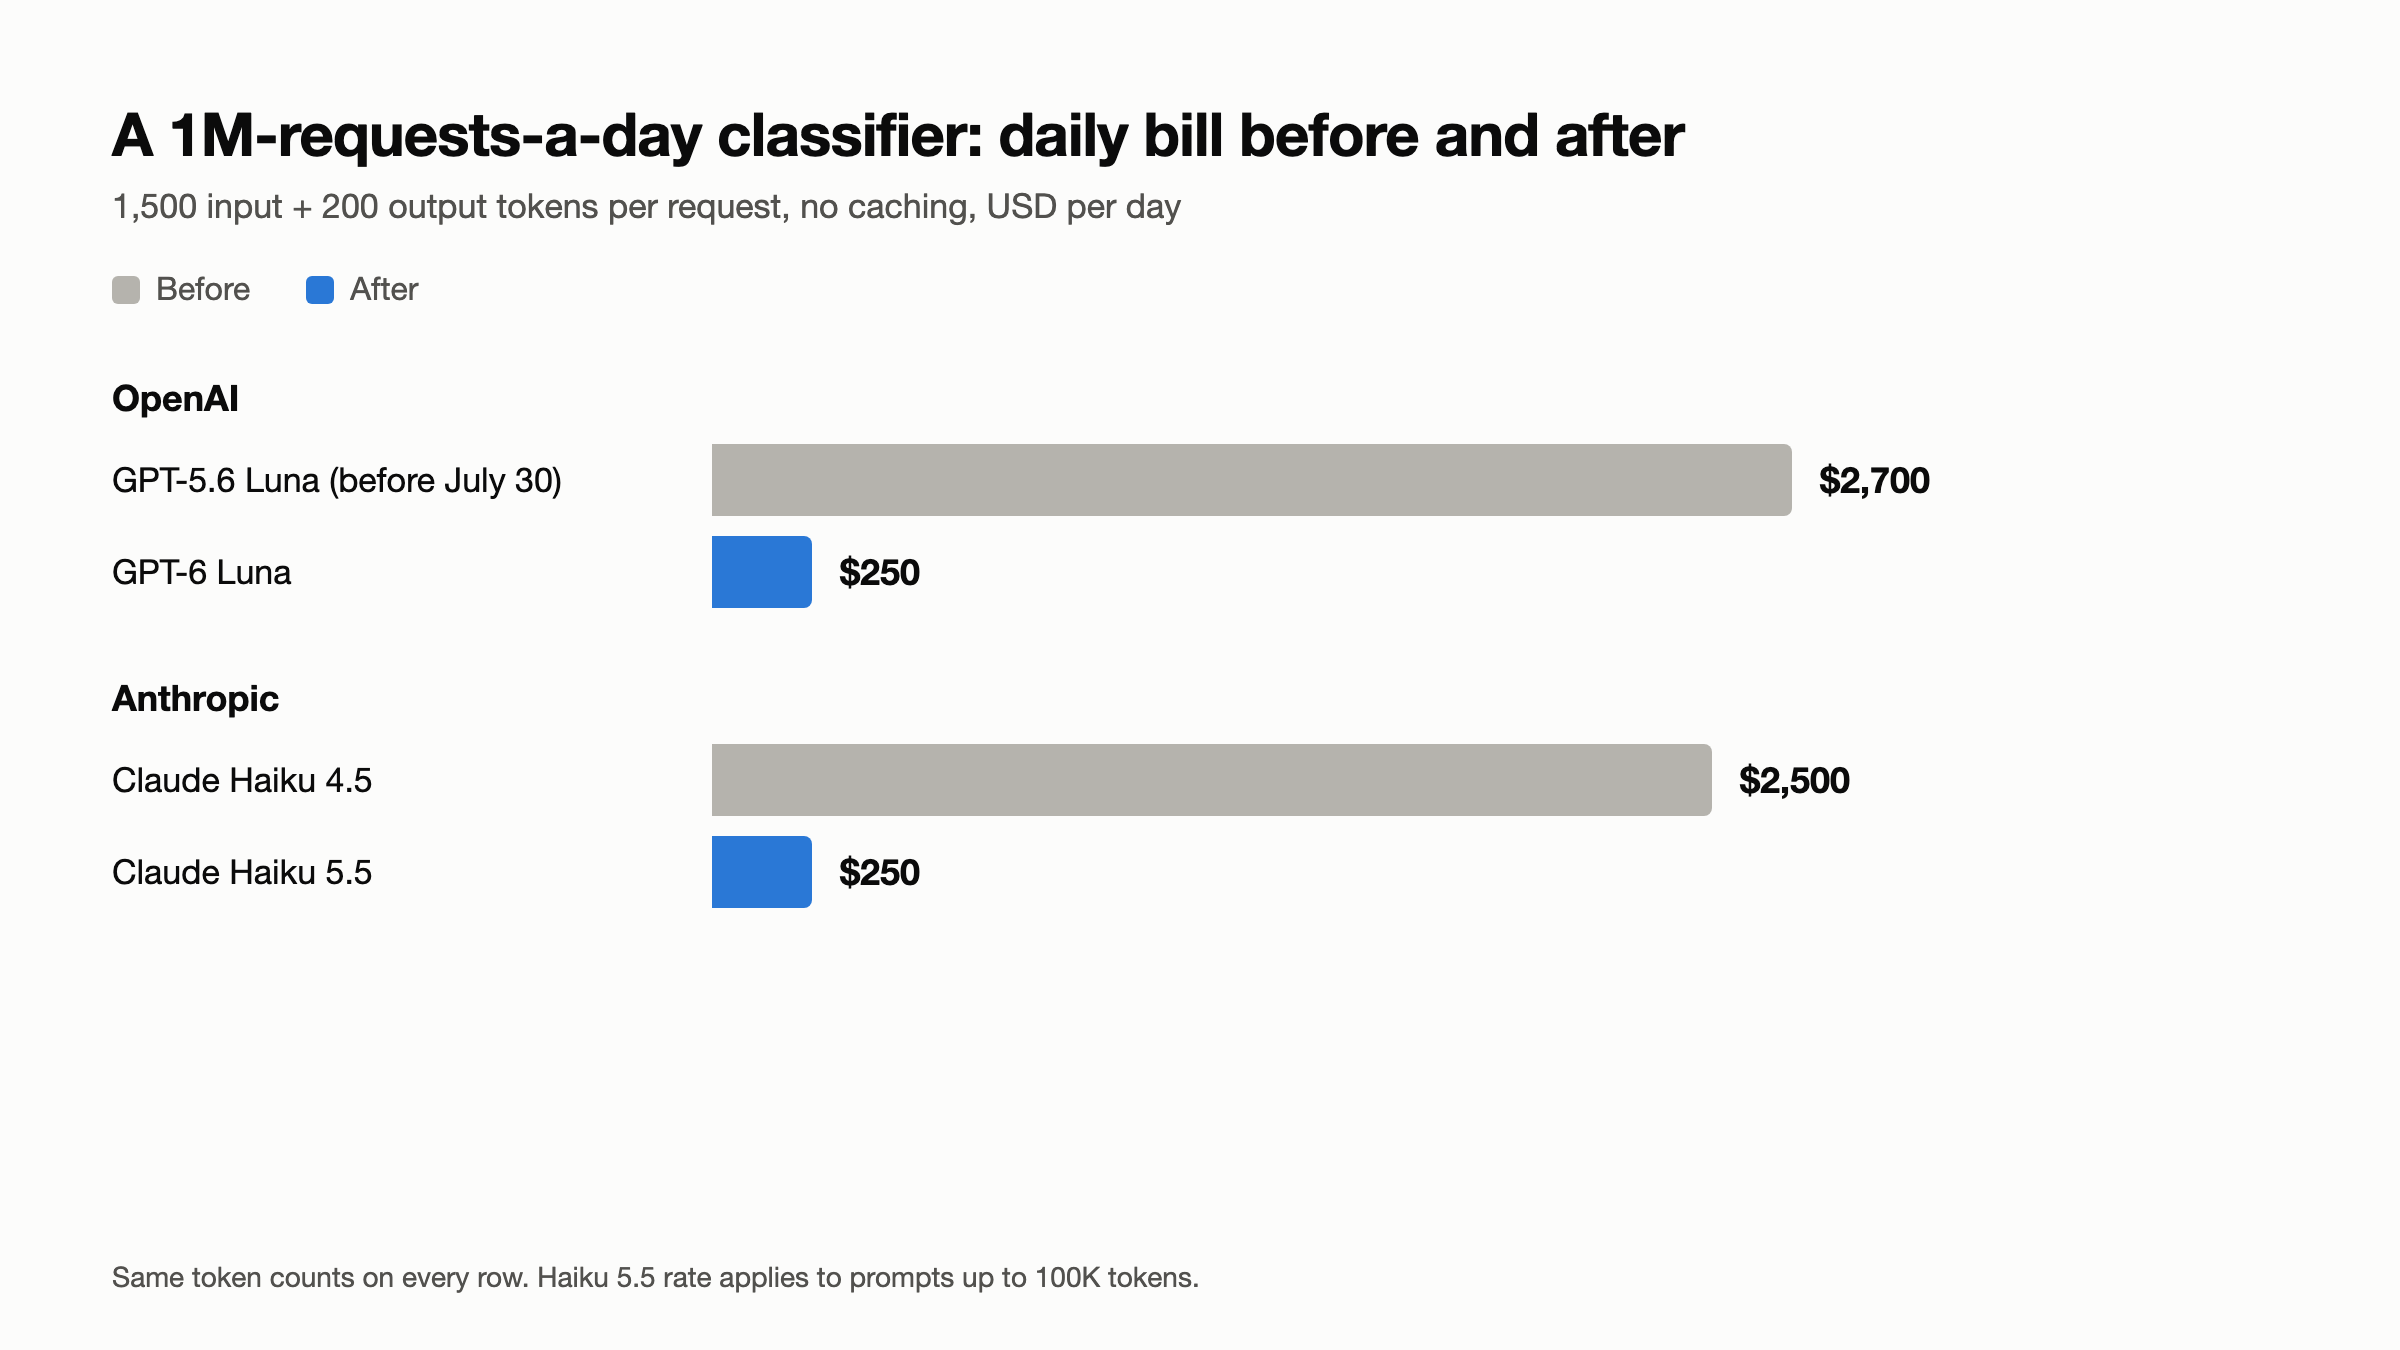
変えるべきこと:小規模モデル向けにプロンプトを削るのをやめ、ミッドティアのトラフィックが今や小型モデルに収まるかどうかをテストしましょう。まず評価セットを実行してください:トークンあたりの価格はあなたのデータでの精度について何も語りません。
バッチ:金額は小さく、割合は同じ
両社は依然として非同期処理に50%の割引を適用しています:AnthropicのBatch APIは入力と出力を半額にし、OpenAIのFlex/Batchティアはキャッシュ入力も含めてすべてを半額にします(GPT-6.1 Sol:$1 / $5 / $0.05)。上記の分類器では、バッチは今や1日$125を節約します。小規模なワークロードでは、追加のキューイングインフラを正当化できないかもしれません。大規模なものでは、OpenAI Batch APIガイドが依然として当てはまります。
依然として請求額を膨らませる落とし穴
キャッシュ書き込みは入力より高コスト。Anthropicは5分間の書き込みに基本入力の1.25倍、1時間の書き込みに2倍を請求します。OpenAIの表にも書き込み列があります:30分で1.25倍、12時間で2.5倍(GPT-6.1 Sol:$2入力に対して$2.50と$5)。書き込まれて一度も読まれないプレフィックスは、キャッシュなしより25%から150%高くつきます。読み取りが入力の5%であれば、短い書き込みは1回の読み取りで元が取れ、長いものは2回で取れます。
長コンテキスト乗数。GPT-6.1 SolとGPT-6 Lunaでは、OpenAIのモデルページによると、272K入力トークンを超えるプロンプトは「リクエスト全体に対して」入力とキャッシュレートが2倍、出力が1.5倍で価格設定されます。Claude Haiku 5.5は100,000プロンプトトークンを超えると$0.10/$0.50から$0.50/$2.50に跳ね上がり、Anthropicはキャッシュの読み取りと書き込みをその閾値にカウントします。その他のClaude 4.6以降のモデルは、1Mウィンドウ全体を標準レートで請求します。ホットパス上のたった1つの過大なプロンプトが節約を帳消しにしかねません。
推論トークンは出力トークンです。OpenAIのreasoning guideには、推論トークンは「出力トークンとして請求される」と記され、usage.output_tokens_details.reasoning_tokensに表示されます。レスポンスは可視出力の前にmax_output_tokensに達することがあり、それでも支払いは発生します。Anthropicのthinking cost docsは、可視サマリーではなく思考全体を請求し、usage.output_tokens_details.thinking_tokensに報告します。出力はすべての行で高価な側であるため、エフォート設定はモデル選択よりも請求額を動かす可能性があります。
地域別の上乗せ。OpenAIは2026年3月5日以降にリリースされたモデルに対して地域処理(データレジデンシー)で10%、FedRAMPエンドポイントで10%を追加します。Anthropicはinference_geo: "us"を設定すると1.1倍の乗数を適用し、BedrockとGoogle Cloud上の地域エンドポイントはグローバルなものより10%のプレミアムがかかります。
トークナイザーとプロモ。Anthropicのドキュメントによると、Claude 4.7以降のモデルは、同じテキストに対してSonnet 4.6以前よりも約30%多くのトークンを生成するトークナイザーを使用するため、同じテキストではHaiku 4.5からHaiku 5.5への移行は90%ではなく87%に近い結果となります。そしてプロモ価格を維持するためにgpt-5.6-solを固定したなら、2026年11月21日をカレンダーに入れておきましょう。
Apidog CLIでコーディングエージェントにLLM呼び出しへのコストアサーションを設定させる
価格は毎月変わり、トークン数は誰かがプロンプトを編集したりエフォート設定を上げたりするたびに変わります。持続可能な修正は、呼び出しが予算を超えたときに失敗するテストを、すべてのプルリクエストで実行することです。Claude Code、Codex、CursorにApidog CLIでそれを書かせましょう。
CLIとエージェントスキルを一度インストールします:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
そしてエージェントに1つのプロンプトを与えます:
In Apidog project <id>, create an environment "openai" with base URL https://api.openai.com
and an endpoint POST /v1/responses. Add a test case that sends our support-ticket summary
prompt to gpt-6.1-sol and asserts: HTTP 200, usage.output_tokens at most 1500 and
usage.output_tokens_details.reasoning_tokens at most 1000. Use an API key variable,
not a literal. Run it and summarize any failures.
エージェントは各ペイロードスキーマを読み、書き込む前に検証し、ケースを実行します:
apidog environment create openai --project <id> --base-url https://api.openai.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog test-case category --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
予算はケースのpostProcessors内にJSONPathへのアサーションとして存在し、test-case-createスキーマのisAtMostやisAtLeastといった比較を使用します:
{
  "type": "assertion",
  "defaultEnable": true,
  "enable": true,
  "data": {
    "name": "output tokens under budget",
    "subject": "responseJson",
    "comparison": "isAtMost",
    "value": "1500",
    "path": "$.usage.output_tokens"
  }
}
Claudeの場合は、エンドポイントを/v1/messagesに向け、$.usage.output_tokensと$.usage.output_tokens_details.thinking_tokensに対してアサートします。次に、同じ呼び出しを2回行い、2回目のレスポンスの$.usage.input_tokens_details.cached_tokens(OpenAI)または$.usage.cache_read_input_tokens(Claude)がゼロより大きいことをアサートするテストシナリオを依頼します:誰かがキャッシュされたプレフィックスを壊すと、請求書が届く前にビルドが失敗します。-dで代表的なプロンプトを渡し、CIシークレットからAPIキーを--env-varで渡し、パイプラインで-r junitを使用します(CI/CDガイド)。Claude CodeでのApidog CLIがエージェントの設定を扱っています。
FAQ
OpenAIとAnthropicは本当に価格を80%引き下げたのですか?1つのモデルについては、はい:GPT-5.6 Lunaは2026年7月30日に$1/$6から$0.20/$1.20になりました。その他のほとんどの下落は、より安価な後継モデルによるものです。
値下げはClaude CodeとCodexのサブスクリプションに適用されますか?価格ページはAPIを対象としています。Woolfは節約はサブスクリプションのハーネスにも及ぶと述べていますが、OpenAIがCodexの$200ティアの使用許容量を半減したとも報告しているので、プランの制限を確認してください。
GPT-5.6 Solの価格は恒久的ですか?いいえ。プロモーションで、少なくとも2026年11月21日までです。いずれにせよGPT-6.1 Solの方が安価です。
今、エージェントの請求額を削減する最も安価な方法は?キャッシュヒット率を上げ、推論エフォートを下げることです。キャッシュ読み取りは長いセッションを支配し、推論は出力レートで請求されます。
次のステップ
最も頻繁に使う3つのLLM呼び出しについてコスト計算を再実行し、それぞれにエージェントがトークン予算テストを追加するようにしましょう。Apidogをダウンロードして始めましょう。