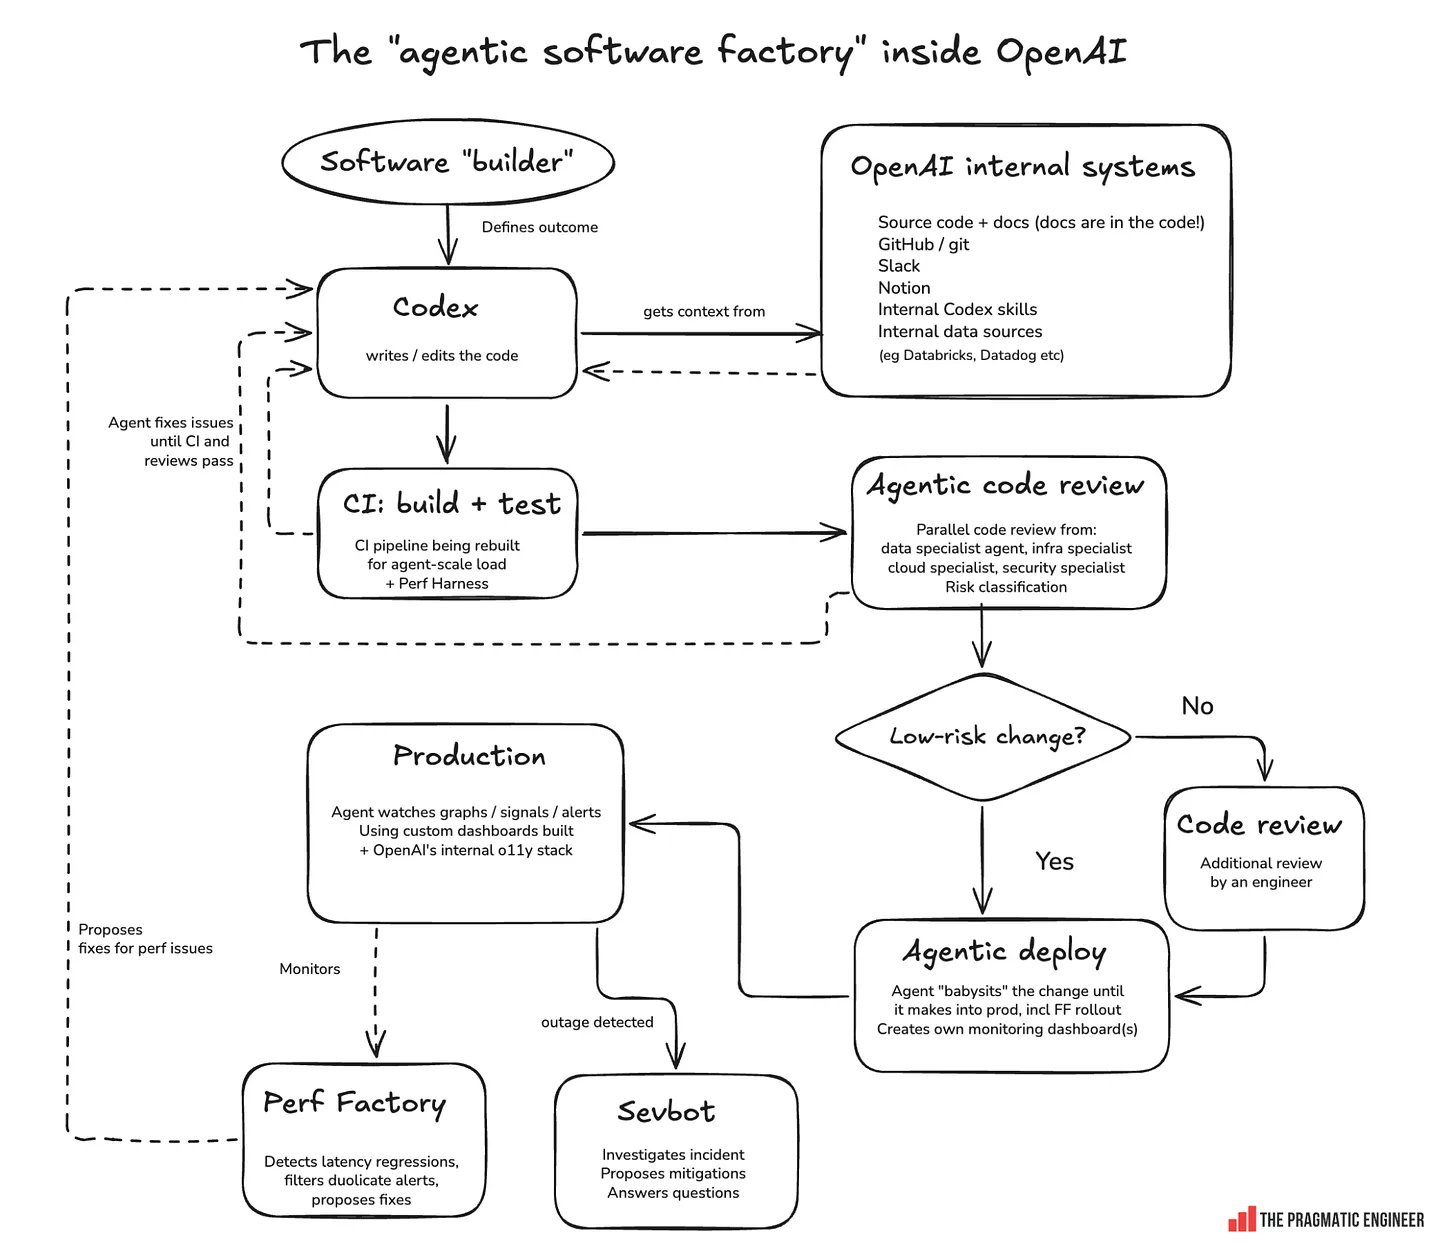
OpenAIの社内エンジニアリングパイプラインの図が今週Xでセミバズりました。それは「ソフトウェアビルダーが成果を定義する」から始まり、本番環境のグラフを監視し、自身でインシデントレポートを作成するエージェントに至るまで、10個のボックスを示していました。情報源はGergely Oroszのニュースレター「The Pragmatic Engineer」に掲載された「OpenAIのエージェント型ソフトウェアファクトリー」という記事であり、その図自体はXで急速に拡散しました。
ほとんどの反応は、重要な詳細を見落としていました。それら10個のボックスのいくつかは、今日インストールできるCodex製品ではなく、OpenAIの社内エンジニアリング設定を説明している点です。この二つを混同することは、この図に関する議論で最もよく見られる間違いです。この記事では、ボックスごとに説明し、外部チームが実際に模倣できる唯一のステージであるCIについて詳しく述べていきます。
button
10のステージ、順番に
この図は左から右へループとして読めます。人間が目標を設定し、エージェントがコードを書き、自動化されたゲートがそれをチェックし、エージェントはそれらのゲートが通過するまで反復を続けます。各ステージについて、社内専用か製品化済みかを明記した全シーケンスは以下の通りです。
| # | ステージ | 何が起こるか | 社内専用かCodexで製品化済みか |
|---|---|---|---|
| 1 | ソフトウェアビルダー | エンジニアまたはPMが成果を定義する | 人間のステップであり、ソフトウェアではない |
| 2 | Codexがコードを書き/編集する | ソースコード、ドキュメント、GitHub、Slack、Notion、社内スキル、DatabricksやDatadogのようなデータシステムからコンテキストを引き出す | 製品化されたCodexはコードを書くが、社内コンテキストグラフ(Slack、Notion、社内データ)は社内専用である |
| 3 | CI: ビルド + テスト | エージェント規模の負荷に対応するために再構築されているパイプラインと、「Perf Harness」 | 製品化済み(あなた自身のCI)。OpenAIの具体的なスケーリング作業は社内専用である |
| 4 | エージェント型コードレビュー | データ、インフラ、クラウド、セキュリティの専門エージェントによる並行レビューと、リスク分類 | 社内専用 |
| 5 | 低リスク決定 | 低リスクの変更は進行し、高リスクの変更は追加の人間エンジニアによるレビューを受ける | 社内専用 |
| 6 | エージェント型デプロイ | エージェントが、機能フラグのロールアウトを含め、変更を本番環境に「監視し」、独自のダッシュボードを構築する | 社内専用 |
| 7 | 本番環境の監視 | エージェントがOpenAIの社内可観測性スタック上でグラフ、シグナル、アラートを監視する | 社内専用 |
| 8 | 障害検出 -> Sevbot | インシデントを調査し、軽減策を提案し、質問に答える | 社内専用 |
| 9 | Perf Factory | 重複アラートを除外し、レイテンシの回帰を発見し、修正を提案する | 社内専用 |
| 10 | ループバック | エージェントはCIとレビューが通過するまで問題を修正し、その後ビルダーは提案された修正を受け取る | 社内ループを説明する |
外部チームが「私たちも持っている」と言えるのは、CIステップという1つのステージと、ステージ2の一部だけです。エージェント型レビューからSevbotまでのすべては、OpenAIの社内開発です。
その「社内専用」の列は、調達の問題でもあります。OpenAIがファイアウォールの内側に保持している要素、つまりオーケストレーション、レビューゲート、人間の承認は、ほとんどのチームが何も持っていない層そのものです。Sharklyは、プロバイダーに依存しない構築場所の1つです。ビルダーは成果をタスクとして定義し、それをエージェントに割り当て、エージェントは既存のランタイム(Claude CodeまたはCodex)を使用してコンピューター上で実行されます。「リリース準備完了」は、何かが「完了」に達する前に人間が動かす必要があるステータスであり、承認はパイプラインの仕事ではなく、個人の仕事として残ります。SharklyはCodexを置き換えたり、コード自体を書いたりするものではありません。それはあなたがすでに支払いをしているランタイムを実行し、周辺のループに場所を提供します。
ステージ1-2:人間がまだ目標を設定し、Codexがまだコードを書く
ソフトウェアビルダー、つまりエンジニアまたはプロダクトマネージャーは、望む成果を定義します。その後、Codexはその目標に達するまで一連のコード変更を行い、結果が機能することを検証します。その検証ループこそが、今日出荷されているCodexの一部です。デスクトップアプリ(Mac版は2026年2月、Windows版は3月)、2026年7月からのChatGPT Work統合、ロールベースのプラグインとスキル、そして長期間実行されるタスクのための/goalコマンドです。そのコマンドの仕組みを知りたい場合は、自律エージェント実行のための/goalについて別途解説しました。
出荷されていないのは、Codexに内部的にフィードされるコンテキストグラフです。SlackのスレッドからDatabricksのダッシュボードまで、ほぼすべてのOpenAIシステムが含まれます。Oroszの記事はそれを直接的に述べています。「OpenAIの社内Codexは、ほぼすべてのOpenAIシステムに接続されているため、その外部版よりもはるかに高度である。」この社内Codexと外部Codexの間のギャップこそが、この記事の本当の論点です。
ステージ3:CIこそがループが実際に強制される場所
これは立ち止まってじっくり考える価値のあるステージです。なぜなら、OpenAIだけでなく、どのチームもすでに所有しているパイプライン全体の唯一のボックスだからです。記事は、OpenAIのCIが約6ヶ月間で負荷を約10倍に増やすために再構築されていると述べています。エージェントが人間だけの場合よりもはるかに多くの変更をパイプラインにプッシュするようになったためです。「Perf Harness」がそれと並行して実行され、パフォーマンスの回帰がレビューに到達する前に捕捉します。
ここで見落とされがちな点があります。「CIとレビューが通過するまで問題を修正する」エージェントは、CIが実際にチェックする内容と同じくらいしか信頼できないということです。テストスイートがユニットロジックはカバーしていてもAPI契約をカバーしていない場合、エージェントは、破壊的変更を依然として出荷する可能性があるグリーンビルドまでループできてしまいます。ステータスコード、スキーマの形状、認証動作、負荷時の応答時間予算は、ほとんどのチームが単体テストに比べて投資を怠りがちなチェックのまさに種類です。
ここにApidogが適合します。CIステップ内でApidog CLIを通じてApidogのテストシナリオを実行することで、エージェントに「コードがコンパイルされた」以上の、より厳しいゲートを満足させることになります。これをCodex内でのApidog CLIで配線する方法について書きました。それがApidogがこのパイプラインで果たす唯一の役割です。Apidogはエージェントではなく、デプロイ、レビュー、インシデント対応には関与しません。
ステージ4-5:専門レビューエージェントとリスク決定
CIが通過した後、OpenAIの社内設定は、データ、インフラ、クラウド、セキュリティの専門エージェントによる並行レビューを通じて変更をルーティングします。Oroszはこれを「各関連インフラチームの人間ドメインエキスパートがすべての変更をレビューするのと同じ」と表現しています。これは、ほとんどの人間チームがすべてのプルリクエストに対して人員を配置できるよりも重いレビュー基準です。Codexの製品化されたコードレビュー機能は、これらの社内専門エージェントとは異なる、より軽量なものです。もし汎用エージェント型レビューアが自身のスタックに何ができるかを検討しているなら、AIコードレビューツールのまとめが公正な出発点となるでしょうし、OpenAIのエージェント型レビューとリスクゲート設計に関する補足記事では、この一つのボックスについてさらに深く掘り下げています(兄弟記事、リンクする前に公開されていることを確認すること)。
その後、リスク分類によって次に行うことが決定されます。コードベースの低リスク領域では、エージェントが自身のPRを自動承認することを選択でき、その種類の変更については人間の承認をループから完全に排除できます。高リスクの変更は、より多くのAIレビューパス、必須の人間レビュー、またはその両方を受けます。OpenAIは低リスクと見なされる正確なルールを公開しておらず、ここではそれを推測するつもりはありません。OpenAIの特定のセットアップを超えて一般化できる一つのアイデアは、公開API契約に対する破壊的変更は、どれほど差分が小さく見えても、決して低リスクと分類すべきではないということです。OpenAPI定義とテストを同じ場所に保持する仕様優先のツールは、スキーマの差分が行数差分よりもはるかに明確なリスクシグナルであるため、その区別を自動的に強制することを容易にします。
ステージ6-8:人間が最初に呼び出されることなく、デプロイ、監視、対応
変更がレビューを通過すると、社内エージェントが機能フラグのロールアウトを含め、それを本番環境に「監視し」、その特定の変更のための独自の監視ダッシュボードを構築します。稼働後、同じエージェント(または関連するエージェント)がOpenAIの社内可観測性スタック上のグラフとアラートを監視します。何か問題が発生すると、Sevbotが引き継ぎます。インシデントを調査し、軽減策を提案し、Slackで開発者の質問に答えます。Sevbotが何をしないかについて正確に述べる価値があります。提案はするが、実行はしません。人間が依然として軽減策を承認し、オンコールを担当します。記事が明言しているように、「オンコール業務は過去のものではない」のです。購入できるCodex製品には、ステージ6から8のどれも存在しません。
ステージ9-10:パフォーマンス回帰とループバック
Perf Factoryはインシデントパスと並行して存在します。アラートやダッシュボードを精査し、重複するシグナルを除外し、実際のレイテンシ回帰を突き止め、修正を提案します。それらの修正は元のビルダーにフィードバックされます。Sevbotと合わせて、これはアラート疲労に対するOpenAIの答えです。オンコールエンジニアがすべてのピングをトリアージする代わりに、エージェントがまず事前にフィルタリングと診断を行うのです。ループはステージ10で閉じられます。エージェントはCIとすべてのレビュー層が通過するまで修正を続けます。
なぜ社内/外部の線があなたのチームにとって重要なのか
「OpenAIスタイル」のエージェント型エンジニアリングが今四半期にあなたのチームで採用できるかどうかを評価しているなら、正直な答えはこうです。ステージ1から3は今日から採用できますが、ステージ4から9は方向性を示すものであり、購入可能な機能ではありません。これはOpenAIを批判するものではありません。この規模の社内ツールは構築に何年もかかります。orchflowsというオープンソースプロジェクトは、Claude CodeとCodex用の/software-factoryコマンドでこのループを近似しようとする公開の試みです。そのREADMEは目標について率直に述べており、スキルのライブラリではなく2つのスキルだけで十分だと主張しています。これは初期段階の、OpenAIとは無関係のプロジェクトなので、すぐに使えるファクトリーとしてではなく、リファレンス実装として扱うべきです。
OpenAI社内での導入は、カスタムの社内配線が必要ない部分では急速に進みました。非エンジニアリングチームでのCodex利用は、2026年2月から5月までの4ヶ月間で、約0%から90%の導入率に達しました。これはパイプライン図だけよりも明確なシグナルです。なぜなら、簡単な部分(明示された目標に向かってコードを書くエージェント)はOpenAIではすでに一般的である一方、難しい部分(すべての社内システムに組み込まれたエージェント型デプロイ、レビュー、インシデント対応)は依然として特注品であることを示しているからです。
何が人間に残されるか
この記事は、何が変わらないかについて慎重です。ビルダーは引き続き成果を定義します。人間は依然として高リスクの変更を承認し、インシデントの軽減策を許可します。Sevbotが事後に行ったことを依然として誰かがレビューし、オンコールローテーションもまだ存在します。記事が結ぶこの一文は、どの統計よりも変化をよく捉えています。「判断力、優先順位付け、センスがより重要になっている」。これを現実的なものにする2つの注意点もあります。モバイルアプリストアのレビューは、エージェントが回避できない手動のボトルネックであり続けており、インフラのスケーリングは毎月の戦いであり、解決済みの問題ではありません。
ベンダーがステージ4から9を出荷するのを待つのではなく、ステージ1から3の独自のバージョンを構築しているなら、すでにパイプラインに存在するゲートであるCIから始めましょう。Codexを中心とした軽量ソフトウェアファクトリーの構築に関する補足記事では、その構築プロセスを詳しく説明しており(兄弟記事、リンクする前に公開されていることを確認すること)、Sevbot/Perf Factoryの設計はOpenAIのPerf FactoryとSevbotに関する記事で独自に扱われています(兄弟記事、リンクする前に公開されていることを確認すること)。テストが通過するまでループするエージェントは、それがループしているテストが実際に何かをアサートする場合にのみ良いアイデアです。ApidogはAPI契約テストを仕様の隣に保持することで、人間だけでなくエージェントが変更をプッシュし始めても、そのゲートが誠実さを保つようにします。