
NVIDIAはHugging Face Open ASR Leaderboardにおいて最も精度の高いオープンウェイトの音声認識モデルをリリースしており、今日から無料で使用できます。Nemotron 3.5 Transcribe(正式名称NVIDIA-Nemotron-3.5-Transcribe-30B-A4B)は2026年10月28日にOpenMDW-1.1ライセンスの下で登場し、商用利用が認められています。つまり、3つの$0ルートがあります。NVIDIA自身のデモSpace、自分のGPU上で動かす無料のウェイト、そして同じチェックポイントをラップしたコミュニティSpaceです。
このガイドでは、各無料ルート、できることとできないこと、そして無料では足りなくなったときの最も安価な有料フォールバックについて説明します。すべての事実は公式モデルカード、Hugging Face上のNVIDIAローンチ記事、そしてOpen ASR Leaderboardから引用しており、いずれも2026年10月29日に確認したものです。
ホスト型APIだけが必要な場合は、Nemotron 3.5 Transcribe APIガイドまでスキップしてください。
Nemotron 3.5 Transcribeは無料ですか?
はい、2つの意味で無料です。ウェイトは無料でダウンロードでき、ライセンスは商用・非商用利用を許可しているため、セルフホスティングのコストはハードウェアのみです。NVIDIAはまた、Hugging Face上でブラウザから試せる無料のデモSpaceを運営しています。
無料でないものは、ホスト型APIです。DeepInfraは音声1分あたり$0.002を請求し、OpenRouterは1秒あたり$0.000033で掲載しています。どちらも無料版は表示されていません。そして2026年10月29日現在、このモデルはbuild.nvidia.comに掲載されていません。ここでは多くのNVIDIAモデルが無料トライアルAPIを利用できます。そこで「transcribe」を検索したところ、無関係なスペイン語ASRモデルが1つ返ってきただけでした。
なぜ注目されるのか:数字で見る
Nemotron 3.5 Transcribeは音声拡張言語モデルです。6億パラメータのASRエンコーダと話者エンコーダが、ハイブリッドMamba-2およびTransformerのmixture-of-experts言語モデルに入力されます。総パラメータ数は340億ですが、トークンあたり約43億のみがアクティブであるため、単一のGPUで動作します。
1つのチェックポイントで実現できること:
- 40言語での文字起こし、そのうち13言語が「leading」評価(英語、スペイン語、フランス語、ドイツ語、ヒンディー語、韓国語、ポルトガル語など)
- 最大1時間の録音を1回のリクエストで処理(65,536トークンのコンテキスト)
- 話者属性付け、最大8名のラベル付き話者に対応
- 単語レベルのタイムスタンプをCTCアラインメントヘッド経由で提供
- 音声翻訳、31言語間で英語との相互翻訳
- コンテキストプロンプティング: 名前や専門用語を渡して正しく綴らせる
- 音声質問応答(英語のみ)
2026年10月28日に更新されたOpen ASR Leaderboardでは、平均WER 5.33%を記録しています。これは61モデル中9位です。上位8モデル(Otter、Zoom Scribe v2 Pro、ElevenLabs Scribe v2、Azure Speechなど)はすべてクローズドな有料APIです。ダウンロード可能なモデルの中では、これより上位にランクされるものはありません。OpenAIのwhisper-large-v3は7.16%で41位です。
NVIDIA自身のモデルカードは、9つの公開データセットで平均WER 4.71%を報告しています。リーダーボードの5.33%は2つの非公開セットを加えたものなので、どちらの数字も誠実です。異なる組み合わせを測定しているのです。
始める前に知っておくべき制限が1つあります。これはオフラインモデルです。録音済みファイルを文字起こしするもので、ライブマイクのストリームではありません。
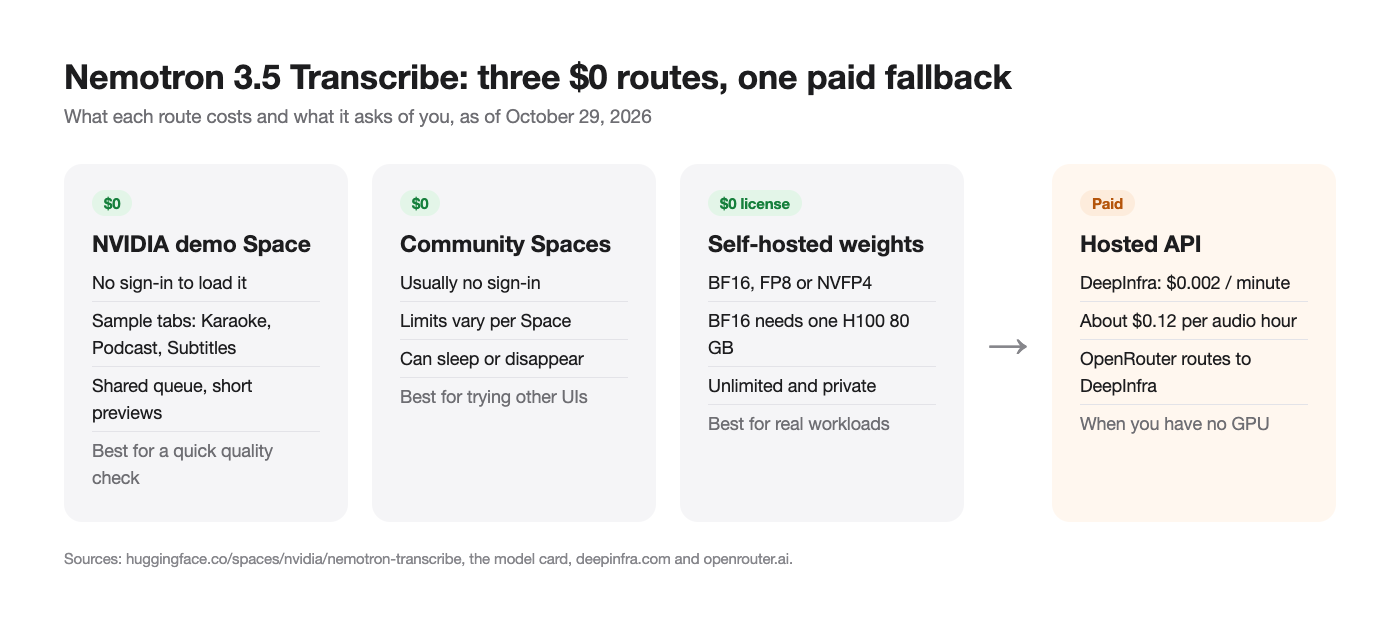
すべての無料・有料ルートの比較
| ルート | コスト | サインイン | 制限 | 最適な用途 |
|---|---|---|---|---|
NVIDIAデモSpace(nvidia/nemotron-transcribe) |
$0 | 不要 | サンプルタブでは60秒プレビュー、共有キュー | 手早い品質チェック |
| コミュニティSpace | $0 | 通常不要 | Spaceごとに異なる。スリープや消滅の可能性あり | 他のUIを試す |
| セルフホストウェイト(BF16、FP8、NVFP4) | $0ライセンス、自分のGPU | ダウンロードにHugging Faceアカウント | BF16にはH100 80 GBが1台。小さいカードはFP8またはNVFP4が必要 | 無制限のプライベート文字起こし |
| DeepInfra API | 1分あたり$0.002 | アカウントとAPIキー | 有料利用 | GPUなしでの本番運用 |
| OpenRouter | 1秒あたり$0.000033 | アカウントとクレジット | DeepInfraのみにルーティング | 多数のモデルを1つのキーで |
| build.nvidia.com | まだ未掲載 | 該当なし | 該当なし | 今後に注目 |
コストがかからないのは最初の3行だけです。
無料ルート1:NVIDIAのデモSpace
このモデルが何をできるか最も手早く聞く方法は、huggingface.co/spaces/nvidia/nemotron-transcribeにあるNVIDIA公式Spaceです。
- ブラウザでSpaceを開きます。読み込むのにアカウントは不要です。
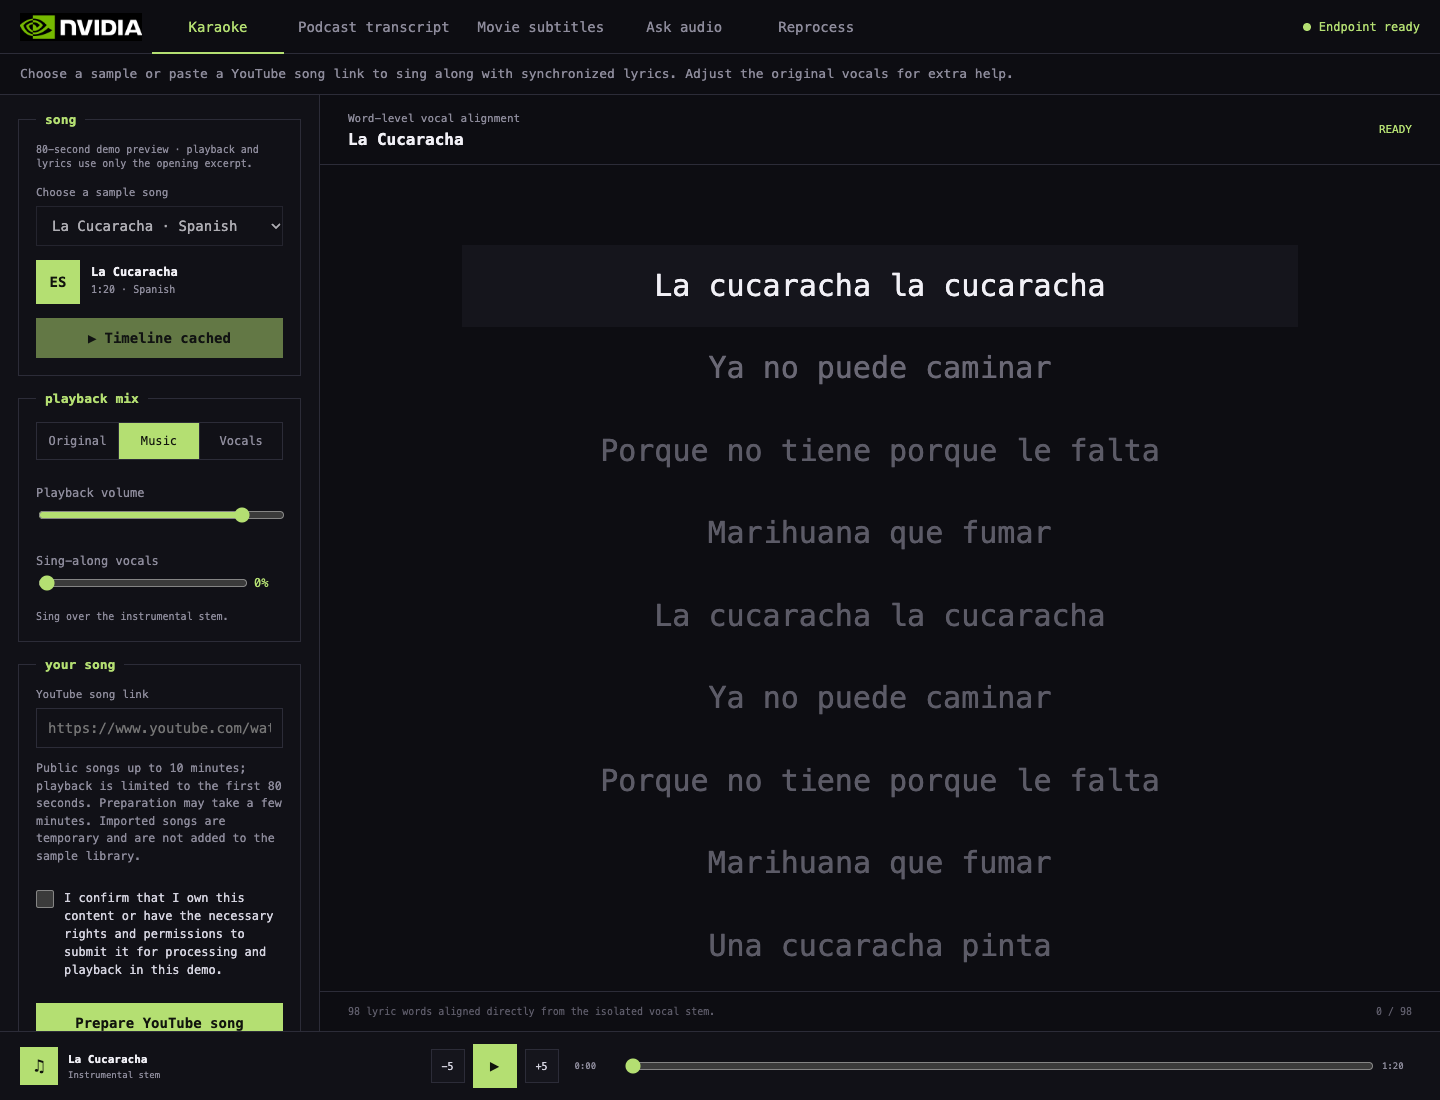
- タブを選びます。2026年10月29日時点でSpaceには3つありました:Karaoke(単語タイミング付き歌詞)、Podcast transcript(話者属性付きテキスト)、Movie subtitles(タイミング付き字幕)。
- タブで許可されていれば、サンプルを選ぶかリンクを貼り付けます。Karaokeタブはプレビューが最初の60秒をカバーすることに注意を促しています。
- 実行して出力を読みます。Karaokeビューでは歌われる各単語がハイライトされ、単語タイムスタンプを見せてくれます。
Spaceはデモとして扱い、無料APIとは考えないでください。公共のSpaceはGPUを共有し、リクエストをキューに入れ、予告なく変更される可能性があります。それを使って製品を構築しないでください。
無料ルート2:オープンウェイトを自分で動かす
これが本当の無料枠です。既に持っているハードウェアで無制限に文字起こしでき、何もマシンから出ていきません。ライセンス(OpenMDW-1.1)は商用利用を認めているので、製品に組み込んで出荷できます。
難点はハードウェアです。NVIDIAの参照構成はBF16でH100 80 GBが1台です。モデルカードの互換性テーブルには次のように記載されています:
- BF16: H100、H200、A100 80 GB、B200、GB200、DGX Spark
- FP8: H100、H200、L40S 48 GB
- NVFP4のみ: RTX 5090(32 GB)とRTX PRO 6000 Blackwell
つまり、コンシューマー向けのRTX 5090がNVFP4チェックポイントで動作します。RTX 4090のような旧世代の24 GBカードはリストにありません。
最も手早いテストは、ソースからTransformersをインストールするだけで済みます:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

inputs = processor.apply_transcription_request("meeting.wav").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=True))
これは少数のファイルには問題ありません。バッチ処理、長時間録音、OpenAI互換エンドポイントには、vLLM 0.32.0とNeMo Speechプラグインでサーブします。Nemotron 3.5 Transcribeをローカルで動かすためのステップバイステップガイドには、モデルカードの正確なインストール手順とvllm serveコマンドが載っています。
ローカルGPUがない場合?時間単位でレンタルすることが、大量のバックログに対する最も安価な「ほぼ無料」ルートです。NVIDIAによれば、1台のRTX PRO 6000 BlackwellがNVFP4ビルドで100時間の音声を3分未満で処理できるとのことですが、この数字はまだオープンソース化されていないサービング最適化を使用しています。
無料ルート3:コミュニティSpace
モデルページには、同じチェックポイント上に構築されたいくつかのコミュニティSpaceが掲載されています。これにはhugging-apps/nemotron-3-5-transcribeやmrfakename/nemotron-3.5-transcribeが含まれます。NVIDIA Spaceのキューが長いときや、シンプルなアップロードボックスが欲しいときに便利です。個人が運営しているため、スリープ、クォータ、時折発生するリンク切れを想定しておいてください。
より良い無料結果を得るプロンプト
Nemotron 3.5 Transcribeは平易な言葉の指示を受け付けます。これらはモデルカードとDeepInfraの掲載情報から引用しています。文字起こしではシステムプロンプトを空にし、temperatureを0にします。
クリーンで読みやすいテキスト:
Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only.
誰が何を言ったか:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
製品名と専門用語:
Transcribe with punctuation and capitalization. Context terms: Apidog, OpenAPI, Kubernetes, gRPC.
翻訳:
Please translate the given speech to English.
コンテキスト用語は、思っている以上に重要です。NVIDIAのContextASRベンチマークでは、WERがコンテキストなしの3.33%から、きめ細かいコンテキストありの1.71%まで下がります。
無料では足りないとき:最も安価な有料ルート
対応GPUを持っておらず、デモ以上のものが必要な場合、ホスト型APIは安価です。DeepInfraの1分あたり$0.002では、1時間の録音で$0.12、1,000時間で$120です。OpenRouterの1秒あたり$0.000033は、1時間あたり約$0.119となり、同じプロバイダーにルーティングされます。
DeepInfraのAPIページから引用した最小限のリクエスト:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@meeting.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
レスポンスにはtext、開始時刻と終了時刻を含むsegments、words、検出されたlanguageが含まれます。APIガイドでは、キー、レスポンスフィールド、コストについて詳しく説明しています。
コーディングエージェントにApidog CLIでエンドポイントをテストさせる
セルフホストでもDeepInfraでも、文字起こしが空で返ってきたり、間違った言語で返ってきたときに大きな音を立てて失敗するチェックが欲しいはずです。その仕事をJSONを目で確認する代わりに、コーディングエージェントとApidog CLIに任せましょう。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
次にエージェントに1つのプロンプトを与えます:
In Apidog project <id>, create a test case for POST {{baseUrl}}/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
that uploads samples/hello.mp3 as the "audio" form field, asserts status 200, a non-empty "text",
"language" equal to "en", and at least one item in "words", then run it against the
deepinfra environment and summarize any failures.
エージェントはスキーマを読み、ペイロードを検証し、ケースを作成して実行します:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
APIからセルフホスティングに移行するときは、環境をローカルサーバーを指すように切り替えます。同じapidog runに-r junitを付けるとCIに組み込めます。セットアップについては、CI/CDパイプラインでApidog CLIを実行するとClaude CodeでのApidog CLIをご覧ください。
依存する前に知っておくべき制限
- オフラインのみ。 ストリーミングはしません。ライブ音声には別のNemotron 3.5 ASR StreamingモデルがNVIDIAから案内されています。
- 音声Q&Aは英語のみ。 文字起こしは40言語をカバーしますが、音声理解と音声指示は英語でのみ評価されています。
- 話者ラベルは身元ではありません。
<spk:0>は「最初の声」を意味し、名前のある人物ではありません。 - 長い出力には余裕が必要。 密な1時間の会話は約20,000出力トークンを生成する可能性があるため、
max_new_tokensをそれに合わせて設定します。 - ハルシネーションを起こす可能性があります。 カードは不明瞭な音声に対して「もっともらしい文字起こしを生成する」可能性があると警告しています。法的または医療に関するものは必ず確認してください。
FAQ
Nemotron 3.5 Transcribeは商用利用無料ですか? はい。OpenMDW-1.1ライセンスはウェイトの商用・非商用利用を許可しています。ホスト型APIはコンピュートに対して課金します。
無料のNemotron 3.5 Transcribe APIキーはありますか? 2026年10月29日時点で見つかりませんでした。DeepInfraとOpenRouterは有料で、まだbuild.nvidia.comには掲載されていません。Nemotron Nano 12B v2 VLのNVIDIA無料APIと比較してください。こちらには無料トライアルエンドポイントが用意されました。
Macで動かせますか? 公式リストにはありません。サポートされているランタイムはLinuxまたはWindows(WSL2)上のNVIDIA GPUを対象としています。GGMLサポートはRTX 5090とRTX PRO 6000のみに記載されています。
Whisperと比べてどうですか? 10月28日のリーダーボードでは、平均WER 5.33%に対し、whisper-large-v3は7.16%です。OpenAIのホスト型オプションについてはWhisper APIガイドを、全モデルのランキングについては最高のオープンソース音声認識モデルをご覧ください。
MP3に対応していますか? はい。WAV、FLAC、MP3、OGG、または16 kHzモノラルPCMにデコードできるものを受け付けます。他の形式の変換にはFFmpegで音声を変換するをご利用ください。
結論
Nemotron 3.5 Transcribeは重要なところで無料です。ウェイト、ライセンス、そしてNVIDIAのデモです。品質チェックにはSpaceを試し、無制限のプライベート利用にはH100、L40S、RTX 5090でセルフホストし、ハードウェアがない場合は1時間あたり$0.12のDeepInfraにフォールバックしてください。どのルートを選んでも、エージェントにApidogチェックをエンドポイントで実行させ、悪い文字起こしが本番環境に届かないようにしましょう。