NVIDIAの新しいNemotron 3.5 Transcribe APIで1時間の録音を文字起こしすると、12セントかかります。これはHugging Face Open ASR Leaderboardで最高のオープンウェイトモデルに対するDeepInfraの料金である1分あたり$0.002で、このモデルは同じ呼び出しで単語タイムスタンプ、話者ラベル、検出言語も返します。
このガイドでは、APIキーの取得方法、最初のリクエストの送信方法、レスポンスの読み方、話者ラベルと専門用語のためのプロンプトの書き方、コストを予測可能に保つ方法を説明します。以下の内容はすべて、2026年10月29日に DeepInfraモデルページ、OpenRouterの掲載ページ、公式モデルカード と照合して確認済みです。
代わりに$0のルートを探していますか? Nemotron 3.5 Transcribeを無料で使う方法をお読みください。
Nemotron 3.5 Transcribe APIで得られるもの
NVIDIAは2026年10月28日にNemotron 3.5 Transcribe(NVIDIA-Nemotron-3.5-Transcribe-30B-A4B)をリリースしました。これは総パラメータ34B、アクティブ約4.3Bのオープンウェイト音声モデルで、ハイブリッドMamba-2とTransformerのMixture-of-Experts言語モデルにASRエンコーダと話者エンコーダを追加したものです。
1つのエンドポイントから以下が得られます:
- 40言語での文字起こし
- 最長1時間のファイル
- 単語タイムスタンプとセグメントタイムスタンプ
- 最大8話者までの話者属性付き文字起こし
- 31言語と英語の間の音声翻訳
- 名前、製品、専門用語のためのコンテキストプロンプティング
- 言語識別
Open ASR Leaderboard(2026年10月28日更新)では、平均5.33% WERで、61モデル中9位、公開ウェイトのモデルの中では1位です。その上位8モデルはクローズドな商用APIです。
これはオフラインモデルです。ライブストリームではなく、録音済みファイルを送信してください。
どこで呼び出し、いくらかかるか
この料金では、1,000時間の音声で約$120かかります。比較すると、OpenAI Whisper APIはこれまで1分あたり$0.006を請求しており、これはDeepInfraの料金の3倍で、whisper-large-v3は同じリーダーボードで7.16% WERで41位です。
ステップ1:DeepInfra APIキーを取得する
- deepinfra.comでアカウントを作成します。
- ダッシュボードを開き、APIキーを作成します。
- 支払い方法またはクレジットを追加します。モデルページはブラウザデモでもログインが必要です。
- シェルでキーをエクスポートします:
export DEEPINFRA_API_KEY="your_key_here"
キーはソース管理に含めないでください。コーディングエージェントを通して作業する場合は、プロンプトではなくエージェントの環境に置いてください。
ステップ2:最初のファイルを文字起こしする
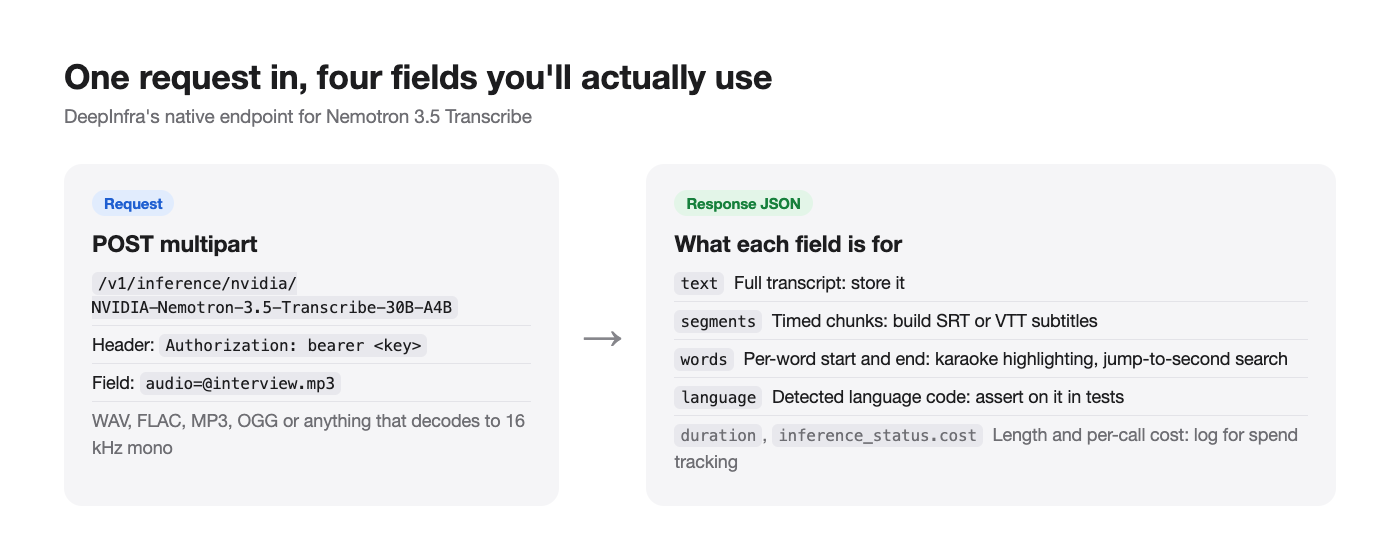
DeepInfraのネイティブ推論エンドポイントは、audioフィールドを含むmultipartアップロードを受け取ります。以下はAPIページにある正確なリクエスト形式です:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@interview.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
モデルはWAV、FLAC、MP3、OGG、または16 kHzモノラルPCMにデコードできる任意の形式を受け入れます。M4Aや動画ファイルがある場合は、まずFFmpegで変換してください:
ffmpeg -i call.m4a -ar 16000 -ac 1 call.wav
ステップ3:レスポンスを読む
DeepInfraはこのレスポンス形状を文書化しています(以下の値は例示です):
{
  "text": "Hello World",
  "segments": [
    { "id": 0, "start": 0.0, "end": 1.0, "text": "Hello" },
    { "id": 1, "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "language": "en",
  "words": [
    { "start": 0.0, "end": 1.0, "text": "Hello" },
    { "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "duration": 5.0,
  "inference_status": { "status": "succeeded", "runtime_ms": 0, "cost": 0.0 }
}
各フィールドの用途:
textは完全な文字起こしです。これを保存します。segmentsは時間付きのチャンクを提供します。字幕(SRTまたはVTT)に使用します。wordsは単語ごとのタイミングを提供します。カラオケ風のハイライトや、正確な秒にジャンプする検索に使用します。languageは検出された言語コードです。テストでアサートしてください。間違った言語は短いクリップでよくある失敗です。inference_status.costは呼び出しコストを報告します。ファイルごとの支出を追跡するためにログに記録します。
ステップ4:Pythonから呼び出す
import os
import requests

URL = "https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"

def transcribe(path: str) -> dict:
    with open(path, "rb") as f:
        r = requests.post(
            URL,
            headers={"Authorization": f"bearer {os.environ['DEEPINFRA_API_KEY']}"},
            files={"audio": f},
            timeout=600,
        )
    r.raise_for_status()
    return r.json()

result = transcribe("interview.mp3")
print(result["language"], len(result["words"]), "words")
print(result["text"][:500])
長いタイムアウトを設定してください。密度の高い音声の1時間分は約20,000出力トークンを生成することがあり、モデルカードは長いジョブには時間がかかると警告しています。
DeepInfraはこのモデル用に「OpenAI Speech-to-Text」タブも掲載しているため、audio.transcriptionsを呼び出すOpenAI SDKコードは、おそらくDeepInfraのOpenAI互換ベースURLを指すことができます。本番コードを切り替える前に、正確なベースURLをそのタブで確認してください。
プロンプト:逐語、クリーン、話者、専門用語
Nemotron 3.5 Transcribeが古いASR APIと異なる点は、指示を受け付けることです。DeepInfraページに記載されているNVIDIA推奨のプロンプトは次のとおりです:
| 目的 | 指示 |
|---|---|
| 逐語的な単語 | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| 読みやすいテキスト | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| ドメイン語彙 | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| 誰が何を言ったか | Transcribe verbatim, including fillers. ... Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. |
| 翻訳 | Please translate the given speech to <target language>. |
文字起こし、翻訳、言語IDにはtemperature 0でreasoning offを使用し、システムプロンプトは空のままにしてください。
コンテキスト用語は効果があります。NVIDIAによると、ContextASR-Bench WERはコンテキストなしの3.33%から、きめ細かいコンテキストありで1.71%に低下し、コンテキスト付きEarnings22は12.54%から9.58%になりました。決算説明会では、会社名、ティッカー、経営陣の名前を渡してください。
ネイティブエンドポイントで指示を運ぶフィールドについては、DeepInfraの入力スキーマタブを確認してください。セルフホストサーバーでは、ローカルセットアップガイドに示すように、指示は音声の隣のチャットメッセージに入ります。
代わりにOpenRouterを使う
すでにLLMにOpenRouterを使っているなら、キーと請求を1つにまとめられます。モデルIDはnvidia/nemotron-3.5-transcribeで、価格は1秒あたり$0.000033、2026年10月29日時点で唯一のプロバイダーとしてDeepInfraが記載されています(稼働率100%、その時点でレイテンシは約1秒)。音声エンドポイントはチャット完了とは異なるため、OpenRouterのモデルのAPIタブからリクエスト形式をコピーしてください。
トレードオフ:OpenRouterはネットワークホップを追加し、今日ではモデルを提供するプロバイダーが1つだけなのでプロバイダーのフェイルオーバーはありません。
コストを予測可能に保つ
- まず無音をトリムします。 支払うのは音声の分単位であり、発話の分単位ではありません。録音から無音部分を削除すると請求が減ります。
- ダウンミックスとリサンプル。 16 kHzモノラルはモデルがとにかく使用する形式です。ステレオ48 kHzを送るとアップロード時間が増えるだけです。
- チャンク単位ではなくファイル単位でバッチ処理します。 モデルは1回のリクエストで1時間を処理します。ファイルを30秒の断片に分割すると、話者ラベルとコンテキストが壊れます。
inference_status.costをログに記録します。 顧客ごとまたはジョブごとに合計します。- 安定したボリュームを超える場合はセルフホストします。 NVIDIAの最適化されたNIMは、1台のRTX PRO 6000 Blackwellで毎秒最大2,238秒の音声を処理します。月に数千時間を文字起こしするなら、1台のレンタルGPUが分単位の料金に勝ります。オープンソースのvLLM経路は、そのNIMの数値より約2倍遅くなると予想されていることに注意してください。
コーディングエージェントにApidog CLIでテストさせる
文字起こしAPIは静かに失敗します。空のtextで200が返る、スペイン語のクリップがポルトガル語として検出される、プロバイダー更新後にwordsが欠落するなどです。手作業でJSONを確認する代わりに、コーディングエージェントにApidog CLIでチェックを書いて実行させましょう。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、エージェントに1つのプロンプトを与えます:
In Apidog project <id>, add the DeepInfra endpoint POST
https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
with a multipart "audio" field and a bearer token from {{DEEPINFRA_API_KEY}}.
Create a test case per file in samples/ (en.mp3, es.mp3, two-speakers.wav) asserting
status 200, non-empty "text", the expected "language", and "words" length > 0.
Run them against the prod environment and report failures with the response body.
エージェントはスキーマを読み、ペイロードを検証し、ケースを書き、それらを実行します:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
-r junitを追加すると、同じコマンドがCIゲートになります。完全なセットアップについては、CI/CDパイプラインでのApidog CLIとClaude CodeでのApidog CLIを参照してください。
よくある質問
Nemotron 3.5 Transcribe APIの価格はいくらですか? 2026年10月29日時点で、DeepInfraでは1分あたり$0.002、OpenRouterでは1秒あたり$0.000033です。どちらでも音声1時間あたり約$0.12です。
無料のAPIキーはありますか? 私たちは見つけられませんでした。このモデルはまだbuild.nvidia.comにありません。無料のルートはNVIDIAのデモSpaceとセルフホスティングです。無料ガイドを参照してください。
最大ファイル長は? 1リクエストあたり1時間で、コンテキストは65,536トークンです。
APIは結果をストリーミングしますか? いいえ。ファイルが完了すると文字起こしを返すオフラインモデルです。
対応言語は? 40言語で、3つのティアに格付けされています。13の「leading」言語には英語、スペイン語、フランス語、ドイツ語、イタリア語、ポルトガル語、ヒンディー語、韓国語、ロシア語、ポーランド語が含まれます。日本語、トルコ語、ウクライナ語は「production-ready」です。中国語官話とアラビア語は「supported」です。
他の音声APIと比べてどうですか? 私たちの最高のオープンソース音声テキスト変換モデルランキングと、以前のトップ音声合成および音声テキスト変換APIまとめを参照してください。
文字起こしを始める
DeepInfraキーを取得し、MP3を付けて1回のcurlを送信すれば、1分あたり$0.002で、時間付きで言語タグ付きのテキストが返ってきます。ドメインのコンテキスト用語を追加し、会議には話者プロンプトを使い、エージェントにすべてのリリースでApidogチェックを実行させて、静かなリグレッションが出荷されないようにしましょう。