
Mistralはしばらくトップエンドで静かでした。Mistral Large 3は2025年12月に出荷され、それ以来、オープンウェイトのフロンティアに関する話題はKimi、DeepSeek、GLM、Qwenに移っていました。2026年10月6日、MistralはMistral Large 4で応えました。これは、チームが「Le Chonk」と呼ぶ1兆パラメータモデルです。
見出しの数字はサイバーベンチマークで、Large 4は82%を記録し、Claude Opus 5.5とGPT-6 Astraはほぼゼロでした。これは本当で、Mistralの発表ページにも記載されており、共有する前に一文のコンテキストが必要です。この記事では、そのコンテキスト、仕様、実際の価格、そしてLarge 4がまだ劣る点について説明します。
TL;DR
- 概要: 1.05兆パラメータの混合エキスパートモデルで、490億のアクティブパラメータ、16億のビジョンエンコーダ、テキストと画像入力、100万トークンのコンテキストウィンドウを備えています。
- 入手方法: 本日よりMistral APIでパブリックプレビューとして
mistral-large-4で利用可能。ウェイトは「月末まで」、つまり10月27日頃。 - 価格: リスト価格で100万トークンあたり入力$1.36 / 出力$4.18。プレビュー中は$0.68 / $2.09と表示されています。キャッシュされた入力は$0.07です。
- サイバーでの勝利: AA Cyber Indexの脆弱性再現テストで82%。Opus 5.5とAstraはタスクを拒否するため、失敗するのではなく、ほぼゼロを記録します。
- 実際の損失: 人間による評価のコーディングでは、Claude Opus 5が4.22を記録したのに対し、Large 4は3.74でした。
「Mistralが帰ってきた」が妥当な理由
2026年の大半において、最も強力なオープンウェイトモデルは中国から登場しました。MistralはMedium 3.5、Devstral 2、Small 4を継続してリリースしていましたが、フロンティアのクローズドモデルと本拠地で競合するようなものはありませんでした。
Large 4は状況を変えます。Mistralは、「米国またはヨーロッパで開発されたどのオープンウェイトモデルよりも著しく優れている」と主張しており、その主張はEU主権を重視する層向けに構築されたトレーニングストーリーによって裏付けられています。このモデルは、Mistral自身のヨーロッパのデータセンターで3,800基のNVIDIA Grace Blackwell GPUを使用してゼロからトレーニングされ、すべてのEU公用語を含む160以上の言語に対応しており、Mistralがヨーロッパのテック企業による史上最大の株式調達と呼ぶ30億ユーロのシリーズDの数週間後に登場しました。
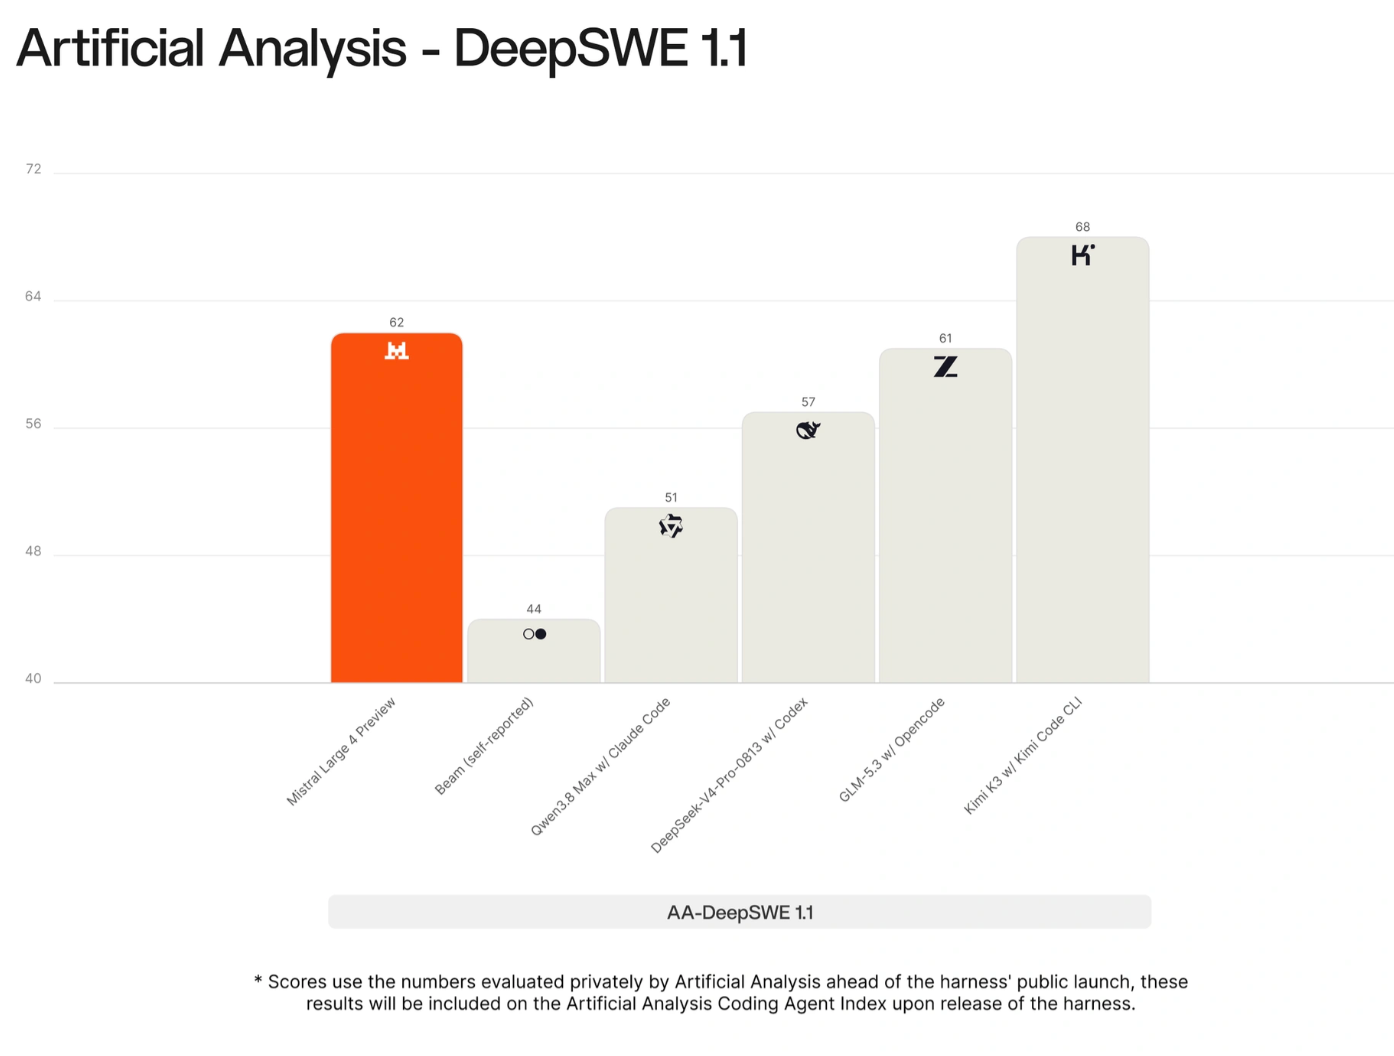
タイミングも重要です。Large 4はReflectionがオープンウェイトのBeamモデルを発表した直後に登場したため、米国対中国のオープンモデル競争には、3番目の有力な参入者が加わったことになります。
サイバーの見出しと落とし穴
これは誰もがスクリーンショットを撮っている結果です。Artificial Analysis Cyber Indexには、モデルにオープンソースソフトウェアの実際の脆弱性を再現し、それをパッチするよう求めるテストが含まれています。Mistralは、Large 4が82%を記録し、これはどのモデルよりも高いと述べています。
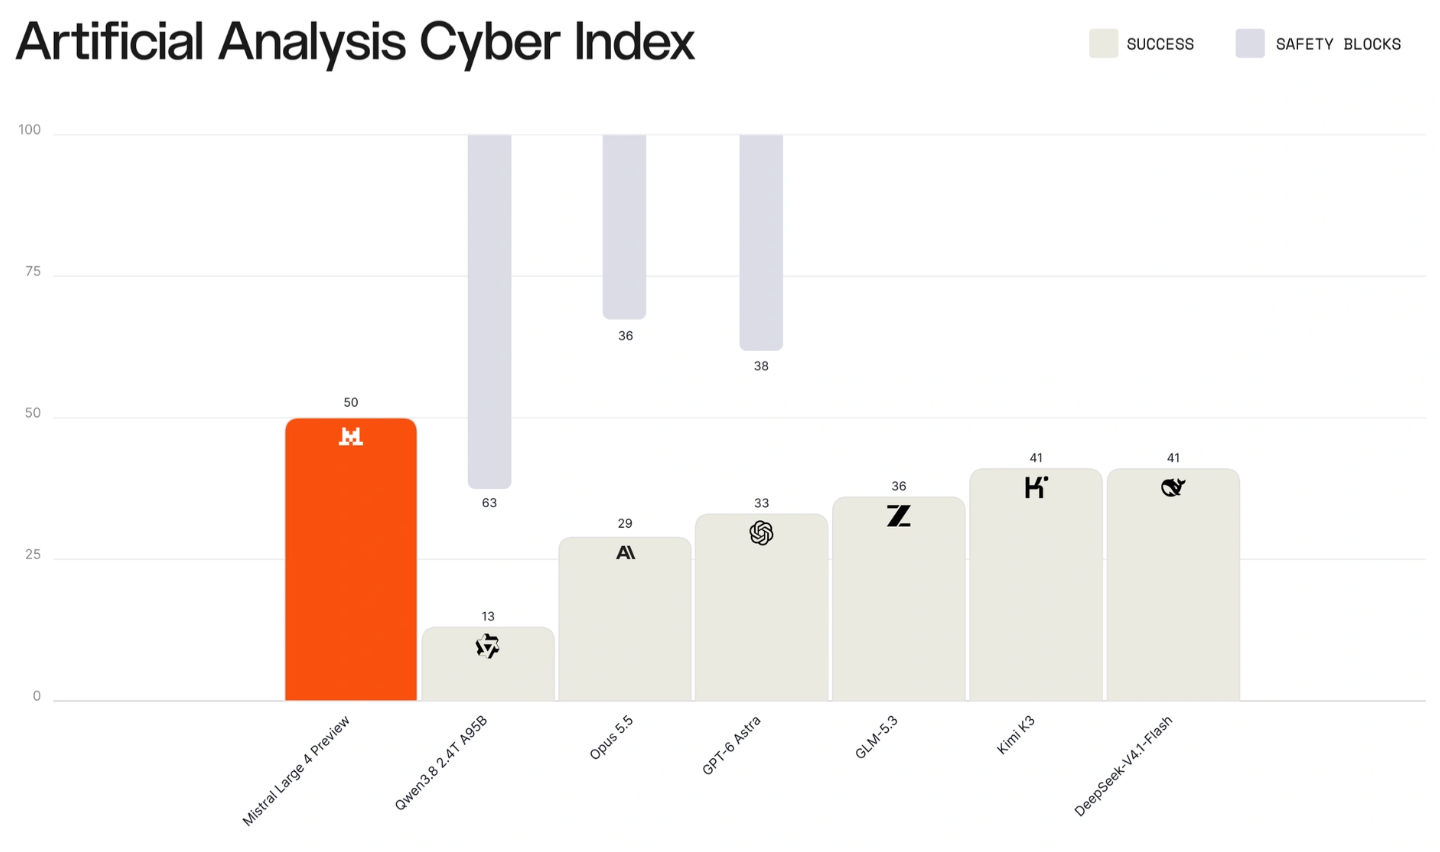
そして、Mistral自身の言葉による落とし穴:「Claude Opus 5.5やGPT-6 Astraを含むいくつかの主要なクローズドモデルは、同じテストでタスクの実行を拒否するため、ほぼゼロのスコアを記録します。」
したがって、次のように解釈してください。
| 主張 | 実際に意味すること |
|---|---|
| 「Large 4はサイバーでAstraとOpus 5.5を打ち負かす」 | この特定のテストでは、クローズドモデルは回答を拒否します。Large 4は回答し、通常は成功します。 |
| 「Large 4は最高のハッキングモデル」 | 未確立。拒否はポリシーの選択であり、能力の限界ではありません。 |
| 「Large 4は安全ではない」 | これも未確立。Mistralは、JailbreakBench、StrongREJECT、AgentHarmからのサイバープロンプトに対する平均拒否率が、他のすべてのオープンウェイトモデルよりも高いと報告しています。 |
この見出しの背後には実際の能力があります。Large 4は、40のキャプチャ・ザ・フラッグ演習のセットであるCybenchの93%も解決しており、Mistralはこれをオープンウェイトモデルで報告された最高のスコアの1つと呼んでいます。B3 Agent Security Benchmarkでは、攻撃の93.3%に耐えます。
セキュリティチームにとって、この組み合わせこそが実際の物語です。自分のコードのCVEを再現してパッチを適用するのに役立ち、かつほとんどの明確に有害なリクエストを拒否するモデルを自分でホストできるのです。APIチームにとっては、他社のポリシーフィルターの背後ではなく、独自のハードウェア上で利用できる便利なツールです。
サイバー以外の分野でLarge 4がGPT-6 Astraに勝る点
サイバーの結果は派手なものです。Astraに対する他の2つの勝利は、より静かで、より意味深いものです。なぜなら、どちらのモデルも実際にタスクを試行したからです。
| ベンチマーク | Mistral Large 4 | GPT-6 Astra | 注記 |
|---|---|---|---|
| Dense 200 (視覚的グラウンディング) | 42% | 41% | 1ポイント差のリード。実質的だが僅差。 |
| Finance Agent v2 (vals.ai) | 先行 | 後塵 | Mistralはスコアではなく順位を報告。 |
| Harvey Legal Agent Benchmark | 最高のオープンモデル | 記載あり | 直接比較の数値は未公開。 |
他のオープンモデルと比較すると、その差はさらに大きくなります。
| ベンチマーク | Mistral Large 4 | 打ち負かす相手 |
|---|---|---|
| AutomationBench (657ワークフロー) | 59.9% | Kimi K3、DeepSeek V4 Pro |
| AA-Briefcase (ナレッジワーク) | 1,393 Elo | DeepSeek V4 Pro |
| DeepSWE v1.1 (コーディング) | 61.7% | オープンウェイトモデルをリード |
| SWE-Atlas-QnA | 59.4% | |
| Terminal-Bench 4.0 | 28.3% |
これらはすべてMistralが報告したプレビューモデルの数値です。独立したラボによる再実行はまだ行われておらず、Euronewsはローンチ時点では強化学習がまだ最終段階にあったと報じています。これらは「強いシグナル」として扱い、最終的な「評決」とは見なさないでください。
まだ劣る点
Mistralは、クローズドモデルが明確に勝利した1つの結果を発表しました。Surge AIが5つのモデルを対象に実施したコーディング品質の人間評価では、Large 4 Previewが2位でした。
| モデル | 人間のコーディングスコア (5点満点) |
|---|---|
| Claude Opus 5 | 4.22 |
| Mistral Large 4 Preview | 3.74 |
| GLM-5.3 | 3.60 |
| Kimi K3 | 3.59 |
| GLM-5.2 | 3.40 |
これは、最高の中国製オープンモデルに対する明確な勝利であり、Claudeとは0.5ポイントの差があります。Mistral自身の表現では、Large 4はコーディングにおいてフロンティアモデルとの「ギャップを縮めている」とのことですが、これは正直な見方です。
また、ローンチ資料にはClaude Fable 5.1やGPT-6 Solとの比較はどこにもありません。もし誰かがLarge 4がFableに勝ると言ったら、ベンチマークを求めてください。
スペック概要
| スペック | Mistral Large 4 |
|---|---|
| APIモデルID | mistral-large-4 (エイリアス mistral-large-4-0) |
| バージョン | 26.10、パブリックプレビュー |
| アーキテクチャ | 混合エキスパート、ハイブリッド指示+推論 |
| パラメータ数 | 合計1.05兆、アクティブ490億、ビジョンエンコーダ16億 |
| コンテキストウィンドウ | 100万トークン |
| 入力 | テキスト、画像 |
| 推論 | reasoning_effort パラメータ ("high" または "none") |
| ツール | 関数呼び出し、構造化出力、組み込みエージェントツール |
| エンドポイント | /v1/chat/completions, /v1/conversations, /v1/agents, /v1/batch |
| ウェイト | オープン、2026年10月末までに公開予定;ライセンスは未発表 |
価格:今日呼び出せる最も安価なフロンティアクラスモデル
これは、APIチームが注目すべき点です。Mistralの料金ページには、Large 4がプレビュー期間中はリスト価格の半額で記載されています。
| モデル | 入力 / 100万 | 出力 / 100万 | オープンウェイト |
|---|---|---|---|
| Mistral Large 4 (プレビュー価格) | $0.68 | $2.09 | はい、10月下旬 |
| Mistral Large 4 (リスト価格) | $1.36 | $4.18 | はい、10月下旬 |
| Claude Opus 5.5 | $4.00 | $20.00 | いいえ |
| GPT-6 Astra | $10.00 | $50.00 | いいえ |
プレビュー価格では、Large 4の出力コストはAstraの約24分の1です。リスト価格であっても、出力はAstraの約12分の1の安さです。キャッシュされた入力は100万あたり$0.07に下がり、これは各ターンで同じシステムプロンプトとツール定義を再送信するエージェントにとって重要です。
Mistralはプレビュー割引がいつ終了するかを明言していないため、予算はリスト価格に基づいて見積もってください。
乗り換えるべきか?
すぐに試すべきケース:
- エージェントワークフローやナレッジワークの自動化を実行しており、フロンティア価格を支払っている場合。AutomationBenchとAA-Briefcaseは、Large 4がこの分野で競争力があり、コストが大幅に低いことを示唆しています。
- EU言語全体での多言語出力、またはコンプライアンスのためのEUホスト型推論が必要な場合。
- 防衛セキュリティ作業を行っており、正当な脆弱性再現で拒否に何度も遭遇している場合。
- 数週間以内にセルフホストできるフロンティアクラスのモデルが必要な場合。
待つべきケース:
- コード品質が主要な指標である場合。Claudeは依然として人間による評価のコーディングでリードしています。
- レビューで正当化できる数値が必要な場合。ウェイトが出荷された後、独立したベンチマークを待ちましょう。
- Large 3を本番環境で実行している場合。プレビューはまだ変更される可能性があり、Mistralはまだ安定版のバージョンIDを公開していません。
ApidogでLarge 4を自分のAPIに対してテストする方法
ベンチマークは、モデルが他人のタスクでどれだけうまく機能するかを示します。より迅速に決定する方法は、Large 4を自分のプロンプトで実行し、現在支払っているモデルと比較することです。Apidogは、コードを1行も書かずにそれを処理します。
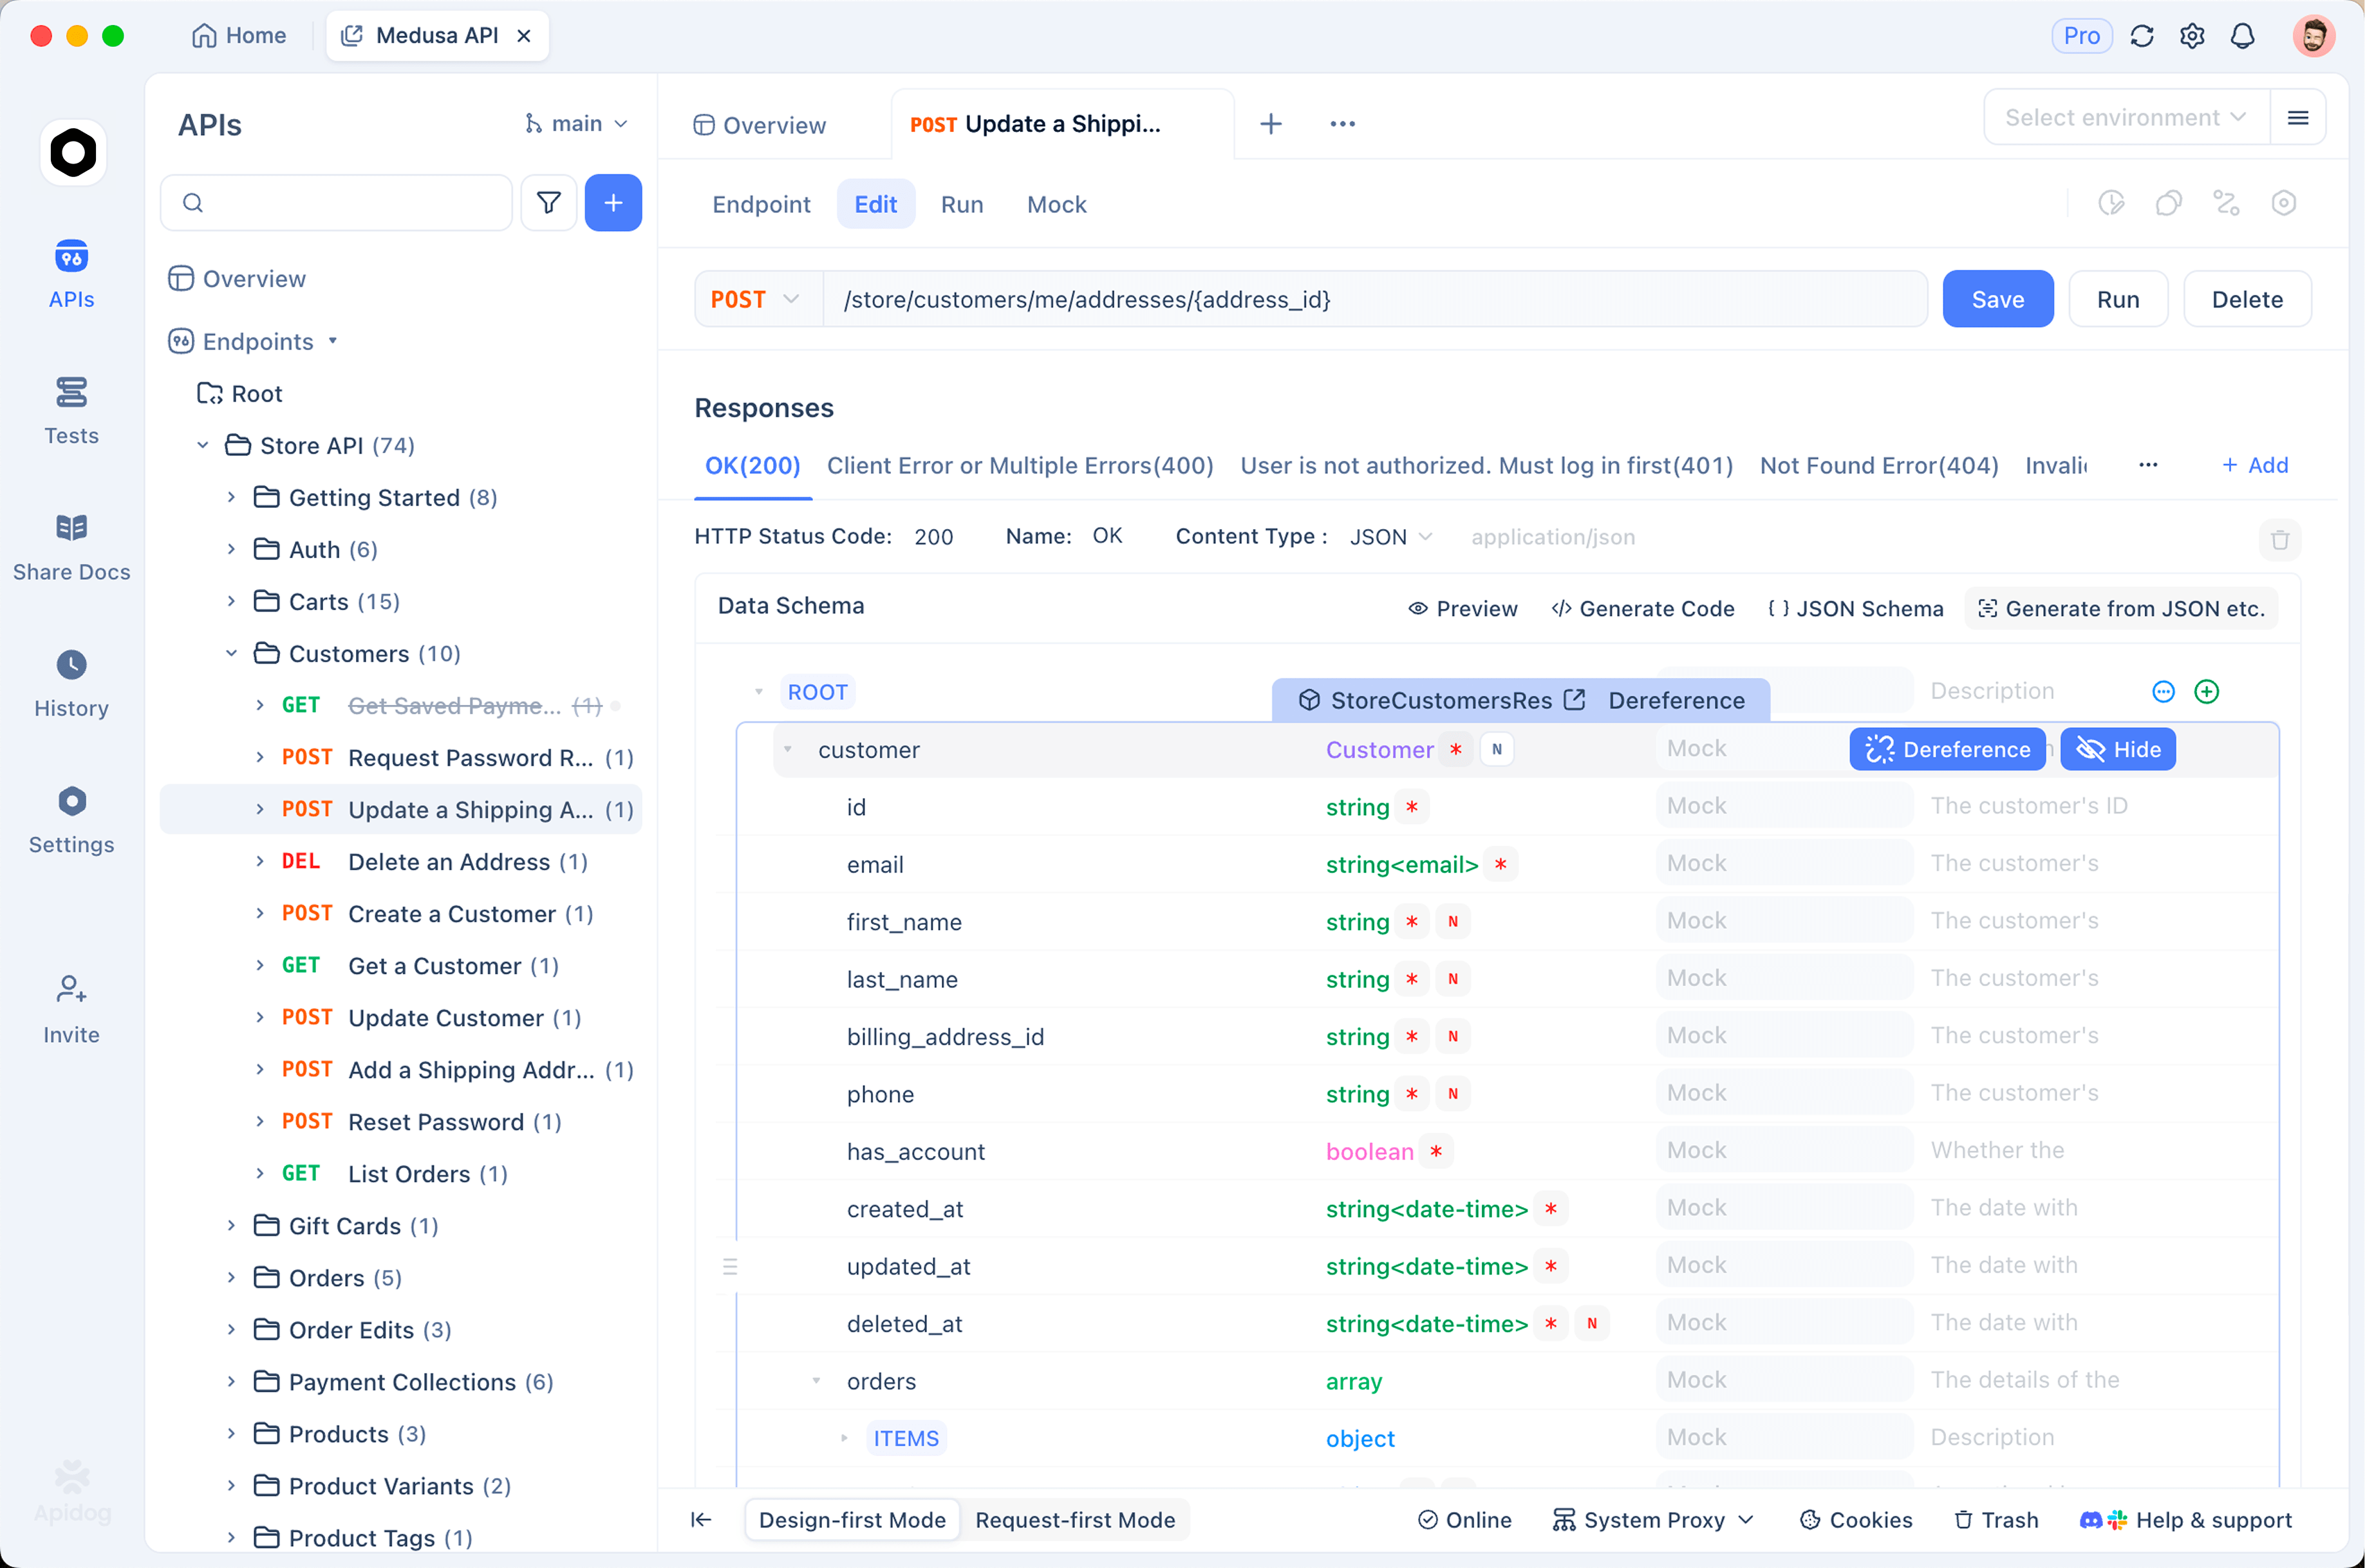
- リクエストを一度保存する。
POST https://api.mistral.ai/v1/chat/completionsを作成し、キーを環境変数として保存し、Authorization: Bearer {{MISTRAL_API_KEY}}を設定します。 - モデルごとにクローンする。 リクエストを複製し、
modelフィールドのみを変更(mistral-large-4対現在のモデル)して両方を送信します。Apidogは、応答、ステータス、レイテンシ、サイズを並べて表示し、usageブロックはコスト比較のためのトークン数を提供します。 - アサーションを追加する。
200ステータス、空ではない回答、構造化出力を要求した場合はJSON Schemaの一致を確認します。これにより、一度限りの実験がリグレッションテストに変わります。 - モデルが更新されるたびに再実行する。 リクエストをテストシナリオにグループ化し、Mistralがプレビューを更新したりウェイトを出荷したりしたときに再実行します。ユーザーが気づく前に品質の変動を確認できます。
Large 4の2つの強みは、API作業に自然に適合します。そのセキュリティ結果は、たとえば自身のステージングAPIで認証バイパスを再現する場合など、APIセキュリティテストの優れたセカンドレビュアーとなります。その関数呼び出しと構造化出力は、Apidogで設計されたOpenAPI仕様をエージェントが呼び出せるツール定義に変換することを可能にします。
キー、推論チャンク、画像、関数呼び出し、コスト計算を含む完全なコードウォークスルーについては、Mistral Large 4 APIガイドを参照してください。以前のMistralモデルから移行する場合、Mistral AI APIの基本とMistral Medium 3.5 APIガイドは引き続き適用されます。同じベースURL、同じ認証、新しいモデルIDです。
FAQ
Mistral Large 4はオープンソースですか? これはオープンウェイトです。Mistralは2026年10月末までにウェイトを出荷すると述べています。ライセンスはまだ公開されていないため、Large 3のApache 2.0と一致すると仮定しないでください。
Mistral Large 4は本当にGPT-6 Astraを打ち負かしますか? 視覚的グラウンディング(42%対41%)とFinance Agent v2では、Mistralの数値によればそうです。サイバー脆弱性テストでは、Astraは拒否するためほぼゼロを記録しており、これは同等の勝利ではありません。
Claudeを打ち負かしますか? コーディングではそうではありません。Claude Opus 5は人間によるコーディング評価で4.22対3.74でリードしています。Claude Opus 5.5もサイバー再現タスクを拒否するため、そこでほぼゼロを記録します。
「Le Chonk」とはどういう意味ですか? これはMistralの非公式なモデルのニックネームで、そのサイズについてのジョークです。公式名称はMistral Large 4、またはML4です。
無料で利用できますか? Mistralの無料プランには、月額$10のAPIクレジットとLe ChatおよびVibeでの最新モデルへのアクセスが含まれます。プレビュー価格では、$10でLarge 4の出力トークン約480万個を購入できます。
結論
Mistralがフロンティアの議論に復帰しました。Mistralの数値によれば、Large 4は中国以外で最も強力なオープンウェイトモデルであり、AstraやOpus 5.5の何分の1かのコストで利用でき、数週間以内には自身のハードウェアで動作させることが可能になります。「サイバーでAstraとClaudeを打ち負かす」という見出しは事実ですが、これは拒否によるものであり、正直なコーディング評価は「Claudeに次ぐ」というものです。プレビュー価格期間中にApidogで自身のAPIに対して今すぐテストし、独立したベンチマークが10月27日以降に到着するまで、本番環境への導入決定は保留してください。