
Mistral Large 4のオープンウェイトが2026年10月29日にHugging Faceで公開されました。MistralがAPIで提供しているのと同じ1.05Tパラメータのモデルが、修正MITライセンスの下、FP8とNVFP4のチェックポイントに加えてコミュニティ製のGGUF量子化版として入手できます。承認ステップなしでダウンロードでき、8台のデータセンターGPU上でvLLMまたはSGLangを使って配信することも、ハードウェアを用意せずにMistral APIのmistral-large-4を100万入力トークンあたり$0.70で呼び出すこともできます。
以下では、10月6日のプレビュー以降に何が変わったか、ダウンロードサイズ、ルートごとのハードウェア、ライセンスについて説明します。モデルの概要についてはMistral Large 4ローンチ解説を、リクエスト形式とSDKコードについてはMistral Large 4 APIガイドをご覧ください。
Mistral Large 4のオープンウェイトとは?
Mistral Large 4のオープンウェイトは、Mistralのフラッグシップモデル(愛称「Le Chonk」)のダウンロード可能なチェックポイントです。これは約1.05Tの総パラメータ、トークンあたり約49Bのアクティブパラメータ(埋め込み層と出力層を含めると52B)、1.6Bのビジョンエンコーダ、100万トークンのコンテキストウィンドウを持つマルチモーダルなMixture-of-Expertsモデルで、Mistral Ecosystem Open-Weight Licenseの下でリリースされています。
公式のモデルカードには、72のテキスト層と128のルーティングエキスパートが記載されており、トークンごとに4つに加えて1つの共有エキスパートが選択されます。
このリリースはプレビューの凍結コピーではありません。Mistralのオープンウェイト発表によると、モデルはウェイトが公開される前に、コーディングとサイバーセキュリティに焦点を当てた3週間の追加強化学習を受けています。
10月6日のプレビュー以降の変更点
プレビュー中にLarge 4をテストした方にとって、現在は4つの点が異なります。
| 項目 | 10月6日プレビュー | 10月29日オープンリリース |
|---|---|---|
| ウェイト | APIのみ、ウェイトは後日公開予定 | Hugging FaceでFP8とNVFP4、ゲートなし |
| 推論モード | highまたはnone |
low、medium、high(デフォルトはhigh)。lowがnoneを置き換え |
| Terminal-Bench 4.0(Mistral報告) | 28% | 41%、出力トークンは約30%削減 |
| B3 Agent Security攻撃耐性(Mistral報告) | 93.3% | 97.1% |
| 100万トークンあたりのAPI価格 | プレビュー割引価格で表示 | 入力$0.70、キャッシュ入力$0.07、出力$2.10 |
推論の変更はコードを壊します。プレビュー統合でreasoning_effort: "none"を送信している場合は、"low"に切り替えてください。Hugging Faceのローンチ投稿によると、Transformersはnoneをhighで実行するため、古い設定のままだと失敗せずにトークンを消費します。
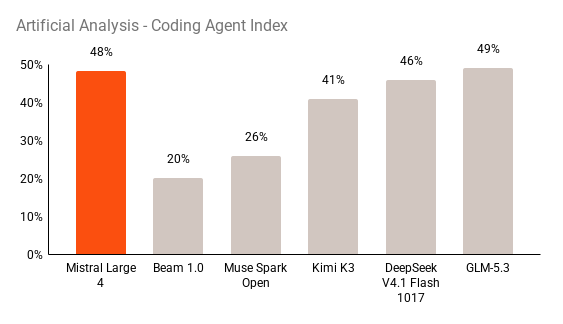
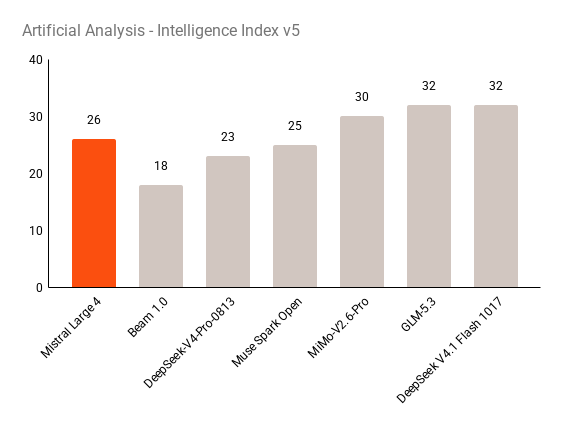
この記事のすべてのベンチマーク数値はベンダー報告です。Mistralはさらに、Cognitionの非公開ベンチマークFrontierCode 2.0で19.7%(同社のチャートでオープンウェイト最高スコア)、Artificial Analysis Coding Agent Indexで48%(GLM-5.3とほぼ同等)を主張しています。11月2日に確認した時点では、独立した再現はまだ保留中でした。
Mistral Large 4を実行する3つの方法
3つのルートがあり、適切なものはどれだけのハードウェアを管理下に置けるかによって決まります。
- Mistral APIを呼び出す。モデルIDは
mistral-large-4、100万トークンあたり入力$0.70、キャッシュ入力$0.07、出力$2.10。GPUは不要です。 - ホステッドプロバイダーを利用する。MistralはOpenRouter、NVIDIAホストのエンドポイントとNIMコンテナ、そしてAzure上でのプライベートデプロイも提供するMicrosoft Foundryを挙げています。
- ウェイトをセルフホストする。Hugging Faceからダウンロードし、自前のマシン上でvLLM、SGLang、Transformers、またはllama.cppで配信します。
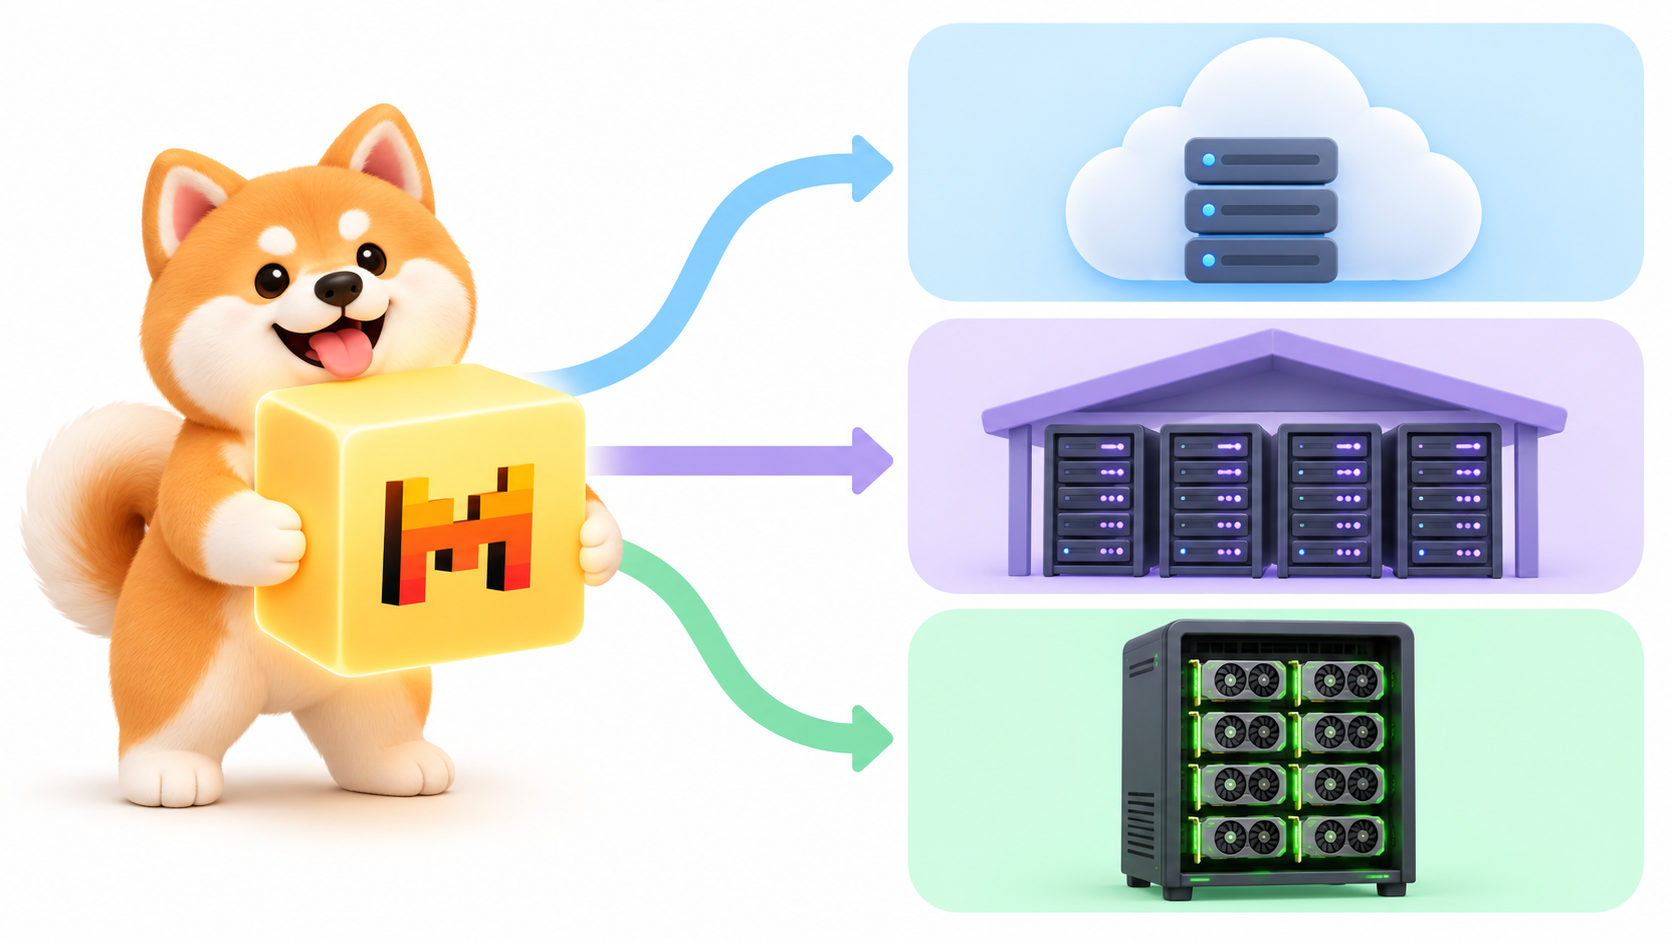
ルート1または2から始めましょう。ルート3への移行は具体的な理由がある場合に行います。ネットワークから出せないデータ、所有する必要のあるファインチューン、または8-GPUノードを稼働させ続けるだけのボリュームなどです。
Mistral Large 4のダウンロード方法
公式リポジトリはゲートされていないため(Hugging Face APIは両方ともgated: falseを報告)、どのアカウントでも匿名クライアントでも取得できます。本当の障壁はサイズです。
| リポジトリ | 形式 | ディスク上のサイズ |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8、公式 | 約1,061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4、公式 | 約610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | 約1,115 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | 約635 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | 約381 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | 約298 GB |
これらは2026年11月2日に各リポジトリのファイル一覧から合計したものです。Unslothもunsloth/Mistral-Large-4-1T-A52B-GGUFとしてGGUF量子化版を公開しています。
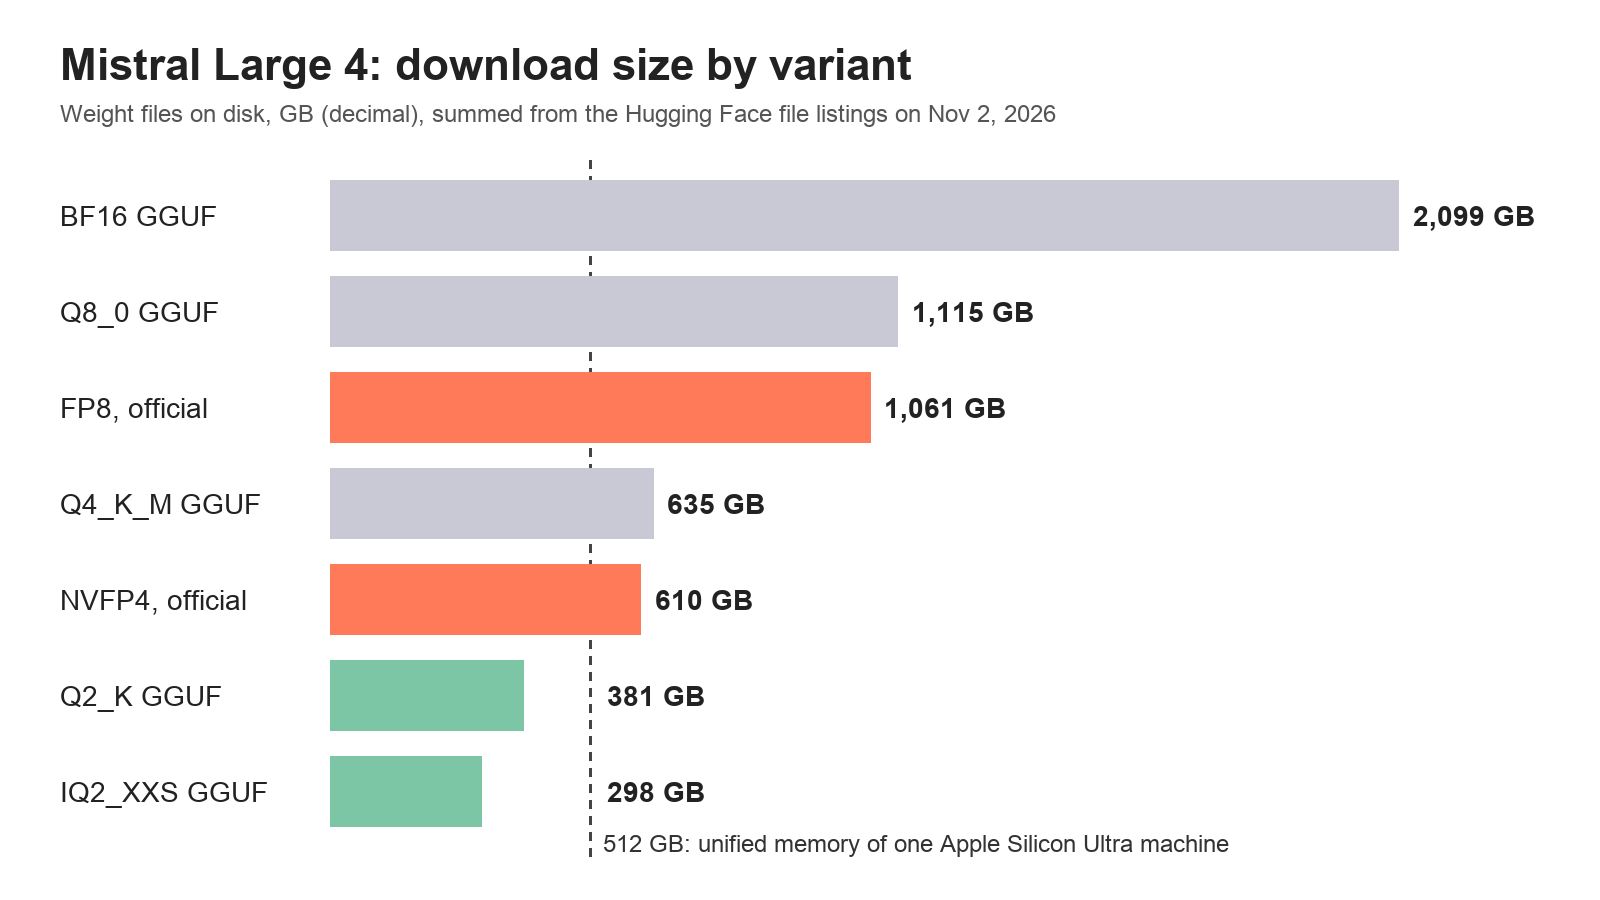
Hugging Face CLIを使って必要なファイルのみをダウンロードしてください。
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
FP8のダウンロードは、1 Gbpsを持続した場合で2時間強かかります。
Mistral Large 4のセルフホスト方法
すべての公式配信例は、8 GPUを搭載した1ノードとテンソル並列度8を前提としています。各エンジンが期待する内容は以下の通りです。
| エンジン | チェックポイント | 公式例でのハードウェア |
|---|---|---|
| vLLM | FP8 | 8 GPU、--tensor-parallel-size 8。Hugging Face Inference Endpointsは8x H200を使用 |
| vLLM | NVFP4 | 8 NVIDIA Blackwell GPU |
| SGLang | FP8 | 8 GPU、--tp-size 8 |
| Transformers | FP8 | torchrun経由の8 GPU |
| llama.cpp | Q2_K GGUF | 512 GBのユニファイドメモリを搭載した1台のApple Silicon Ultraマシン |
vLLM
モデルカードはvLLMを推奨しており、専用のDockerイメージを提供しています。
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
両方のパーサーフラグを維持してください。そうしないと、思考テキストがcontentに混入し、ツール呼び出しが生のテキストとして届きます。より高速なデコードのために、カードにはオプションのDSpark投機的デコーダが記載されています。--speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'を追加してください。
そのドラフターを使った8x H200での測定では、Hugging Faceは1リクエストあたり約65トークン/秒、負荷時に1,000件のShareGPT会話全体で合計約480トークン/秒を計測しました。
SGLangも同様に動作します。モデルカードのsglang serve例では、--tp-size 8、--speculative-algorithm DSPARK、そしてauto推論・ツール呼び出しパーサーを使用しています。
Macでのllama.cpp
llama.cppチームは初日からサポートを提供しました。Q2_K量子化版(381 GB)は、512 GBのユニファイドメモリを搭載した1台のApple Silicon Ultraマシンに収まります。
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Faceによると、1台のM3 Ultraでプリフィル約90トークン/秒、生成15トークン/秒です。プライベートな実験には十分ですが、エージェントループには遅いです。2ビット量子化は品質も低下するため、まず自分のタスクでテストしてください。
Mistral推奨のサンプリングは、すべての推論レベルでtemperature=1.0とtop_p=0.95です。
セルフホストモデルの呼び出し
vLLMとSGLangはどちらもOpenAI互換サーバを公開しているため、リクエストは通常のチャット補完と同じに見えます。
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
ホステッドAPIでは、同じボディを"model": "mistral-large-4"とBearerキーを付けてhttps://api.mistral.ai/v1/chat/completionsに送信します。vLLMのOpenAI互換サーバドキュメントに、受け付けるフィールドが記載されています。
Apidog CLIでClaude Codeに両方のエンドポイントをテストさせる
セルフホストモデルは静かに失敗します。パーサーフラグの欠落で推論がcontentに漏れ出したり、ツール呼び出しがプレーンテキストで返ってきたりします。curlコマンドを手で貼り付ける代わりに、コーディングエージェントにApidog CLIで両方のルートをチェックさせましょう。
一度セットアップします。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
次にClaude Codeに1つのプロンプトを与えます。
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
エージェントは各スキーマを読み、ペイロードを検証し、ケースを実行します。
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
Apidogアプリで実行結果を確認するには--upload-reportを追加するか、同じapidog run ... -r junitの行をCIに組み込んで、vLLMのアップグレードが壊れたツール呼び出しとともに出荷されないようにしましょう。Claude CodeでのApidog CLIガイドでセットアップをより詳しく説明しています。ApidogのFreeプランは最大4ユーザーまでカバーします。
ライセンス:できることとできないこと
Mistral Ecosystem Open-Weight LicenseはMITに1つの条件を加えたものです。
できること:コピーに著作権と許可表示を保持する限り、モデルとその派生を商業・非商業目的で実行、デプロイ、ファインチューン、改変することができます。
Mistralから別途商用ライセンスが必要な場合:「Model as a Service」として実行する場合。ライセンスはこれを、第三者にモデルまたはその派生への推論またはポストトレーニングのためのアクセスを提供することと定義しています。
この条件が適用されない場合:内部使用、モデルが特定の機能やハーネス内に存在するエンドユーザー製品、他者がホストするモデルにリクエストを単に中継する場合、Mistral自身の製品を通じた使用などです。
内部コーディングアシスタントやモデル上に構築された製品機能は問題ありませんが、生の推論の再販売には契約が必要です。これは要約であり、法的助言ではありません。
別のオープンウェイトモデルに関する同様のウォークスルーについては、GLM-5.3セルフホストガイドをご覧ください。
セルフホストすべきか、APIを呼び出すべきか?
ボリュームが控えめな場合、サーバ制限を調整せずに100万コンテキストを使いたい場合、またはすでに8-GPUノードを運用していない場合は、APIを呼び出しましょう。100万トークンあたり入力$0.70、出力$2.10では、月に1億入力トークンと2,000万出力トークンで、キャッシュ割引を考慮する前で$112になります。
データをネットワークから出せない場合、ファインチューンを所有したい場合(Hugging Faceは8x B300ノードでのTRLによるLoRAトレーニングを示しています)、または安定したボリュームでノードを稼働させ続ける場合にはセルフホストしましょう。MistralのForgeサービスは、自分のデータでチューニングするためのマネージドオプションです。
FAQ
Mistral Large 4のオープンウェイトは無料でダウンロードできますか?
はい。Hugging Face上の両方の公式リポジトリはゲートされていないため、アクセスをリクエストすることなくダウンロードできます。コストがかかるのは実行する場合です。公式FP8チェックポイントは約1,061 GBで、配信例は8台のデータセンターGPUを使用します。
Mistral Large 4を単一GPUで実行できますか?
1 GPUをカバーする公式レシピはありません。vLLM、SGLang、Transformersのすべての例はテンソル並列度8の8 GPUを使用しています。文書化されている最小の構成は、512 GBのユニファイドメモリを搭載した1台のApple Silicon Ultraマシンでの381 GBのQ2_K量子化版によるllama.cppです。
Mistral Large 4はオープンソースですか?
オープンウェイトであり、OSIの意味でのオープンソースではありません。商用利用を許可する修正MITライセンスの下でウェイトを入手できますが、モデルを推論またはポストトレーニングサービスとして第三者に提供するには、Mistralからの別途商用ライセンスが必要です。
オープンウェイトモデルはAPIモデルと同じですか?
Mistralによると、リリースされたチェックポイントは10月6日のプレビュー後に3週間の追加強化学習を受けており、APIは更新されたモデルをmistral-large-4として提供しています。推論モードも変更されました。low、medium、またはhighを使用してください。
Mistral Large 4 APIの料金はいくらですか?
2026年11月2日時点で、Mistralは100万入力トークンあたり$0.70、100万キャッシュ入力トークンあたり$0.07、100万出力トークンあたり$2.10を提示しています。