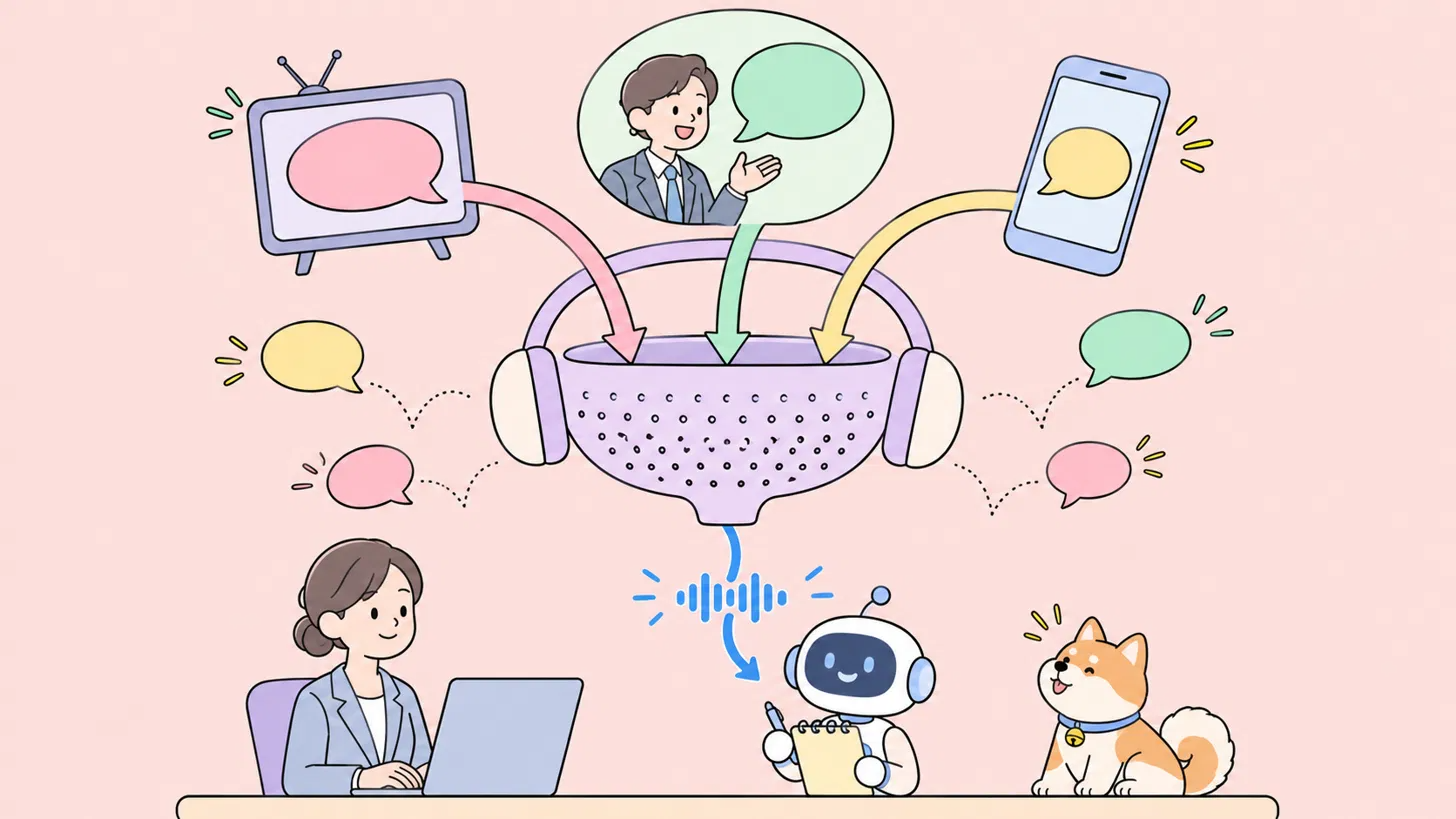
ボイスエージェントが実際の通話で失敗するとき、その原因が LLM や音声にあるとは限りません。問題はその一歩手前、エージェントが「聞いている」音声の段階ですでに発生しています。音声認識(STT)に渡る場合も、Speech-to-Speech モデルに直接入力される場合も同じです。最新の STT は交通音やエアコンの音なら問題なく処理できます。しかし、どうにもできないのが「二人目の話者」です。同僚の声、テレビの音、コールセンターで隣のデスクにいるエージェントの声。STT はそれらの声も聞き取ってしまい、発信者が一度も言っていない言葉にエージェントが反応してしまうのです。
Krisp Voice Isolation は STT の手前に配置され、メインスピーカー以外のすべての声を除去します。このレビューでは、Krisp のベンチマークとドキュメントを読み、セルフサービス API に登録し、Krisp の公開データセットから 8 件の実際の録音を API に通してみました。そのうえで、処理前後の音声をオープンソースの STT モデルで文字起こしし、何が実際に変化したのかを確認しました。
結論を先に言うと: エージェントがオフィス、家庭、コールセンターなど、背景で誰かが話している環境から着信を受けるのであれば、Voice Isolation をパイプラインに組み込む価値は十分にあります。私のテストでは、331 語もの偽のトランクリスト(誤認識テキスト)を生み出していた背景音声がゼロになりました。トレードオフは確かにありますが、ごく小さいものです。クリーンな電話音声でのわずかなコスト増、API リージョンが米国のみ対応、SDK と比べて API で利用できるモデルが少ないこと。
問題は「背景の雑音」ではなく「背景の話し声」
STT(音声認識)モデルは、音声を捉えるようには訓練されていますが、どの話し声が重要かを判断するようには訓練されていません。ノイズは音声の形をしていないため、フィルタリングできます。しかし、他人の声はまさに音声そのものなので、音声として認識されてしまうのです。
Krisp自身の例が分かりやすいでしょう。通話者がサブスクリプションの解約を依頼している間に、近くの同僚がランチの話をしていたとします。STTは1つの単語ストリームを返すだけで、どの言葉が通話者によるものかを示す情報は一切ありません。その結果、オペレーター(エージェント)は両方の発言を1つのリクエストとして受け取ってしまいます。
これが音声エージェントを壊すメカニズムは3つあります。
- 誤った文字起こし。 通行人の言葉がトランスクリプトに混ざり込み、LLMが通話者が一度も言っていないことに回答してしまう。
- 誤検知による割り込み。 エージェントが通行人の声を聞き、通話者が口を挟んだと勘違いして、文章の途中で話を止めてしまう。
- ターン交替(発話の区切り)の崩壊。 背景の話し声があると通話者がまだ話しているように見えるため、エージェントが発話の終わりを判断できない。
いずれの場合も、エージェントのロジックは設計どおりに動作しています。問題は、本来聞くはずのなかった声に反応してしまっていることです。
このギャップがどれほど大きいかは、数字が物語っています。KrispのVoice Isolation 2.5リリーステストでは、クリーンなsingle-speaker音声に対して、10のSTTシステムの平均単語誤り率(WER)は2.10%でした。ところが、通話者に重なって別の人が話すと、同じシステムの平均は35.92%に跳ね上がりました。ノイズ抑制ではこのギャップは埋められません。なぜなら、干渉しているのは音声そのものだからです。
...preserve everything exactly...
Krisp Voice Isolationとは
Krisp Voice Isolation API & SDKは、ライブ音声ストリームから背景の声やノイズを除去し、メインの話者の声だけを後段に渡します。音声AIエージェント向けに構築されており、Krispが「Background Voice Cancellation(BVC)」という名称で人間同士の通話向けに提供しているのと同じコア技術です。
エージェントのパイプラインの最初に配置されるため、その後のすべてのモデルが1人の話者の声だけを認識します:
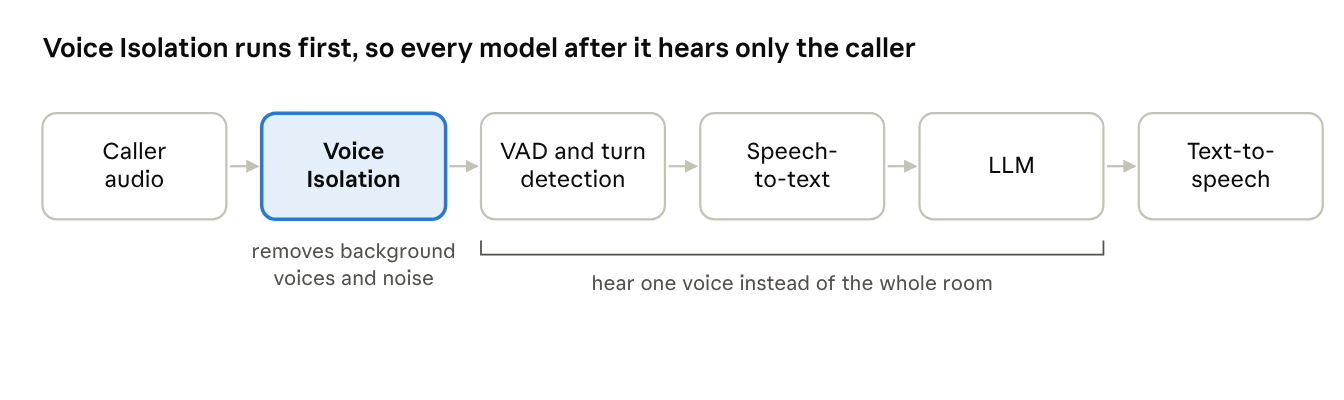
Voice Isolationが音声エージェントパイプラインのどこに位置するか
この配置が重要です。これがないと、VADやターン検出が傍観者の声も拾ってしまい、これが誤った割り込みの原因になります。
Krispは音声AIに約9年取り組んでおり、年間1兆分を超える音声を処理していると述べています。Voice Isolationは、 音声AI APIおよびSDKラインナップの製品のひとつです。Voice Isolationは、Krispの音声エージェント向けリアルタイムモデル群「VIVA」の一部で、Turn-Taking、Interrupt Prediction、VADと並んで提供されています。ターンテイキングに取って代わるものではなく、それと連携して動作します。
この4つのモデルにより、背景の声やノイズをどの程度積極的に除去するかを制御できます。最も積極的な設定(デフォルト構成)では、Default が最も多く除去します。Balanced は同じ計算量で、メインの声をより軽めに処理します。Lite は Default の約3分の1の計算量で動作します。HD は電話音声ではなく、32 kHz の WebRTC ストリーム向けのモデルです。積極さ(aggressiveness)は計算量を変えずに調整できるランタイム設定で、API では 0 から 100 の範囲で指定する suppression_level パラメータです。
事前に知っておくべき制限として、声を除去するモデルは話者がマイクの近くにいることを前提としています。目安として、約30 cm 以上離れると、メインの話者自身の声まで抑制される可能性があります。これは厳密なルールではなく一般的な推奨値であり、実際の距離は音響条件によって異なります。スマートスピーカーのような遠距離(ファーフィールド)デバイス向けには、Krisp がノイズのみを除去する別のモデルを提供しています。
バージョン2.5は2026年8月にリリースされ、Krisp は9月に公開ベンチマークとデータセットを発表しました。このモデルは現在、セルフサーブ型の API としても SDK としても利用可能です。
Krispのベンチマークが示すもの
Krispの公開ベンチマークによると、Voice Isolationにより平均単語誤り率(WER)が23.24%から6.24%へと73%低下しました。
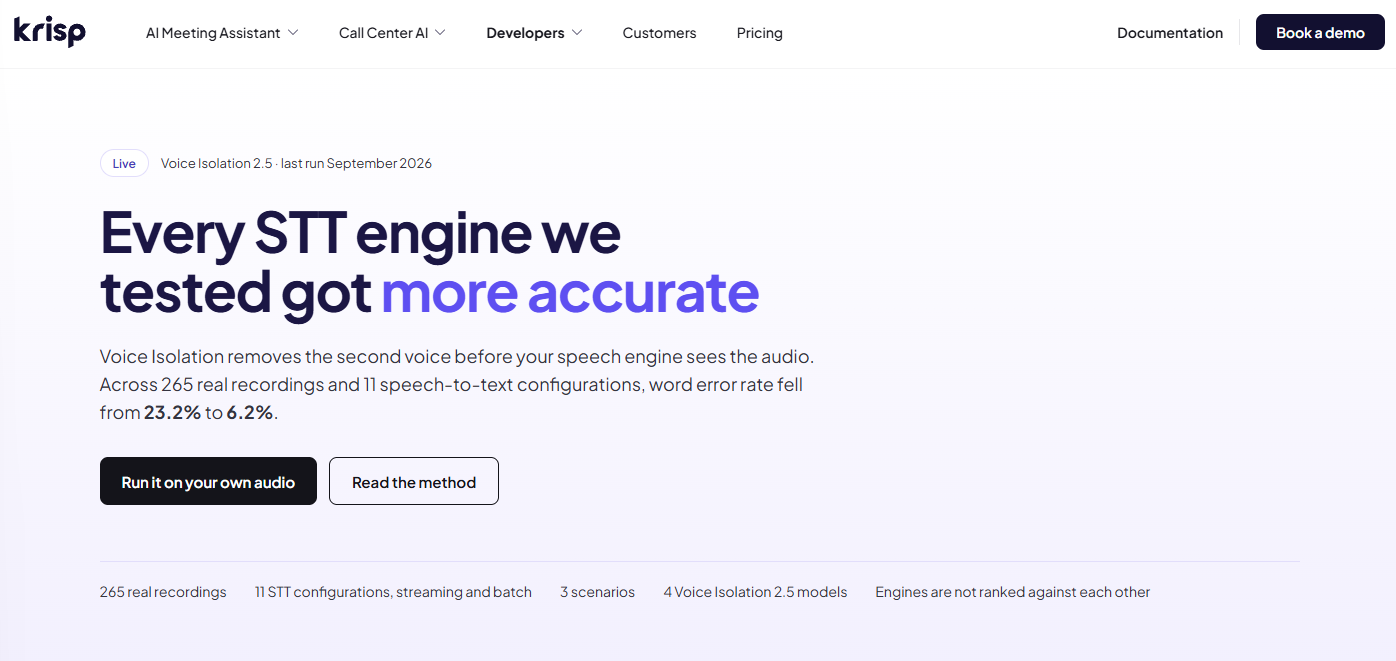
Krispのベンチマークページにこの主要な結果がまとめられています。
このベンチマークでは、オフィス、家庭、コールセンターの4フロア、車内での265件の実録音を使用しています。シミュレーションや後からのミックスは一切ありません。ほとんどの録音は同じシナリオに沿っています。まず主要話者が話し、次に別の人が加わり、主要話者が沈黙している間にもう一方が話し続け、その後主要話者が再度話し始めるという流れです。この沈黙の区間が本当の試金石となります。なぜなら、この区間の正解トランスクリプトは「空」だからです。各ファイルは9つのエンジンによる11のSTT構成に対して、アイソレーションありとなしの両方で処理されました。
出典: Krisp voice isolation benchmark、2026年10月 · 11のSTT構成、全シナリオの合計
すべてのエンジンが改善し、悪化したものは一つもありませんでした。より有用なのは、エンジン間の差がどう変化するかという点です。生オーディオでは約20ポイントあった差が、アイソレーション後には約5ポイントに縮まります。エージェントが背景の話し声を拾っているなら、STTベンダーを乗り換えるよりも入力をクリーンにする方がWERに大きな影響を与えるということです。
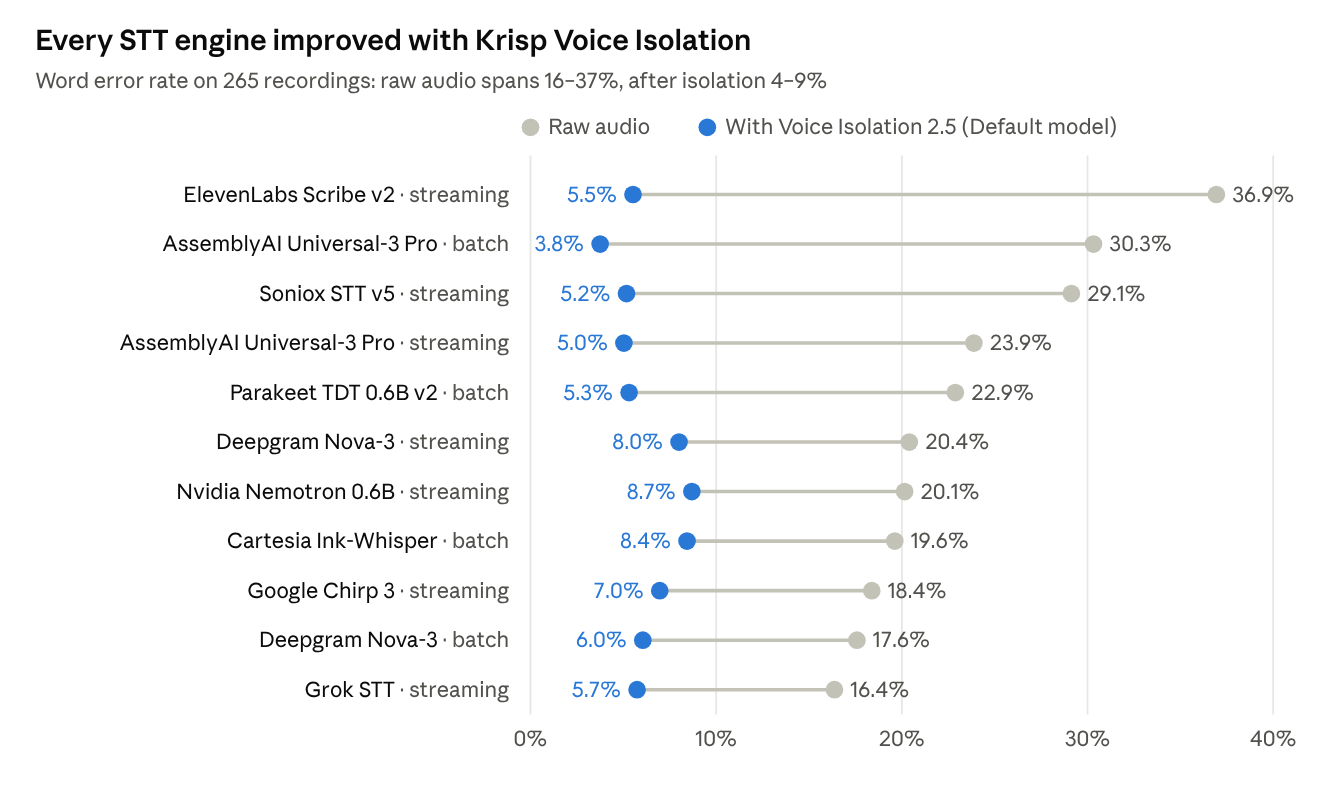
シナリオ別に見ると、改善幅は別の話者の声が存在するかどうかに依存します。
効果がないケース
Krispは自社製品の弱点を公表しており、それがこの記事で最も説得力のある部分だと私は思います。
- クリーンな電話音声はむしろ少し悪化します。除去すべき第二の話者声がないため、アイソレーションは主音声にしか干渉できません。電話通話のWERは3.48%から3.91%に上昇し、あるファイルでは9.42%から21.65%に悪化しました。このケースではBalancedモデルが最も優れており、3.53%にとどまっています。
- 重度のエコーは依然として課題です。別の2.5リリーステストでは、困難な音響環境での単一話者録音が、アイソレーションありで11.61%、なしで8.02%という結果でした。バージョン2.1(15.42%)よりはるかに改善されていますが、アイソレーションなしよりはまだ劣っています。
- 過剰なアイソレーションによる「サイレントエラー」。Krispの説明によると、以前のモデルでは主音声の一部が削除されることがありました。人間の耳には音声が問題なく聞こえるのに、STTでは文節ごと欠落し、隙間だらけながらも一見きれいに読める文字起こしが生成されていました。この問題を解消するため、バージョン2.5は人間の耳ではなくSTTに合わせて調整されました。
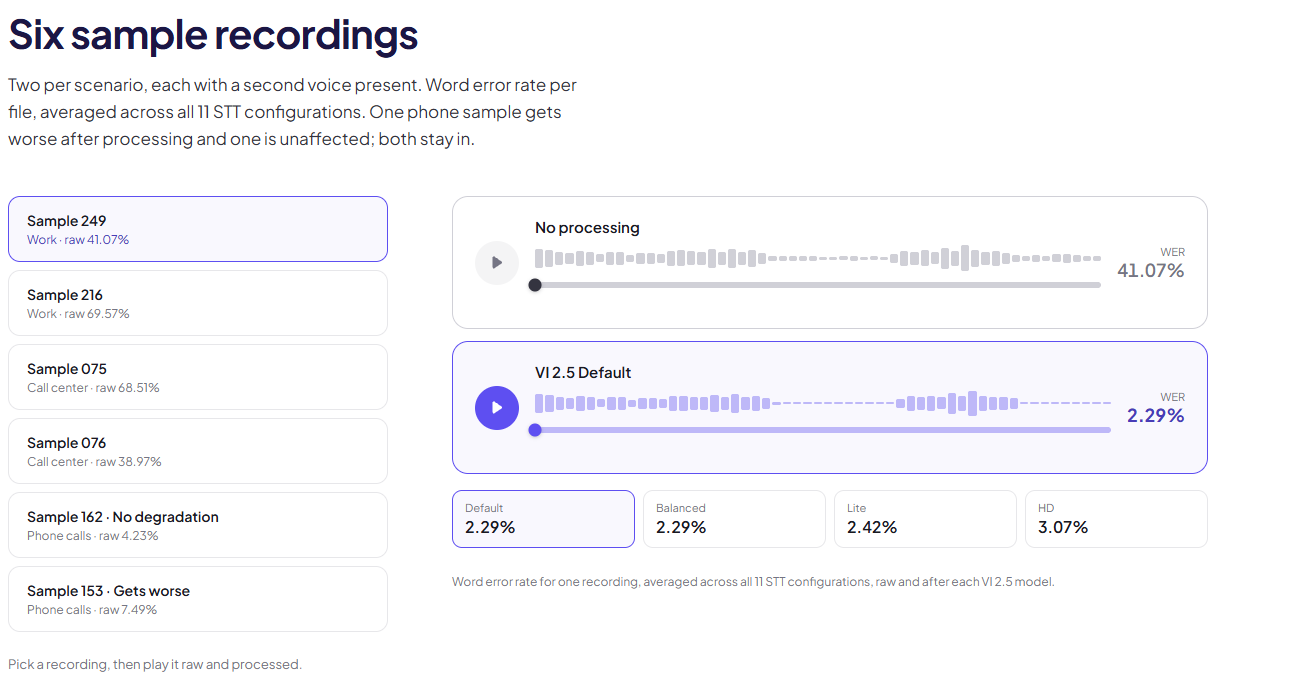
ベンチマークページでは、6つの録音を処理前と処理後で再生できます。サンプル153(電話通話)には「悪化する」というラベルが付いています。
他にも念頭に置くべき点が2つあります。Krispのサイトに記載されている73%と46.4%という数字は、それぞれ異なるテストに基づいています。公開ベンチマークの265件の録音と、2.5リリーステストの1,685件の録音です。また、Krispの結果は、自社のアイソレーションありとなしの比較であって、他社のアイソレーション製品との比較ではありません。
録音データ、手書きの文字起こし、セグメントラベル、そして各モデルの出力はすべてHugging Faceで公開されていますので、誰でもこのテストを再実行できます。そこで私も次にそれを試してみました。
ハンズオン:Voice Isolation API を試してみた
実際にテストしてみたところ、Voice Isolation はトランスクリプトから背景の発話をすべて取り除き、プールした WER は 40.1% から 10.2% まで低下しました。
セットアップ
Developers Portal への登録は、Google、Microsoft、メールのいずれかでサインインでき、あっという間に完了します。トライアルでは 30 ドル分のクレジットと同時 2 セッションまでの利用制限が与えられました。あとは API Keys → Create key と進むだけで、一度しかコピーできない API キーが発行されます。
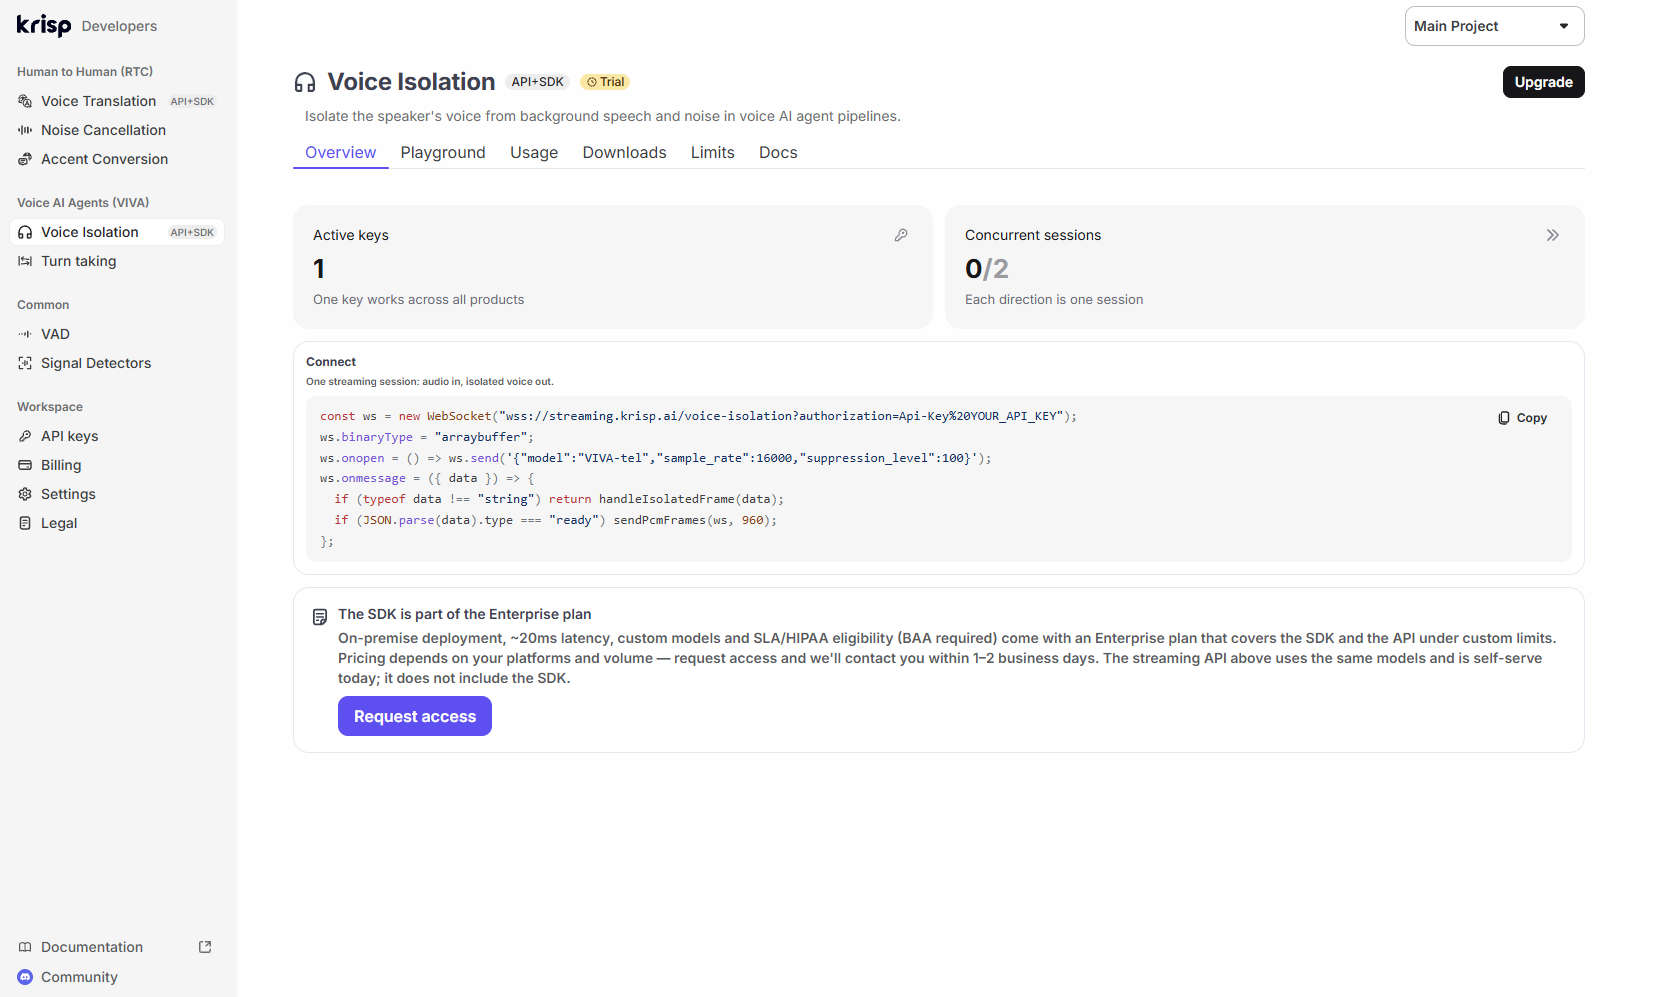
トライアルプランの Developers Portal にある Voice Isolation ページ。
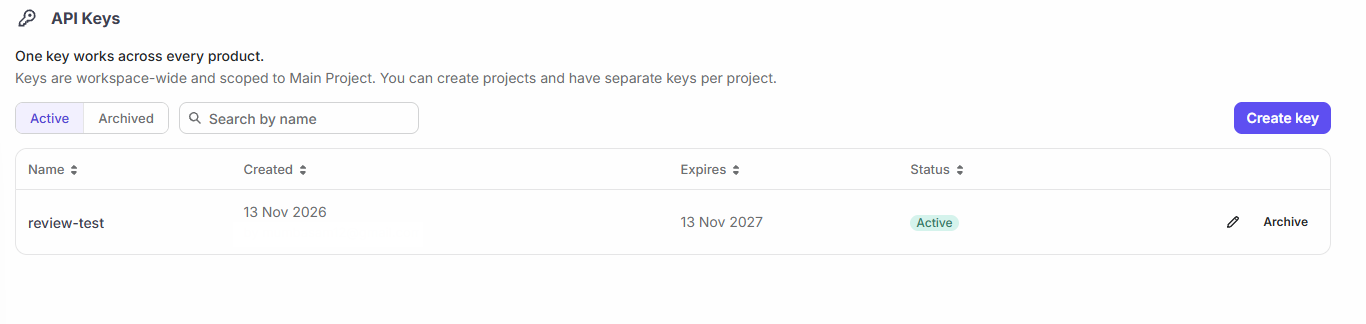
本レビュー用に作成した API キー。1 つのキーで、 Voice Translation API を含むすべての Krisp API 製品を利用できます。
この API は WebSocket ベースです。バックエンドが API キーを短期間有効なセッショントークンに交換し、クライアントが小さな JSON の hello を送信して ready を待ち、その後 16 ビットのモノラル PCM をストリーミングすると、クリーンアップされた音声がフレームごとに返ってくる仕組みです:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
これは Krisp の公式API クイックスタート(WAV ファイルをクリーンアップする短い Python スクリプト)に近いものです。ハマりやすいポイントが 1 つあります。すべての音声メッセージは正確に 30 ミリ秒でなければならないということです。それ以外の長さだと invalid_frame_duration エラーでセッションが終了してしまうため、最後のフレームは無音でパディングしましょう。
テストには、Krisp の公開データセットから 8 件の録音を選びました。オフィス環境の録音 3 件、コールセンターのフロアでの録音 3 件、車内での電話 2 件で、合計約 11 分です。それぞれをリアルタイム速度で API に(アジアから)ストリーミングしました。そして、元の音声とクリーンアップ後の音声を、Krisp のベンチマークにも使われているエンジンの 1 つである NVIDIA のオープンソース Parakeet TDT 0.6B v2 で文字起こしし、ラベル付きの各セグメントを人間のトランスクリプトと照合してスコア化しました。
結果
改善のほぼすべては、あるひとつの場所から来ていました。それは、メインの話者が沈黙している間に他の誰かが話し続けていた区間です。生の音声では、Parakeet はその背景音声を331語のトランスクリプトに変換しました。Voice Isolation を適用した後は、何も出力されなくなりました。これらの区間では背景の声はメインの話者より13〜34 dB小さかった一方で、メインの話者のレベルはほとんど変化していません(1 dB以内)。
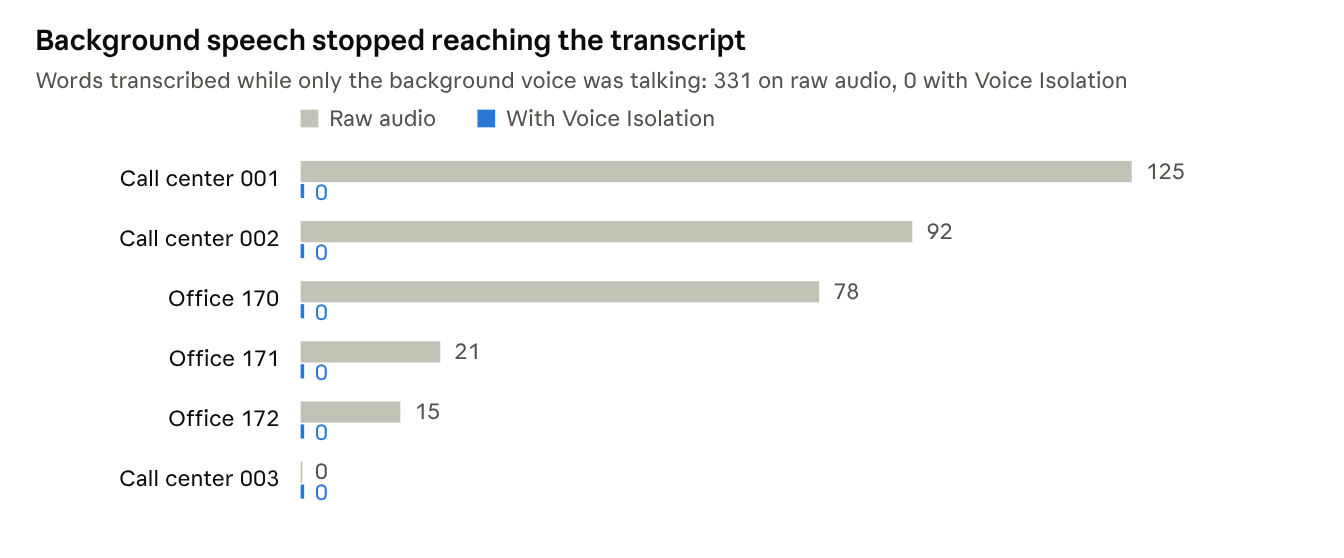
私のテスト · Krisp API(VIVA-tel)、Parakeet TDT 0.6B v2 で文字起こし · 背景音声のみの区間を含む6つの録音
コールセンターの例は、これがなぜ重要なのかを示しています。テスト対象のエージェントが話を止めている間、隣の席のエージェントは別の通話中でした。生のトランスクリプトはその通話を一字一句拾い上げていました。
thank you for calling meridian bank before i begin i will need to confirm your identity for security could you give me your full name your date of birth...
音声エージェントはこれを発話者の発言として扱ってしまいます。Voice Isolation を使うと、同じ区間は空の結果として返ってきました。
両者が同時に話していた場合の変化は小さく、生の状態で13.2%、クリーンアップ後で12.5%でした。こうした区間では、Parakeet はすでに、より大きくより近い声を優先していました。そこに残る誤りの大部分は、採点側の数値フォーマット(電話番号、価格、郵便番号)によるもので、両バージョンに同程度影響していました。
2つのクリーンな電話録音については、片方で誤りが1件増え、もう片方では2件減りました。これは、クリーンな音声でのコストは小さいという Krisp 自身の調査結果と一致しています。
米国外からの利用におけるレイテンシと信頼性
この API は現在 US リージョンでのみ稼働しており、Krisp のドキュメントでは、他の地域のクライアントは追加のレイテンシが発生すると注意喚起されています。アジアからの場合、フレーム1つの往復(送信からクリーンアップ済み音声の返却まで)の中央値はセッションによって260〜520ミリ秒で、セッションの確立には通常1.5〜3秒かかりました。これはネットワーク距離によるものであり、モデルの問題ではありません。Krisp はアルゴリズムのレイテンシを15ミリ秒としています。ただし、エージェントが米国から遠い地域のユーザーにサービスを提供している場合、その影響は体感されるでしょうし、自前のサーバー上で SDK を動かせばこれを回避できます。
9つのセッションのうち1つは、約70秒時点で異常終了しました。再実行すると問題なく動作しました。これはサービスというよりアジアからの長い経路のせいだと考えていますが、本番環境では再接続処理を実装しておくべきという教訓です。
このテストについて: 8ファイルという小さなサンプルであり、ベンチマークではありません。テレフォニーモデル(VIVA-tel)用に32 kHz の録音を16 kHz にリサンプリングし、STT エンジンは1つだけを使用し、テキストの正規化はシンプルなままにしたため、絶対値は Krisp のものと比較可能ではありません。確認していたのは変化の方向と規模であり、それは Krisp が報告している内容と一致していました。
開発者体験:API か SDK か
Voice Isolation には 2 つの利用方法があり、どちらを使えるかは契約プランによって異なります。
API を使うのが最も手軽な方法です。モデルファイルを同梱する必要もなく、自分の CPU で何かを実行する必要もありません。ただしトレードオフとして、音声が Krisp のクラウドに送られること、そしてモデルは 4 つではなく 2 つだけになる点が挙げられます。つまり、8 kHz または 16 kHz の電話音声用の VIVA-tel と、32 kHz ワイドバンド音声用の VIVA-pro です。VIVA-pro はまだ API リファレンスには記載されていませんが、ポータルの Playground には存在しており、私のテストでは API もこれを受け付け、Krisp も利用可能であることを確認しています。
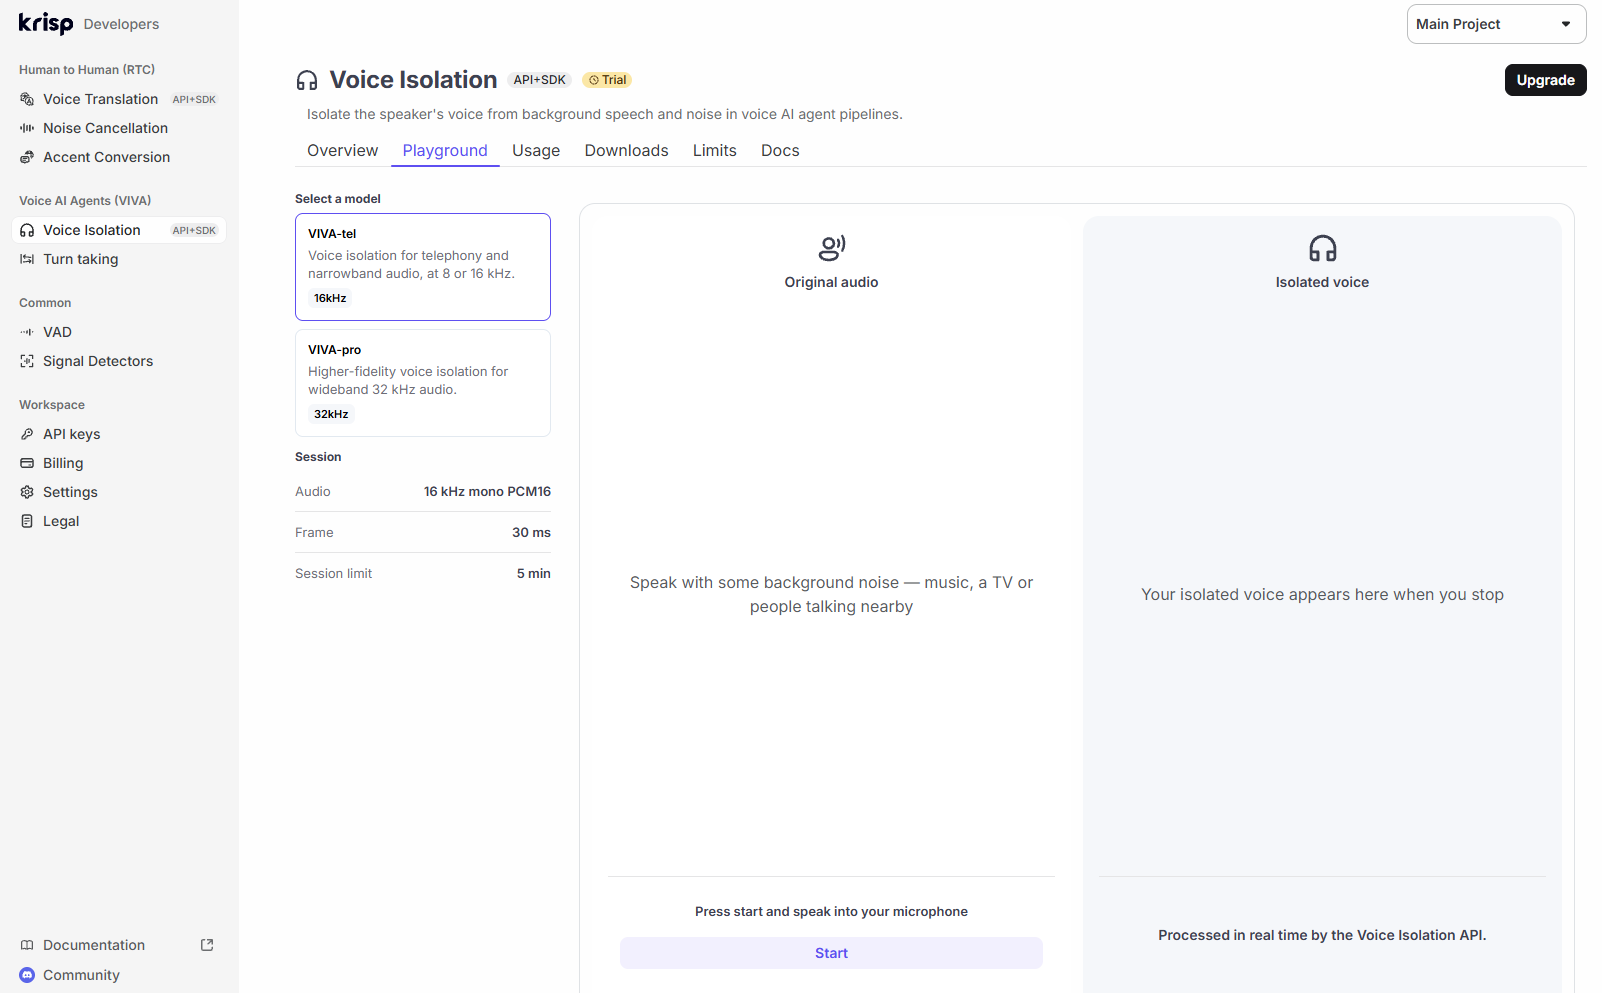
ポータルの Playground では、コードを書く前に自分のマイクを使ってどちらの API モデルでもテストできます。
SDK は音声を自分のサーバー内に保持し、ライセンス確認のときだけオンラインにアクセスします。コストの面でも興味深い話があります。Krisp の CPU に関する記事によると、enableLowPrecisionExecution という SDK のフラグを 1 つ設定するだけで、FP16 対応の CPU 上でサーバーが処理できる通話数がほぼ 2 倍になるそうです。16 vCPU の AWS Graviton3 インスタンスでは、同時通話数が 76 から 137 に増加し、Lite モデルはフルモデルの約 3 倍のストリームを処理できます。なお、古い Intel Ice Lake チップではこのフラグは効果がありません。
統合
- Pipecat にはすぐに使えるフィルターが用意されています。トランスポートのオーディオ入力フィルターとして KrispVivaFilter() を追加するだけで、ターン検出用の KrispVivaTurn と組み合わせることも可能です。ただし、これは SDK を使用するため、API キーだけではなく SDK へのアクセス権とモデルファイルが必要です。
- LiveKit は LiveKit Cloud で Krisp モデルを提供しており、エージェント向けの背景音声キャンセル(noise_cancellation.BVC())も含まれます。LiveKit の音声分離モデルは追加料金がかかります。
- WebRTC や電話のパイプラインでは SDK を直接使用でき、API は WebSocket を開けるものであれば何とでも連携できます。
ドキュメントは明確で最新の状態に保たれています。クイックスタートは初回で問題なく動作し、エラーメッセージも、期待されるフレームサイズと受信したフレームサイズに至るまで、何が問題だったのかを正確に教えてくれます。一点だけ不満なのは命名です。ブログでは Default、Balanced、Lite、HD という名称が使われ、SDK のダウンロードでは krisp-viva-vi-tel-v2.5.1 のようなファイル名が使われ、API ではモデルを VIVA-tel と VIVA-pro と呼んでいます(ただし API リファレンスに記載されているのは前者のみ)。ドキュメントに対応表があると助かるでしょう。
料金体系
APIはオーディオ1時間あたりで課金され、価格は十分に安いので、コストを理由に利用をためらう必要はないでしょう。
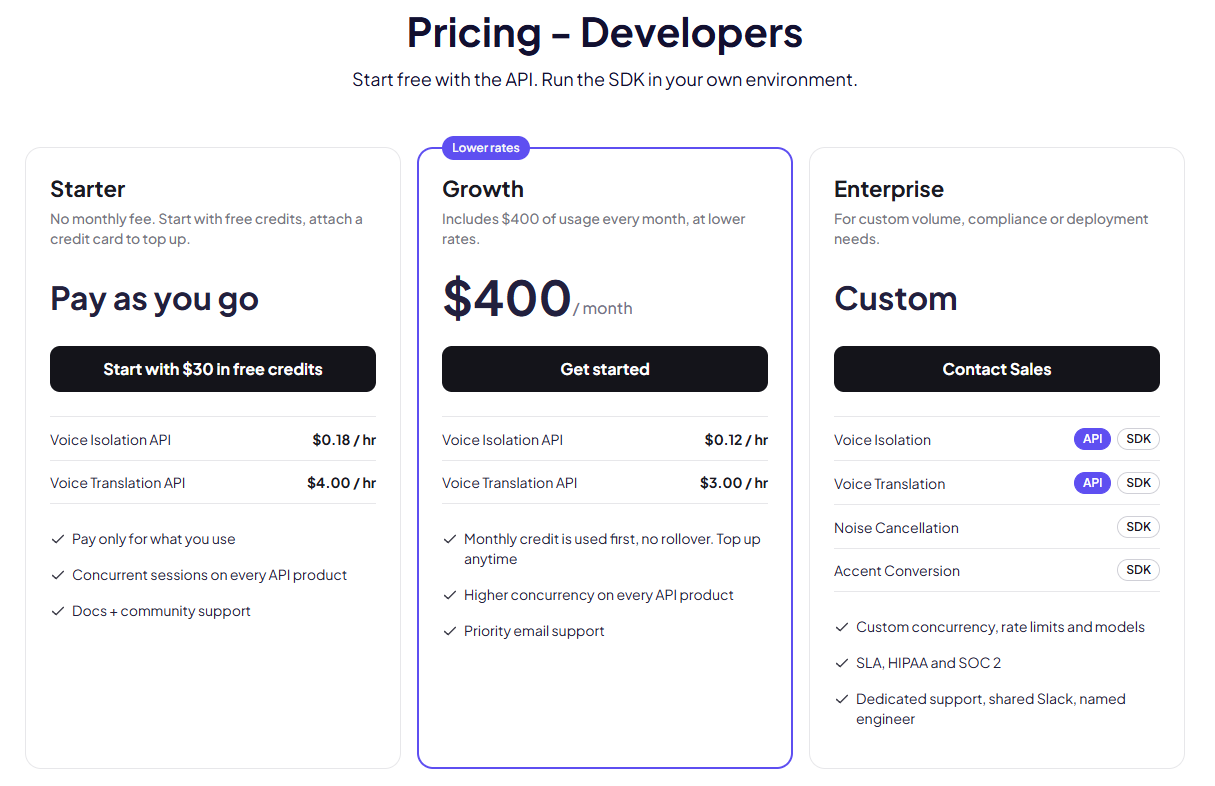
Krispの開発者向け料金(2026年11月時点)。
従量課金制のStarterプランでは、Voice Isolation APIの料金はオーディオ1時間あたり0.18ドルで、月額料金はありません。レートはAPIモデルのVIVA-telとVIVA-proの両方で同じです。Growthは月額400ドルで、400ドル分の利用枠が含まれ、レートは1時間あたり0.12ドルに下がります。また、より高い同時実行数と優先サポートが付きます。Enterpriseはカスタム料金で、SDK、SLA、HIPAAおよびSOC 2対応が含まれる唯一のプランです。
初回クレジットの30ドルは、Starterのレートで約166時間分のオーディオに相当するため、テストには十分な量です。クレジットの有効期限は12か月で、利用は分単位で課金されます。目安として、5分間の通話をStarterでクリーンアップするコストは約1.5セントです。
SDKはEnterpriseプラン限定で、価格は要相談のため、自社サーバーでモデルを実行したい場合はセールスに問い合わせる必要があります。料金はKrispの料金ページからのもので、2026年11月時点で確認済みです。
代替手段
背景の声を除去するツールは Krisp だけではありませんが、これらの製品を同一条件下で比較した独立系のテストはまだ存在しません。各ベンダーが自社のデータに基づく数値を独自に公表しているため、以下の数値はあくまで主張として受け止めてください。
Krisp が際立っているのは、その裏付けとなるデータです。11 の STT 環境を対象としたオープンで再現可能なベンチマークを公開している唯一のベンダーであり、自社が負けたケースまで公表しています。デプロイの柔軟性でも最も優れており、クラウド API、サーバー上の SDK、あるいは LiveKit や Pipecat への組み込みという選択肢があります。
まとめ
Krisp Voice Isolationは、テストでは問題なく動くのに実際の通話でボイスエージェントの調子が悪くなるときに頼りになる解決策です。エージェントが聞くべきでない声を取り除き、すでに使っているSTTとそのまま組み合わせられます。Krispのベンチマークと私自身のテストのどちらでも、同じ結果が確認できました。つまり、背景の話し声が文字起こしに届かなくなるのです。
メリット
- 単なるノイズではなく背景の話し声を除去できる。これはSTT単体では対処できない問題
- 言語ごとの設定や音声登録なしで、あらゆるSTTエンジンで動作
- CPU上で動作し、アルゴリズムの遅延は15ms
- 弱点となったケースまで含めたオープンで再現可能なベンチマーク
- セルフサービスのAPIで30ドルの無料クレジット付き。料金も1時間あたり0.12〜0.18ドルと安価
- Pipecat用の既製フィルターやLiveKitサポートを提供
デメリット
- クリーンな電話音声では認識精度がわずかに低下。エコーの激しい部屋では生音声よりも劣る
- APIは米国リージョンでのみ稼働するため、その他の地域では体感できるほどの遅延が発生
- APIで提供されるモデルはSDKの4つに対して2つ。オンプレミス利用にはEnterprise SDKが必要
向いているチーム:コールセンター、オフィス、自宅、車内など、近くで他の人が話している環境から着信を受けるエージェントを運用しているチームです。まずはAPIで自分の録音データへの効果を測定し、他のモデルが必要になった場合、米国外での低遅延が必要な場合、あるいは音声を自社サーバー内に留めたい場合はSDKへの移行を検討しましょう。
不要なケース:発信者がほとんどの場合、静かな部屋に一人でいるエージェントや、スマートスピーカーのような遠距離対応デバイスには向いていません。音声除去モデルはこうした環境での動作を想定していないからです。
無料クレジットを活用すれば、Krisp Voice Isolation APIを試して、自分の録音データを午後一つかけて処理してみることができます。
FAQ(よくある質問)
ボイスアイソレーションはノイズキャンセレーションと同じですか? いいえ、異なります。ノイズキャンセレーションは、交通音やキーボードの打鍵音など、音声以外のノイズを除去します。ボイスアイソレーションはさらに、他人の声も除去します。ノイズキャンセレーションでは他人の声は残ってしまいます。
Krispのボイスアイソレーションは自分の使っているSTTプロバイダーで動作しますか? はい。オーディオ自体を処理するため、どのSTTエンジンの前段にでも置けます。KrispはDeepgram、AssemblyAI、ElevenLabs、Soniox、Google、Cartesia、NVIDIAのモデルを含む11の構成でテストを行っています。音声間(speech-to-speech)モデルの前段にも配置できます。この構成での結果はまだ公開されていませんが、試してみることを妨げるものは何もありません。
ターン検出の代わりになりますか? いいえ。VADやターン検出の前に配置され、よりクリーンなオーディオを提供するものです。Krispは同じVIVA SDKで、ターン検出(Turn-Taking)を別のモデルとして提供しています。
ユーザーは声の登録(エンロールメント)が必要ですか? いいえ。ユーザーの声の登録も学習も不要です。
レイテンシはどのくらい追加されますか? Krispによるとアルゴリズムレイテンシは15 msで、SDKドキュメントでは追加レイテンシは約20 msとされています。クラウドAPIを使う場合は、それに加えてUSリージョンへのネットワーク時間がかかります。
電話でも使えますか? はい。ナローバンドの電話音声、G.711、G.722、G.729、Opusなどの一般的なコーデック、Bluetoothヘッドセットに対応しています。
人同士の通話ではどうですか? 同じ技術は、KrispのRTC SDKにBackground Voice Cancellation(BVC)として搭載されており、ブラウザ、デスクトップ、モバイルアプリでユーザーのデバイス上で動作します。人間のオペレーターが対応するコンタクトセンターでは、KrispのコールセンターAI製品を通じて利用でき、近くのオペレーターの声が顧客との通話に入り込むのを防ぎます。