
MoonshotのKimi K2.7 Codeは、ほとんどのデベロッパーが実際に料金を支払っている2つのモデル、Claude OpusとGPT-5.5を相手にベンチマークで登場しました。簡単に言うと、クローズドな最先端モデルはほとんどのコーディングタスクで依然として高いスコアを出していますが、その価格が示唆するほどの差はありません。Kimiはダウンロードしてセルフホストできるオープンウェイトモデルであり、レンタルしかできないモデルに数ポイント差で迫っています。
この比較では、数値を並べ、コストとオープン性に対して重み付けを行い、どのタスクにどのモデルを選ぶべきかを示します。
要点
- 生のコーディング品質: ほとんどのスイートでGPT-5.5とClaude Opusがリードしています。Kimi K2.7 Codeは数ポイント差で後れを取っています。
- コスト: Kimiははるかに安価(100万トークンあたり入力$0.95/出力$4.00)で、セルフホストも無料です。クローズドモデルはコストが高く、独自のハードウェアでホストすることはできません。
- オープン性: Kimiは修正MITライセンスのもとでオープンウェイトを提供しています。OpusとGPT-5.5はクローズドです。
- 結論: 最高の単発品質を求めるなら最先端モデルを選び、コスト、量、またはデータ管理が最後の数ポイントよりも重要である場合はKimiを選びましょう。
競合モデルの概要
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| 種類 | オープンウェイト (修正MITライセンス) | クローズド | クローズド |
| アーキテクチャ | MoE, 合計1兆 / アクティブ320億 | 非公開 | 非公開 |
| コンテキストウィンドウ | 256Kトークン | 大 | 大 |
| セルフホスト | はい | いいえ | いいえ |
| 価格 (100万トークンあたり) | 入力$0.95 / 出力$4.00 | 高価、レンタルのみ | 高価、レンタルのみ |
構造的な違いが最大の特徴です。Kimiは何であるかを正確に示し、ユーザー自身で実行できます。他の2つは、呼び出すサービスです。
コーディングベンチマーク
これらはMoonshotが報告したスコアです。いくつかのスイートはMoonshot独自のものであるため、ベンダーの視点として扱ってください。ただし、パターンは一貫しており、読む価値はあります。
| ベンチマーク | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5は最初の2つでトップの座を獲得し、Claude OpusはMLS Bench Liteでリードし、他の場所でも僅差で追従しています。Kimiはそれぞれで一歩及ばない結果となっています。Kimi Code Bench v2では差は小さいものの、Program Benchではより広くなっています。もしあなたの仕事が2つ目のベンチマークに似ているなら、最先端モデルはその価値を発揮します。
エージェントおよびツール使用のベンチマーク
コーディングエージェントの成否は、コード生成だけでなくツール呼び出しにかかっています。ここでは、その差が縮まります。
| ベンチマーク | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
MCP Mark Verifiedでは、KimiはClaude Opusをわずかに上回っていますが、GPT-5.5は大きくリードしています。MCP Atlasでは、3つのモデルは約5ポイント差に収まっています。エージェントワークロードにおいては、Kimiは生のコーディングスコアが示唆するよりも、競合モデルに接近しており、トークンコストが膨らむ場所でこれは重要です。
コスト面でKimiが優位
ベンチマークは品質を測定しますが、費用は測定しません。Kimi K2.7 Codeは、入力100万トークンあたり0.95ドル、出力100万トークンあたり4.00ドルで動作し、キャッシュヒットの場合は100万トークンあたり0.19ドルです。クローズドな最先端モデルはトークンあたりのコストがかなり高く、ホスティングすることでそれを逃れることはできません。ダウンロードは提供されていません。
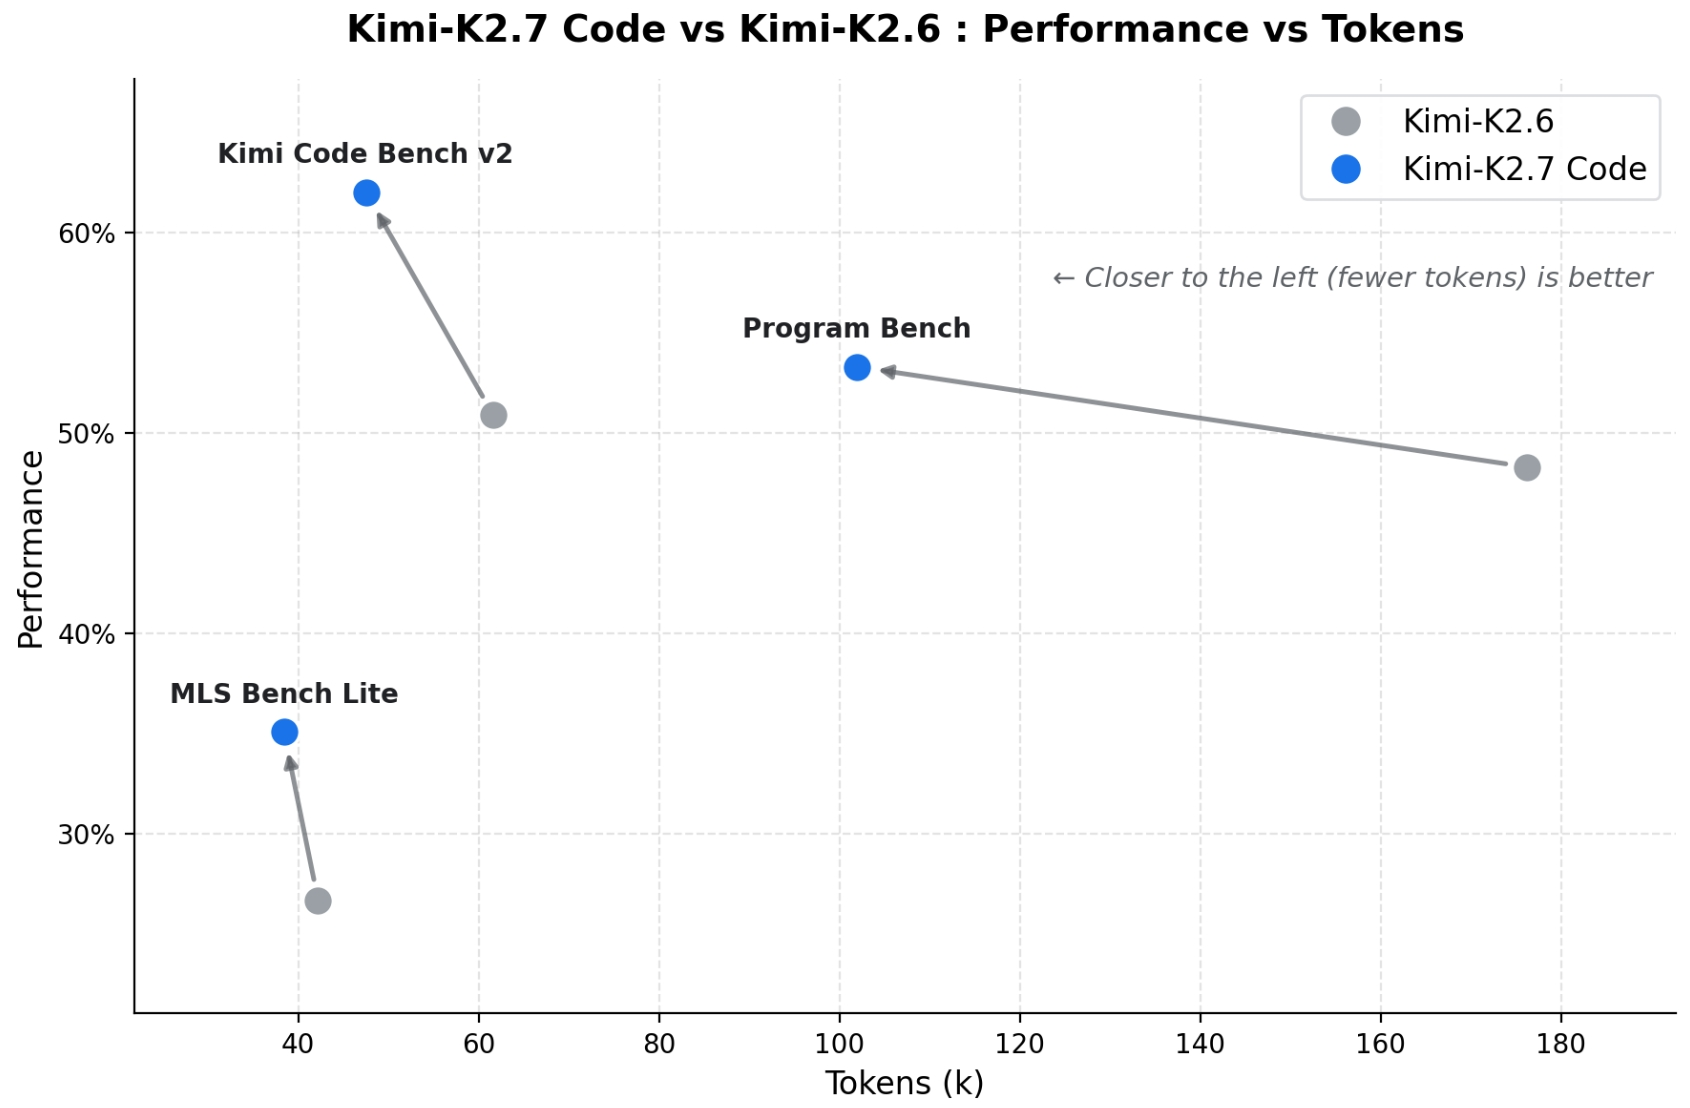
以下の2つの要因で節約効果がさらに高まります。
- オープンウェイトはトークンコストゼロの選択肢を意味します。 独自のハードウェアでセルフホストすれば、トークンあたりのコストは完全に消滅します。その代わりにGPU時間を費やします。
- より効率的な推論。 K2.7 Codeは、同じ作業に対してK2.6よりも思考トークンを約30%少なく使用するため、エージェントの各ステップの費用が削減されます。エージェントのトークンコストを削減する方法に関するガイドで、これがなぜ積み重なるのかを詳しく説明しています。
タスクごとに何百ものツール呼び出しを行うエージェントにとって、わずかな価格で90%の品質を持つモデルは、しばしば総合的な価値で勝利します。
コンテキストとオープン性
3つのモデルはすべて長いコンテキストをうまく処理します。Kimiのウィンドウは256Kトークンで、1つのプロンプトで完全なサービスとそのテストをカバーするのに十分です。より大きな差別化要因はライセンスです。Kimiの修正MITライセンスのウェイトを使用すると、モデルをファインチューニング、監査、エアギャップ環境で実行できます。コンプライアンスやデータレジデンシーの規制があるチームにとって、これはあれば良いというものではなく、決定的な要因であり、クローズドモデルは選択肢から外れます。
それぞれを選ぶべき時
GPT-5.5またはClaude Opusを選ぶべき場合:
- 最高の単発コーディング品質が必要で、数ポイントのベンチマークスコアがコストを正当化する場合。
- 管理されたSLAを持つクローズドサービスをレンタルすることに問題がない場合。
- 最も難しいタスクがProgram Benchのように、差が最も大きい場合に似ている場合。
Kimi K2.7 Codeを選ぶべき場合:
- トークンコストが実行可能性を左右するような、大量のエージェントワークロードを実行する場合。
- データが独自のインフラストラクチャ内に留まる必要がある場合。
- モデルをファインチューニングしたり監査したりしたい場合。
- リーダーボードのトップではなく、全体の価値を最適化している場合。
より広い範囲では、当社のMiniMax M3 vs DeepSeek V4 vs Qwen 3.7比較で他のオープンウェイトの競合モデルを、DeepSeek V4 vs Claude Opusのコーディング比較で別のオープン vs クローズドの対決を掘り下げています。モデルではなくエージェントを比較している場合は、Claude Code vs OpenAI Codexを参照してください。
自分で比較を試す
ベンチマークは出発点であり、あなたのコードベースに対する最終的な判断ではありません。正直なテストは、自身のタスクで3つのモデルすべてを実行し、その結果を読み取ることです。Kimi Code CLIは、まず無料でエージェントを提供しており、各モデルのAPIを直接呼び出して生の出力を比較できます。
その際には、Apidogでエンドポイントをテストしてください。同じプロンプトを各モデルに送信し、呼び出しを並べて保存し、応答品質、レイテンシ、トークン使用量を一箇所で比較できます。Apidogをダウンロードして、比較テストを実行しましょう。
よくある質問
Kimi K2.7 CodeはClaude OpusやGPT-5.5よりも優れていますか? Moonshotが報告したコーディングベンチマークでは、いいえ。クローズドモデルのほとんどのスイートで高いスコアを出しています。Kimiの利点は、オープンウェイトであることと、数ポイント差に留まりながらもはるかに低コストであることです。
Kimiはどれくらい安いですか? 入力100万トークンあたり0.95ドル、出力100万トークンあたり4.00ドルで、セルフホストは無料です。クローズドな最先端モデルはトークンあたりのコストが高く、セルフホストはできません。
Kimi K2.7 Codeを自分で実行できますか? はい。ウェイトは修正MITライセンスのもとでオープンです。vLLM、SGLang、またはKTransformersで提供してください。
コーディングエージェントに最適なのはどれですか? 生の品質ではGPT-5.5がリードしています。費用対効果の高い大量のエージェントワークロードにはKimiがより良い価値を提供し、エージェントベンチマークでも僅差です。
これらのベンチマークは中立的ですか? いくつかのスイートはMoonshot独自のものであるため、ベンダーの視点として読んでください。最先端モデルとの一貫した差が有用なシグナルであり、正確な数字そのものではありません。
まとめ
Kimi K2.7 Codeは、ほとんどのコーディングベンチマークでClaude OpusやGPT-5.5に勝っているわけではありませんし、Moonshotもそう主張していません。数ポイント低いスコアですが、はるかに低コストで、自分で実行できるオープンウェイトを提供しています。最高の品質を求めるなら、クローズドな最先端モデルが依然として優位です。しかし、大量のエージェント、プライベートなデプロイメント、またはチャートのトップよりも全体的な価値を重視する人にとっては、Kimiが賢明な選択肢です。自分のコードで3つのモデルすべてを実行し、Apidogで出力を比較し、あなたのワークロードに判断させましょう。