
ほとんどの人は、チャットボックスを開いてタイピングすることで新しいモデルに出会います。Jevはそのような慣習とは異なります。これはTypeSafe AIのSystem Oneモデルであり、散文を全く生成しません。プログラムの状態と一連の型付けされた質問を渡すと、確率が付与された決定が返されます。この役割の変化が、この手法の全てです。あなたの言語モデルは書き続け、Jevが次に何が起こるかを決定し、あなたのコードがその決定をどうするかを決定します。
このガイドは、呼び出し自体ではなく、呼び出しを囲むアーキテクチャについて説明します。まず入門が必要な場合は、Jevとは何かから始めて、次にTypeSafe自身の発表記事を読んで、会社の枠組みを理解してください。
Jevが優れている点
Jevが行うすべてのことは、3つのプリミティブでカバーされます。noulは、状態に関する1つのステートメントが真である確率を返します。choiceは、基準マップ(最大255オプション)から1つのオプションを選択し、選択されたもの、完全な確率分布、および信頼度を返します。scoreは、状態を2〜10レベルの順序付けられたルーブリックに配置し、レベル、凡例、確率、および信頼度を返します。会社とモデルファミリーに関する背景は、TypeSafe AIに関する私たちの記事にあります。
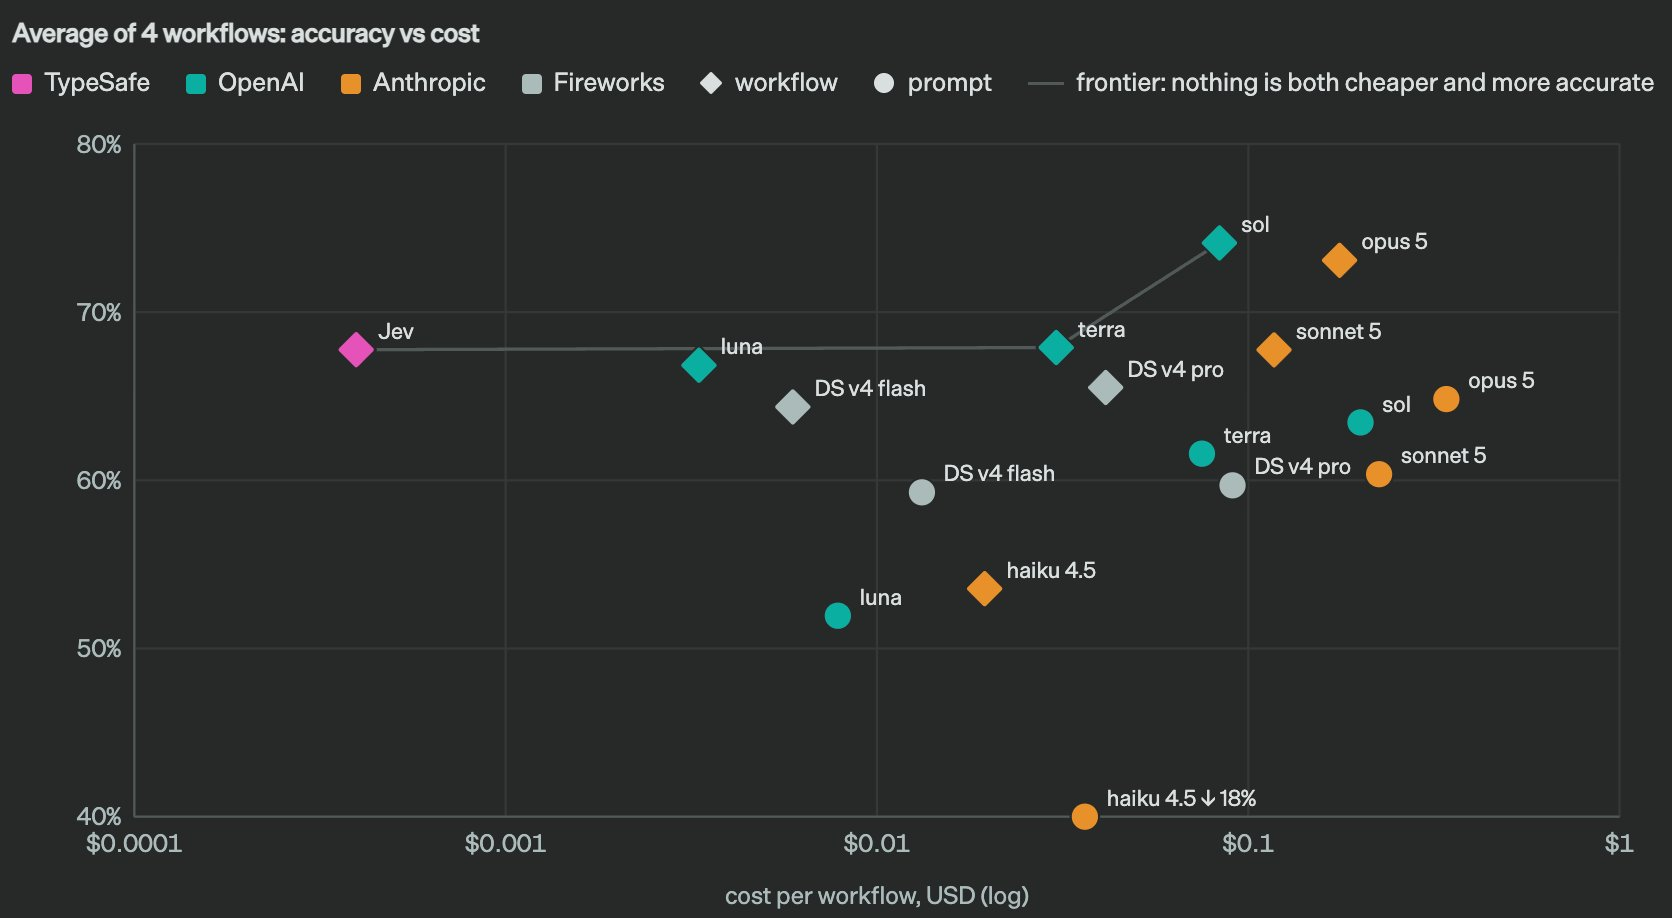
アーキテクチャには4つの特性が重要です。すべての回答は、プログラムがすでに理解している型で届きます。すべての回答はそれ自体の不確実性を伴うため、「不明」は驚きではなく分岐点となります。1つの状態に関する多くの質問が、単一のパスで解決されます。そして、入力トークン100万あたり0.042ドルで、出力トークンは無料なので、サンプルではなくすべてのイベントで質問することができます。
Jevをライターではなく、審査役として実行する
4つの役割が明確に分離されています。
- LLMが生成します。 コード、メールの下書き、要約、計画など。
- Jevが決定します。 リクエストを分類し、リスクを評価し、経路を選択し、事前に記述した基準と照合して出力を確認します。
- あなたのコードが制御します。 しきい値とルールによって、行動するか、再試行するか、エスカレートするか、停止するかを決定します。
- 人間が限界を補足します。 信頼度が低く、かつリスクが高い場合は、人間に委ねられます。
これが分割が機能する理由です。言語モデルは、あらゆるものを出力できるため柔軟ですが、その自由さゆえに、依存するワークフローに組み込むのが難しい場合があります。TypeSafeの考え方では、Jevは「文字列生成を諦める」ことで、その代わりに狭い契約を得ます。つまり、リクエストがサーバーを出る前に可能な回答のセットが固定され、すべての結果は宣言された形状に適合し、不確実性はしきい値と比較できる数値である、というものです。
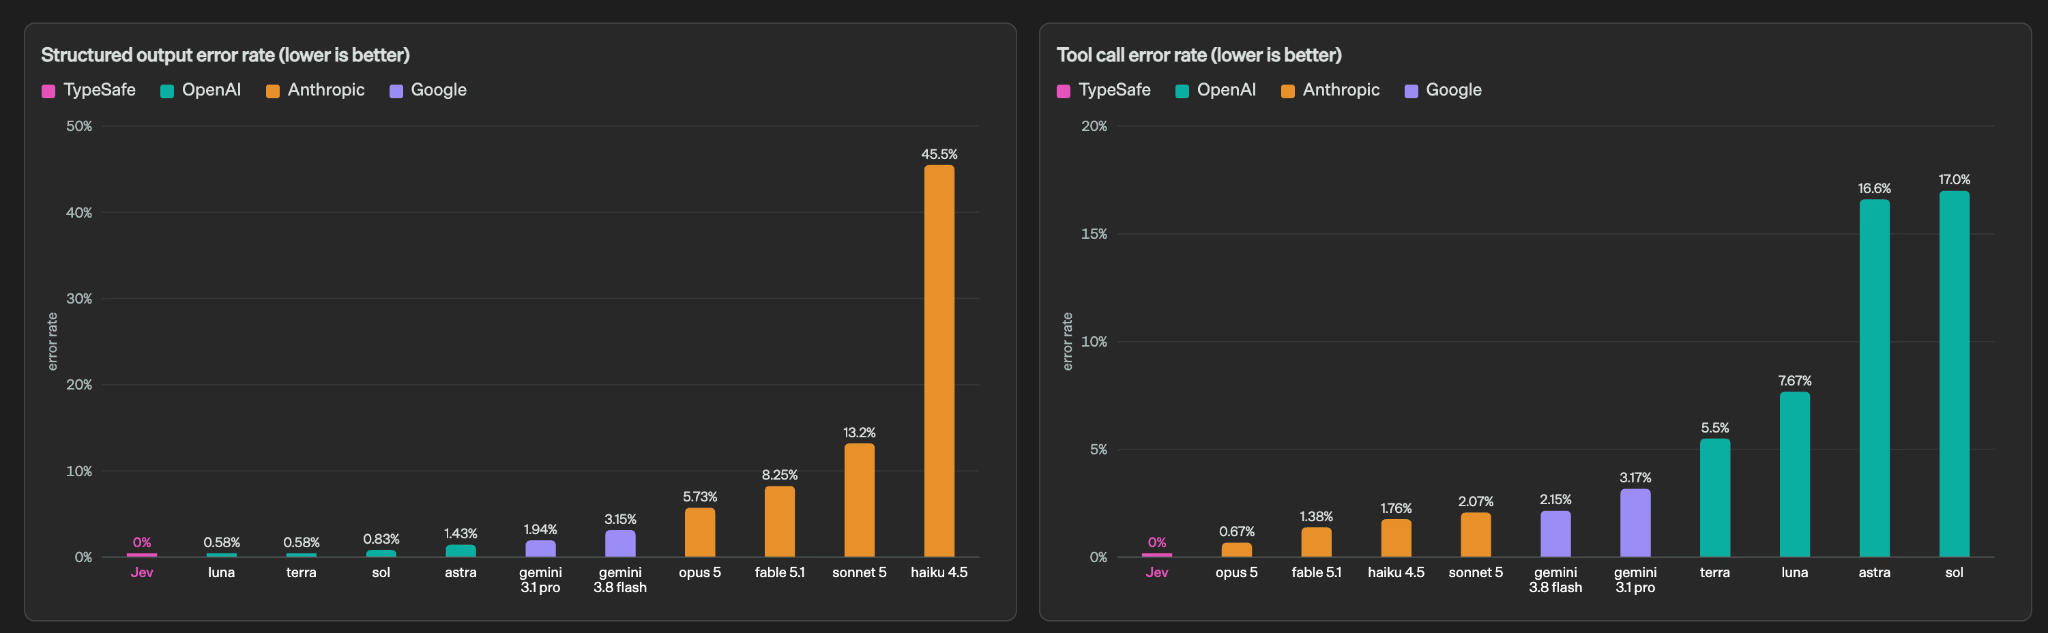
コスト面も同じトレードオフから生じます。TypeSafeは、エンドツーエンドの応答時間が70msから500msであると報告しており、テストしたワークフローでは193.6倍高速で444.6倍安価であると主張しています。これらはベンダーの数値であり、独立したベンチマークではないと考えるべきです。いずれにせよ、構造的なポイントは変わりません。高価なモデルは、実際に何かを記述する必要がある場合にのみ実行され、その周囲で行われる繰り返しの判断は、安価な場所で実行されます。
Jevが回答できる質問の設計
すべてのリクエストは、共有のstateと一連の独立した質問を伴います。Jevは状態を一度読み込み、それらすべてに回答します。サポートトリアージの呼び出しは次のようになります。
{
  "model": "jev-latest",
  "state": {
    "message": "I've been trying to connect Stripe for three days. I'm losing sales and I need this fixed today.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Which team should own this ticket?",
      "criteria": {
        "billing": "Payments, charges, invoices, subscription changes",
        "technical": "Bugs, broken behavior, failing integrations",
        "sales": "Pricing, plans, questions asked before purchase"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "How frustrated is this customer?",
      "criteria": [
        "Calm and matter of fact",
        "Frustrated but civil",
        "Extremely frustrated or threatening to leave"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "The customer needs a resolution today."
    }
  }
}
うまく機能する質問と不安定な質問を分ける3つの習慣があります。
プロンプトの作成をやめる。 ペルソナ、具体的な例、長い前置きはテキストジェネレーターを誘導します。Jevはテキストを生成しません。Jevには状態、1つの原子的な質問、そして各回答が何を意味するかの正確な記述が必要です。記述的な基準は、単なるラベルよりも優れています。「支払い、請求、請求書、サブスクリプションの変更」は、「請求」という単語単独よりも適切にルーティングします。また、Jevに説明を求めないでください。なぜなら、応答には決定、確率、信頼度のみが含まれるからです。
1つの質問、1つの判断。 「このリードは価値があり、緊急で、購入する可能性が高いか?」は、トレンチコートを着た3つの質問です。これらを分割し、コードで結果を結合して、重みを確認したり変更したりできるようにしてください。
モデルから計算を除外する。 Jevは意味を判断します。あなたのプログラムが計算を行い、割引表を適用し、契約条件を確認します。この分離が、システム全体を監査可能にするものです。
TypeSafeはまた、これらの慣習をコーディングエージェントに教えるドロップインスキルも提供しています。これはClaude Codeにclaude plugin marketplace add typesafe-ai/skillsでインストールするか、その他の場所ではnpx skills add typesafe-ai/skillsでインストールできます。詳細はエージェントスキルページにあります。
状態をクリーンに保つ
最大の状態よりも、関連する状態の方が優れています。通常、3つのセクションでカバーされます。すなわち、判断対象のオブジェクト、そのオブジェクトを読み取るのに必要なコンテキスト、そして変更された場合に決定を左右する事実です。それ以外のすべては、送信するために料金を支払うノイズです。
重複するログ行、現在の問題以前の履歴、そしてモデルが到達することを期待する結論を述べる文章は削除してください。1リクエストあたりの上限は64kトークンで、状態と最長の質問には32kが利用可能ですが、その上限に達するずっと前に精度が低下する可能性があります。ルーティングが曖昧になった場合、基準を書き直すよりも状態を縮小する方が通常は迅速な解決策となります。
並列質問と信頼度ゲート
Jevは状態を一度しか読み込まないため、13番目の質問は2回目の往復よりもはるかにコストがかかりません。行動を変えうるすべての独立した判断、つまり意図、リスク、緊急度、感情、関連性、必要な次のステップを送信してください。次に、その回答がコードの動作を一切変更しない質問は削除してください。未使用のシグナルは、見返りのないメンテナンスコストです。
プリミティブを判断の形状に合わせます。重大度、品質、適合性といったグラデーションは、強制的なイエス/ノーではなく、scoreに属します。単一の事実声明はnoulに属します。固定された目的地のセットはchoiceに属します。
ゲートは、実際にアーキテクチャが存在する場所です。型付けされた回答であっても誤った回答である可能性があるため、信頼度が次に何が起こるかを決定します。実行可能な開始パターンの一つは、0.85を超える場合は自動的に実行し、0.55から0.85の場合はより強力なモデルまたは2回目のパスに渡し、0.55未満のものは人間にキューイングすることです。これらの正確な数値は例示です。TypeSafeの信頼度ルーティングパターンは、誤りのコストに基づいてアクションごとに個別のしきい値を設定し、その信頼度ページでは「自身のデータでテストし、結果を観察しながら調整してください」と述べています。しきい値が調整されたら、モデルを固定します。jev-latestは最新の安定版リリースに従いますが、jev-1.13.0は測定した動作を固定します。
Apidogで決定レイヤーをテストする
決定レイヤーは、その動作を証明できる場合にのみ信頼する価値があります。これは、使い捨てのカールコマンドの履歴ではなく、保存されたリクエストとアサーションを意味します。Apidogはこれら両方を提供し、通常APIテストとは異なり、文字列ではなく数値やEnum値をチェックするため、アサーションの見た目も異なります。
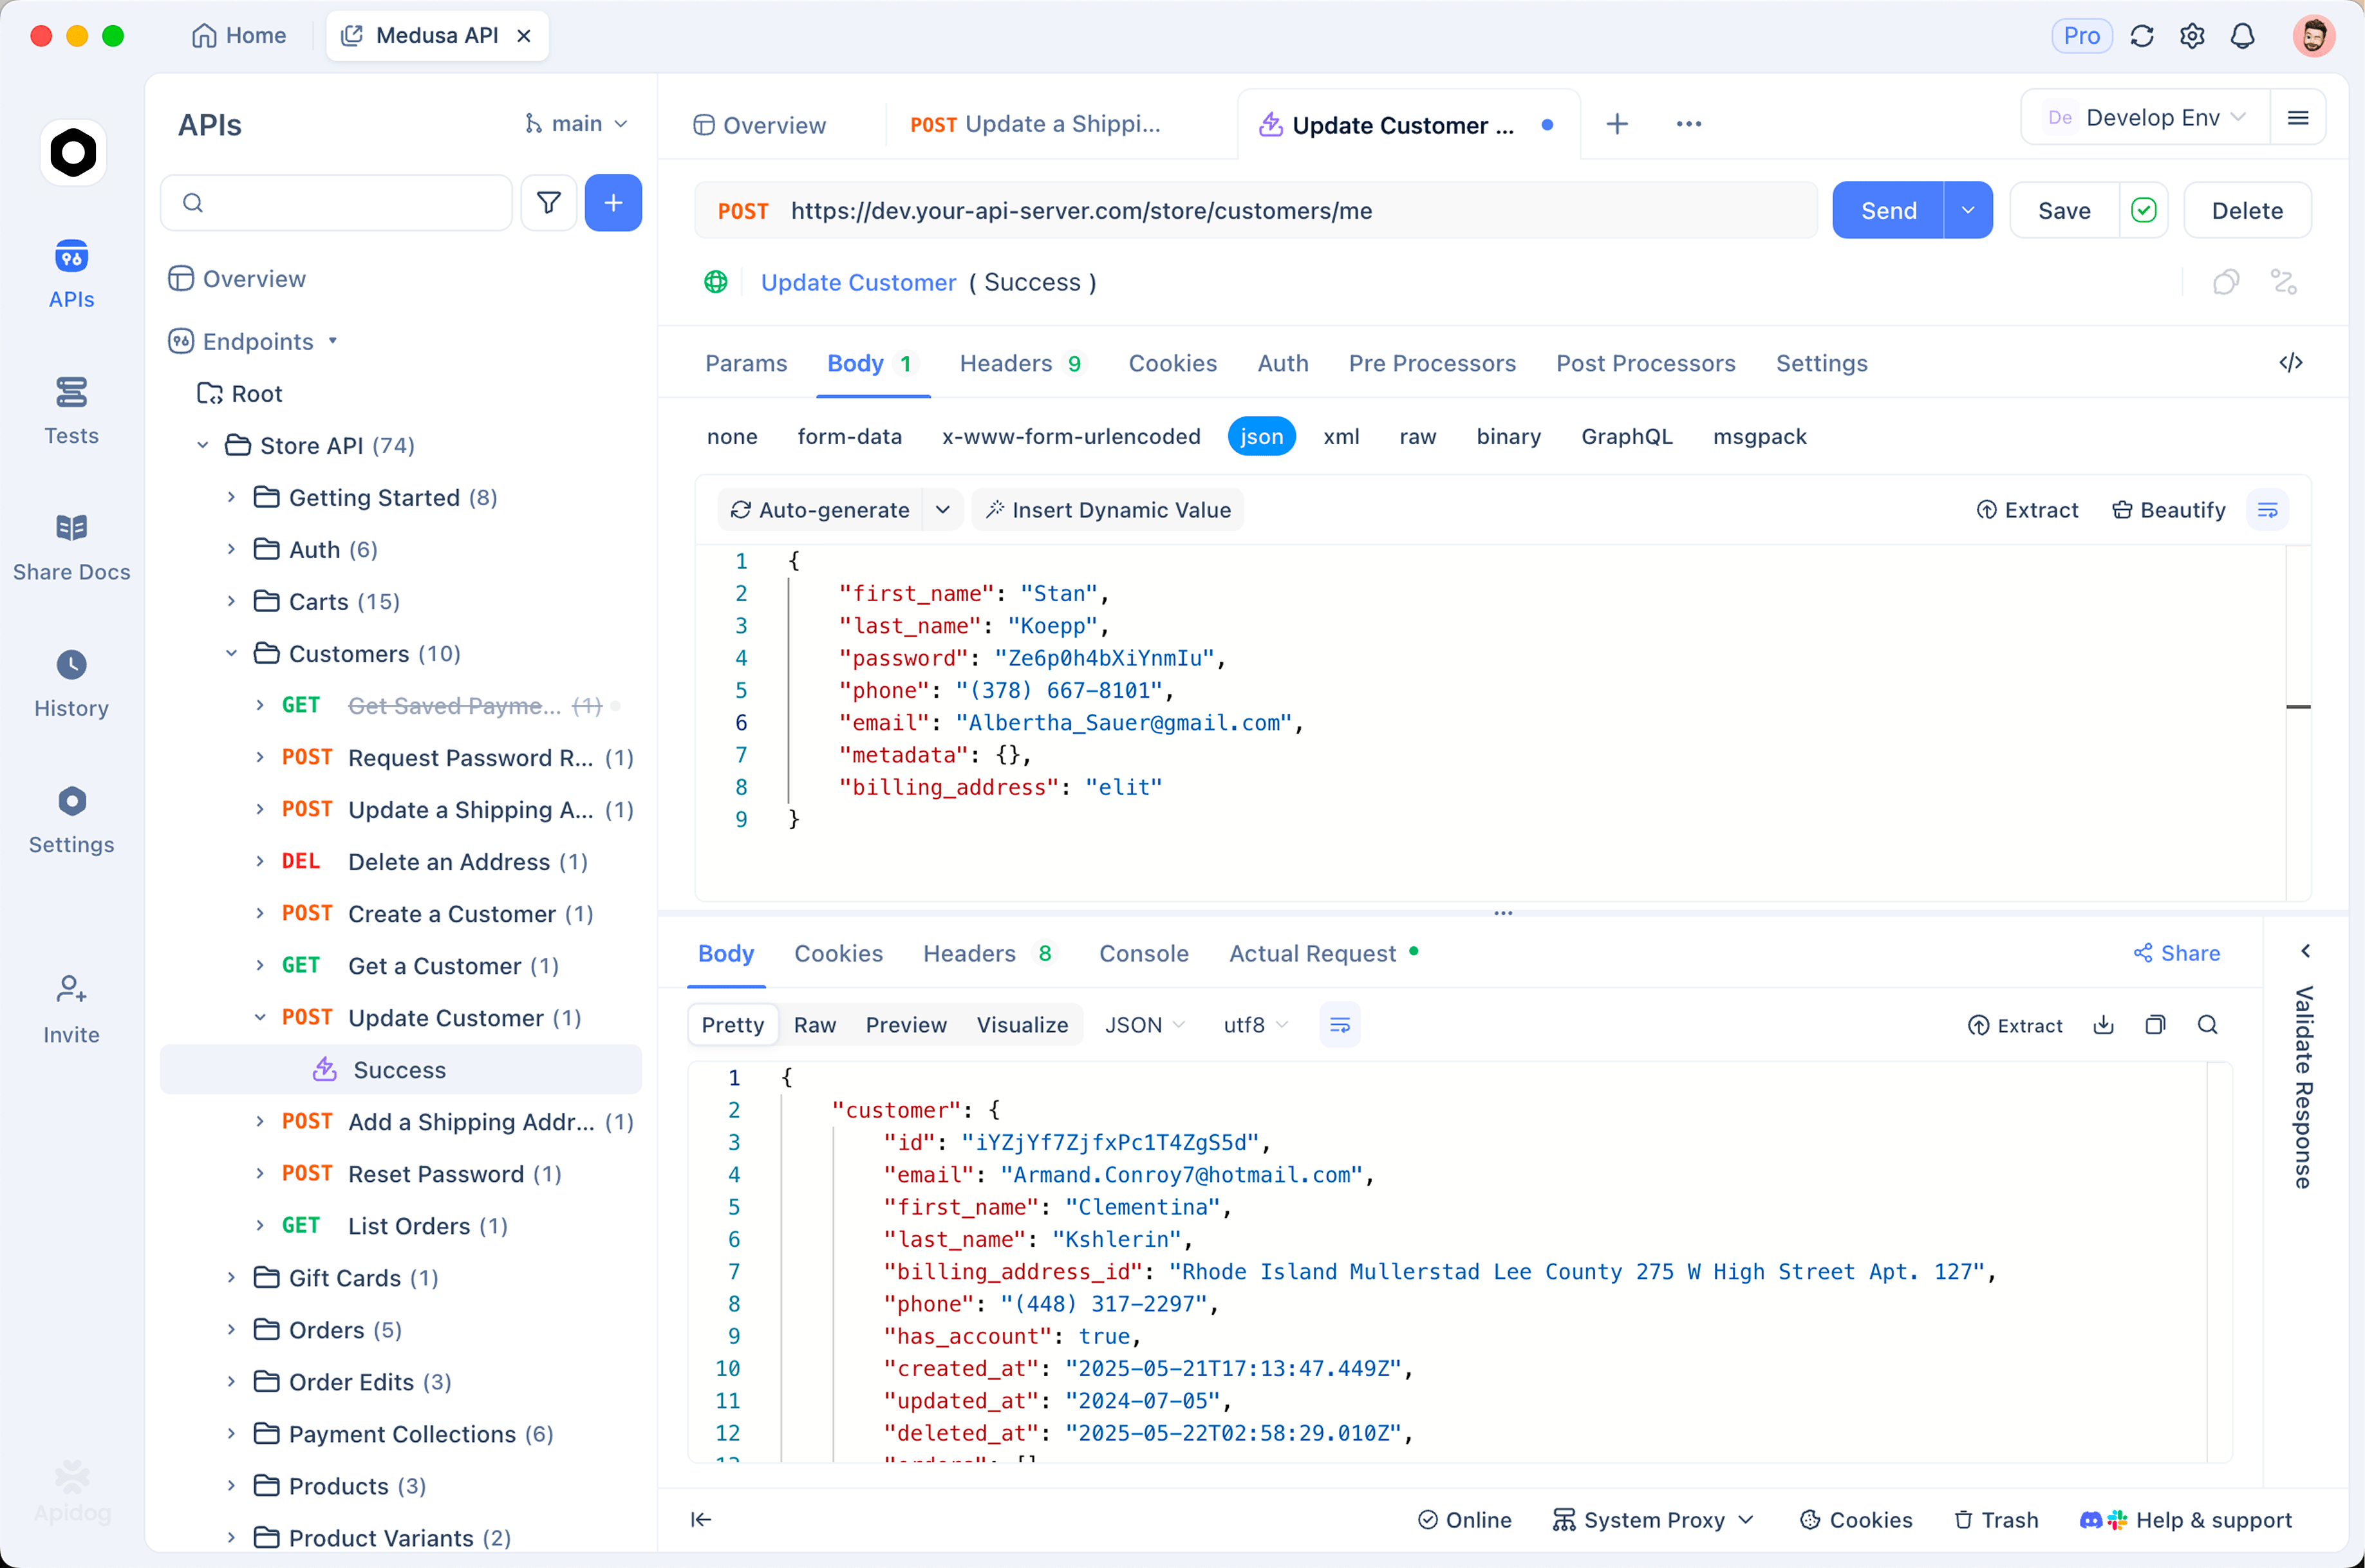
キーを環境変数として保存する。 TypeSafeという環境を作成し、TYPESAFE_API_KEYをローカル値として追加してマシン上に保持し、Bearerトークン内で{{TYPESAFE_API_KEY}}として参照します。環境変数と秘密変数に関するガイドでは、スコープルールについて説明しています。
実際のリクエストを送信する。 上記のstateと質問のボディを使用して、POST https://api.typesafe.ai/v1/systemoneを送信します。
決定をアサートする。 answers.department.choiceがbillingに等しいこと、answers.urgent.noulが0.9より大きいこと、answers.frustration.scoreが1.5より大きいことなどのポストプロセッサーアサーションを追加します。これにより、動作変更が発生した場合、静かにチケットを誤ルーティングする代わりにテストが失敗するようになります。
次に、重要なシナリオを構築します。 ラベル付けされた小さな状態のセットをテストシナリオとして保存します。穏やかな質問、怒りを含んだキャンセル脅威、そして優れたルーターがためらうべき意図的に曖昧なメッセージです。最初の2つでは高い信頼度をアサートし、3つ目では信頼度がゲートを下回ることをアサートします。この単一のシナリオにより、しきい値の調整が当て推量ではなく証拠に基づいたものとなり、手動では気づきにくい障害を検出できます。例えば、誰かが基準の説明を書き直しても、すべての応答は引き続き検証されるが、ルーティングが静かに変更される、といったケースです。CIで実行すれば、書き換えはビルドを失敗させます。
応答の形状をモックすることで、フロントエンドの作業がトークンを消費しないようにします。answersオブジェクトはリクエストの前に宣言されるため、モックと実際の応答がずれることはありません。Apidogをダウンロードしてこれを設定してください。無料プランは4人までのチームをカバーします。
決定レイヤーが費用対効果を発揮する5つのワークフロー
- ユニバーサル検証器。 すべての高価なLLM呼び出しをラップします。着信プロンプトのインジェクション、選択されたツールの明らかな不一致、要件の不足した出力、およびソース資料で裏付けられていない主張に関する最終回答をチェックします。高価な頭脳の周りの安価なチェックです。
- サポートコントロールタワー。 チケットを分類し、緊急度、不満、返金意図、キャンセルリスクを1回の呼び出しで検出し、その後ルーティングします。これにより、誤ったキューにあるチケットが減り、放置される貴重なアカウントが減ります。
- リードの適格性評価。 企業適合性、技術的成熟度、表明された問題、購買意図、緊急度を個別のシグナルとして採点し、それらを独自の重みで結合して、パイプラインレビューで擁護できるようにします。
- モデルルーター。 リクエストごとに、決定論的なコード、小型モデル、フロンティアモデル、または人間がそれを処理すべきかを決定します。これは通常、コスト削減が最初に現れる場所です。
- 大規模データセットジョブ。 サポートログ、レビュー、リスト、トランスクリプト、またはエージェントトレース全体で同じ意味判断を実行し、構造化された特徴を抽出し、人間が確認する価値のあるレコードをランク付けします。これは、各決定が高速かつほぼ無料である場合にのみ実用的な分析となります。
よくある質問
まだ言語モデルは必要ですか? はい。Jevは返信、要約、コードを作成することはできません。どのシステムがそれを行うべきかを決定し、ポリシー遵守や、あなたがしていない約束が回答に含まれているかといった明確な基準に基づいて、後から下書きを評価できます。
JSONモードや構造化出力とどう違うのですか? 構造化出力はテキストモデルの書式を制約しますが、モデルは依然としてトークンを生成し、有効な形状で誤ったことを主張する可能性があります。Jevはあなたが定義した回答セットに対する確率分布を返すため、不確実性が第一級のフィールドとなります。OpenAIの構造化出力に関する解説では、この比較のもう一方の側面について説明しています。
どうすればアクセスできますか? Jevは現在、早期アクセス段階であり、ウェイティングリストがあります。そのため、まだセルフサービスではありません。TypeSafeは開発者をバッチでリストから案内しており、通過するとconsole.typesafe.aiでサインインできます。また、Vercel AI Gatewayを介して、AI SDK 7のexperimental_evaluateでtypesafe-ai/jevとして利用できますが、これはSDK専用であり、OpenAI互換のエンドポイントには公開されていません。Jev APIキーの取得方法に関する私たちのウォークスルーには、リクエストとSDKの詳細が記載されています。
このようなものをローカルで実行できますか? オープンウェイトに対する制約付きデコーディングを用いて、このアイデアの一部を再現するプロジェクトがいくつかあります。OpenJevとオープンソースのJev代替品の記事では、それぞれが調整された信頼度にどれだけ忠実であるかを含めて比較しました。
本ガイドのまとめ
Jevは、他のモデルを置き換えるモデルではありません。Jevは、他のモデルがいつ、どこで、実行されるべきかを決定するレイヤーです。そのように構築してください。つまり、クリーンな状態、明確な基準を持つ原子的な質問、並列評価、そしてすべてのアクションの前に信頼度ゲートを配置することです。そして、1つの実際のチケットをルーティングする前に、Apidogで保存されたシナリオを用いてそのゲートが機能することを証明してください。