
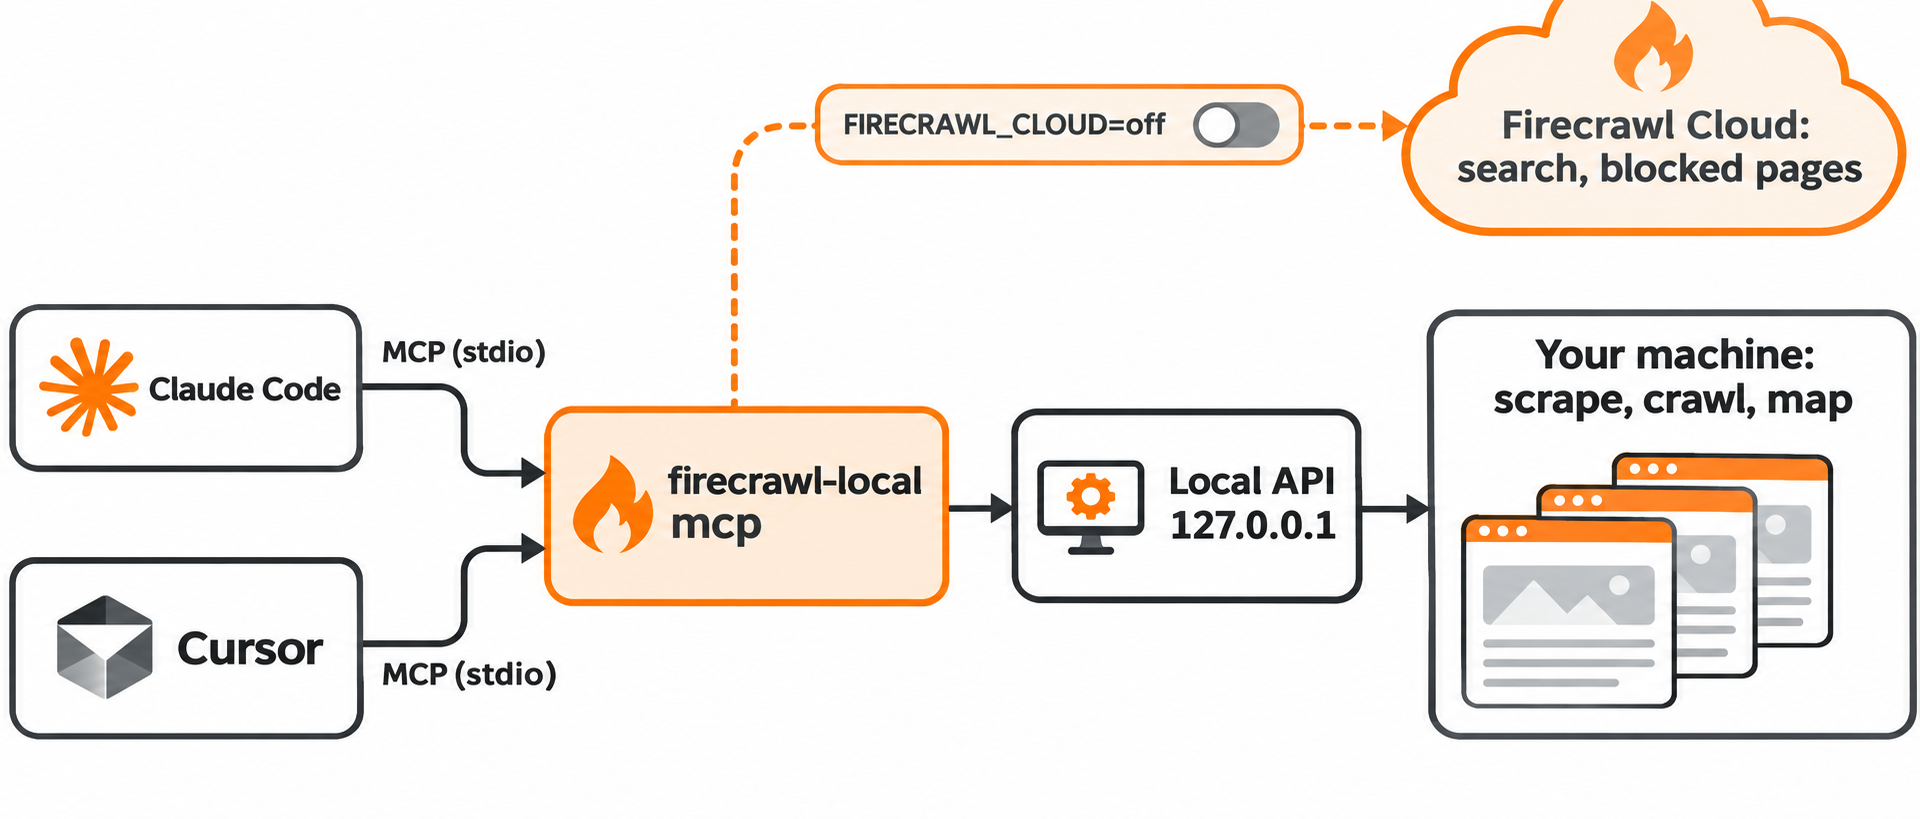
Firecrawl Localを使うには、cargo install firecrawl-localでインストールし、firecrawl-local initを実行してClaude CodeとCursorにMCPサーバーとして登録したあと、両方のツールを再起動します。これでエージェントは自分のマシン上でサイトのスクレイピング、クロール、マッピングを行えるようになります。コードから使う場合は、firecrawl-local serveを実行し、任意のFirecrawl SDKの接続先をhttp://localhost:3002に設定します。
このガイドでは、Firecrawl Localの使い方をステップごとに紹介します。2026年11月19日のテスト実行(arm64 Mac上のFirecrawl Local 0.1.0)で得られた実際の出力に加え、エージェントに与えるプロンプトや、そのエージェントにApidog CLIでローカルAPIをテストさせる方法も取り上げます。
始める前に必要なもの
Firecrawl Localは、Firecrawlリポジトリにある単一のRustバイナリです。インストールする前に、以下を確認してください:
- RustとCコンパイラ。 Rustはrustup.rsから入手します。macOSでは
xcode-select --installを実行し、DebianまたはUbuntuではbuild-essentialをインストールします。 - Node.js 22以降(MCPサーバーを使う場合)。
npx経由でfirecrawl-mcpnpmパッケージを実行します。 - ChromeまたはChromium(任意)。 Firecrawl Localは、JavaScriptが必要なページに対して、すでにインストールされているブラウザを使用します。静的ページはブラウザなしでも動作します。
- Claude Code、Cursor、またはその他のMCPクライアント。
initはClaude Desktop、Windsurf、Gemini CLI、Codexにも対応しています。
Firecrawl自体が初めてなら、まずFirecrawl Webスクレイピングガイドから始めて、また戻ってきてください。
ステップ1:Firecrawl Localをインストールする
crates.ioからクレートをインストールし、バージョンを確認します:
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Cargoはソースからコンパイルします。私たちのMacではリリースビルドが6分54秒で完了し、バイナリは~/.cargo/bin/firecrawl-localに配置されました。このフォルダーがPATHに含まれていることを確認するか、フルパスを控えておいてください。手動でMCPをセットアップするときに必要になります。
ステップ2:ターミナルから最初のスクレイピングを実行する
エージェントに組み込む前に、取得が動作することを確認します:
FIRECRAWL_CLOUD=off firecrawl-local scrape https://example.com --markdown
1.2秒でページの本文がMarkdownとして出力されました。--markdownを外すと、Firecrawl APIが返すのと同じJSONが得られます。--format markdown,linksでフォーマットを指定できます。ローカルで選べるのはmarkdown、html、rawHtml、linksです。
次に、ページごとに1つのMarkdownファイルを書き出すクロールを実行します:
FIRECRAWL_CLOUD=off firecrawl-local crawl https://docs.firecrawl.dev --limit 20 --out ./pages
これはFirecrawlドキュメントの20ページを4.4秒で取得し、0005-docs.firecrawl.dev_advanced-scraping-guide.mdのような名前のファイルを保存しました。firecrawl-local crawl --helpで確認できる便利なクロールフラグは次のとおりです:
| フラグ | 動作 |
|---|---|
-l, --limit |
最大ページ数(デフォルト100) |
--max-depth |
リンクをたどる深さ |
--include, --exclude |
保持またはスキップするパスの正規表現(複数指定可能) |
--entire-domain |
開始パス外のリンクもたどる |
-c, --concurrency |
同時に取得するページ数 |
--ignore-robots |
robots.txtを無視する(デフォルトでは読み込まれます) |
firecrawl-local map https://firecrawl.devは、サイトマップと開始ページから見つけたすべてのURLを1行のJSONとして返します。
ステップ3:initでFirecrawl LocalをClaude CodeとCursorに追加する
initはマシン上のAIツールを見つけ、それぞれのMCP設定にFirecrawl Localを追加します。まずプレビューします:
firecrawl-local init --dry-run
私たちのMacでは、変更対象となるすべてのツールが一覧表示されました:
Firecrawl MCP server:
  Claude Code: would be added in ~/.claude.json
  Claude desktop: would be added in ~/Library/Application Support/Claude/claude_desktop_config.json
  Cursor: would be added in ~/.cursor/mcp.json
  Gemini CLI: would be added in ~/.gemini/settings.json
  Codex: would be added in ~/.codex/config.toml
ドライランでは、Firecrawl Cloudに送信される内容も表示されます。検索クエリ、マシンからのアクセスをブロックしたページのURL、サインイン後のAlexandria呼び出し、ランダムなインストールIDとAIツール名です。ローカルで問題なく読み込めるページは送信されません。
このガイドで扱う2つのツールだけをセットアップするには、--agentを繰り返します:
firecrawl-local init --agent claude-code --agent cursor
有効な名前はclaude-code、claude-desktop、cursor、windsurf、gemini、codexです。initは書き込む前に各設定ファイルをバックアップします。その後、Claude CodeとCursorを再起動して新しいサーバーを読み込ませてください。
Claude CodeでFirecrawl Localを手動設定する
ツールに設定を編集させたくない場合は、Claude CodeのMCPコマンドを使ってstdioサーバーを自分で追加します:
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- ~/.cargo/bin/firecrawl-local mcp --public-only
Claude Code内で/mcpを実行し、サーバーが接続されていることを確認します。
CursorでFirecrawl Localを手動設定する
CursorはMCPサーバーを~/.cursor/mcp.json(グローバル)または.cursor/mcp.json(単一プロジェクト)から読み込みます。バイナリへのフルパスを使用してください:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}
--public-onlyを指定すると、サーバーはlocalhostおよびプライベートネットワークのアドレスを拒否します。信頼できないページをエージェントが読むときは、このオプションを有効にしておいてください。そうしないと、ページ内の隠れた指示によってエージェントが内部URLへ誘導される可能性があります。
ステップ4:エージェントに与えるプロンプト
firecrawl-local mcpはループバックポートでローカルAPIを起動し、そのAPIに対してfirecrawl-mcpパッケージを実行します。エージェントには標準のFirecrawl MCPツールが見え、scrape、crawl、map、batch scrapeは自分のマシン上で実行されます。ホスト型Firecrawl MCPサーバーを使ったことがあるなら、ツール名は同じです。
ローカルツールに適したプロンプト:
Map https://docs.example.com, then crawl only the /api/ pages (limit 40)
and write a summary of every endpoint into docs/vendor-api.md.
Scrape the changelog at https://example.com/changelog as markdown and list
every breaking change from the last three releases.
Batch scrape these five pricing pages and build a comparison table of
plan names and limits. Quote only what the pages say.
検索が必要なプロンプトは避けてください。FIRECRAWL_CLOUD=offでは、そのツールはどこにも接続しません。完全にローカルな検索環境については、Claude向けオープンソースWeb検索ガイドを参照してください。
ステップ5:Firecrawl Local APIを実行し、SDKの接続先を設定する
スクリプトやパイプラインで使うには、APIサーバーを実行します:
FIRECRAWL_CLOUD=off firecrawl-local serve
127.0.0.1:3002で待ち受けます。ヘルスチェックはすぐに応答します:
curl -s localhost:3002/health
# {"status":"ok","engine":"firecrawl-local","version":"0.1.0"}
スクレイピングはおなじみのv2形式で返され、次の2つのローカルマーカーが含まれます:"engine": "local-fetch"と"source": "local"、さらにcreditsUsed: 0です。
curl -s localhost:3002/v2/scrape -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown","links"]}'
Firecrawl SDKはAPIキーなしで接続先に指定できます。Python:
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Node:
import { Firecrawl } from "firecrawl";

const app = new Firecrawl({ apiUrl: "http://localhost:3002" });
const doc = await app.scrape("https://example.com");
console.log(doc.markdown);
initはショートカットも提案します。FIRECRAWL_API_URL=http://127.0.0.1:3002を設定すれば、既存のFirecrawlコードがローカルで動作します。Firecrawl CLIは保存済みのログイン情報をFirecrawl Localと共有するため、どちらかのツールでloginすれば両方で使えます。
クロールは非同期です。POST /v2/crawlはすぐにジョブIDを返し、数秒後にGET /v2/crawl/{id}がstatus: completed、total: 10、creditsUsed: 0、expiresInSeconds: 3587を報告しました。ジョブはメモリ上に存在し、開始から1時間で期限切れになり、serveが停止すると消えます。そのため、クロールが完了したらすぐに結果を保存してください。
psで計測したところ、サーバープロセスの常駐メモリはアイドル時で約10 MB、10ページのクロール直後で43 MBでした。Firecrawlのローンチ投稿は、セルフホスト型Firecrawlより37倍高速でメモリ使用量が230分の1だと主張しています。READMEには測定方法が公開されていないため、これらはFirecrawlの公表値として扱ってください。
FIRECRAWL_CLOUDでFirecrawl Localを完全ローカル運用する
デフォルト(auto)では、3つのものがFirecrawl Cloudに送信されます。検索、マシンからのアクセスをブロックするページ、Alexandriaデータプロバイダー(firecrawl-local loginで無料アカウントが必要)です。FIRECRAWL_CLOUDはこの引き渡しを制御します:
| 値 | 効果 |
|---|---|
auto(デフォルト) |
検索、ブロックされたページのフォールバック、Alexandriaがすべて動作 |
search |
検索のみFirecrawl Cloudに送信 |
off |
何もFirecrawl Cloudに送信しない |
認識されない値はoffとして扱われます。クラウドがオフの場合、POST /v2/searchは"code":"CLOUD_ONLY"と、FIRECRAWL_API_KEYまたはFIRECRAWL_CLOUD=autoを設定するよう促すメッセージを返します。クラウドが取得したページには"source": "firecrawl-cloud"が付くため、結果の出どころを常に判別できます。
serveは、--allow-privateを指定しない限りlocalhostおよびプライベートなターゲットを拒否します。また、ループバック以外の--hostにバインドするには--tokenが必要です。クラウドメタデータとリンクローカルアドレスは、すべてのモードでブロックされます。
コーディングエージェントにApidog CLIでFirecrawl Local APIをテストさせる
クロールエンドポイントは、パイプラインを壊す可能性が最も高いものです。非同期であり、ジョブには期限があり、サーバーを停止するとジョブが失われます。手動でポーリングする代わりに、コーディングエージェントにApidog CLIでテストを構築・実行させましょう。
一度だけセットアップします:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
次に、Claude CodeまたはCursorに次のプロンプトを1つ与えます:
firecrawl-local serve is running on http://localhost:3002. In Apidog project <id>,
import an OpenAPI file for POST /v2/scrape, POST /v2/crawl and GET /v2/crawl/{id},
create an environment for that base URL, and build a test scenario that starts a
crawl of https://docs.firecrawl.dev with limit 10, saves the returned id, polls
GET /v2/crawl/{id} until status is "completed", and asserts total equals completed
and every page has non-empty markdown. Run it and summarize any failures.
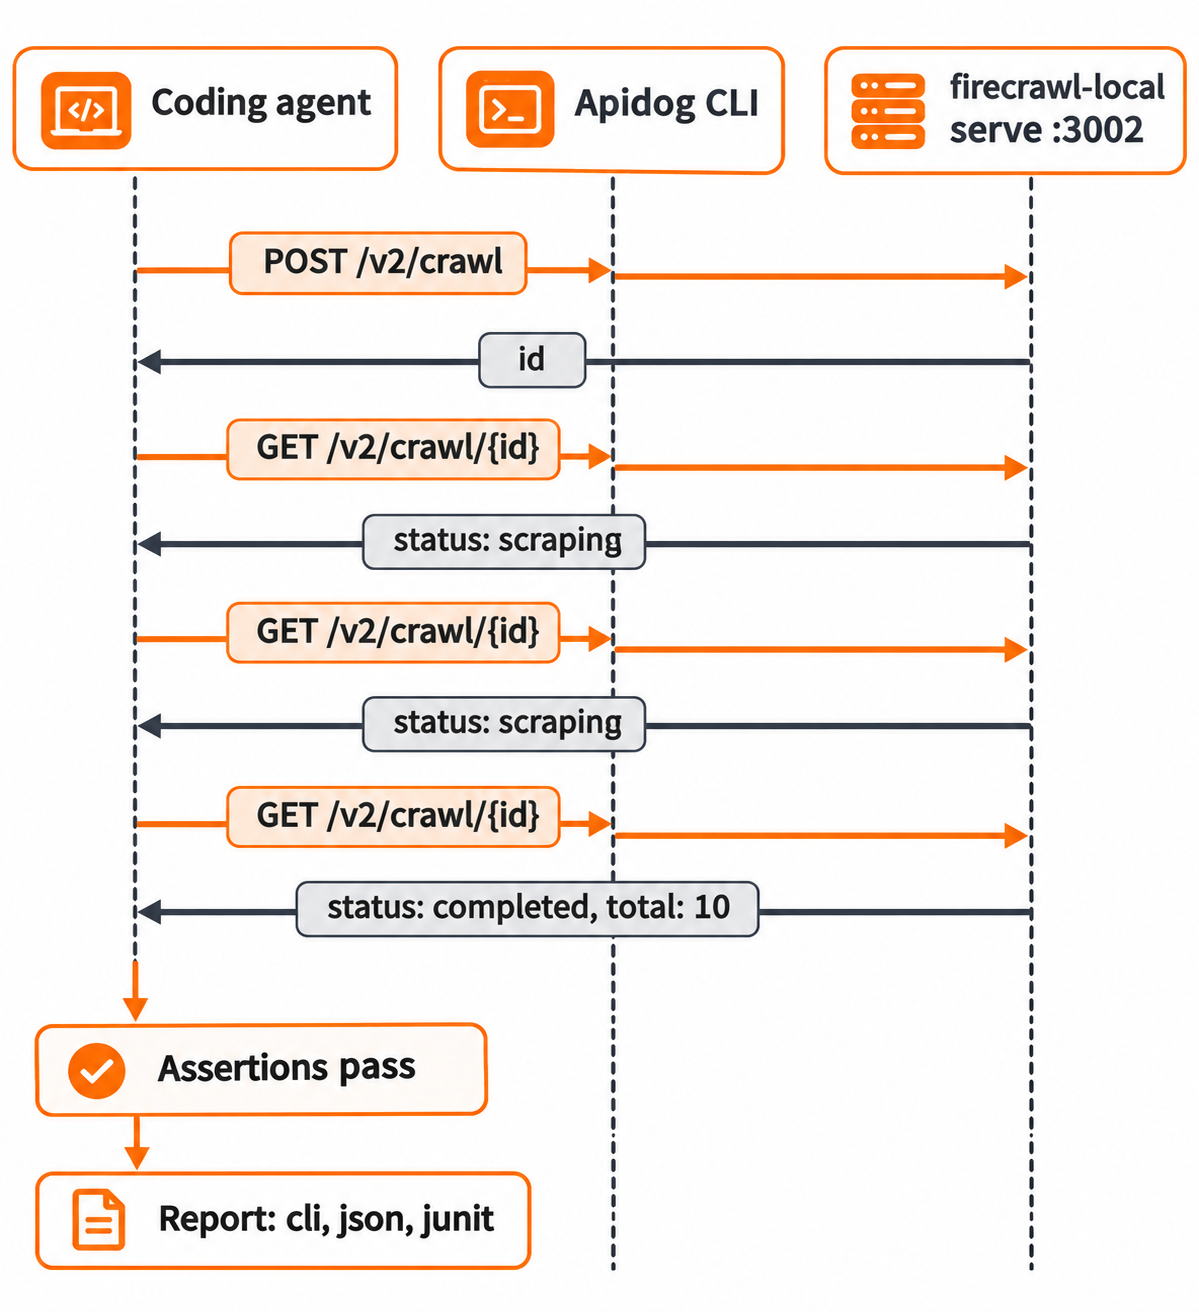
エージェントは各ペイロードスキーマを読み取り、検証し、次のようなコマンドを実行します。これらはすべてCLI 2.2.12のapidog <cmd> --helpから取得したものです:
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file ./scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Apidog CLIはあなたのマシンからリクエストを送信するため、localhost:3002に到達できます。同じ実行をCIに組み込むには-r junitに切り替えます。Claude CodeでのApidog CLIとCursorでのApidog CLIのガイドでは、エージェント側の利用方法を説明しています。ApidogのFreeプランは最大4ユーザーのチームに対応しています。
Firecrawl Localのトラブルシューティング
| 症状 | 解決策 |
|---|---|
404とNOT_FOUNDが/v1/scrapeで返る |
v2のみが提供されています。クライアントを/v2/...に切り替えてください |
CLOUD_ONLYが/v2/searchで返る |
FIRECRAWL_CLOUD=offでは想定どおりです。autoまたはsearchを使用してください |
| エージェントにFirecrawlツールが表示されない | init後にツールを再起動してください。Node.js 22以降を確認してください |
| JavaScriptページの内容が薄い | Chromeをインストールするか、--browser alwaysを設定してください |
jsonまたはsummary形式が見つからない |
ローカルではサポートされていません。代わりに警告が表示されます |
| クロールIDが見つからない | ジョブが1時間で期限切れになったか、serveが再起動されました |
よくある質問
Firecrawl Localは無料ですか? ローカルのスクレイピング、クロール、マッピングはFirecrawlに何も送信せず、私たちのテストでは0クレジットでした。コードはAGPL-3.0、SDKはMITです。検索とAlexandriaはFirecrawl Cloudを経由します。
Firecrawl Localを使うにはAPIキーが必要ですか? いいえ、ローカルルートには不要です。Alexandriaデータプロバイダーを使う場合にのみ、firecrawl-local loginまたはFIRECRAWL_API_KEY経由でキーが必要です。
Firecrawl LocalはWindsurf、Codex、Gemini CLIで動作しますか? はい。initはClaude Code、Claude Desktop、Cursorに加えて、windsurf、codex、geminiにも対応しています。
既存のFirecrawlコードは変更なしで動作しますか? v2のscrape、map、crawl、batch scrapeについては、はい。API URLをhttp://localhost:3002に変更してください。v0およびv1のルートは提供されておらず、ブラウザのactionsは無視されます。
Firecrawl Localはrobots.txtを尊重しますか? はい。クロール時にrobots.txtを読み込み、User-Agentで自身を識別するため、サイト所有者はFirecrawlLocalとして対応できます。--ignore-robotsはこの動作を無効にします。自分の所有するサイトでのみ使用してください。