
DeepSeek V4 Proは2026年8月12日にプレビューを終了しました。0813の刻印がされたGAビルドは、現在`deepseek-v4-pro` APIエンドポイントとして提供されており、誤植のように見える数字を伴っています。1Mトークンのコンテキストウィンドウ、最大出力は384Kトークン、キャッシュヒット時の入力価格は100万トークンあたり$0.003625にまで低下します。Unite.AIが報じたように、4ヶ月間プレビュー期間にあったこのモデルは、DeepSeekの主力製品となりました。
発売時の報道は、何が出荷されたかを伝えるものであり、それをどう呼び出すかを伝えるものではありません。このガイドでは、実践的な部分について説明します。OpenAI SDKを使った最初のリクエスト、思考モードと`reasoning_content`フィールド、ストリーミング、ツール呼び出し、そして1Mのコンテキストが手頃な価格であるか、それとも破滅的であるかを決定するプロンプトキャッシングの計算についてです。最初にアーキテクチャの背景を知りたい場合は、「What is DeepSeek V4」を読んでから戻ってきてください。
TL;DR
- DeepSeek-V4-Pro-0813は、2026年8月12日現在、`deepseek-v4-pro`エンドポイントの背後にあるGAスナップショットであり、本番環境でターゲットとすべきビルドです。
- APIはOpenAI互換です。`openai` SDKを`https://api.deepseek.com`に向け、`model="deepseek-v4-pro"`を設定すれば完了です。Anthropic Messages形式とDeepSeek独自のResponses APIも動作します。
- 1Mトークンのコンテキスト、384Kの最大出力、3つの思考モード(`non-think`、`think high`、`think max`)があり、回答とともに`reasoning_content`フィールドを返します。
- 料金:入力は$0.435/M(キャッシュミス時)、$0.003625/M(キャッシュヒット時、120倍安い)、出力は$0.87/M。繰り返しのプロンプトプレフィックスでは自動的にキャッシュされます。
- DeepSeekは8月6日、「大幅な」API料金値上げが予定されていると警告しました。具体的な金額や日付はまだ不明なため、余裕を持った予算を立ててください。
- 本番環境に組み込む前に、Apidogでエンドポイントをテストし、SSEストリームを検査し、プロ環境とフラッシュ環境を並行して保持してください。
GAビルド0813が開発者にもたらす変更点
プレビューは2026年4月に開始され、小型のV4 Flashは7月に出荷されました。8月12日には、DeepSeekの通常のタイムスタンプ規則(`v3-0324`がV3のスナップショットを示したのと同じ方法)に従って、Proモデルがビルド0813として一般提供されました。
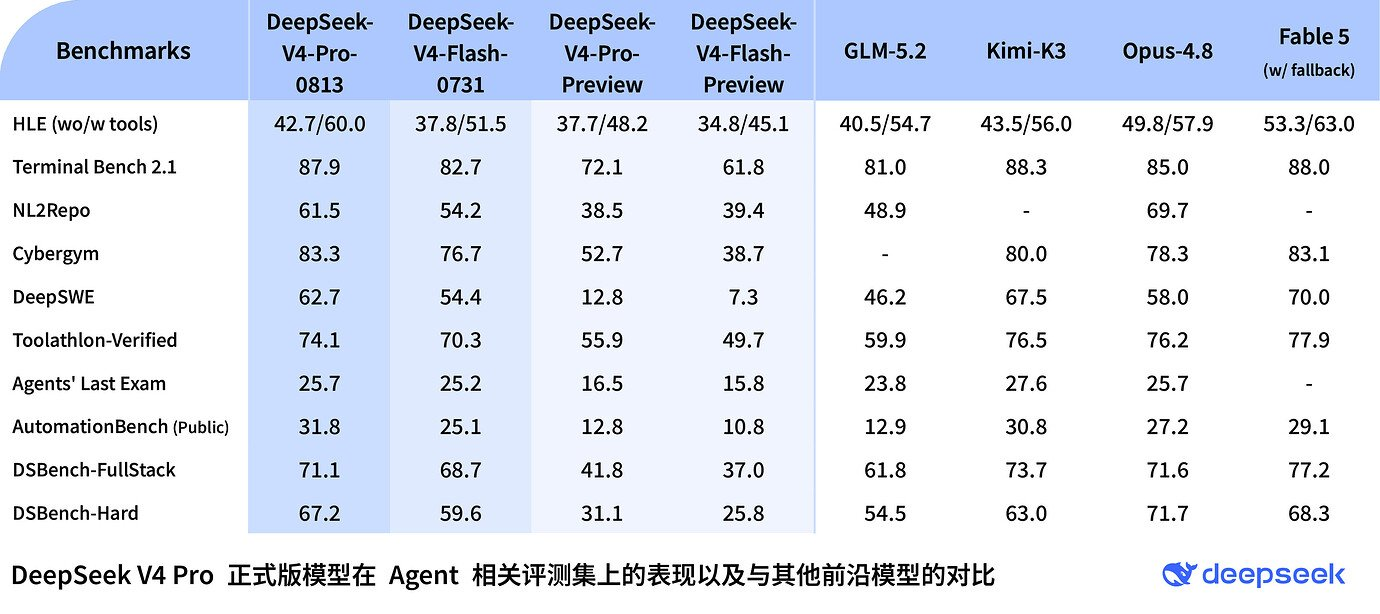
GAにより、3つの変更点があります。
- スナップショットは安定しています。プレビューモデルは予期せず変更される可能性があり、評価やプロンプトチューニングが無効になることがありました。ビルド0813は、DeepSeekが新しいスナップショットを発表するまで固定されたターゲットです。
- エンドポイントはプロダクションエイリアスです。公式APIでは`deepseek-v4-pro`を呼び出すと0813ビルドが取得されます。スナップショットを明示的に指定するには、OpenRouterでは`deepseek/deepseek-v4-pro-0813`としてリストされています。
- 全機能が利用可能です。思考モード、関数呼び出し、構造化出力、プロンプトキャッシング、およびマルチフォーマットAPI(OpenAI、Anthropic、Responses)はすべてGAエンドポイントで利用可能です。
内部的には、V4 Proは総パラメータ数1.6T、トークンあたりアクティブなパラメータ数49BのMixture-of-Expertsモデルです。主要なエンジニアリングのポイントは効率性であり、Compressed Sparse AttentionとHeavily Compressed Attentionという2つのアテンションスキームにより、シングルシーケンストークンの推論計算はV3.2の27%に、KVキャッシュは10%に削減されています。このKVキャッシュの削減こそが、1Mトークンのコンテキストがデモ機能ではなく、これらの価格で提供可能になった理由です。
DeepSeek V4 Pro 0813:スペックの概要
| スペック | DeepSeek V4 Pro 0813 |
|---|---|
| リリース | 2026年8月12日にGA(スナップショット 0813) |
| アーキテクチャ | Mixture-of-experts、総パラメータ数1.6T、トークンあたりアクティブなパラメータ数49B |
| アテンション | Compressed Sparse Attention + Heavily Compressed Attention |
| V3.2と比較した推論コスト | シングルシーケンストークン計算の27%、KVキャッシュの10% |
| コンテキストウィンドウ | 1,000,000トークン |
| 最大出力 | 384Kトークン |
| 思考モード | non-think、think high、think max |
| 入力価格 | $0.435/Mトークン(キャッシュミス時)、$0.003625/M(キャッシュヒット時) |
| 出力価格 | $0.87/Mトークン |
| APIフォーマット | OpenAI Chat Completions、Anthropic Messages、DeepSeek Responses |
| モデルID | deepseek-v4-pro |
| 小型モデル | deepseek-v4-flash(総パラメータ数284B / アクティブなパラメータ数13B)、入力$0.14/M、出力$0.28/M |
機能面では、DeepSeek自身のモデルカードによると、V4-Pro-Max(最大思考設定)でSWE-bench Verified 80.6%、Terminal Bench 2.0 67.9%、GPQA Diamond 90.1%、LiveCodeBench 93.5%を達成しています。これらは第三者がまだ検証していない自己申告のベンダー数値なので、重要なものを移行する前に、タスク固有の評価を独自に実行してください。
APIキーを取得して最初のリクエストを行う
セットアップは約5分で完了します。
- DeepSeekプラットフォーム(platform.deepseek.com)でアカウントを作成し、クレジットを追加します。APIは前払い制です。
- APIキーを開き、キーを生成してすぐにコピーします(一度しか表示されません)。
- コードに貼り付けるのではなく、環境変数としてエクスポートします。
export DEEPSEEK_API_KEY="sk-..."
APIはOpenAI Chat Completionsプロトコルに対応しているため、標準の`openai`パッケージがクライアントとして機能します。`https://api.deepseek.com`と`https://api.deepseek.com/v1`のどちらもベースURLとして機能します。`/v1`はプロトコル互換性のためであり、モデルのバージョンではありません。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a concise technical assistant."},
        {"role": "user", "content": "Explain idempotency in REST APIs in two sentences."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
初日から`response.usage`を出力しましょう。キャッシュヒット時には非常に安価で、1Mトークンのキャッシュミス時には非常に高価なモデルなので、トークンの会計処理は誤差と実際の請求額の差になります。
APIツールにインポートしたり、簡単なテストを行うのに便利な生のHTTPでの同じリクエスト:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-pro",
    "messages": [
      {"role": "user", "content": "List three ways to version a REST API."}
    ]
  }'
フルパラメータの参照は、Anthropic互換エンドポイント(Anthropic SDKやClaude Codeから書き換えなしで利用可能)やDeepSeek独自のResponses APIを含む公式DeepSeekドキュメントに記載されています。
3つの思考モードの操作
V4 Proは、推論を個別のモデルではなくダイヤルとして公開しています。1つのエンドポイントで3つのモードがあります。
- non-think: モデルは直接回答します。最も速く安価で、抽出、分類、フォーマット、要約に適しています。
- think high: モデルは回答前に推論し、その推論を`reasoning_content`フィールドで返します。コーディング、デバッグ、多段階分析のデフォルトです。
- think max: 最大限の推論予算で、V4-Pro-Maxベンチマーク数値の背後にある設定です。本当に難しい問題のために温存してください。
これらのモードは標準の`reasoning_effort`パラメータにマッピングされているため、ベンダー固有の配線は不要です。
response = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high", # "none" | "high" | "max"
    messages=[
        {"role": "user", "content": "Our API returns 502s under load but only behind the CDN. Walk through likely causes in order of probability."},
    ],
)

message = response.choices[0].message
print("--- Reasoning ---")
print(message.reasoning_content)
print("--- Answer ---")
print(message.content)
実用的な注意点が2つあります。まず、`reasoning_content`を会話履歴に戻してはいけません。以前のターンの`content`のみを送信してください。次に、推論トークンは出力トークンとして$0.87/Mで課金されるため、think maxは実際にお金と遅延が発生します。デフォルトで最大にせず、タスクに合わせてモードを選択してください。
ストリーミング応答
最大出力が384Kで、長文の推論が可能な思考モードの場合、非ストリーミングのリクエストはユーザーエクスペリエンスを悪化させます。`stream=True`を設定し、両方のデルタタイプを処理します。思考モードでは、`reasoning_content`チャンクが最初に到着し、次に回答が到着します。
stream = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high",
    stream=True,
    messages=[
        {"role": "user", "content": "Design a rate limiter for a public API. Compare token bucket and sliding window."},
    ],
)

for chunk in stream:
    if not chunk.choices:
        continue # final chunk may carry usage data only
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True) # thinking phase
    elif delta.content:
        print(delta.content, end="", flush=True) # answer phase
合理的なUIパターンとしては、「思考中」インジケーターとして推論フェーズを折りたたんで表示し、`content`デルタが開始されたら通常のレンダリングに切り替えるというものです。内部的にはこれは標準のServer-Sent Eventsであり、SSEを使用したAPI応答のストリーミングに関するガイドでその仕組みを解説しています。
ツール呼び出しと構造化出力
V4 ProはOpenAIスタイルの関数呼び出しをサポートしており、既存のエージェントループは修正なしで移植できます。ツールを定義し、`tool_calls`を読み取り、実行し、結果を追加し、繰り返します。
tools = [{
    "type": "function",
    "function": {
        "name": "get_endpoint_status",
        "description": "Check the health of an internal API endpoint",
        "parameters": {
            "type": "object",
            "properties": {
                "endpoint": {"type": "string", "description": "Path, e.g. /v1/orders"}
            },
            "required": ["endpoint"],
        },
    },
}]

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "Is /v1/orders healthy right now?"}],
    tools=tools,
)

print(response.choices[0].message.tool_calls)
構造化出力は、確実に解析可能なJSONが必要な場合に標準の`response_format`パラメータを介して機能します。多段階ツールループの完全なウォークスルーはそれ自体が記事に値するため、メッセージ形式の詳細は公式ドキュメントを参照してください。
プロンプトキャッシングの経済学:アーキテクチャを変える数値
ベンチマークよりも注目すべきスペックがここにあります。DeepSeekはプロンプトのプレフィックスを自動的にキャッシュします。キャッシュ制御ヘッダーもTTL設定も不要で、繰り返されるプレフィックスは$0.435/Mではなく$0.003625/Mで課金されます。これは、APIがすでに見た入力に対して120倍の割引です。
現実的なワークロードで数字を見てみましょう。200Kトークンのリポジトリコンテキストを保持し、1回のセッションで50回の呼び出しを行うコーディングエージェントを構築しているとします。
- キャッシュなしの場合:50回の呼び出し × 200Kトークン × $0.435/M ≈ 入力コスト$4.35。
- 自動キャッシュありの場合:1回のキャッシュミス($0.087)+ 49回のキャッシュヒット(約$0.0007ずつ)≈ $0.12。
同じセッションで約35倍安価になり、必要なのはプロンプト構造だけです。安定したコンテンツを最初に(システムプロンプト、ドキュメント、リポジトリコンテキスト)、変動するコンテンツを最後に(ユーザーの最新メッセージ、タイムスタンプ、リクエストID)。プロンプトの早い段階での変更は、その時点からキャッシュされたプレフィックスを無効にするため、システムプロンプトにタイムスタンプを含めると、すべての呼び出しがサイレントに全額課金のキャッシュミスに変換されます。
これにより、1Mのコンテキストウィンドウも再定義されます。ミス時には$0.435かかりますが、安定したセッションプレフィックスとして機能する場合、1回の呼び出しあたり約0.3セントで読み取られます。一般的な理論については、プロンプトキャッシングとは何かを参照してください。
Apidogでのdeepseek-v4-proのテスト
V4 Proを本番コードに組み込む前に、適切なデバッガーでエンドポイントをテストしましょう。DeepSeekのAPIはOpenAI互換であるため、Apidogは特別な処理なしでこれを認識します。
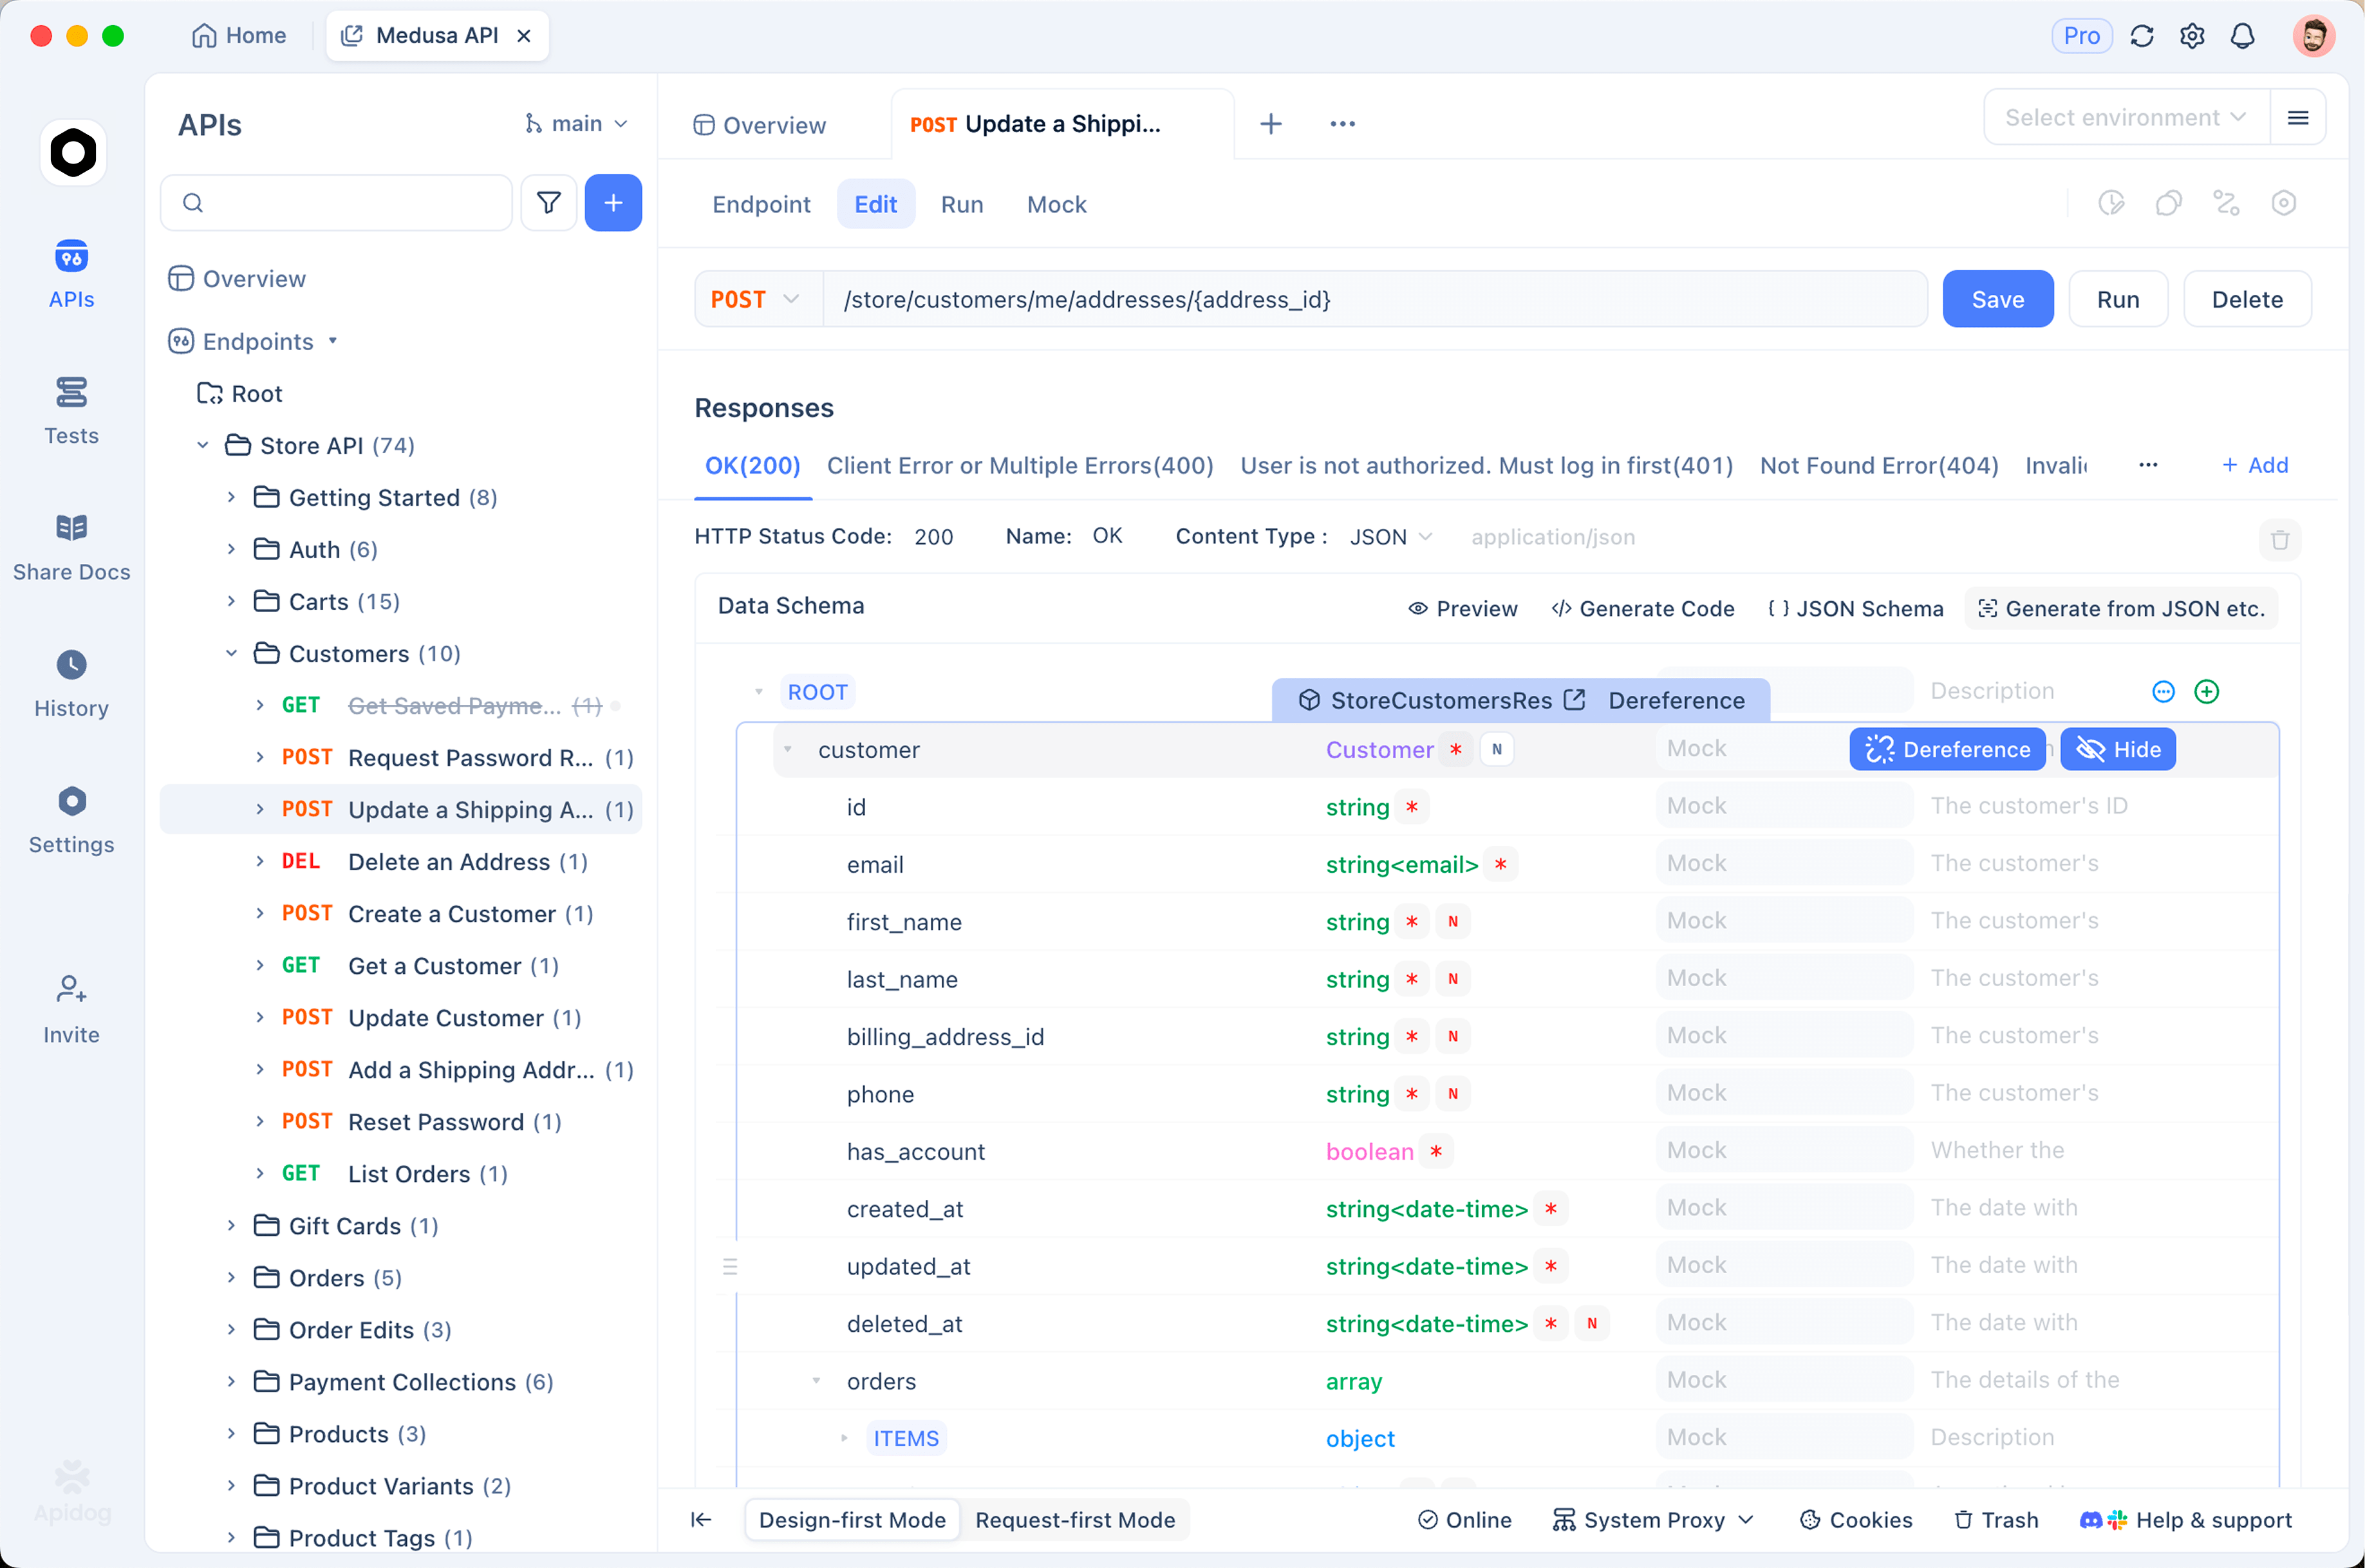
- エンドポイントをインポートします。前のcurlコマンドをApidogに貼り付けると、ヘッダー、認証、本文が自動的に解析され、編集可能なリクエストになります。
- ProとFlashの環境を設定します。`base_url`とAPIキーを環境変数として保存し、モデル名も変数にします。`deepseek-v4-pro`と`deepseek-v4-flash`の切り替えはワンクリックで環境変更が可能になり、「このプロンプトでProはFlashの3倍の価格に見合うか?」という問いが議論ではなく経験的な問いになります。
- SSEストリームを検査します。`"stream": true`でリクエストを送信すると、Apidogはイベントストリームを生の`data:`行の羅列ではなく、ライブのタイムラインとしてレンダリングし、デルタをマージして`reasoning_content`が回答より先に到着するのを見ることができます。think-max呼び出しが遅いと感じた場合、このビューは時間の使われ方を正確に示します。
- セッションをコレクションとして保存します。DeepSeekが次のスナップショットを出荷した際、アップグレードする前に同じリクエストを再実行し、動作を比較できます。これは一般的にOpenAI互換エンドポイントでチームが使用するワークフローと同じです。
レスポンスビューアは、すべてのリクエストで`usage`ブロックも表示します。これは、プロンプト構造を調整しながらキャッシュヒット率を確認する最も速い方法です。
現在の価格と今後の値上げについて
2つのV4エンドポイントの現在の希望小売価格:
| モデル | 入力(ミス) | 入力(キャッシュヒット) | 出力 |
|---|---|---|---|
deepseek-v4-pro |
$0.435/M | $0.003625/M | $0.87/M |
deepseek-v4-flash |
$0.14/M | $0.28/M |
Proの価格であっても、これは西側の最先端モデルを大きく下回っています。しかし、1つの注意点があります。GAの6日前である2026年8月6日に、DeepSeekは「大幅な」API料金の値上げが予定されていると警告しました。具体的な数字や施行日はまだ発表されていません。
数字が不明な間の現実的なヘッジ方法:
- 現在のタスクごとの実際のコストを、実際のワークロードからの`usage`データで測定し、発表された値上げを推測ではなく数分でモデル化できるようにします。
- キャッシュヒットを最大化します。値上げが比例的に適用される場合でも、プレフィックスを多用するアーキテクチャはほとんどの利点を維持します。
- V4 Flashをルーティングのフォールバックとして保持します。アクティブなパラメータが13Bで$0.14/$0.28の価格帯であるため、Proが必要なリクエストのために温存し、大量のシンプルなタスクを処理します。
V4の料金体系とプロバイダー間の比較に関する詳細な分析については、DeepSeek V4 API料金ガイドを参照してください。
よくある質問
既存のOpenAI SDKコードは変更なしで動作しますか?
ほぼ動作します。`base_url`を`https://api.deepseek.com`に変更し、APIキーを交換し、`model="deepseek-v4-pro"`を設定するだけです。Chat Completions、ストリーミング、ツール、構造化出力はOpenAIの形式に従います。Anthropic SDKを使用しているチームは、代わりにDeepSeekのAnthropic Messagesエンドポイントを使用できます。
V4 Proの代わりにV4 Flashを使用すべきなのはどのような場合ですか?
Flash(総パラメータ数284B、アクティブなパラメータ数13B)は、分類、抽出、シンプルなチャット、深い推論を必要としないレイテンシーに敏感なあらゆるものに対応する量産モデルです。Proは、エージェントによるコーディング、長文コンテキスト分析、思考モードのワークロードでその3倍の出力価格の価値を発揮します。忠誠心ではなく、タスクによってルーティングを使い分けてください。
CursorでV4 Pro 0813を使用できますか?
はい、CursorはカスタムのOpenAI互換エンドポイントをサポートしているため、GAビルドをカスタムモデルとして組み込むことができます。正確な設定については、CursorでDeepSeek V4 Proを使用する方法で詳しく説明しています。
まとめ
GAモデルが公開された初日は、以下の習慣を身につけるのに最適な時期です。キーの取得、最初のリクエスト、思考モード、ストリーミング、そしてキャッシングを意識したプロンプトのレイアウトです。V4 Proは、120倍のキャッシュ割引によりプロンプト構造がアーキテクチャ上の決定事項となるため、これまでのどのモデルよりも最後の習慣に報いるでしょう。上記の例を参考に、`usage`の数値を確認し、次のスナップショットや発表された価格変更があった際に動作を再検証できるよう、保存されたApidogコレクションを保持してください。