DeepSeekは、2026年9月10日にDeepSeek-V4.1-FlashのウェイトをHugging FaceでMITライセンスの下で公開しました。これは、APIでモデルがGA(一般提供)されたのと同じ日です。このようなタイミングは異例です。ほとんどのラボは、まずホスト型エンドポイントを提供し、数週間後、あるいは全く公開しないこともあります。 見出しの数字はほとんどの読者を驚かせるでしょう。バックボーンには5520億パラメータ、ビジョンエンコーダーを含めると7630億パラメータです。しかし、その根底にある設計は、サイズが示唆するよりもセルフホスティングに適しています。プレフィル時には80億パラメータ、デコード時には160億パラメータのみがアクティブになり、新しいFP4 KVキャッシュはトークンあたり890バイトで、V4-Flashが必要とした量の約4分の1です。計算は安価ですが、メモリが障壁となります。 いずれにせよ、人々は試すでしょう。このガイドでは、メモリ計算、各ハードウェアティアでの現実的なパス、一般的なセットアップコマンド、そしてApidogでローカルのOpenAI互換エンドポイントをホスト型APIに対してテストする方法を提供します。まずモデルの概要を知りたい場合は、「DeepSeek-V4.1-Flashとは?」を読んでから戻ってきてください。ボタン
TL;DR
- ウェイト:5520億パラメータのMoEバックボーン、MITライセンス。8ビットで約552GB、4ビットで約280GB(バックボーンのみ)。
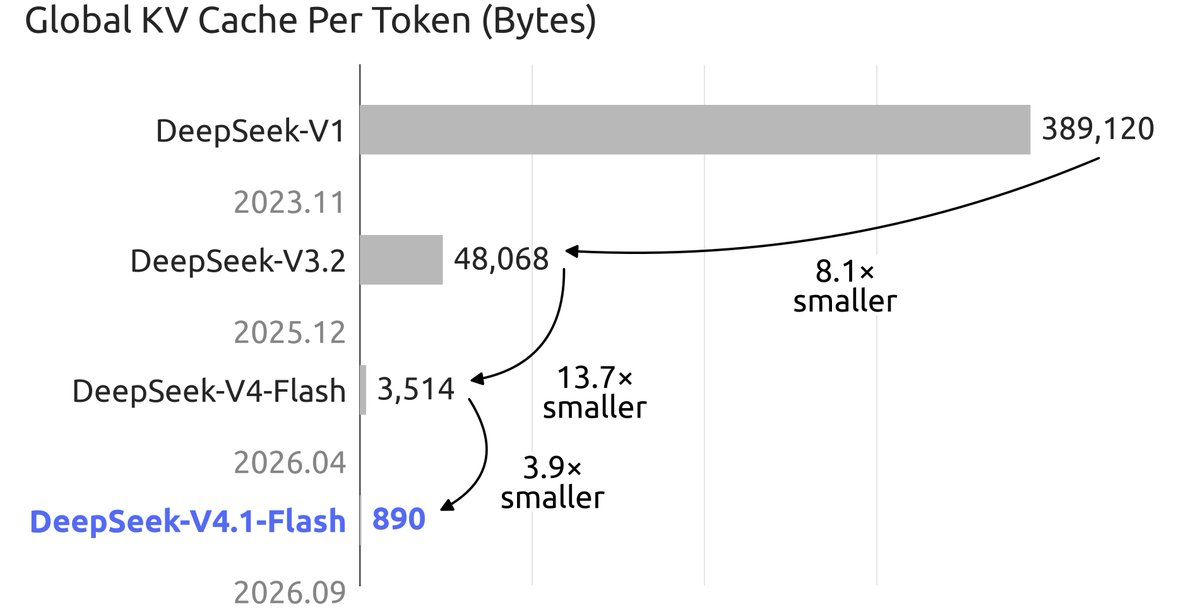
- KVキャッシュ:トークンあたり890バイト。100万トークンのコンテキスト全体で約0.9GBが必要。この部分は解決済みです。
- 現実的な4ビットでのサービスには、80GBクラスのGPUが4〜8基必要です。それ以下ではCPUまたはSSDオフロードとなり、処理は遅くなります。
- ホスト型APIは、オフピーク時に100万キャッシュミスの入力トークンあたり0.15ドルを請求します。ほとんどのチームにとって、これだけでも電気代を上回るコストメリットがあります。
ダウンロードするもの
モデルカードには、新しい因果エンコーダ・デコーダレイアウトを持つ5520億パラメータのMixture-of-Expertsバックボーンが記述されています。40層で、20層がエンコーダ、20層がデコーダに分かれています。各層は384個のエキスパートと1つの共有エキスパートにルーティングされます。DeepSeek-ViTビジョンエンコーダは、フルチェックポイントを7630億パラメータに押し上げます。テキストのみが必要な場合でも、全てをダウンロードすることになります。
ローカル推論において重要な3つの詳細:
- アクティブパラメータは少ない。 プレフィル時に80億、デコード時に160億がアクティブ。トークンあたりのFLOP数は中規模の密なモデルのようです。問題は、5520億パラメータのそれぞれが、順伝播が到達できるどこかに存在しなければならないことです。
- KVキャッシュはFP4。 リリースノートによると、キャッシュは前世代のHBMの1/4、SSDストレージの1/8を使用します。トークンあたり890バイトであるため、長大なコンテキストはもはや以前のようなメモリ問題ではありません。
- アテンションは疎な設計。 3つの静的モードを持つCompressed Sparse Attention 2は、64Kコンテキストでトレーニングされ、45兆トークンの実行の後半で1Mまで拡張されました。これが1MでもKVの数値が小さいままである理由です。
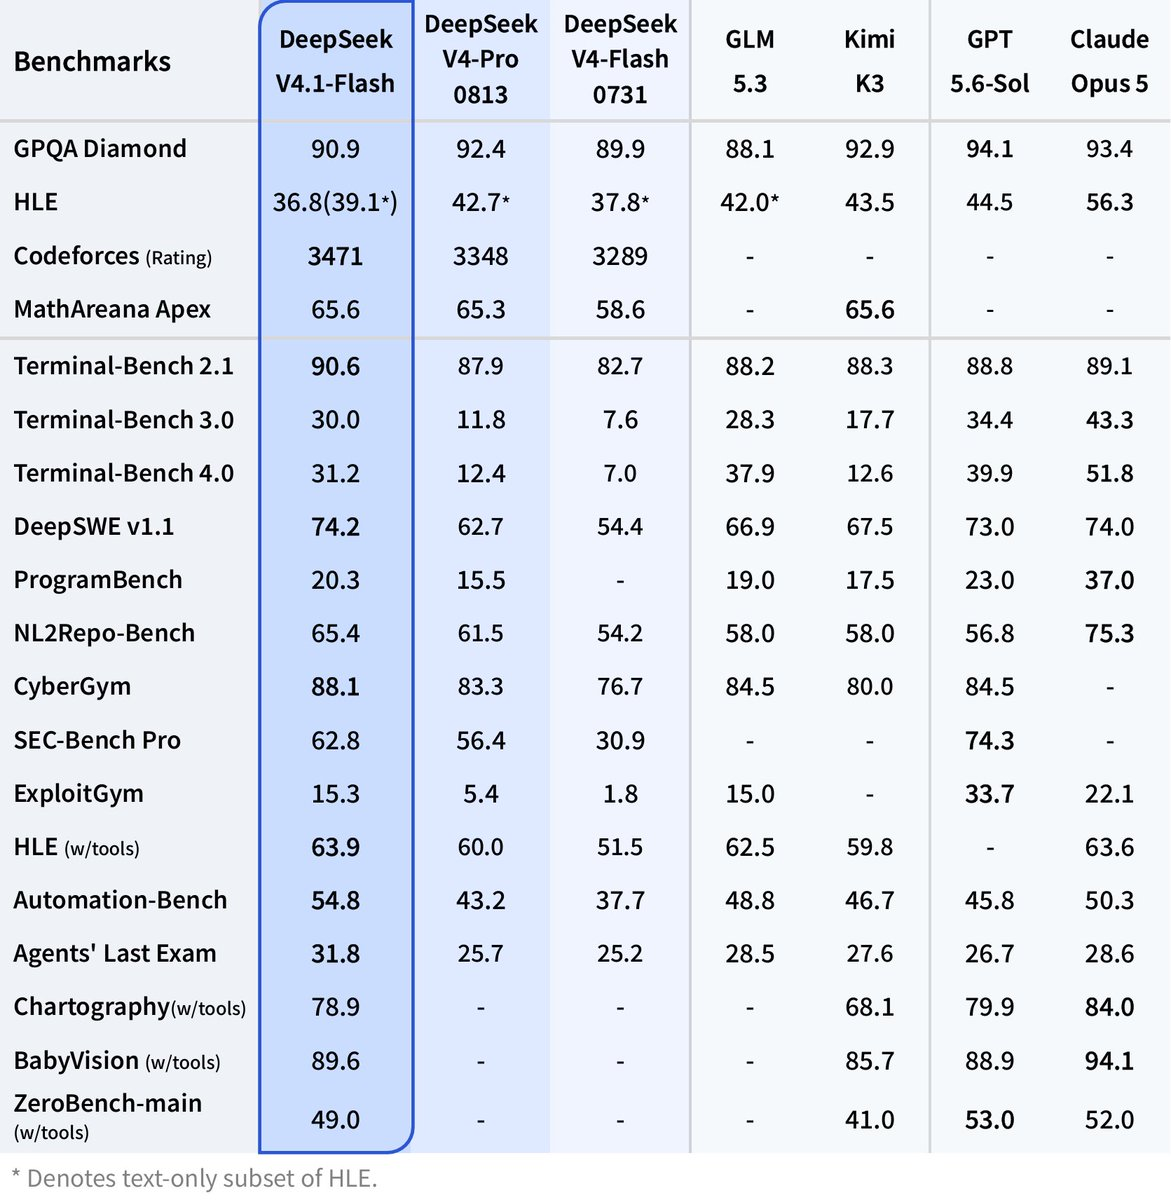
技術レポートにはアーキテクチャが完全に記載されています。カード上のベンチマーク数値はすべてDeepSeekが報告したものです。これらは主張として扱ってください。
メモリ計算
以下の数値は単純な乗算であり、測定値ではありません。また、エンジンオーバーヘッド、アクティベーション、およびビジョンエンコーダは除外されています。
| コンポーネント | サイズ | 計算方法 |
|---|---|---|
| バックボーンウェイト (8ビット) | 約552 GB | 5520億パラメータ x 1バイト |
| バックボーンウェイト (4ビット) | 約280 GB | 5520億パラメータ x 0.5バイト |
| KVキャッシュ (トークンあたり) | 890バイト | モデルカードより |
| KVキャッシュ (128Kコンテキスト) | 約0.11 GB | 890 x 128,000 |
| KVキャッシュ (1Mコンテキスト) | 約0.89 GB | 890 x 1,000,000 |
2つの点が目立ちます。まず、KVキャッシュは誤差の範囲です。100万トークンのセッションが1ギガバイト未満に収まるため、ウェイトの予算に触れることなく、何十もの長いセッションをメモリに保持できます。次に、ウェイトが問題の全てです。どの量子化トリックを使っても、5520億パラメータを単一の消費者向けGPUに収めることはできませんし、MoEルーティングはすべてのエキスパートがロードされ、アドレス可能である必要があるため、80億アクティブ設計も助けにはなりません。
それが、オフロードされたセットアップが不均衡に感じる理由でもあります。プレフィルはプロンプト全体にわたってバッチ処理され、計算がボトルネックになります。デコードは、トークンごとにRAMまたはSSDから160億のアクティブパラメータをページインします。1秒あたりのトークン数を決定するのは、FLOPsではなく帯域幅です。
現実的なハードウェアティア
ここにはスループットの数値はありません。DeepSeek以外の誰も、信頼できるベンチマークを公開できるほど長くウェイトを保持していません。
ティア1:マルチGPUサーバー、80GBクラスのカード4〜8枚。 80GBカード4枚で320GBが得られ、KVキャッシュとエンジンオーバーヘッドのためのわずかなマージンを含め、4ビットウェイトに十分です。8枚のカードでは640GBが得られ、8ビットチェックポイントまたは大規模バッチでの快適な4ビットデプロイに十分です。これは、「ローカルで実行する」ことがテンソル並列化による本番レベルのサービスを意味する唯一のティアであり、5桁または6桁の購入費用、あるいは1時間あたり数ドルのクラウドレンタル費用がかかります。
ティア2:CPUオフロードを備えた単一の大容量メモリワークステーション。 512GB以上のシステムRAMと1つまたは2つのGPUを搭載したマシンは、4ビットウェイトをRAMに保持し、必要に応じてエキスパート層をGPUにストリーミングできます。機能しますが、デコード帯域幅がHBMではなくDDR5バスであるため、遅いです。インタラクティブなチャットではなく、バッチジョブや夜間評価に使用してください。
ティア3:SSDストリーミングを備えたApple Silicon。 愛好家向けのパスです。512GBのMac Studioは、統合メモリに4ビットウェイトを保持できます。すでに所有している場合は、これは現実的な選択肢です。それ以下の場合、Kimi K3 HNスレッドの領域になります。外部SSDにウェイトが分割され、mmapが重い処理を行い、おおよそ1秒あたり1トークンです。これはモデルが動作することを証明するものであり、そのマシンで有用であることを意味するものではありません。Kimi K3をローカルで実行するためのガイドでは、より大きなモデルでの同様のトレードオフをカバーしており、DeepSeek V4をローカルで実行する方法では前世代をカバーしています。
セットアップパス
ハードウェアが整ったら、フローは次のようになります:ダウンロード、OpenAI互換エンドポイントの背後でのサービス提供、テスト。
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
1Gbps回線では、100GBごとにフルスピードで約15分かかります。1時間以上を見積もってください。
サービス提供には注意点があります。vLLM、SGLang、llama.cpp、OllamaでのCEDアーキテクチャとCSA2アテンションに対するDay-0サポートは[検証済み]です。新しいレイヤータイプは通常、ウェイトをロードする前にエンジンパッチを必要とし、リリースノートには特定のエンジンは記載されていません。ダウンロードを決定する前に、各プロジェクトの変更ログで「DeepSeek-V4.1」を検索してください。サポートが利用可能になったら、8つのGPUにわたるvLLMでのサービス提供は次のようになります。
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
GGUF変換が存在すれば、llama.cppのllama-serverまたはOllamaモデルは同じhttp://localhost:8000/v1形式のエンドポイントを公開するため、OpenAI SDKクライアントは1行変更するだけで動作します。
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "このインシデントレポートを要約し、3つの根本原因を挙げてください。"}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
temperature=1.0とtop_p=0.95の値は、モデルカードで推奨されている設定と一致します。Ollamaについては、当社のOllamaガイドでModelfileのフローを、vLLMガイドでマルチGPUフラグについて詳しく解説しています。
実用的な選択肢:ホスト型API
オフピーク時、料金ページではdeepseek-flashが100万キャッシュミス入力トークンあたり0.15ドル、100万キャッシュヒット入力トークンあたり0.003ドル、100万出力トークンあたり0.60ドルと記載されています。ピーク時はこれらの料金が2倍になります。したがって、1ヶ月あたり10億入力トークンと2億出力トークンの費用は、キャッシュヒットが入力側の料金をさらに下げる前で、オフピーク時に約270ドル、ピーク時に540ドルかかります。80GBクラスの8GPUサーバーは、ハードウェアの償却や管理者を雇う費用を考慮する前に、持続的な負荷がかかった場合の電気代と冷却費だけで、これを上回る費用が毎月かかります。データ常駐規則がある場合や、すでにアイドル状態のハードウェアがある場合を除き、コスト面ではAPIが優位です。切り替えはbase_urlの変更1つで済みます。DeepSeek-V4.1-Flash APIガイドでその手順を説明しています。
制約がお金ではない場合、ローカル運用が優位です。例えば、エアギャップ環境、外部に送信できないプロンプトデータ、またはウェイトを変更する必要がある研究などです。
Apidogでローカルエンドポイントをホスト型APIに対してテストする
どちらのパスを選択するにしても、トラフィックを向ける前に、ローカルサーバーがリファレンスのように動作することを証明してください。量子化のずれ、誤ったチャットテンプレート、または不足している停止トークンはすべて、微妙な出力の違いとして現れます。Apidogでのワークフローは次のとおりです。
- 2つの環境を作成します。 1つは
localと名付け、base_urlをhttp://localhost:8000/v1に設定します。もう1つはhostedと名付け、base_urlをhttps://api.deepseek.comに設定し、実際のキーを使用します。すべてのリクエストは{{base_url}}/chat/completionsとBearer {{api_key}}を使用します。 - 小さなプロンプトセットをリクエストとして保存します。 JSON抽出、コード修正、長文要約など、ワークロードを代表する5〜10個のプロンプトです。それらすべてで
modelをdeepseek-flashに設定します。これは両方のサーバーで動作します。 - アサーションを追加します。 JSONタスクの場合、レスポンスが解析され、必須のキーが存在することを確認するアサーションを追加します。すべてのリクエストについて、
finish_reasonがstopと等しいことを確認するアサーションを追加します。これは、不正なコンテキスト設定による切り詰めを捕捉します。 - 両方の環境に対してセットを実行します。 環境ドロップダウンを
hostedからlocalに切り替え、同じテストシナリオを再実行します。localのみで発生するエラーは、量子化またはテンプレートの問題であり、ワンクリックで特定できます。 - ストリーミングを監視します。
stream: trueを設定し、SSEビューを使用してイベントが1つずつ到着するのを確認します。送信前に応答全体をバッファリングするローカルサーバーは、非ストリーミング呼び出しでは問題なく見えますが、ここでは正しくありません。 - CIに組み込みます。 エンジンをアップグレードするたびに
apidog-cliでシナリオを実行し、破損したチャットテンプレートがユーザーではなくパイプラインを失敗させるようにします。
Apidogをダウンロードすれば、すべてのフローが1つのプロジェクトから実行できます。
よくある質問
DeepSeek-V4.1-Flashをラップトップで実行できますか? 実用的な意味ではできません。4ビットバックボーンは約280GBです。ラップトップでは、Kimi K3の実験と同様に、SSDから1秒あたり約1トークンの速度でストリーミングできますが、これはデモンストレーションであり、ワークフローではありません。APIを使用するか、DeepSeek-V4.1-Flashを無料で利用する方法に記載されているいずれかのオプションを使用してください。
80億のアクティブパラメータということは、VRAMが8GBしか必要ないということですか? いいえ。アクティブパラメータはトークンあたりの計算量を設定するもので、メモリではありません。MoEルーティングは、任意のトークンに対して各層の384個のエキスパートのいずれかを選択できるため、5520億パラメータすべてをロードしてアクセス可能にする必要があります。
100万コンテキストにはどれくらいのメモリが必要ですか? トークンあたり890バイトで、約0.89GBのKVキャッシュが必要です。これはこのモデルの安価な部分です。ウェイトが最も高価な部分です。
商用利用でもライセンスは安全ですか? はい。Hugging Faceのモデルカードによると、ウェイトはMITライセンスです。
まとめ
DeepSeek-V4.1-Flashは、法的にかつ技術的に重要な方法でオープンです。MITライセンスのウェイト、公開された技術レポート、そして100万トークンのセッションをメモリほぼ無料で利用可能にするKVキャッシュ設計が特徴です。しかし、あなたの机の下にあるマシンで実行できるという意味でオープンではありません。ほとんどのチームにとって、オフピーク時に100万入力トークンあたり0.15ドルのホスト型APIを使用するのが適切な選択であり、ローカルデプロイメントは外部に出せないデータのために確保されるべきです。
いずれにせよ、信頼する前にテストしてください。Apidogを両方のエンドポイントに向け、同じ保存されたリクエストを実行し、アサーションによってローカルビルドが参照と一致するかどうかを確認してください。