
Opus 5.5 で何かをリバースエンジニアリングするには、モデルを REA を介して逆アセンブリエンジンに接続し、段階的に作業します。ターゲットをルーティングし、マッピングし、最も呼び出しの多い関数をデコンパイルし、Opus に関数名を付けさせて説明させ、振る舞いのみの仕様書を作成し、その仕様書から別のコンテキストで再構築します。各段階に応じて努力レベルを合わせ、再構築が同等であることをパリティテストで証明します。
これは X でバイラルになったガイドの要約版です。2026年10月12日、ビルダーの Movez は Claude Opus 5.5 を使ったリバースエンジニアリングに関する11ステップのコースを公開しました。100万回閲覧され、2,800件のブックマークを獲得しました。この記事では、その主張を情報源と照合し、ベンチマークの詳細を2点修正し、ほとんどのガイドが省略するステップ、つまりターゲットが通信する API のテストを追加します。
これは、自分が所有しているか、調査を許可されているソフトウェアにのみ使用してください。REA の README は、このツールを「合法的な研究、教育、相互運用性、ソフトウェアの保存、および所有または調査を許可されているソフトウェアの分析」に限定しています。
Opus 5.5 がバイナリを読むためにツールを必要とする理由
Opus 5.5 はテキストの読み書きを行いますが、Mach-O や ELF ファイル自体を読み込むことはできません。REA は、エージェントと分析エンジン(ネイティブコードの場合は Hopper、Ghidra、IDA)の間に位置する MCP サーバーで、ローカルで分析を実行し、発見事項をその証拠とともに返します:アドレス、擬似コード、文字列、呼び出し箇所です。モデルはそれらの発見事項を読み、次の質問をします。
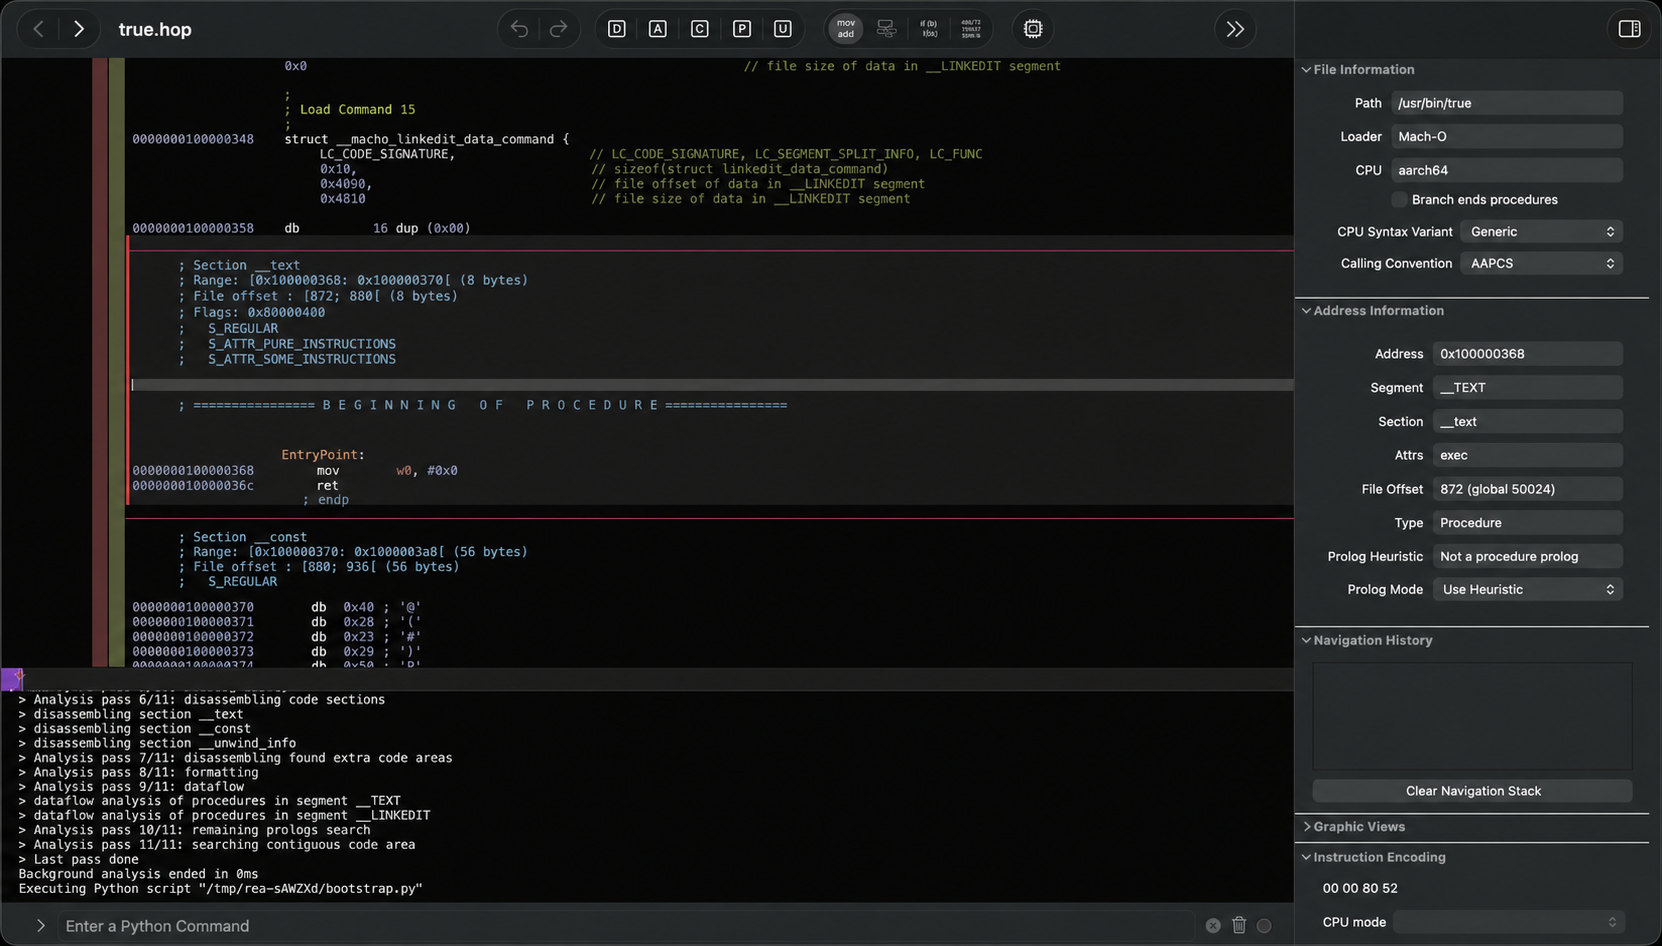
REA は2026年10月27日までに GitHub スターが393,000を超え、10月12日の約115,000から増加しました。最初に話題になったとき、私たちは REA とは何か、どのように機能するか と 1つのアプリ機能を再構築するための6ステップのループ を扱いました。このガイドはモデル側に焦点を当てます:プロンプト、努力設定、制限です。
ステップ1:REA をインストールし、ハウスルールを書く
REA には Node.js 22.23.4 以降(22系。24.22.1+ または 26.12.1+ も動作します)と npm が必要です。現在の npm リリースは 6.8.0 です。エージェントに登録します:
npx rea-agents setup
npm install --global rea-agents
rea --help
セットアップは設定変更をプレビューし、触れるものをバックアップし、Claude Code、Codex、Cursor、Gemini CLI、Grok Build をサポートします。ネイティブ分析には Hopper、Ghidra、IDA が必要です。JavaScript、Electron、.NET の検査にはエンジンは不要です。
次に、エージェントにハウスルールを与えます。コースの CLAUDE.md ブロックはスレッドの最良の部分です:
# Reverse-engineering house rules
- Only analyze targets I own or am authorized to examine. State the basis once.
- Tag every claim: observation, inference, or unknown.
- Cite the evidence: address, bytes, pseudocode or call site.
- Start with the smallest overview. Expand only on a concrete gap.
- Separate static facts from runtime facts.
- Build from behavior and public specs, never from copied code or assets.
- Every recovered behavior needs a passing test before "done".
ステップ2:各段階に応じた努力レベルを選ぶ
Opus 5.5 は5つの努力レベルをサポートします:low、medium、high、xhigh、max です。Anthropic の努力に関するドキュメントによると、Opus 5.5 のデフォルトは medium で、xhigh は長時間のエージェント実行を対象とし、max はトークン消費のすべての制限を解除します。API では output_config.effort で設定するか、エージェントの努力設定で設定します。
コースの分割は妥当な出発点であり、測定されたルールではありません:
| 段階 | 推奨努力レベル | 理由 |
|---|---|---|
| ルーティング、偵察、ナビゲーション | medium |
主にツール呼び出しと一覧表示 |
| 通常の関数の注釈付け | high |
命名にはデータフローの推論が必要 |
| 長時間の複数関数セッション | xhigh |
30分を超える実行向けに設計 |
| 難読化された、またはポインタが多いコード | max |
最も深い推論、最高コスト |
セッション単位ではなく、関数単位で努力レベルを上げてください。
ステップ3:何かを開く前にターゲットをルーティングする
最もよくある初心者の間違いは、JavaScript が丸見えの Electron アプリで逆アセンブラを開くことです。REA はデスクトップインストール、ネイティブバイナリ、JavaScript および Electron アプリ、.NET アセンブリ、Android APK、WASM、Web サイト、保存されたネットワークキャプチャをカバーし、それぞれに専用のエントリツールがあります。最初のプロンプトではターゲットを特定するだけにしてください:
I want to understand how [FEATURE] works in [APP] at [ABSOLUTE PATH].
First tell me what kind of target this is (native, Electron/JS, .NET, APK, WASM)
and which REA tool opens it. Don't start deep analysis yet.
Then give me a one-paragraph map and where you'd look first for [FEATURE].
Keep observations, inferences and unknowns separate.
Electron ターゲットは analyze-javascript-application に進みます(モジュール、インポート、IPC 境界、エンジンなし)。ネイティブターゲットは open_binary に進みます。
ステップ4:文字列をマッピングし、クロスリファレンスで関数をランク付けする
まだコードを読まないでください。ネイティブターゲットの場合、インベントリから始めます:
rea inspect /absolute/path/to/program --provider ghidra --json
rea search /absolute/path/to/program entry --kind procedures --provider ghidra --json
文字列は最速の手がかりです:URL、エラーメッセージ、機能名。ベース URL や Authorization: Bearer 文字列も、バイナリが API と通信していることを示し、これはステップ9で重要になります。
次に、クロスリファレンス(呼び出し元の数)で関数をランク付けします。147 の呼び出し元を持つ関数は、設定ローダーのようなコアインフラストラクチャである可能性が高いです。呼び出し元が2つの関数は後回しにできます。上から下へ読みます。
ステップ5:1つの関数をデコンパイルし、Opus に名前を付けさせる
単一のホットな関数をデコンパイルします:
rea function /absolute/path/to/program parseConfig --provider ghidra --json
rea decompile /absolute/path/to/program --procedure=parseConfig --provider ghidra --json
出力は粗いものです(var_28、至る所にキャスト)。固定チェックリストを付けて、high 努力で Opus 5.5 に渡します:
Here is decompiled pseudocode for a function with 147 cross-references.
1. Rename every variable based on how it is used.
2. State the function's purpose in one sentence.
3. List the data structures it reads and writes.
4. Name the pattern (singleton, factory, state machine, observer).
5. Flag missing error handling, validation or security checks.
Mark anything you're unsure of instead of guessing.
デコンパイラは細部を間違えます。REA の DX-Ball ショーケースでは、最初の擬似コードは入力を受け取らないサウンドパン関数を示していました。命令ビューだけがパラメータを明らかにしました。最終的な C 再構築は3,205の元の x86 テストケースに合格し、63個のコンパイル済み関数バイトをすべて再現します。それはエージェントが擬似コードをアセンブリと呼び出し元に対してクロスチェックしたからです。シグネチャがおかしいと思ったら、rea instructions を要求してください。
ステップ6:難読化されたコードは予算を決めて、延々と取り組まない
ここが、バイラルになったコースを訂正する必要がある点です。それは Elastic Security Labs の難読化ベンチマークを「Claude Opus」のテストとして引用しています。2026年4月21日に公開された Elastic の研究は、Opus 5.5 ではなく Claude Opus 4.6 をテストしました。数値は:
| Tigress フェーズ | 解決数 |
|---|---|
| 変換なし | 1/1 |
| 単一変換 | 4/6 |
| ペア変換 | 3/6 |
| 高負荷、多層 | 0/6 |
合計で、Opus 4.6 は評価可能な20のターゲットのうち8つ(40%)を解決しました。成功の平均は$2.39、失敗は$4.83で、失敗は成功の約2倍のコストがかかります。これらは下限として扱い、Opus 5.5 の測定値とは考えないでください。5.5 に相当する公開されたものは見つかりませんでした。
第二に、コースでは、Caveman というツールがデコンパイルされたジャンクの「約75%を除去する」と述べています。Elastic は Caveman を、デコンパイルされたコードのフィルターではなく、モデル自身の冗長性を最大75%削減するプラグインと説明しています。
教訓は生き残ります:難読化された関数ごとに支出を上限設定し、1~10の信頼スコアを求め、隣接するものが解決されるまで、6未満のものは保留します。
ステップ7:大きなターゲットをコントローラーとワーカーに分割する
1つのチャットで500の関数を保持することはできません。名前を忘れ、矛盾します。コースの修正は、コードを決して分析しないコントローラーと、それぞれが1つの関数を担当するワーカーです:
Controller: The function map is in functions.json (address, name, size, xrefs).
Cluster functions by call-graph proximity, order clusters by xref count,
send each cluster to a worker, inject already-resolved struct names into every
brief, and queue a second pass for any result with confidence below 6.
Report token spend after each cluster.
各ワーカーは、アドレス、目的、1~10の信頼スコア、使用または発見した構造体、クリーンなソースを返し、コントローラーの構造体名を再利用します。Elastic のベンチマークも同じコントローラーとワーカーの形で実行されました。
ステップ8:クリーンなコンテキストで振る舞いのみの仕様書を書く
クリーンルーム再構築は、ソフトウェアが何をするかをコピーし、そのコードは決してコピーしません。Opus に振る舞いのみの仕様書を求めます:公開インターフェース、データモデル、テスト可能な要件としての各機能、公開標準からのファイル形式、エラー処理。アドレス、デコンパイルされた名前、コピーされたものは禁止します。
次に、その分析を見ることのない別のコンテキストで、その仕様書から実装します。その分離がクリーンルームの境界です。これはエンジニアリングの実践であり、法的助言ではありません。
ステップ9:API 契約を復元し、Apidog CLI でテストする
ステップ4の文字列はしばしばベース URL と認証ヘッダーを明らかにするので、振る舞いの一部は API の背後にあります。あなたの再構築は、その契約も守る場合にのみ一致し、トラフィックはアセンブリよりも速くそれを示します。
所有しているテストアカウントで HAR を記録し、REA に要約させます:
rea inspect-web-network-capture /absolute/session.har har --json
次に、エージェントにそのキャプチャを Apidog CLI でテスト済みの契約に変換させます。一度セットアップします:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
エージェントに1つのプロンプトを与えます:
Import session.har into Apidog project <id>. List the endpoints it created,
remove anything that isn't part of [FEATURE], and write one test case per
endpoint that asserts status code, required fields and response schema.
Run them against the original-service environment, then against my rebuild's
environment, and report every endpoint where the two disagree.
エージェントはインポートを実行し、書き込む前にペイロード形状を確認し、両方の環境を実行します:
apidog import --project <id> --format har --file ./session.har
apidog endpoint list --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog test-case run --project <id> --endpoint <endpointId> -e <originalEnvId> -r cli,json
apidog test-case run --project <id> --endpoint <endpointId> -e <rebuildEnvId> -r cli,json
同じケース、2つの環境、1つの差分、-r junit で毎回のコミットで再実行可能(Apidog CLI CI/CD ガイドを参照)。Claude Code から操作したい場合は、Claude Code での Apidog CLI を参照してください。Apidog の無料プランは最大4ユーザーまで対応します。手動アプローチについては、API のリバースエンジニアリングを参照してください。
ステップ10:出荷前に同等性を証明する
「一致すると思う」は証拠ではありません。ローカルの振る舞いについては、Opus に、元のプログラムと再構築の両方に同じ入力を与えるハーネスを構築させます:
Generate 50 inputs: 30 normal, 10 edge (empty, max size, unicode), 10 error
(malformed, missing fields, corrupt). Run each through both programs. Compare
byte-for-byte where possible, semantically otherwise. Report the match rate and
every divergence as cosmetic, behavioral or critical.
ステップ9の API 実行により、誰にでも示せる2つの数値が得られます:ローカル一致率と API 一致率です。最後ではなく、構築しながらテストします。
よくある質問
Opus 5.5 でのリバースエンジニアリングは合法ですか? 管轄地域、ライセンス、目的によります。REA は、合法的な研究、教育、相互運用性、保存、および所有または調査を許可されているソフトウェアの分析をサポートします。再構築を商業的に出荷する前に法的助言を求めてください。
リバースエンジニアリングにはどの努力レベルを使うべきですか? ルーティングと偵察には medium から始め、関数の注釈付けには high、難読化されたコードには関数ごとの予算を付けて max を取っておきます。Opus 5.5 のデフォルトは medium です。
Claude は難読化されたバイナリをどの程度扱えますか? Elastic Security Labs による唯一の公開ベンチマークは Opus 4.6 をテストしました:20の Tigress ターゲットの40%を解決し、高負荷の多層ターゲットは0%でした。Opus 5.5 に相当するテストは公開されていません。
リバースエンジニアリングされたアプリが使用する API をテストするにはどうすればよいですか? テストアカウントで HAR をキャプチャし、apidog import --format har でインポートし、Apidog CLI でテストケースを作成して、元のサービスと再構築の両方に対して実行します。
REA はバイナリをアップロードしますか? REA はローカルで分析を実行します。エージェントがモデルに渡す発見事項(文字列、擬似コード)のみがモデルプロバイダーに届きます。