
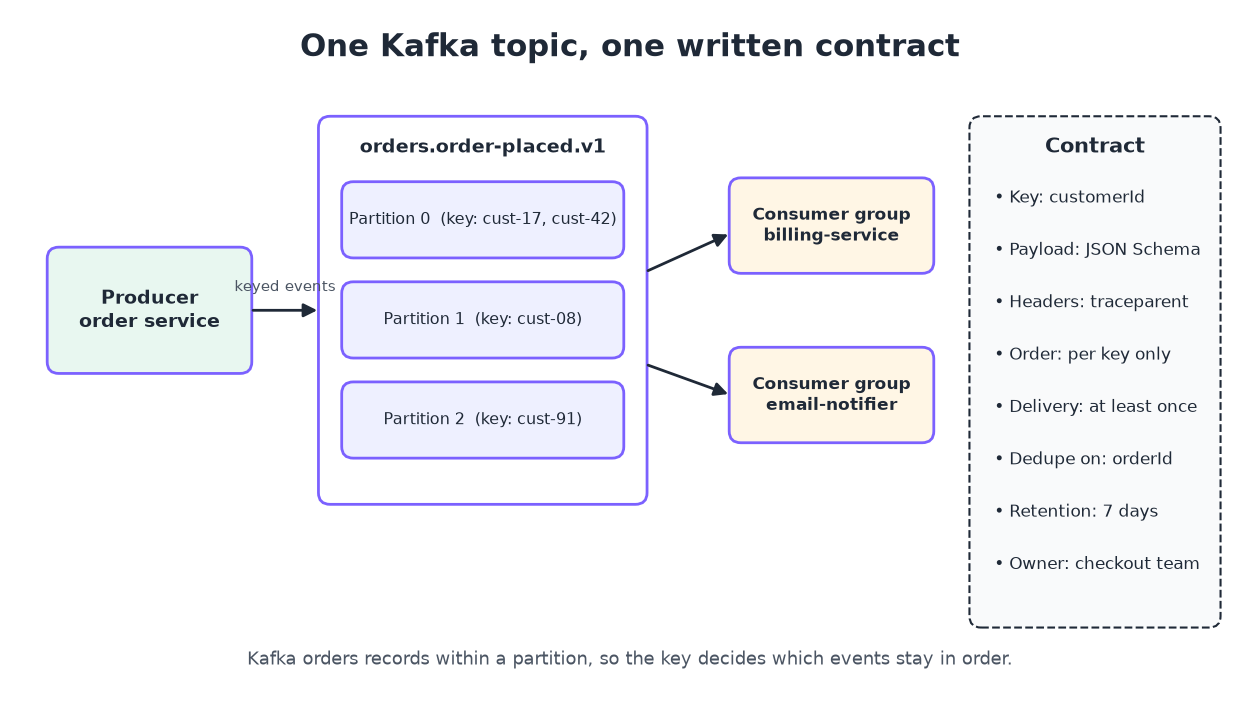
Kafka APIをドキュメント化するには、トピックごとにコントラクト(契約)を記述しましょう。コントラクトには、トピック名、イベントキー、ペイロードスキーマ、ヘッダー、順序性と配信の保証、コンシューマーグループ、保持期間、オーナーを記載します。そして、そのコントラクトをHTTP APIドキュメントの隣に保管しましょう。そうすれば、プロデューサーとコンシューマーは、稼働中のクラスターからメッセージを逆解析する代わりに、単一の信頼できる情報源を参照できます。
このガイドでは、コントラクトの各要素、AsyncAPIでの記述方法、スキーマを安全に進化させる方法、そしてApidog CLIを使ってコーディングエージェントに作業を任せる方法を解説します。
イベント駆動設計が初めての方は、まずイベント駆動APIの構築方法とWebhookとイベント駆動アーキテクチャのガイドをご覧ください。
Kafka APIとは何か?
Kafka APIとは、サービスがApache Kafkaクラスターを通じてイベントをやり取りするために使う、トピック、メッセージ形式、配信ルールの集合です。REST APIとは異なり、エンドポイントを呼び出して応答を待つということはありません。プロデューサーはレコードをトピックに書き込み、コンシューマーは各自のタイミングでそれを読み取ります。そしてコントラクトは、それらのレコードの構造と意味の中に存在します。
Kafkaの公式ドキュメントには、「イベントはキー、値、タイムスタンプ、そしてオプションのメタデータヘッダーを持つ」と明記されています。Kafka自体は値の中身を検証しません。プロデューサーがある日はJSONを書き込み、翌日には異なる構造のJSONを書き込んでも、ブローカーはその両方を受け入れます。だからこそ、Kafka APIにはHTTP API以上に文書化されたコントラクトが必要なのです。トランスポート層には、破壊的変更を防ぐ仕組みが何もないからです。
ドキュメント化されていないトピックは、予想どおりの形で問題を引き起こします。コンシューマーが1つのサンプルからフィールドの型を推測してnullでクラッシュしたり、新しいサービスが各メッセージを「少なくとも1回」受け取ることを知らずに、リトライで二重課金してしまうといった具合です。
Kafkaトピックごとにドキュメント化すべきこと
すべてのトピックに、同じ中核的な情報が必要です。次の表をチェックリストとして使ってください。
| コントラクト項目 | 記載すべき内容 | 例 |
|---|---|---|
| トピック名 | 完全な名前と命名規則 | orders.order-placed.v1 |
| 目的 | イベントの意味を説明する1文 | 「注文が支払いを通過し、出荷可能になった」 |
| イベントキー | どのフィールドがキーか、その理由 | customerId。特定の顧客の注文が順序どおりに処理されるようにするため |
| ペイロードスキーマ | 全フィールド、型、必須フラグ、形式 | JSON Schema、Avro、またはProtobuf |
| ヘッダー | 各ヘッダーの名前、型、意味 | traceparent、schema-version |
| パーティションと順序性 | パーティション数と順序の保証 | 12パーティション、customerIdごとに順序保証 |
| 配信セマンティクス | 少なくとも1回、冪等プロデューサー、トランザクション | 少なくとも1回。コンシューマーはorderIdで重複排除が必要 |
| コンシューマーグループ | 既知のグループとそれぞれの役割 | billing-service、email-notifier |
| 保持期間 | レコードが読み取り可能な期間 | 7日間 |
| オーナー | 担当チーム、連絡先、バージョンポリシー | チェックアウトチーム、#checkout-events |
特に重要なのは順序性と配信の行です。サンプルメッセージからこれらを推測することはできません。
Kafka APIを6ステップでドキュメント化する方法
- すべてのトピックとそのオーナーを一覧化する。 クラスターからトピック一覧を取得し、それぞれのプロデューサーを特定します。
- キーを定義する。 どのフィールドがキーであるか、それが順序性にどう影響するかを記録します。
- ペイロードスキーマを記述する。 すべてのフィールドをJSON Schema、Avro、またはProtobufで記述します。
- ヘッダーとメタデータを説明する。 トレーシング、スキーマバージョン、コンテンツタイプのヘッダーを含めます。
- 保証を明記する。 配信セマンティクス、順序の範囲、保持期間、コンシューマーグループをドキュメント化します。
- 人が見る場所に公開する。 HTTP APIドキュメントの隣にコントラクトを置き、コードと同じようにバージョン管理します。
ステップ1と2:トピックとキー
<domain>.<event>.<version>のような命名パターンを使えば、読み手はトピックのオーナーと参照しているバージョンを把握できます。次にキーをドキュメント化しましょう。キーがパーティションを決めるからです。Kafkaのドキュメントには「同じイベントキー(顧客IDや車両IDなど)を持つイベントは同じパーティションに書き込まれ」、コンシューマーはパーティションのイベントを「書き込まれたのとまったく同じ順序で読み取る」と記載されています。
したがって、コントラクトには単に「順序保証あり」ではなく、「customerIdごとに順序保証」と記載すべきです。Kafkaが順序を保証するのはパーティション内のみであり、トピック全体にわたっては決して保証しません。
ステップ3:ペイロードスキーマ
ペイロードはコンシューマーがコードを書く対象となる部分なので、フィールドごとに記述しましょう。以下はorder-placedイベントのJSON Schemaです:
{
  "type": "object",
  "required": ["orderId", "customerId", "totalCents", "currency", "placedAt"],
  "properties": {
    "orderId": { "type": "string", "description": "Unique order ID; use it to deduplicate" },
    "customerId": { "type": "string", "description": "Also the record key" },
    "totalCents": { "type": "integer", "minimum": 0 },
    "currency": { "type": "string", "enum": ["USD", "EUR", "GBP"] },
    "placedAt": { "type": "string", "format": "date-time" },
    "couponCode": { "type": ["string", "null"] }
  }
}
「use it to deduplicate(重複排除に使用)」というdescriptionは、フィールドの型だけでなく、そのフィールドをコンシューマーがどう扱うべきかを伝えています。この形式が初めての方はJSON Schemaとは何かをご覧ください。
ステップ4と5:ヘッダーと保証
各ヘッダー(トレースコンテキスト、スキーマバージョン、コンテンツタイプ)を一覧化し、コンシューマーがそれに依存できるかどうかを明記します。次に、配信保証をKafka自身の用語で記述します。Kafkaの設計ドキュメントには、「Kafkaはデフォルトでat-least-once(少なくとも1回)の配信を保証し」、メッセージは「決して失われることはないが、再配信される可能性がある」と記載されています。プロデューサーが冪等オプションやトランザクションを使っているなら、そのことを明記してください。使っていない場合は、コンシューマーに重複排除を指示し、どのフィールドで重複排除するかを指定しましょう。
コンシューマーグループもドキュメント化しましょう。各購読グループ内では、1つのパーティションは同時に「必ず1つのコンシューマーによってのみ消費されます」。これにより、読み手はグループがどこまでスケールアウトできるかを把握できます。つまり、パーティションごとにアクティブなコンシューマーは1つだけです。
AsyncAPIでコントラクトを記述する
ツールには機械可読な形式が必要で、Kafkaの場合は通常AsyncAPIが使われます。「メッセージ駆動型APIを機械可読な形式で記述する」ための仕様です。RESTにおけるOpenAPIと同じ役割を果たします。
AsyncAPI 3.0のドキュメントは、info、servers、channels、operations、componentsで構成されます。チャネルはaddressを通じてトピックに対応し、各操作にはsendまたはreceiveのactionが設定されます:
asyncapi: 3.0.0
info:
  title: Orders events
  version: 1.0.0
channels:
  orderPlaced:
    address: orders.order-placed.v1
    messages:
      orderPlaced:
        $ref: '#/components/messages/orderPlaced'
operations:
  publishOrderPlaced:
    action: send
    channel:
      $ref: '#/channels/orderPlaced'
components:
  messages:
    orderPlaced:
      payload:
        $ref: './schemas/order-placed.json'
AsyncAPIには、サーバー、チャネル、操作、メッセージの各レベルにKafkaバインディングもあります。これは、汎用的なフィールドでは表現できないKafka固有の詳細を記述する場所です。仕様はプロデューサーのリポジトリに置きましょう。そうすれば、イベントを変更するプルリクエストが、そのコントラクトも同時に変更することになります。
Kafkaのスキーマ進化:互換性ルールをドキュメント化する
スキーマはいずれ変更されます。コントラクトには、どの変更が安全かを明記すべきです。スキーマレジストリを使用している場合は、その互換性モードをドキュメント化してください。Confluentのスキーマ進化ドキュメントには以下のモードが記載されており、「Confluent Schema Registryのデフォルトの互換性タイプはBACKWARD」とされています:
| モード | 誰が何を読み取れるか |
|---|---|
| BACKWARD | 新しいスキーマのコンシューマーは、前のスキーマで書き込まれたデータを読み取れる |
| BACKWARD_TRANSITIVE | 新しいスキーマのコンシューマーは、それ以前のすべてのスキーマで書き込まれたデータを読み取れる |
| FORWARD | 前のスキーマのコンシューマーは、新しいスキーマで書き込まれたデータを読み取れる |
| FORWARD_TRANSITIVE | それ以前の任意のスキーマのコンシューマーは、新しいスキーマで書き込まれたデータを読み取れる |
| FULL | 前のスキーマに対して後方・前方の両互換 |
| FULL_TRANSITIVE | それ以前のすべてのスキーマに対して後方・前方の両互換 |
| NONE | 互換性チェックは無効 |
実務では、BACKWARDモードの下ではオプションフィールドの追加や、デフォルト値を持つフィールドの削除が可能です。必須フィールドの名前変更や型変更はコンシューマーを壊します。破壊的変更が必要な場合は、新しいトピックバージョン(orders.order-placed.v2)を公開し、両方をドキュメント化して、旧バージョンの廃止日を設定しましょう。
Apidog CLIでコーディングエージェントにKafka APIのドキュメント化を任せる
手書きのコントラクトは、誰かがプロデューサーを変更した瞬間に陳腐化します。コーディングエージェントなら、プロデューサーコードを読み、スキーマを書き、あなたがレビューする間にドキュメントを同期させ続けることができます。Apidog CLIは、Claude Code、Codex、Cursor、その他のターミナルエージェントに、Apidogプロジェクト内でそれを実現するコマンドを提供します。
CLIをインストールしてログインし、エージェントがコマンドを認識できるようApidogスキルを追加します:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
セットアップ自体をエージェントに任せることもできます。Apidog CLIインストールガイドを読んで自分でセットアップするよう指示しましょう。
次に、エージェントに次のプロンプトを1つ与えます:
Read the Kafka producers in ./services/orders. For every topic they write to,
create an Apidog data schema in project <projectId> for the message payload,
then create one Markdown doc per topic with the key, headers, ordering,
delivery guarantee, consumer groups, retention and owner. Validate every
payload before you write it.
エージェントはペイロードの構造を確認し、ファイルを検証してから、スキーマとコントラクトページを書き込みます:
apidog cli-schema get schema-create
apidog cli-schema validate schema-create --file order-placed.schema.json
apidog schema create --project <projectId> --file order-placed.schema.json
apidog cli-schema get doc-create
apidog doc create --project <projectId> --file order-placed.doc.json
apidog schema list --project <projectId>
apidog schema createは、ペイロードを再利用可能なデータスキーマとして保存します。HTTPエンドポイントから同じモデルを参照できるので、一度定義したOrderでRESTレスポンスとKafkaイベントの両方をカバーできます。apidog doc createはMarkdownドキュメントをプロジェクトツリーに書き込み、上の表に挙げたトピックコントラクトを保持します。プロデューサーが変更されたら、プロンプトを再実行すれば、エージェントがapidog schema updateを使って更新します。エージェント駆動のドキュメント作業の詳細については、CLIからAPIをドキュメント化する方法とClaude CodeでのApidog CLIをご覧ください。
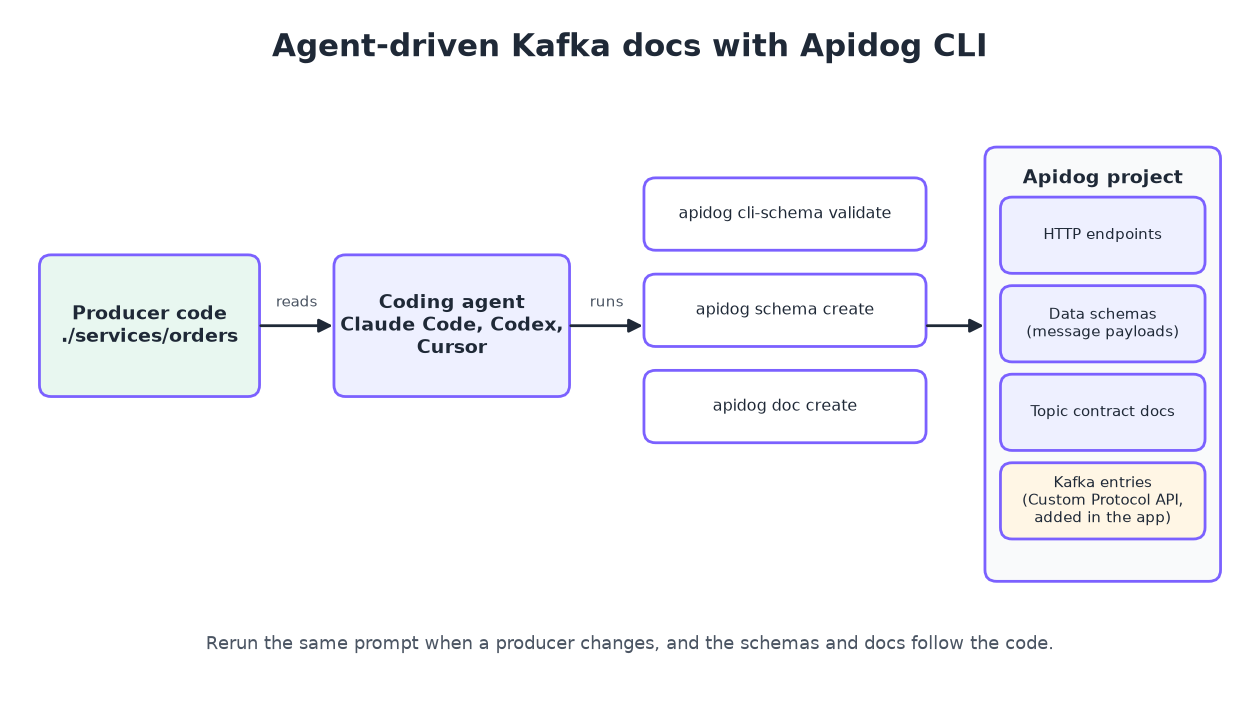
1つのステップだけはアプリ内での作業が残ります。ApidogのカスタムプロトコルAPIを使えば、KafkaエンドポイントをHTTPエンドポイントと並べてドキュメント化できます:新規その他のプロトコルAPIを選択し、その他のカスタムプロトコルAPIを選び、プロトコルとしてKafkaを指定して、URI(トピック)、名前、ステータス、メンテナー、タグ、説明を入力します。これらのエントリは、HTTPドキュメントとフォルダーツリー、検索、クイック共有を共有します。現在のところCLIにはカスタムプロトコルエンドポイント用のコマンドがないため、これが手動で作成する唯一の部分です。
Apidogの無料プランは最大4ユーザーまで利用できるため、小規模チームならRESTとKafkaのドキュメントを無料で1つのプロジェクトにまとめられます。
FAQ
Kafka用のOpenAPIは存在しますか?
AsyncAPIがその役割を果たします。サーバー、チャネル(トピック)、操作、メッセージペイロードをYAMLまたはJSONで記述し、Kafka固有のバインディングも備えています。
Kafka APIのドキュメント化にスキーマレジストリは必要ですか?
必須ではありませんが、あると便利です。ドキュメントはルールを述べるだけですが、レジストリは書き込み時にそれを強制します。運用している場合は、その互換性モードをドキュメント化しましょう。
Kafkaトピックのドキュメント化とRESTエンドポイントのドキュメント化の違いは何ですか?
RESTのドキュメントはリクエストとレスポンスを記述します。一方Kafkaのドキュメントは、多くのコンシューマーが後から読み取る1つのメッセージを記述するため、キー、順序の範囲、配信保証、保持期間、コンシューマーグループも必要になります。これらは典型的なRESTドキュメントには現れないものです。
ApidogでKafkaメッセージをテストできますか?
ApidogはカスタムプロトコルAPIを通じてKafkaエンドポイントをドキュメント化できますが、Kafkaメッセージの送受信は行いません。コントラクトとペイロードスキーマの管理にはApidogを使い、プロデューサーとコンシューマーのコードのテストにはKafkaクライアントライブラリを使ってください。
Kafkaのドキュメントはどのくらいの頻度で更新すべきですか?
プロデューサーがメッセージを変更するたびです。コードレビューと紐付けましょう。イベントを変更するプルリクエストでコントラクトを更新するか、エージェントにApidog CLIで再生成させます。