
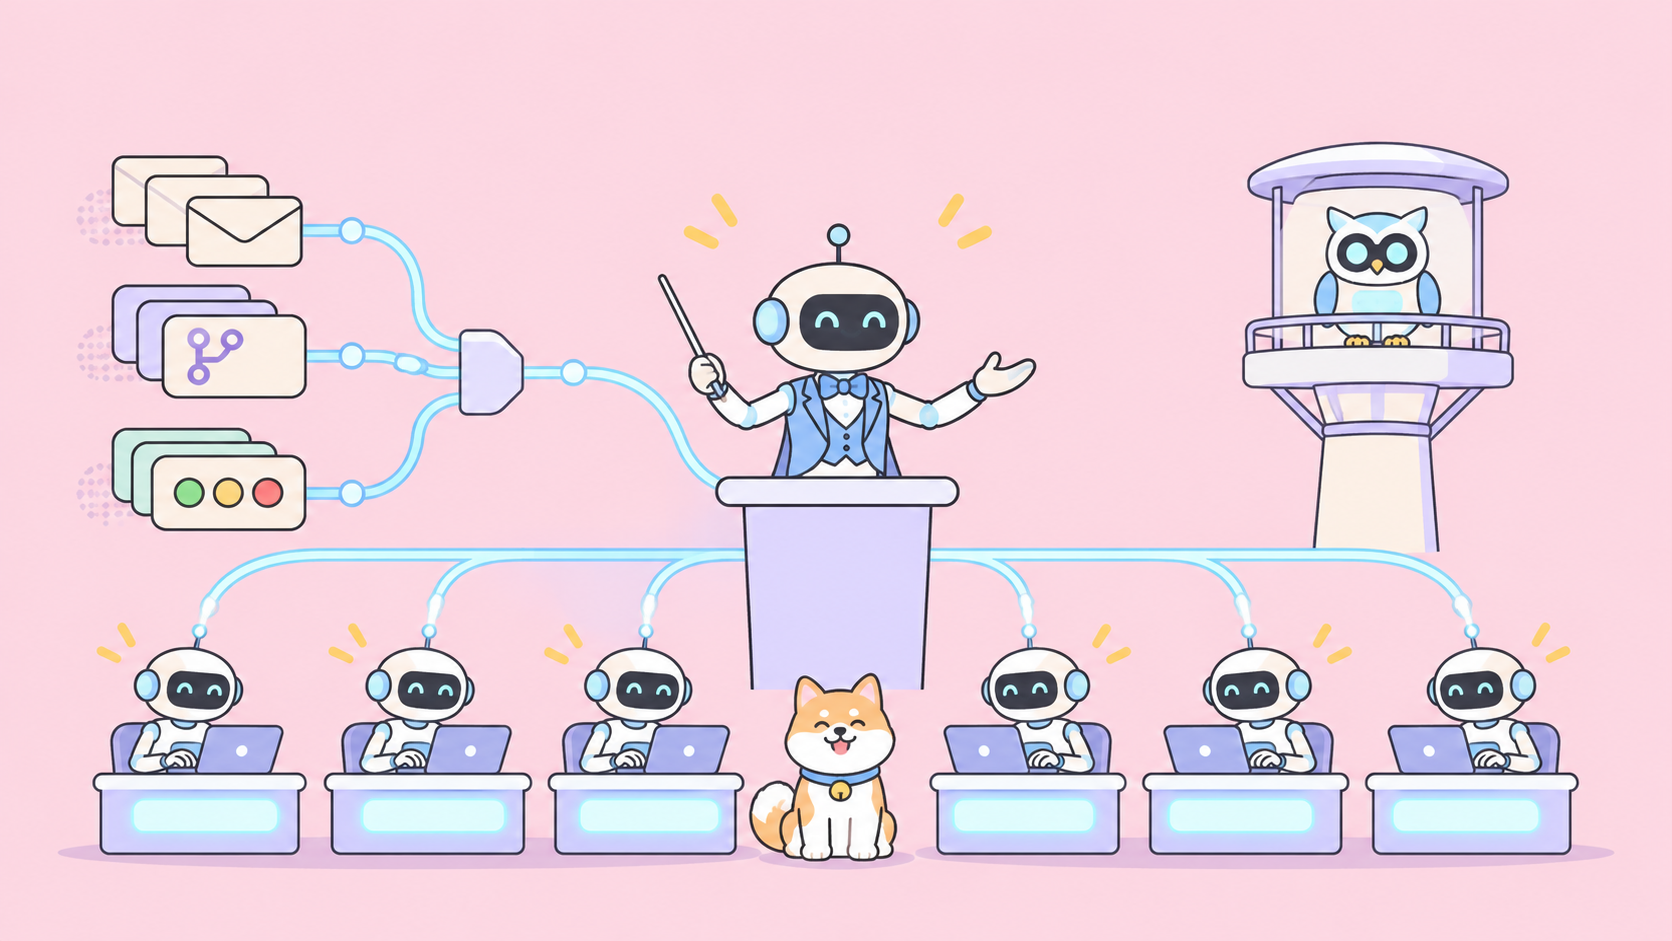
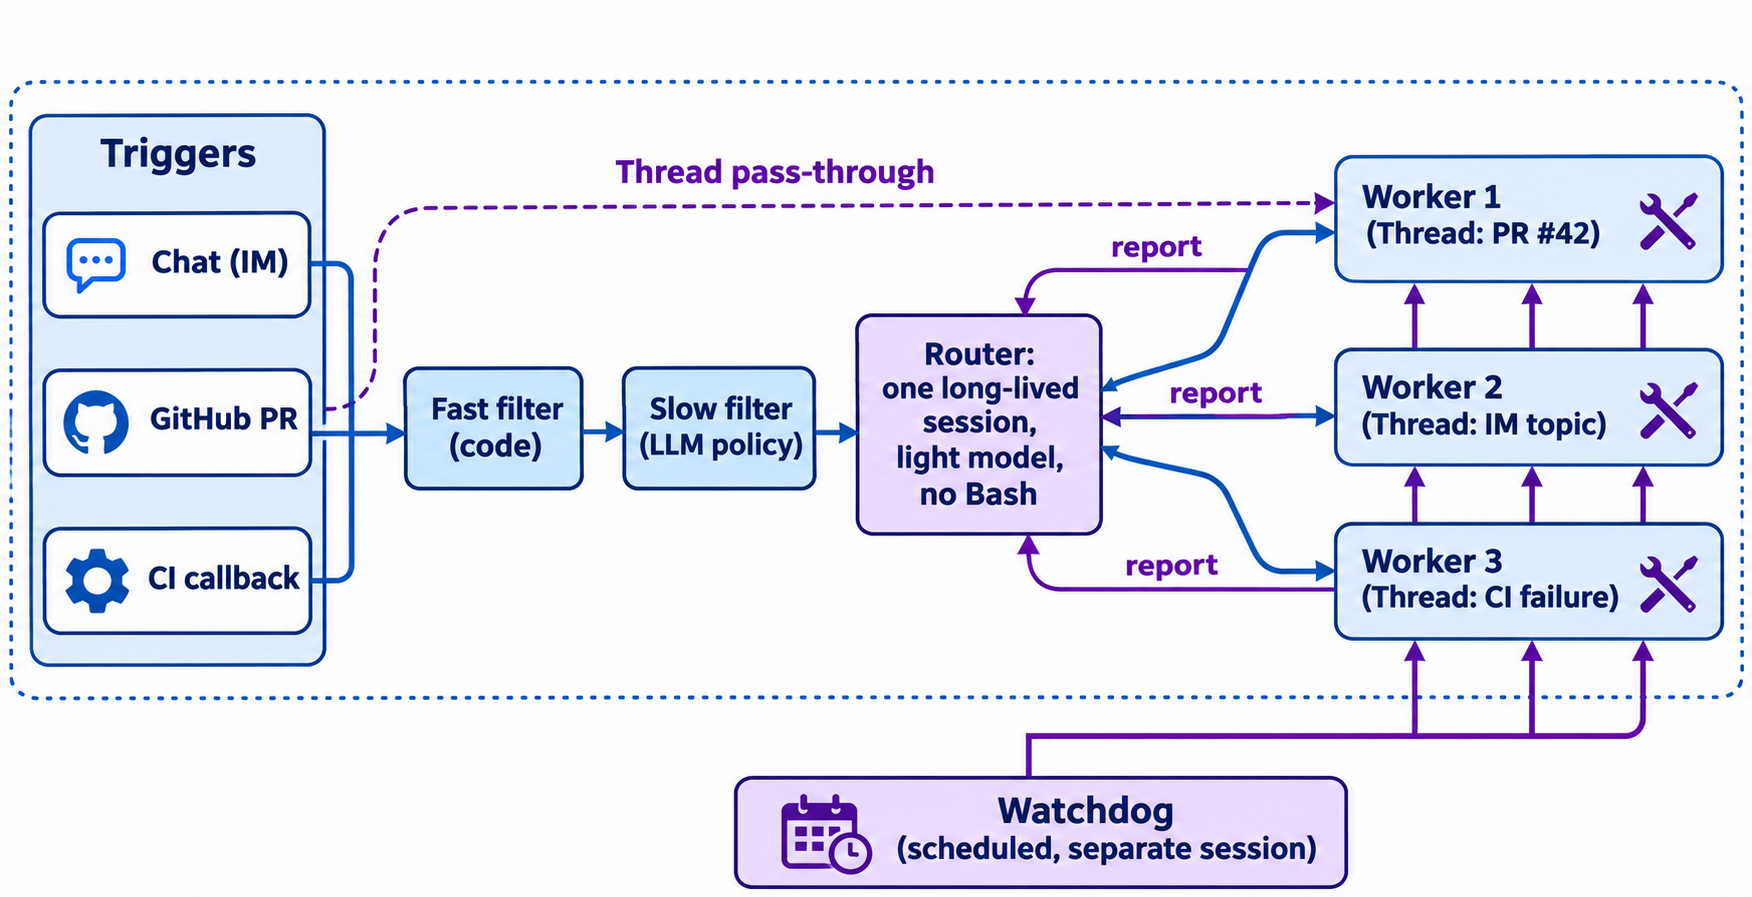
DeepSeek Harnessが提唱するようなスーパーエージェントを構築するには、エージェントを2つのレイヤーに分割します。1つは人間と対話しタスクを振り分ける常駐型のRouterセッション、もう1つはツールをフル活用して単一のタスクをそれぞれ実行する、隔離された複数のWorkerセッションです。両者にはイベントTriggers(チャット、GitHub、CIなど)から入力を供給し、後続のやり取りはThread単位でルーティングし、さらに全体を監視する独立したWatchdogを追加します。
本ガイドでは、DeepSeek Harnessの設計論考「Exploring Super-agent Design」をもとに、具体的な構築手順へと落とし込んで解説します。なお注意点として、この論考で解説されているのはアーキテクチャであり、正式リリースされた機能ではありません。その一部はdsh-superagent-prototypeと呼ばれるプロトタイププラグインに実装されていますが、著者らは「公式のDeepSeek製品ではない」としています。本記事に掲載しているコードスニペットはすべて概念を示すためのサンプルであり、DeepSeek公式のコードではありません。
スーパーエージェントとは?
スーパーエージェントとは、多様なチャネル(チャット、プルリクエスト、CIなど)からイベントを受け取り、隔離されたセッションで複数のタスクを並行実行しながら、一貫した1人のアイデンティティとして人間に返答する、常時稼働型の単一AIチームメイトです。
従来の課題として、エージェントセッションは互いに孤立しており、「人間が一度に把握できるアクティブなセッション数は通常3〜5個程度」という点が挙げられます。単一タスクの処理能力はモデル自体の性能に制約されますが、マルチタスクのボトルネックになるのは人間のアテンション(注意の限界)です。スーパーエージェントは、この後者の限界を打破することを目的としています。
スーパーエージェントには4つの特徴があります。
- 継続性(Continuous):IMとGitHubをまたいで単一のエージェントとして機能します。チャットでプランAを議論した後にPRのコメントでプランBに変更しても、文脈を見失わずに追従します。
- 高い生産性(Productive):タスクを並行して実行し、直前のタスクが完了する前に次の指示を受け付けることができます。
- プロアクティブ(Proactive):イベントを常時監視し、対応が必要になるまで不要な介入はせず静かに控えています。
- 高可用性・永続性(Persistent):常にオンライン状態を維持し、障害発生時も自律的に復旧します。
Harness自体を初めて知る方は、まずはDeepSeek Harnessの概要や、Claude Codeとの比較記事からご覧ください。
スーパーエージェントのアーキテクチャ:5つのモジュール
設計論考では5つのモジュールが提示されています。それぞれの役割と構築ステップは以下のとおりです。
| モジュール | 役割 | 構築ステップ |
|---|---|---|
| 2層構造アーキテクチャ | Routerが振り分け、Workerが実行 | 1 |
| イベント駆動型Trigger | チャット、GitHub、CIのイベントをエージェントへの入力に変換 | 2 |
| 全二重・マルチチャネル | 非同期ツール、チャネルに応じた応答 | 4 |
| コンピュート・状態・環境の分離 | ステートレスなループ、DBでの状態管理、既存マシンの維持 | 5 |
| Watchdog | 進捗とエラーを監視する独立セッション | 6 |
ステップ1:RouterとWorkerを分離する
Routerは単一の常駐型セッションです。人間とのすべてのやり取りとタスクの振り分けを担当し、自身でタスクを実行することは一切ありません。Bashツールを持たずに稼働でき、より軽量で安価なモデルで十分に対応できます。Routerの1ターンの間に複数のTriggerが届いた場合は、次回の呼び出しにバッチ処理としてまとめられます。つまり、長い入力に対して短い出力となり、プリフィル段階で集約されます。
各Workerは、タスクごとに用意される独立したセッションです。すべてのツールへのアクセス権を持ち、利用可能な中で最も高性能なモデルを使用します。人間に直接返答することはなく、結果はRouterに報告します。Worker自身がサブエージェントを利用することも、Worker自体をエージェントチーム全体として構成することも可能です。
これをエージェントチームと混同しないようにしてください。チームリーダーは密結合した1つのタスクを分解しますが、Routerは互いに独立したタスクを振り分けるだけです。もちろん、これらを組み合わせて階層化することも可能です。
# Illustrative sketch, not DeepSeek's code
class Router:
    def on_events(self, batch):              # triggers arriving mid-turn are batched
        plan = self.llm_light.decide(batch)  # dispatch, reply, or ignore
        for task in plan.new_tasks:
            Worker.spawn(task, model="strongest", tools="all", report_to=self)
        for msg in plan.replies:
            self.channels.send(msg)          # only the Router speaks to humans
ステップ2:イベントをTriggerに変換する
スーパーエージェントへのあらゆる入力はTriggerとなります。チャットメッセージ、GitHub Webhookイベント、Slack Events APIのペイロード、CIのコールバックなどがこれに該当します。その大半はモデルに渡す必要すらないため、論文では2段階のフィルタリングを行っています。
- コードによる高速パス(Fast path):送信元、グループ、ユーザーまたはボットの許可リストに基づいてフィルタリングします。送信元ごとに「明示的なリクエストにのみ応答」「候補」「無視」といったモードを割り当てます。
- LLMによる低速パス(Slow path):候補となったイベントはモデルに送られ、「このチャンネルで誰かがバグを報告した際に応答する」といったプロンプト形式のポリシーが適用されます。
イベントを受け取るインテークエンドポイントは、即座に受信応答を返し、処理は後回し(非同期)にするべきです。GitHubのWebhookベストプラクティスでは10秒以内に2XX系レスポンスを返すことが求められていますが、モデル呼び出しを含めるとこの制限時間を保証できません。まずは202 Acceptedを返してTriggerをキューに入れ、Routerに後から取得させましょう。このレイヤーのリトライ処理や冪等性については、信頼性の高いWebhookの設計ガイドで解説しています。
ステップ3:Thread単位で後続イベントをルーティングする
Threadとは、同一のPR、IMのトピック、またはメールスレッドで連続して発生する一連のイベントを指します。Threadの最初のイベントによって生成されたWorkerはそのThreadを購読します。以降の後続イベントはRouterを経由せず、直接そのWorkerへと転送されます。
このマッピングは多対多の関係になります。2つのWorkerが同じPRを操作している場合、両方のWorkerがそのイベントを受信し、Worker同士が直接メッセージをやり取りすることなくPR自体を通じて競合を解決できます。
このステップを省略すると大きな代償を払うことになります。論考の実験では、このパススルー機構を外すと、Routerの意思決定回数が約30%増加し、トークン消費量が約37%増加しました。
ステップ4:コンテキストをキャッシュとして扱い、ツールを非同期化する
Routerはすべての情報を保持できるわけではないため、論考ではコンテキストをキャッシュのように扱います。
- インライン化(Inline):必要になる可能性が高いもの(ID、短い要約、前後のメッセージなど)をコンテキストに含めます。
- 退避(Spill):それ以外の情報は切り捨て、エージェントが必要に応じて追跡できるポインタ(参照先)だけを残します。
Trigger、Thread、Workerに付与された永続的なIDは、著者らが「Chain of Recall(想起の連鎖)」と呼ぶ参照グラフを形成します。エージェントはTriggerから対応するThread、そしてそれを処理したWorkerへとたどることで、巨大なプロンプトを抱えることなくマルチホップのコンテキスト想起を実現できます。
次に全二重(フルデュプレックス)化を行います。ブロッキング処理となるrun()ツールを、非同期のstart()とstop()に置き換えます。start()は即座に「開始完了(Started)」を返し、実行結果は後から新しいイベントとして届きます。これにより、前の処理が実行中であってもエージェントは次の指示を受け付けられるようになります。論考によると、DeepSeek Harnessにはこの機能が実装されているものの、デフォルトでは有効化されていないとのことです。
最後に、返答をチャネルに応じた形式(channel-aware)にします。検証されたルールでは、IMでの返答は100語程度に制限される一方、GitHub、メール、ドキュメントなどでは構造化された詳細なレポートを出力するように設定されています。
さらに、これによって投機的実行(speculative execution)も可能になります。テストされたユーザーグループでは、「バックグラウンドで再現と修正を試み、確認が取れた単純な修正のみを提示し、それ以外は静かに控える」というポリシーが採用されています。
ステップ5:コンピュート、状態、環境を分離する
エージェントの処理ループはステートレスなクラウドコンテナ上で動かし、セッション状態はデータベースに保持します。開発環境は既存のマシン上にそのまま残し、各マシンで軽量デーモンを実行します(論考ではこれをBYOM: Bring Your Own Machineと呼んでいます)。ループ処理がクラッシュしても、どこでも再起動してDBから状態を再読み込みできる一方、リポジトリは各ローカルマシン上に保持されたままになります。
この論考では、Anthropicの「Scaling Managed Agents: Decoupling the brain from the hands」も同様の概念に基づいていると指摘されています。ただしAnthropicのアプローチは、ローカルマシンではなくマネージドサンドボックスを対象としています。
ステップ6:Watchdogを追加する
Watchdogは、メインシステムから切り離され、スケジュールに従って定期実行される独立したセッションです。APIエラーを処理し、各Workerが順調に進捗しているか、あるいは迷走(ドリフト)していないかをモデルに問い合わせて確認します。メンテナーはWatchdogに直接問い合わせて、何が原因で失敗したのかを確認することも可能です。Routerがスタックした際に監視機能まで共倒れしないよう、必ずRouterのプロセス外で稼働させてください。
実験結果から見えてきたこと
著者らは、約20件の作業リクエストを含む約300件のチャットおよびCIメッセージを用意し、タイマーを用いてコーディング作業をシミュレートした上で、各構成を5回ずつテストしました。なお、これらの結果は「あくまで参考値」と位置づけられています。
| 構成 | p50(分) | p95(分) | 1実行あたりのキャッシュ読み取りトークン数 |
|---|---|---|---|
| スーパーエージェント | 12.4 | 15.7 | 23.2M |
| Threadパススルーなし | 12.6 | 15.5 | 31.8M |
| 単一セッション + サブエージェントツール(中立プロンプト) | 20.4 | 29.5 | 6.1M |
| 単一セッション(委譲優先プロンプト) | 13.8 | 29.0 | 10.8M |
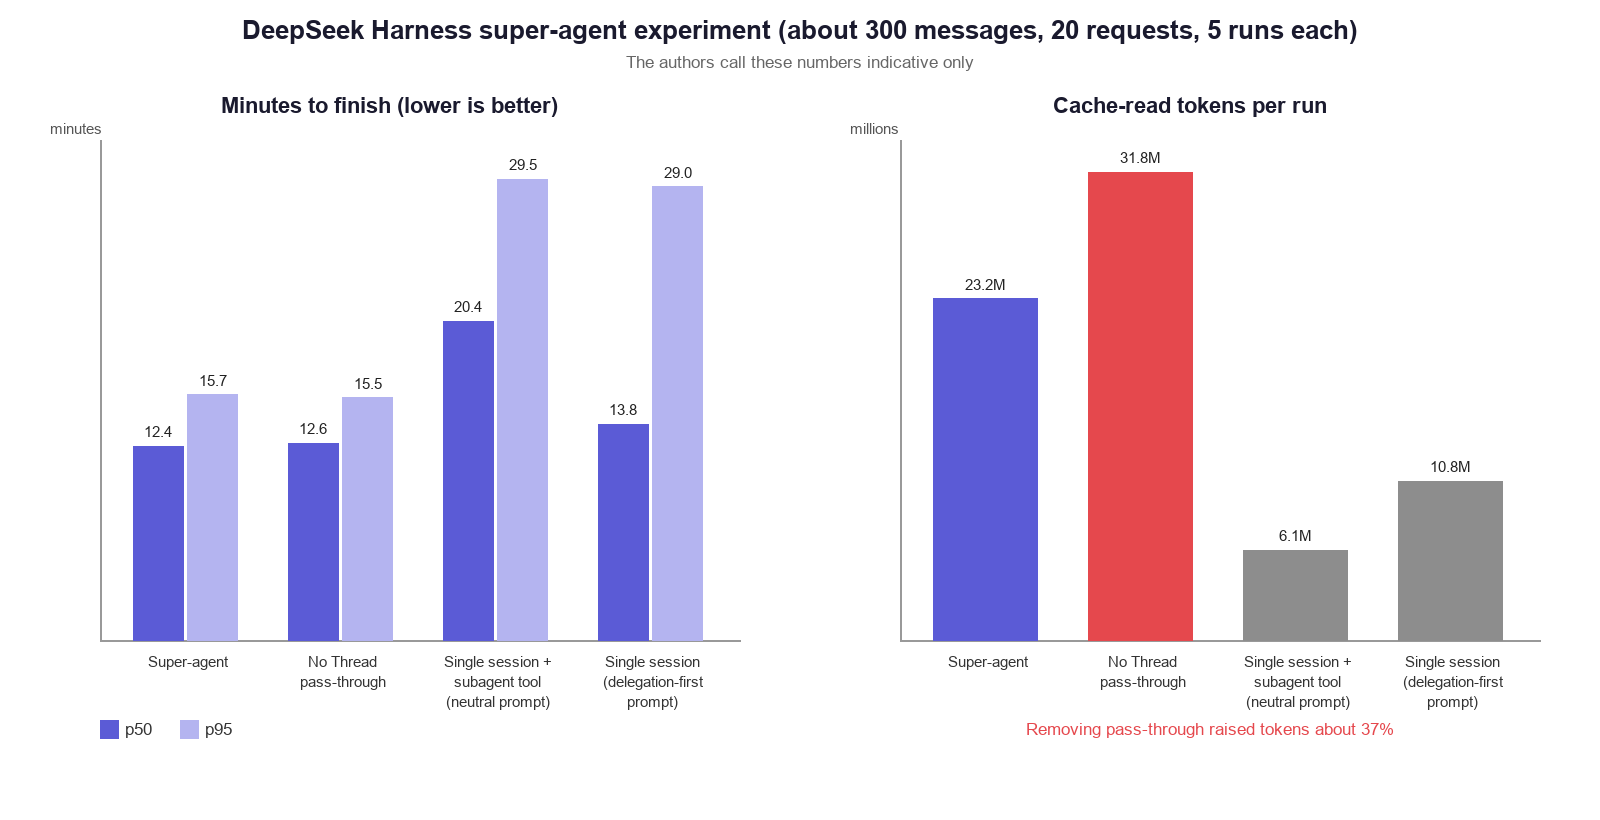
特筆すべき結果が2つあります。1つ目は、中立的なプロンプトを与えた場合、単一セッションは5回の実行で一度もタスクの委譲を行わず、p95の所要時間がスーパーエージェントのほぼ2倍に達したことです。委譲を優先するプロンプトを与えることで中央値(p50)は改善されたものの、テール(p95)の遅延は解消されませんでした。2つ目は、スーパーエージェントは単一セッションよりも多くのトークンを消費するため、トークンコストを支払うことでレイテンシの短縮と人間のアテンションの節約を得るトレードオフ関係にあるという点です。
もう1つのテストでは、Router単体に負荷をかけました。Triggerの頻度が毎分1件から40件に増加するにつれて、バッチサイズは1.0から2.8に拡大し、リクエストあたりの処理時間は2.5秒から3.9秒に微増した一方で、意思決定あたりの時間は6.4秒から1.6秒へと短縮されました。このように、バッチ処理があるおかげで、単一のRouterが早い段階でボトルネックになるのを防いでいます。
Apidog CLIでTriggerインテークをテストする
すべてのTriggerは、インテークエンドポイントに着信するHTTPリクエストから始まります。そのため、まず最初にテストすべきはこのエンドポイントです。もしエンドポイントがPRコメントを取りこぼしたり、イベントごとに新しいthread_idを割り当ててしまったりすると、Threadルーティングが破綻し、すべての後続イベントが再びRouterを経由することになってしまいます。Apidog CLIを使えば、コーディングエージェント自身にこのテストを作成・実行させることができます。
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
続いて、エージェントに次のようなプロンプトを1つ指示します。
In Apidog project <id>, create POST /triggers/github for a GitHub
pull_request_review_comment webhook. Add a test case that sends two
comments on the same PR and asserts: status 202, a trigger_id in the
body, and the same thread_id both times. Run it against staging and
summarize any failures.
エージェントは各ペイロードスキーマを読み取り、そのJSONを検証し、エンドポイントとテストケースを作成して実行します。
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <stagingEnvId> -r cli,json
同様のapidog run呼び出しに-r junitを指定すれば、パイプラインにそのまま組み込めます。詳細はCI/CDにおけるApidog CLIをご覧ください。使用するエージェントがDeepSeek Harness自体の場合はこちらのセットアップガイドを、Claude Codeの場合はこちらの手順を参照してください。なお、ApidogのFreeプランでは最大4ユーザーまで利用可能です。
残された課題
論考では、まだ解決されていない課題として以下が挙げられています。
- 負荷の増大に伴うRouterのスケーリングとWorkerトポロジーの選定。
- Chain of Recallを超えた長期記憶の実現。
- セッションレスなUX:単一のチャットウィンドウが存在しない環境でのエージェントの制御。
- コンテキスト境界とエージェント間プロトコル(A2Aなどが候補の1つ)。
- セキュリティ:クラウドループに侵入したプロンプトインジェクションが接続されたすべてのマシンに波及する恐れや、コンテキスト内の認証情報漏洩のリスク。著者らは、エージェントが認証情報を直接目にすることなく利用できる仕組みを求めています。
よくある質問(FAQ)
スーパーエージェントは有効化すればすぐに使えるDeepSeek Harnessの機能ですか? いいえ、違います。論考で説明されているのはアーキテクチャ設計です。一部の機能はdsh-superagent-prototypeプラグインに存在しますが、著者らはこれを公式のDeepSeek製品ではないと明言しています。全二重ツールも実装されていますが、デフォルトでは無効になっています。
なぜRouterには軽量なモデルを使用するのですか? Routerはタスクの振り分けと人間とのやり取りのみを担当し、タスクの実行やBashの操作を一切行わないためです。高度な推論を伴う処理は、最高性能のモデルを備えたWorkerが担当します。
スーパーエージェントとエージェントチームの違いは何ですか? チームリーダーは密結合した1つのタスクを複数のパートに分割しますが、Routerは互いに独立したタスクを振り分けます。また、スーパーエージェント内部の各Workerが独自のエージェントチームを動かすことも可能です。
スレッドパススルー(Thread pass-through)とは何ですか? PR、IMトピック、またはメールスレッドでの後続イベントは、そのThreadを担当するWorkerに直接転送され、Routerをスキッ... [truncated 795 chars]