
Groq はすべてのアカウントに、OpenAI 互換エンドポイント用の Free Plan キーを発行しており、そのキーはサインアップした瞬間から使えます。つまずきやすいのはアクセス権の取得ではなく、アプリが実際にモデルを呼び出し始めた後に制限内に収めておくことです。Groq はドキュメント上でモデルごとの Free Plan の数値を公開していますが、その数値は変動し、自分のアカウントでは異なる場合もあります。信頼できる習慣は、アカウント設定を確認し、毎回の呼び出しでレスポンスヘッダーを読むことです。制限はセッションの途中で変わる可能性があるからです。
このガイドでは、キーの取得、標準的な OpenAI クライアントを Groq のエンドポイントに向ける方法、そしてほとんどの「無料枠」記事が飛ばしてしまう部分、つまり本番環境で 429 に遭遇して初めて知るのではなく、リアルタイムで制限を監視する方法を扱います。さらに、コーディングエージェントがそのチェックを Apidog CLI テストに変えるので、忘れてしまう一度きりの curl コマンドではなく、繰り返し実行できるものになります。
TL;DR
Groq には Free Plan と Developer Plan の 2 つのティアがあります。レート制限は(ユーザー単位ではなく)組織レベルで適用され、リクエスト、トークン、日次合計のうち最初に達した上限に引っかかり、キャッシュされたトークンはカウントされません。Groq はモデルごとの Free Plan の数値を公開していますが、自分のアカウントに適用される数値はコンソールの制限ページにあります。そのため信頼できる方法は、予告なく変わりうる表を信じるのではなく、毎回の呼び出しで x-ratelimit-* レスポンスヘッダーから読み取ることです。
キーを取得してエンドポイントを呼び出す
console.groq.com でアカウントを作成し、キーページからキーを生成します。Groq はそのキーを OpenAI 互換 API 経由で公開しているので、これまでに OpenAI の SDK を呼び出したことがあれば、形はすでにご存じでしょう。ベース URL を OpenAI ではなく Groq に向け、それ以外はすべて同じにします:
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instant",
    "messages": [{"role": "user", "content": "Summarize this ticket in one sentence."}]
  }'
または公式の Python OpenAI クライアントを使う場合:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GROQ_API_KEY"],
    base_url="https://api.groq.com/openai/v1",
)

response = client.chat.completions.create(
    model="llama-3.3-70b-versatile",
    messages=[{"role": "user", "content": "List three causes of API timeout errors."}],
)

print(response.choices[0].message.content)
Groq のOpenAI 互換性ドキュメントには、既存のコードをコピーする前に知っておくべきいくつかのギャップが記載されています: logprobs、logit_bias、top_logprobs、messages[].name はすべて 400 エラーを返し、n を設定する場合は 1 でなければならず、temperature を 0 にすると真の貪欲法デコーディングではなく微小な正の浮動小数点数に変換されます。
Free Plan と Developer Plan
Groq 自身の表現は率直です:「より高い制限、Batch および Flex 処理などにアクセスするには Developer プランにアップグレードしてください。」Free Plan はすべての新しいキーが最初に属するプランであり、テストや小さなサイドプロジェクトには十分実用的です。
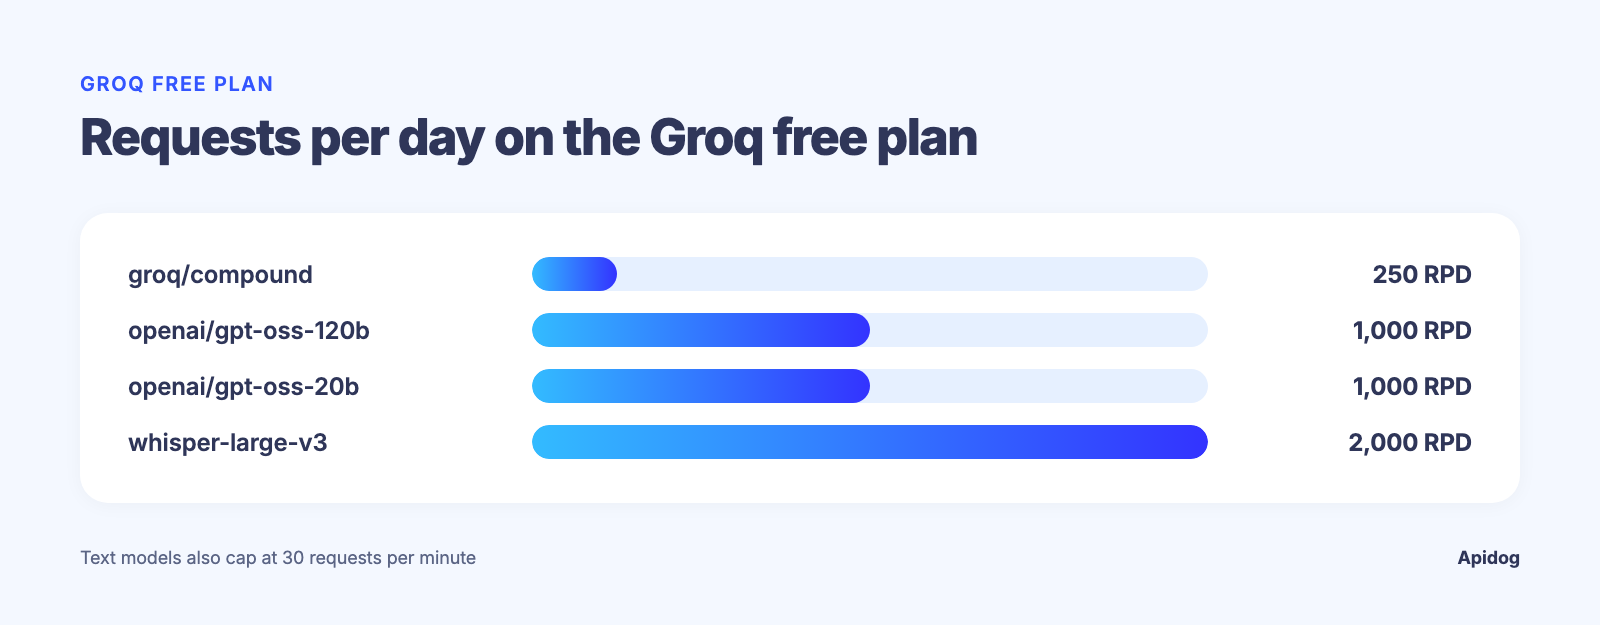
2026-09-15 時点で読んだ Groq のレート制限ドキュメントによると、Free Plan でいくつかのモデルに許可されている内容は次のとおりです:
| モデル | RPM | RPD | TPM | TPD | 音声 |
|---|---|---|---|---|---|
groq/compound |
30 | 250 | 70K | - | - |
openai/gpt-oss-120b |
30 | 1K | 8K | 200K | - |
openai/gpt-oss-20b |
30 | 1K | 8K | 200K | - |
whisper-large-v3 |
20 | 2K | - | - | 7.2K ASH / 28.8K ASD |
同じページには、すべてのモデルでより高い上限に加えて Batch および Flex 処理を備えた Developer Plan タブがあります。上の表はスナップショットとして扱ってください。Groq は予告なくこれらの数値を変更する可能性があります。自分の数値はアカウント設定の制限ページにあります。食い違う場合はこの記事よりもそのページを信頼してください。
生の数値よりも重要なポリシーの詳細が 2 つあります。レート制限は「個々のユーザーではなく組織レベルで」適用されるため、1 つの Groq 組織を共有する 5 人は 5 つの別々の制限ではなく 1 つの制限を共有します。そして「キャッシュされたトークンはレート制限にカウントされません」ということは、うまくキャッシュされたプロンプト構造は、見出しの数値が示す以上に実際のスループットを稼げるということです。
制限に達する前に知っておくべきモデル
重要になる制限は、どのモデルを呼び出すかによって異なります。Groq のテキストモデルと Compound システムは 131,072 トークンのコンテキストで動作します:
| モデル ID | 種類 |
|---|---|
llama-3.1-8b-instant |
高速な汎用テキスト |
llama-3.3-70b-versatile |
より大規模な汎用テキスト |
openai/gpt-oss-120b |
オープンウェイトの推論モデル |
openai/gpt-oss-20b |
より小規模なオープンウェイトの推論モデル |
groq/compound |
エージェント型システム |
groq/compound-mini |
より軽量なエージェント型システム |
Whisper モデルである whisper-large-v3 と whisper-large-v3-turbo はこの表には当てはまりません。これらは音声文字起こしモデルであり、Groq はそれらのスループットをトークンではなく、独自の RPM および RPD 上限と併せて 1 時間あたりおよび 1 日あたりの音声秒数(ASH/ASD)で測定します。
各モデルには独自の RPM、RPD、トークン上限があるため、llama-3.1-8b-instant の制限が openai/gpt-oss-120b に適用されると考えないでください。
推測するのではなくレート制限ヘッダーを読む
api.groq.com からのすべてのレスポンスには、コンソールにアクセスする必要なく、自分の状況を正確に示す一連のヘッダーが付いています:
x-ratelimit-limit-requestsとx-ratelimit-limit-tokens: 現在のウィンドウでの上限x-ratelimit-remaining-requestsとx-ratelimit-remaining-tokens: 今残っている量x-ratelimit-reset-requestsとx-ratelimit-reset-tokens: ウィンドウがリセットされるタイミングretry-after: 429 で送信され、どれだけ待つべきかを示す
毎回の呼び出し後に x-ratelimit-remaining-tokens を読めば、一度調べて忘れてしまった静的な数値ではなく、ライブのゲージが手に入ります。以下は cURL による簡単なチェックで、ヘッダーのみを出力します:
curl -sD - https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "llama-3.1-8b-instant", "messages": [{"role": "user", "content": "hi"}]}' \
  -o /dev/null | grep -i ratelimit
おしゃべりなテストスクリプトに対してこれをループで数回実行すると、x-ratelimit-remaining-tokens がカウントダウンしていくのがわかります。アプリにバックオフロジックが必要になった場合は、遅延を推測するのではなく retry-after ヘッダーを尊重するパターンについて、API レート制限の実装方法に関するガイドをご覧ください。
コーディングエージェントに Apidog CLI でチェックを実行させる
curl と grep のやりとりを手作業で行うのは、1 回のデバッグセッションなら問題ありません。しかしチームにはスケールせず、デプロイのたびに一度きりのシェルコマンドを再実行する人はいません。代わりにチェックをコーディングエージェントに任せましょう。Apidog CLI を使えば、テストを一度書けば、頼むたびに実行してくれます。まず一度セットアップします:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
トークンは Apidog のアカウント設定、API アクセストークンから取得します。次にエージェントに 1 つのプロンプトを与えます:
Use Apidog CLI on project <id>. Create a Groq environment with base URL
https://api.groq.com/openai/v1 and add POST /chat/completions with Bearer auth
from {{GROQ_API_KEY}}. Create one test case per model we run in production
(llama-3.1-8b-instant, openai/gpt-oss-120b) that asserts status 200 and fails
when x-ratelimit-remaining-tokens drops below 10% of x-ratelimit-limit-tokens.
Put both cases in a "Groq limits" test suite, run it, and report the headers.
実行されるコマンドは次のとおりです(Apidog CLI 2.2.7 で確認済み):
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog endpoint create --project <id> --file groq-chat.json
apidog cli-schema validate test-case-create --file groq-8b-case.json
apidog test-case create --project <id> --file groq-8b-case.json
apidog test-suite create --project <id> --name "Groq limits"
apidog run --test-suite <suiteId> --project <id> -e <envId> \
  --env-var "GROQ_API_KEY=$GROQ_API_KEY" -r cli,junit
予算の減少は、デモ中の突然の 429 ではなく、失敗したテストとして現れるようになります。この最後の行をデプロイ前の CI ジョブに入れてください。Apidog CLI CI/CD パイプラインのガイドで説明しているとおりです。あるいはエージェントに apidog scheduled-task create を依頼すれば、cron でランナー上でスイートを実行します。これは Groq の組織レベルのプールを考えるとさらに重要です。チームメイトの 1 人がバッチジョブを実行すると、1 時間後に本番エンドポイントが必要とする共有予算を食いつぶしてしまう可能性があります。これはGPT のレート制限について API をテストする記事の背後にある考え方と同じです。
実際に制限に達したときにどうするか
429 が返ってきたら、すぐにリトライするのではなく retry-after を尊重してください。リクエストレベルの制限に対してタイトなリトライループを回すと、残りの予算をより速く消費するだけで、リセットウィンドウをさらに先に押し出してしまいます。これをテストスクリプトではなく本番サービスに組み込む場合は、レート制限超過エラーの完全ガイドで、Groq だけでなく複数のプロバイダーで機能するバックオフ戦略を解説しています。
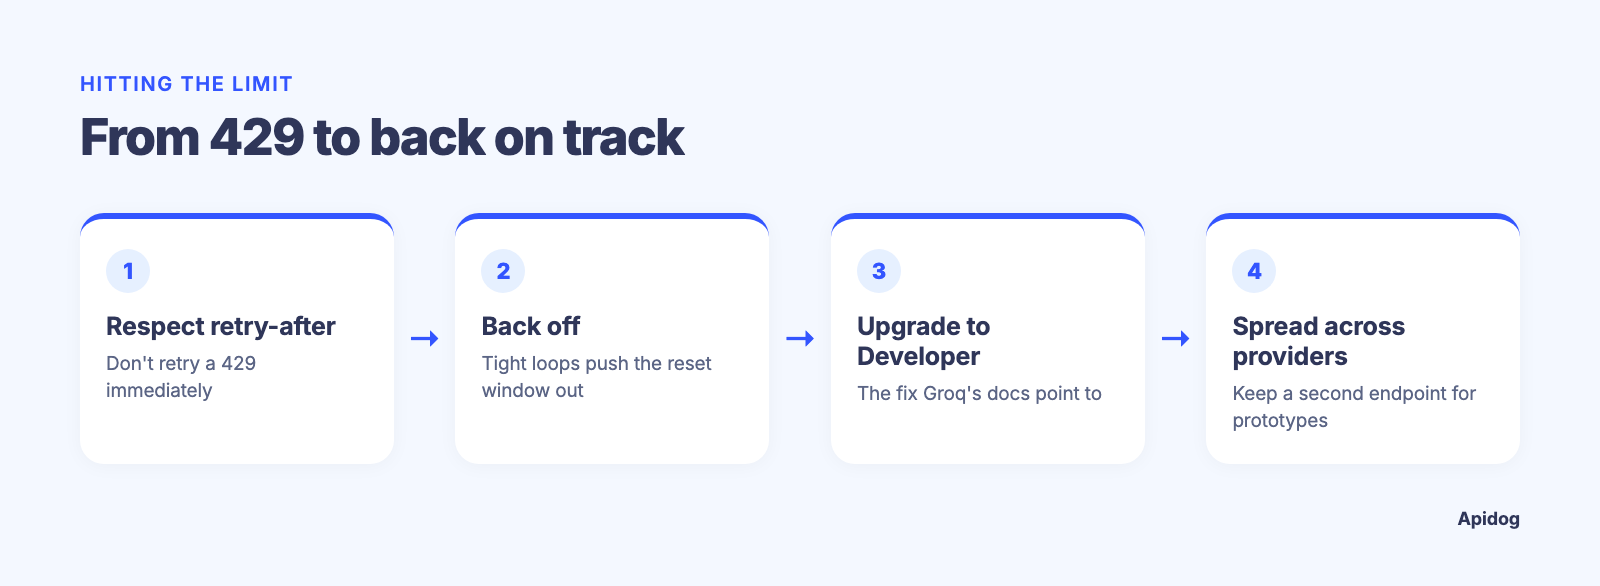
Free Plan で一貫して上限に達しているなら、最速の解決策は Groq がドキュメントで直接示している Developer Plan へのアップグレードです。2 番目に速い解決策、特にプロトタイプの場合は、トラフィックを複数のプロバイダーに分散させることです。OpenRouter の代替のまとめでは、まさにこの状況のために手元に置いておく価値のある他のエンドポイントを紹介しています。
FAQ
Groq の API には無料枠がありますか? はい。すべての新しいアカウントは Free Plan から始まり、OpenAI 互換エンドポイントにアクセスできます。Groq はいくつかのモデルについてFree Plan の制限例を公開していますが、自分のアカウントに実際に適用される上限はコンソール設定の制限ページにあります。
現在の Groq レート制限を確認するにはどうすればよいですか? 方法は 2 つあります。アカウント設定の制限ページを開くか、任意の API レスポンスの x-ratelimit-limit-requests および x-ratelimit-limit-tokens ヘッダーを読むかです。ヘッダーは呼び出した瞬間のアカウントの実際の制限を反映しており、一度見て覚えた数値よりも信頼できます。
Groq のレート制限を超えるとどうなりますか? retry-after ヘッダー付きの 429 レスポンスが返り、何秒待つべきかが示されます。遅延を推測するのではなくコードで処理する方法については、レート制限超過ガイドをご覧ください。
キャッシュされたトークンは Groq のレート制限にカウントされますか? いいえ。Groq はキャッシュされたトークンがレート制限にカウントされないと明言しているため、キャッシュされたシステムメッセージを再利用するプロンプト構造は、生のトークン制限が示す以上の実際のスループットを得られます。
Groq のレート制限はユーザー単位ですか、組織単位ですか? 組織単位です。同じ Groq 組織下のすべてのキーは 1 つのリクエストとトークンのプールを共有するため、チームメイトのスクリプトが本番アプリに必要な予算を食いつぶす可能性があります。
最も大きなコンテキストウィンドウを持つ Groq モデルはどれですか? llama-3.1-8b-instant、llama-3.3-70b-versatile、openai/gpt-oss-120b、openai/gpt-oss-20b、および Compound システムはすべて 131,072 トークンのコンテキストで動作します。Whisper モデルはテキストではなく音声文字起こしであるため、Groq はそれらの制限を音声の長さで測定します。同じコンテキストウィンドウ内でもレート制限はモデルごとに異なるため、それぞれ個別に確認してください。
まとめ
Groq API を無料で使う方法は秘密の数値ではなく、習慣です。キーを取得し、OpenAI 互換エンドポイントをそれに向け、この記事を含むブログ記事で見つけた数値を信じるのではなく、毎回の呼び出しでレスポンスヘッダーを読みましょう。
コーディングエージェントに Apidog CLI でそのチェックを一度構築させ、モデルごとの残りトークンに対するアサーションを入れれば、それ以降はデプロイのたびに実行されます。セットアップは Groq のドキュメントの残りを読むよりも短時間で済みます。負荷がかかった状態での AI API レイヤーのテストについてより深く知りたい場合は、AI エージェント向けの最高の API テストツールに関するガイドが次の一歩としておすすめです。