
Grok 4.6は8月12日にリリースされ、フロンティアモデルの選択を再形成する主張を掲げました。すなわち、Artificial Analysis IndexにおいてGPT-5.6 Solと同等のインテリジェンスを持ちながら、出力トークン100万あたり30ドルではなく6ドルという価格です。ほとんどの比較記事では未だにGrok 4.5をベンチマークしており、これはフロンティアモデルに大きく遅れをとっていたため、価格は問題ではありませんでした。しかし、状況は一変し、この比較では4.6の数値を用いて新たに評価を開始します。
簡単に言うと、リポジトリ規模のコーディングエージェントにはGPT-5.6 Solが依然として最強の選択肢であり、長期間にわたる自律作業ではClaude Fable 5がわずかに先行し、そしてGrok 4.6は、他の2つの価格を正当化できるほどの能力を持つ、今や最もコストパフォーマンスの高い選択肢です。適切な選択はあなたのワークロードに依存するため、以下に数値、APIの考慮事項、そしてあなたのスタックでこれら3つすべてをテストするための再現可能な方法を示します。今日そのテストを実行したい場合は、Apidogを使用すると、1つのワークスペースからこれら3つのAPIすべてを並行して無料で利用できます。
TL;DR
- インテリジェンス指標: Claude Fable 5が62で首位。Grok 4.6とGPT-5.6 Solは61で同点。
- 価格(出力、100万トークンあたり): Grok 4.6が6ドル、Claude Opus 4.8が25ドル、GPT-5.6 Solが30ドル。最大で5倍の差。
- コンテキスト: GPT-5.6 Sol 105万トークン、Claude Fable 5 100万トークン、Grok 4.6 50万トークン。
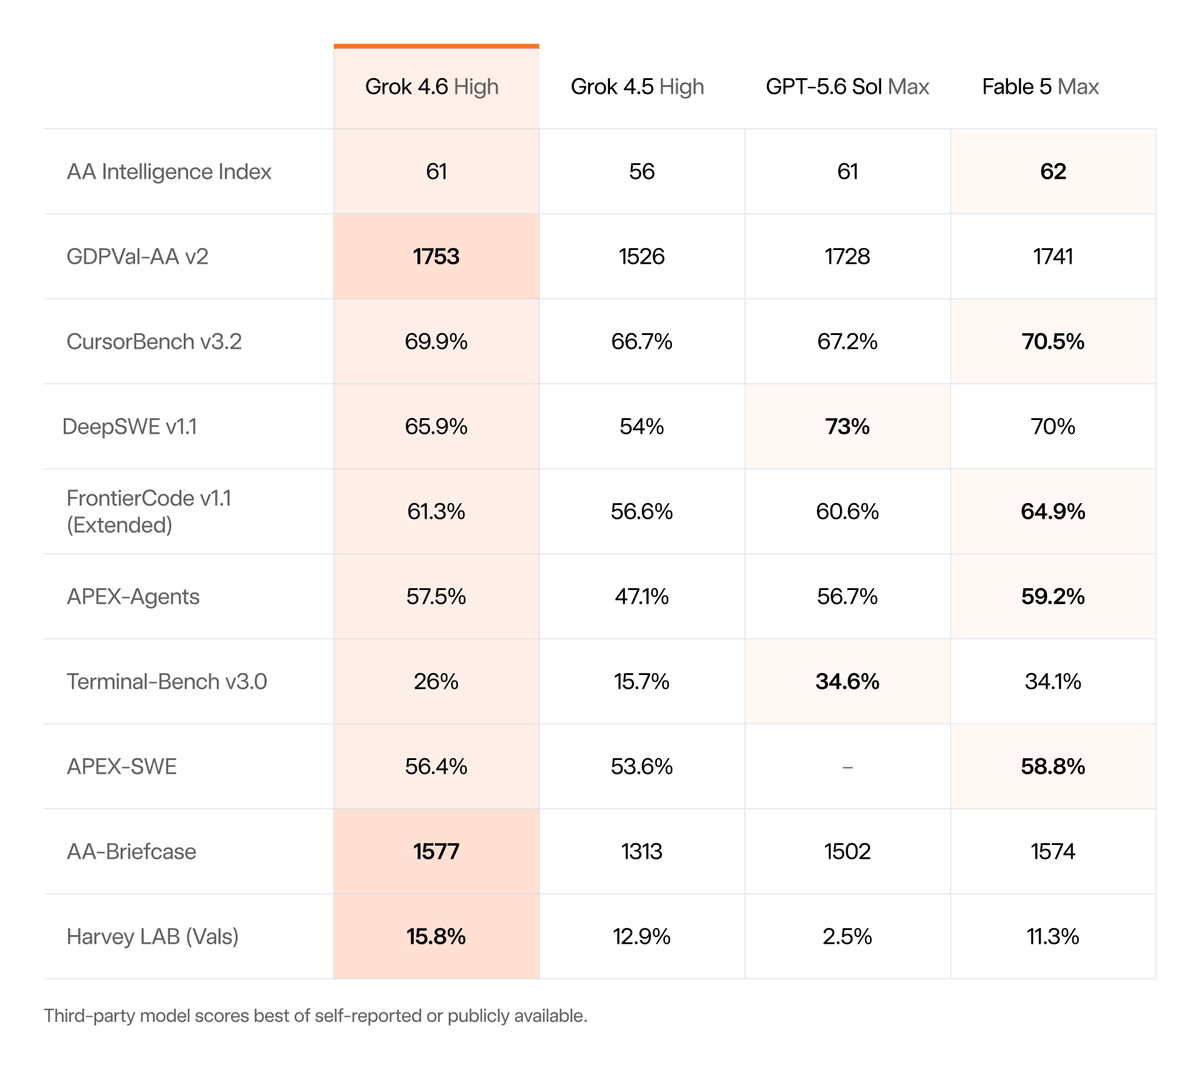
- コーディング: DeepSWEではSol Maxがリード(73.0%に対しGrokは65.9%)。FrontierCodeではFable 5 Maxがリード(63.6%に対し61.3%)。
- エージェント: APEX-AgentsではFable 5 Maxが59.2%でリード。Grok 4.6(57.5%)がSol Max(56.7%)をわずかに上回る。
- 完了タスクあたりのコスト: Artificial Analysisの測定によると、Grok 4.6は0.84ドルで、フロンティアモデルの中で最低。
- ベンチマークだけで決めないでください。自身のワークロードで20プロンプトの比較テストを実行してください(方法は以下)。
仕様と価格の比較
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| 開発元 | xAI | OpenAI | Anthropic |
| インテリジェンス指標 | 61 | 61 | 62 |
| コンテキストウィンドウ | 50万 | 105万 | 100万 |
| 入力価格 / 100万 | 2ドル | 12ドル | 10ドル |
| 出力価格 / 100万 | 6ドル | 30ドル | 25ドル* |
| 高速/プレミアムバリアント | 2倍の価格 | Sol Maxティア | Fable 5 Maxティア |
| APIスタイル | OpenAI互換 | OpenAIネイティブ | Anthropic Messages |
| 知識カットオフ | 2026年2月 |
*Claudeの価格はOpus 4.8のものであり、Fable 5ティアの価格は努力設定によって異なります。詳細なマトリックスについては、弊社のGPT-5.6価格ガイドおよびClaudeコスト削減の内訳をご覧ください。
価格の非対称性がここでの大きなポイントです。入力側ではGrokはOpenAIの6分の1の料金であり、出力側では5分の1です。チャットワークロードではこれは良いことですが、1つのタスクで数十回のモデル呼び出しや長いツール使用のトランスクリプトを生成するエージェントワークロードでは、これが積もり積もって、日あたり50ドルのエージェントと250ドルのエージェントの差になります。
コーディングベンチマーク: 深さならSol、価値ならGrok
リリース時の数値を見ると、各モデルが独自の領域を占めています。
| ベンチマーク | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (リポジトリ規模の修正) | 65.9% | 73.0% | |
| FrontierCode v1.1 拡張版 | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
このように読み解いてください:
- GPT-5.6 Sol MaxのDeepSWEにおける7ポイントのリードは本物であり、重要です。リポジトリ規模のバグ修正は、最も困難で経済的に価値のあるコーディングベンチマークです。エージェントが大規模な既存のコードベースで最小限の監視で作業する場合、Solは依然として最も安全な選択肢です。弊社のGPT-5.6 Sol vs Claude Fable 5比較でこの対決を深く掘り下げています。
- Claude Fable 5は一貫性において勝利しています。複合インデックス、FrontierCode、APEX-Agentsでリードしています。突出した点はありませんが、2位以下になることはほとんどありません。この特性は、1つの誤ったステップで1時間の進捗が台無しになるような、長期間にわたる自律作業に適しています。
- Grok 4.6は決して大きく遅れることはなく、時には先行することもあります。CursorBenchとTerminal-Benchでリードしつつ、他のベンチマークでもわずかなコストで追いつく位置にいることは、トラフィックの大部分をルーティングし、困難なケースだけをSolやFableにエスカレートするモデルの特性そのものです。
正直に言うと、これらはリリース週の数値であり、ほとんどがベンダーから報告されたものです。Grok 4.5のリリース時のベンチマークは注意深く読む必要がありました。ここに示すすべてのベンダーについても同様の注意が必要です。
トークンあたりのコストではなく、タスクあたりのコスト
モデルの冗長性やリトライ率が異なる場合、トークン価格は誤解を招きます。最終実行に失敗する安価なモデルは、節約したトークンよりも多くのレビューと修正作業を生み出します。より良い指標は完了タスクあたりのコストであり、ここでArtificial Analysisの独立した測定結果は驚くべきものです。Grok 4.6はエージェント評価全体でタスクあたり平均0.84ドルと、フロンティアモデルの中で最も低く、単に低価格であるだけでなく、比較的規律あるトークン使用量によって助けられています。
具体例を挙げます。あなたのコーディングエージェントが、完了したタスクごとに平均して50万の入力トークンと10万の出力トークンを使用するとします。
| モデル | 入力コスト | 出力コスト | タスクあたり |
|---|---|---|---|
| Grok 4.6 | 1.00ドル | 0.60ドル | 1.60ドル |
| Claude Opus 4.8 | 5.00ドル | 2.50ドル | 7.50ドル |
| GPT-5.6 Sol | 6.00ドル | 3.00ドル | 9.00ドル |
月に1,000タスクを実行する場合、Grokは、そのワークロードでの成功率が維持されれば、他の選択肢と比較して約6,000ドルから7,400ドルを節約できます。この条件がすべてであり、それがコミットする前にテストを行う理由です。
APIのエルゴノミクス: 統合が実際にあなたにどれだけのコストをかけるか
- Grok 4.6はOpenAI互換です。OpenAIスタイルのクライアントをお持ちであれば、
base_urlをhttps://api.x.ai/v1に指定するだけで実行できます。また、ゲートウェイユーザー向けにOpenRouter、Vercel、Cloudflareでも利用可能です。 - GPT-5.6 Solは最も深いエコシステムを持っています。Responses API、プログラムによるツール呼び出し、そしてあらゆる場所でファーストパーティのSDKが利用できます。ティア構造については、GPT-5.6 APIの使い方をご覧ください。
- Claude Fable 5はAnthropicのMessages APIを使用しており、異なるリクエスト形式、優れたツール利用の信頼性、そして1つのモデル内でコストと能力をトレードオフする努力パラメータを備えています。
移行の摩擦はGrokとOpenAI間(共有フォーマット)で最も低く、Anthropicへの移行またはAnthropicからの移行が最も高くなります。モデル間の切り替えやルーティングを想定している場合、その非対称性はアーキテクチャの決定に含めるべきです。
コンテキストウィンドウ: 50万トークンで十分な場合とは
理論上、GPT-5.6 Solの105万トークンウィンドウはGrok 4.6の50万トークンの2倍であり、Claude Fable 5の100万トークンがそれに続いています。実際には、あなたのワークロードがコンテキストに実際に何を保持するか、という点が問題となります。
50万トークンのウィンドウは、およそ35万語に相当します。これは、中規模サービスのコードベース全体、1年分のサポートトランスクリプト、または数百ページにわたる法律文書に匹敵します。ほとんどのエージェントタスクはこれに近づくことはありません。真に100万トークン層を必要とするワークロードは限られており、例えば、モノレポ全体の分析、要約を拒否する非常に長い複数セッションのエージェントトランスクリプト、そして大量のドキュメントセットの単発処理などが挙げられます。
ウィンドウサイズだけで選択することに反対する2つの実用的な注意点があります。第一に、コンテキストが満たされるにつれて、どのモデルも性能が低下します。3つすべてのモデルにおいて、80%の容量での検索品質は20%の場合よりも悪いため、ウィンドウを詰め込むアーキテクチャが選択的に検索するアーキテクチャに勝ることはほとんどありません。第二に、入力トークンは予算を圧迫する要因です。Solのフルウィンドウを満たすには、定価でリクエストあたり約12.60ドルかかりますが、Grokのウィンドウを満たすには1ドルしかかかりません。もしプロンプトが常に40万トークンを超えるのであれば、より大きなウィンドウが必要なだけでなく、どのベンダーを選択するにしても、キャッシングと検索の戦略が必要です。
知識カットオフとエコシステムの成熟度
Grok 4.6は2026年2月1日の知識カットオフ日で出荷され、3つの中で最も新しいため、急速に変化するフレームワークを参照するコーディングエージェントにとって重要です。これは実際には小さな利点ですが、本格的なエージェントスタックは、パラメトリック知識を信頼するのではなく、検索ツールとドキュメントツールで自身を構築します。
エコシステムは逆の話です。OpenAIは最も深いサードパーティ統合インターフェースを持ち、Anthropicはエージェントフレームワークに関する最も強力なマインドシェアを持っています。一方、xAIはOpenAI互換性に頼って両方を借りている新参者です。この賭けはほとんどの場合うまくいっています。チャット補完形式を話すものは何でも今日のGrokに対して実行可能であり、OpenRouter、Vercel、Cloudflareを介したゲートウェイの利用可能性は、インフラストラクチャに手を加えることなくGrokを採用できることを意味します。しかし、失われるのは、ファーストパーティの洗練度、バッチAPI、キャッシングティア、そして詳細な使用量制御が既存のベンダーよりも未成熟であることです。
どのジョブにどのモデルを
- 自律型リポジトリ規模のコーディングエージェントで品質重視なら: GPT-5.6 Sol。DeepSWEのリードは、大規模なコードベースでの脱線が少ないことを意味します。
- 長期間にわたる知識作業や複数時間のエージェントセッションなら: Claude Fable 5。最高の複合スコア、最高のエージェントベンチマーク、安定性の実績が最も強い。
- 高ボリュームのエージェントトラフィック、コスト重視の製品、またはルーターのデフォルトモデルなら: Grok 4.6。フロンティアクラスの出力をコモディティ価格で提供。最も難しいタスクの10%はSolまたはFableにエスカレート。
- IDEでの対話型コーディングなら: Grok 4.6のCursorBenchでのリードと2倍高速バリアントにより、有力な候補となります。これは、実際のCursorセッションでトレーニングされた後に、この目的のために効果的に構築されました。
午後にあなたのスタックで3つすべてをテストする
ベンチマークは平均を予測するものであり、あなたのワークロードを予測するものではありません。以下に、Apidogを使用した再現可能な比較テストを示します。
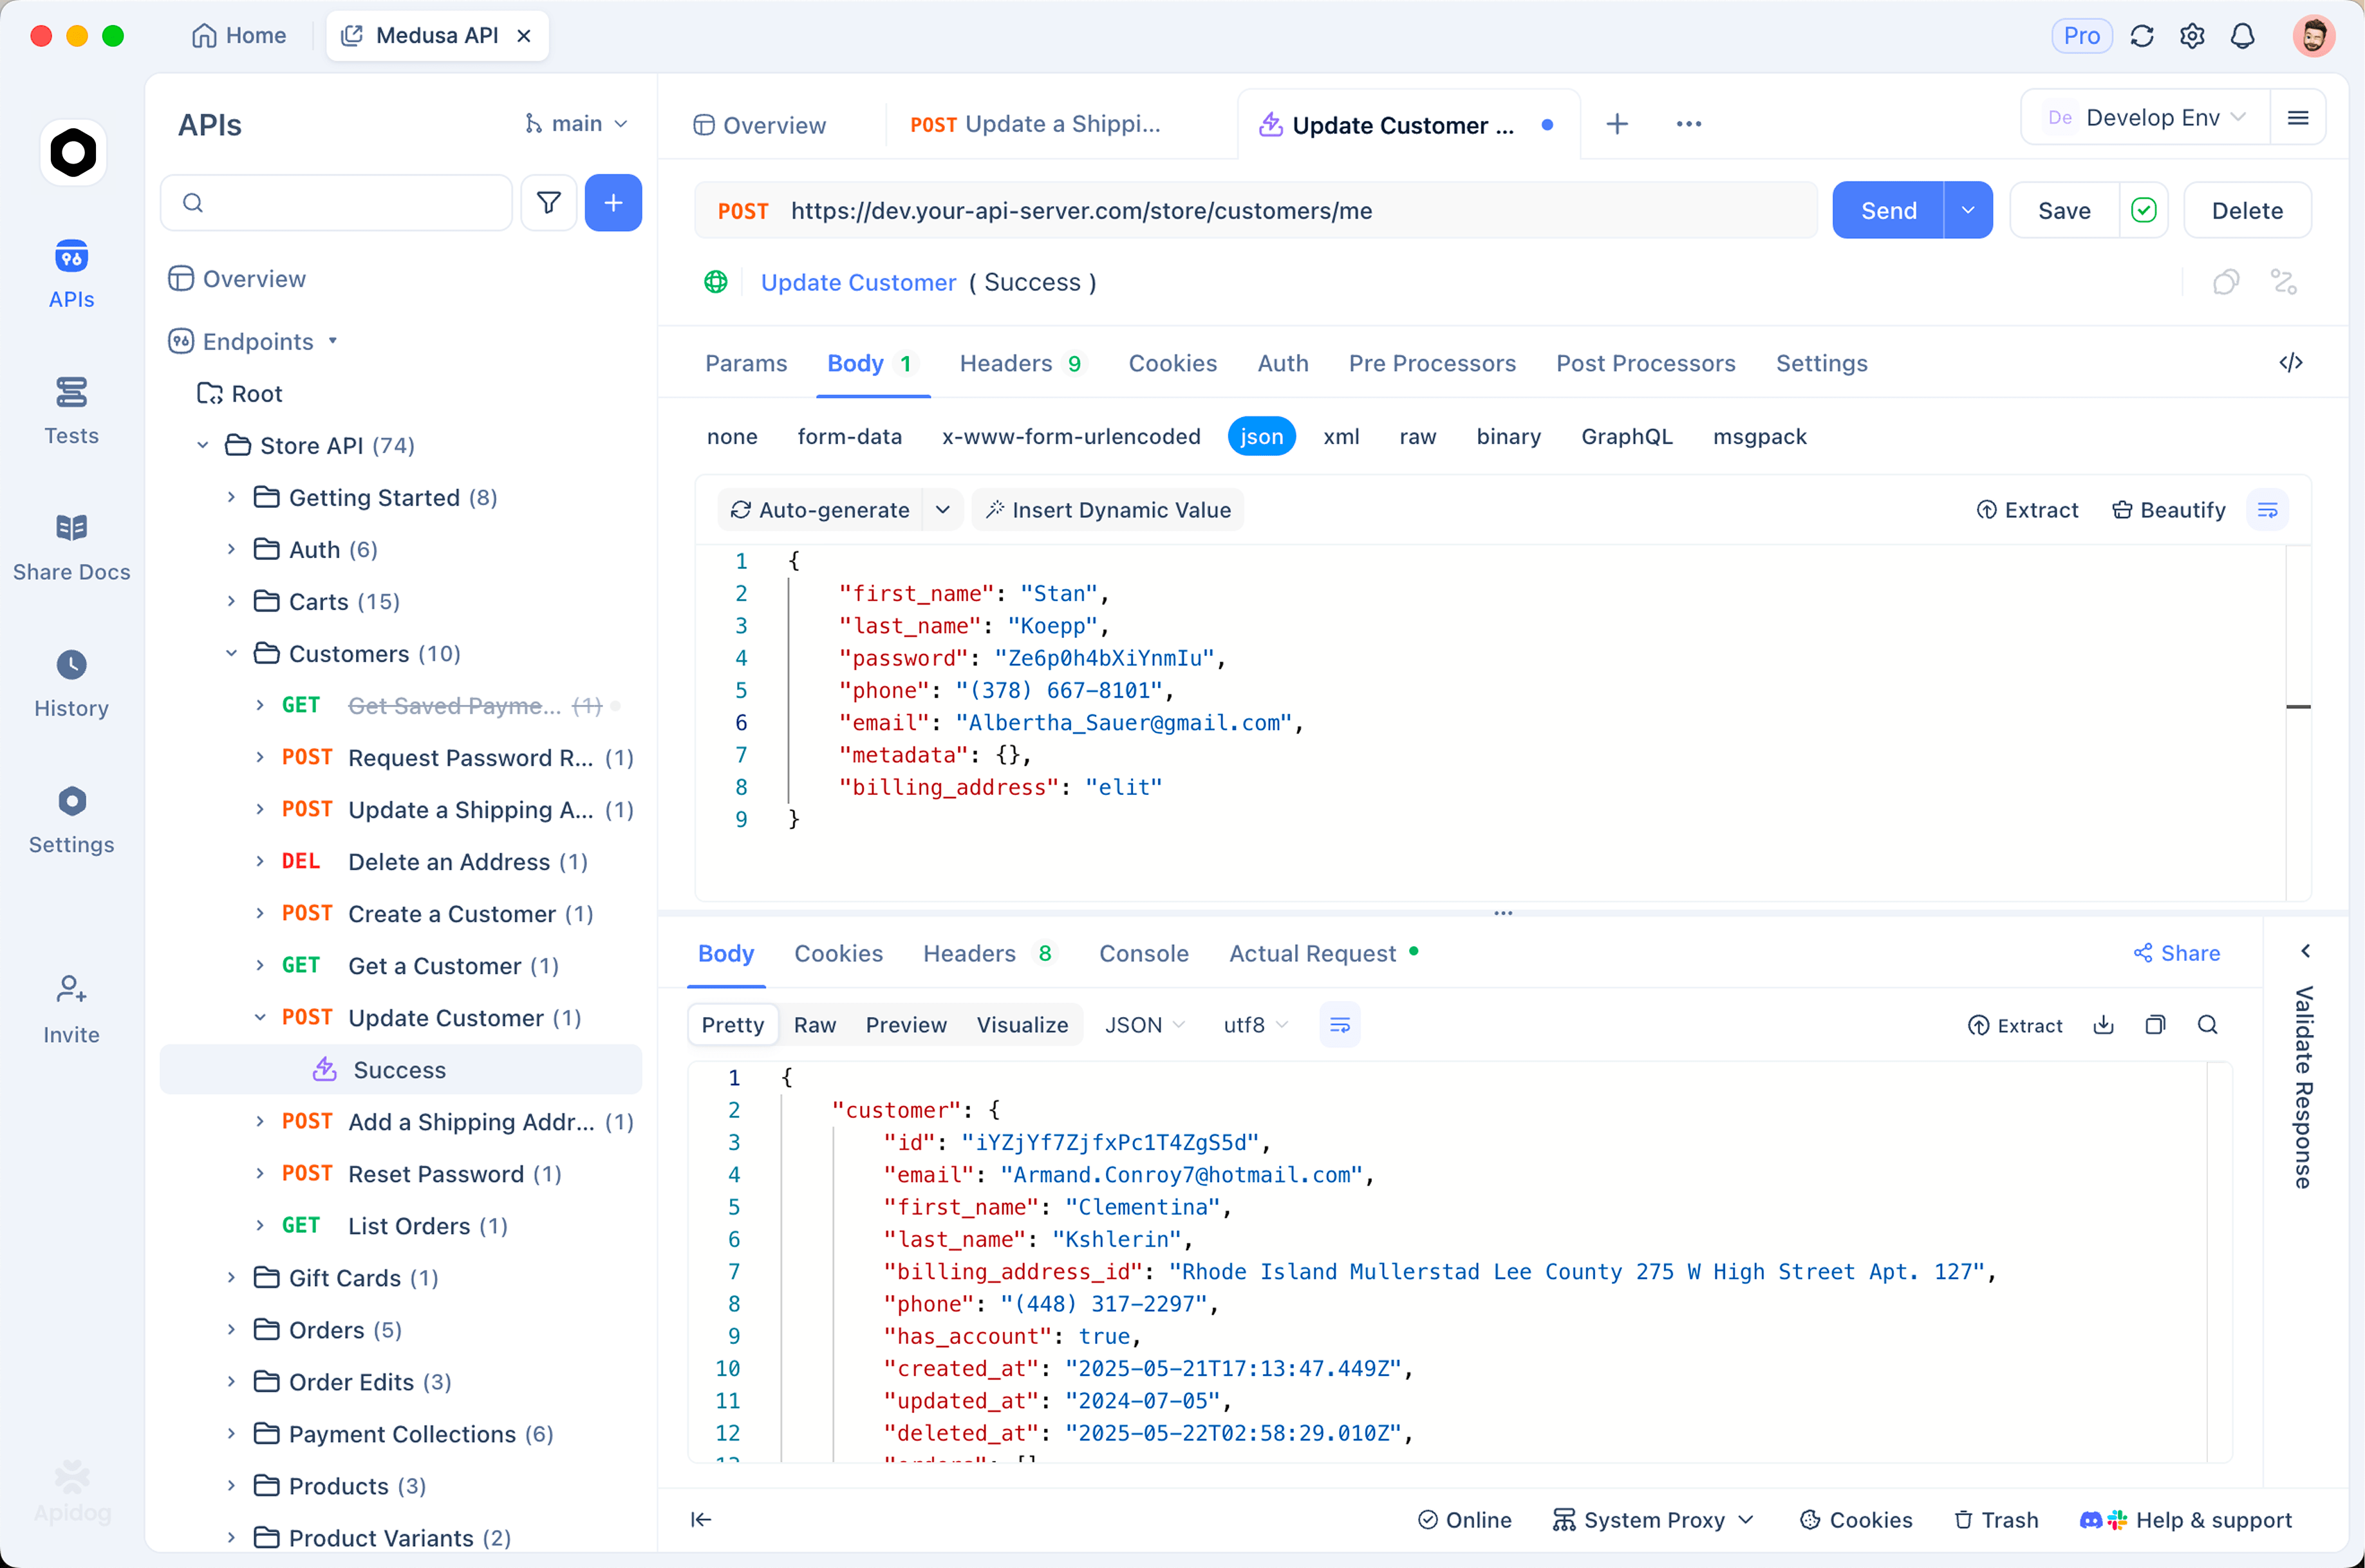
- 1つのプロジェクト、3つの環境。xAI(
api.x.ai/v1)、OpenAI、Anthropicそれぞれの環境を作成し、それぞれ独自の認証情報を持たせます。同じリクエストでドロップダウン1つでプロバイダーを切り替えられます。 - 20個の実際のプロンプトを収集します。おもちゃの質問ではなく、製品からの実際のタスクを抽出します。システムプロンプト、関数呼び出しを使用する場合はツール定義、そして少なくとも5つの既知の困難なケースを含めます。
- あなたが重視する点をアサートします。Apidogのアサーションを追加し、応答の有効性、
usageオブジェクトからのトークン使用量、およびレイテンシのしきい値を検証します。ツール呼び出しワークロードの場合、ツール呼び出しJSONが解析され、スキーマに一致することを確認します。モデルは、散文よりもここで失敗する可能性がはるかに高いです。 - テストシナリオとして、モデルごとに3回実行します。LLMの出力は異なります。3回実行することで、1回のデモでは隠れてしまうばらつきが明らかになります。結果をエクスポートし、トークンあたりのコストではなく、成功率と成功あたりのコストを比較します。
- スイートを保持します。次のモデルバージョンが出荷されたら(現在のペースでは数ヶ月以内)、再実行します。モデルの選択は今や四半期ごとの決定事項であり、常設の評価ハーネスを持つチームは、逸話で再決定するチームよりも数週間早く切り替えることができます。
よくある質問
- Grok 4.6はGPT-5.6 Solより優れていますか?複合インデックスでは61で同点です。Solはリポジトリ規模のコーディング(DeepSWE 73.0% vs 65.9%)で明確にリードしています。GrokはCursorBenchとTerminal-Benchでリードし、出力コストは5分の1です。「優れている」かは、あなたのワークロードがDeepSWEに似ているか、IDEセッションに似ているかによります。
- Grok 4.6はClaude Fable 5より優れていますか?Fable 5はインデックス(62 vs 61)、FrontierCode、APEX-Agentsで、すべてわずかな差でリードしています。Grokの利点は価格です。精度が重要な自律作業にはFable 5、コスト重視の大量処理にはGrokです。
- 2026年のフロンティアAIモデルで最も安価なのはどれですか?Grok 4.6です。100万トークンあたり2ドル/6ドルで、独立して測定されたエージェントタスクあたり0.84ドルです。最も近いフロンティア競合モデルの出力トークンは約4倍のコストがかかります。
- 本番環境のエージェントをGrok 4.6に切り替えるべきですか?ベンチマークだけでは判断できません。まず、上記の比較テストを実際のワークロードで実行してください。5倍の価格差は、あなたのタスクで成功率が維持される場合にのみ効果を発揮します。
- 3つのモデルすべてを1つのAPI形式で利用できますか?ほとんどの場合可能です。Grok 4.6はOpenAIのチャット補完形式をネイティブにサポートしているため、GPT-5.6とクライアントコードを共有できます。ClaudeはAnthropicのMessages APIを必要としますが、OpenRouterのようなゲートウェイを使用すれば、わずかなマークアップで3つすべてを1つのインターフェースに正規化できます。
- Grok 4.6のコンテキストウィンドウが小さいことは重要ですか?ほとんどのエージェントおよびチャットワークロードでは重要ではありません。50万トークンは一般的な使用量をはるかに超えており、どの3つのモデルも限界に近づくと性能が低下します。ただし、単一の呼び出しでモノレポ全体や大量のドキュメントセットを日常的に処理する場合は重要です。その場合、Solの105万トークンウィンドウが真の余裕をもたらします。