
GPT-Live-1.1とGPT-Realtimeの選択は、結局のところアーキテクチャで決まります。GPT-Live-1.1は全二重の音声フロントエンドで、推論とツールは別のバックエンドモデルに任せ、アクティブ1分あたり$0.05で課金されます。GPT-Realtime-2.1は単一の音声対音声モデルで、聞く、推論する、ツールを呼び出す、話すをすべて行い、トークン単位で課金されます。すでにテキストエージェントがあるならGPT-Live-1.1、1つのモデルにすべてを任せたいならRealtimeを選んでください。
OpenAIは2026年11月20日にGPT-Live-1.1をAPIに公開したため、エンドポイント、課金、ツールモデルが異なる2つの音声スタックが存在しています。7月のGPT-Live vs GPT-Realtimeの記事ではChatGPTの機能とAPIを比較しましたが、今回はAPI対APIの比較です。
ひと目でわかるGPT-Live-1.1 vs GPT-Realtime
2026年11月20日時点のGPT-Live-1.1モデルページ、gpt-realtime-2.1モデルページ、OpenAI料金ページから、両スタックの比較をまとめました:
| GPT-Live-1.1 | gpt-realtime-2.1 | |
|---|---|---|
| エンドポイント | v1/live/sessions |
v1/realtime |
| 設計 | 全二重音声+委任バックエンド | 単一の音声対音声推論モデル |
| 入力 | 音声、テキスト | 音声、テキスト、画像 |
| 出力 | 音声、テキスト | 音声、テキスト |
| 課金 | アクティブ$0.05/分、スタンバイ$0.02/分 | 100万音声トークンあたり入力$32、出力$64 |
| 推論とツール | バックエンドモデル、別途課金 | 同一モデル・同一料金に含まれる |
| 関数呼び出し | 委任経由 | session.tools |
| トランスポート | WebRTC、WebSocket、SIP(着信・発信) | WebRTC、WebSocket、SIP(着信) |
| レート制限 | 同時セッション数 | 1分あたりのリクエスト数とトークン数 |
OpenAIの音声エージェントガイドでは、アーキテクチャ表でこの分岐をまとめています。GPT-Liveは「別のバックエンドを持つ全二重会話」向けです。Realtime APIは「1つのセッションで音声、推論、ツール使用を完結させる」ためのものです。
アーキテクチャ:委任方式 vs 単一モデル方式
GPT-Live-1.1は「話す」と「考える」を分離します。音声モデルがリアルタイムで会話を処理し、話しながら聞くこともできます。推論、検索、ツールが必要なリクエストが来ると、バックエンドモデルに作業を委任し、その処理が実行されている間も会話を継続します。
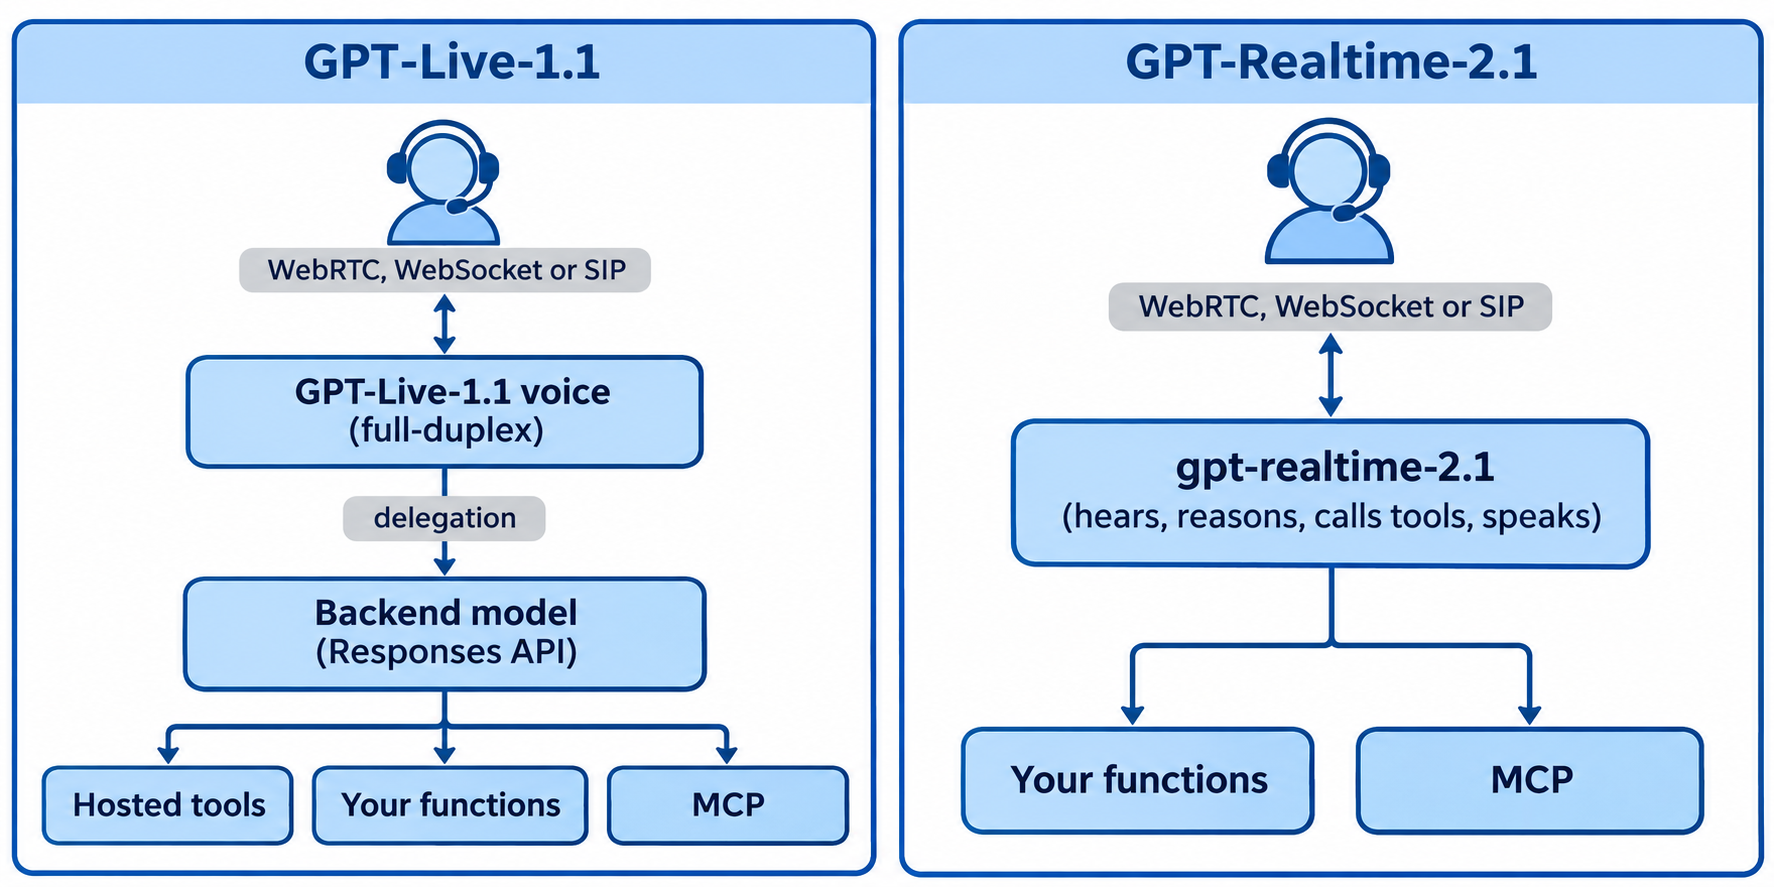
ライブ会話ガイドによると、委任はセッション作成時に一度だけ設定します。モードは2つあります:
responses:OpenAIがResponses APIを通じてバックエンドを実行します。delegation.responses.modelでモデルを選択し、instructions、tools、tool_choice、reasoning、service_tierを追加します。ドキュメントではgpt-6-lunaから始め、難しいタスクにはgpt-6-solに移行することを推奨しています。client:アプリ側がバックエンドを実行します。GPT-Liveがsession.delegation.createdイベントを送信し、session.instructions.appendなどのイベントで結果を返します。
モードはセッション途中で変更できません。切り替えるには新しいセッションが必要です。モード内のバックエンド設定はsession.updateで変更できます。
gpt-realtime-2.1は逆のアプローチを取ります。1つの推論モデルが音声を解釈し、ツールを呼び出し、音声で回答します。2つ目のモデルも、ハンドオフもなく、すべてのコンテキストが1か所に集約されます。
GPT-Live-1.1では、音声レイヤーに触れることなくバックエンドを差し替えたり、既存のテキストエージェントをそのまま使ったりできます。Realtimeでは、音声モデルそのものがエージェントです。
料金体系:分単位 vs トークン単位
GPT-Live-1.1は時間単位で課金され、Realtimeはトークン単位で課金されます。そのため、発信者が沈黙したり、長々と話したり、電話を保留したりすると、コストの挙動が大きく異なります。
| コスト項目 | GPT-Live-1.1 | gpt-realtime-2.1 | gpt-realtime-2.1-mini |
|---|---|---|---|
| 音声 | アクティブ$0.05/分、スタンバイ$0.02/分 | 100万トークンあたり入力$32、出力$64 | 100万トークンあたり入力$10、出力$20 |
| テキスト | セッション時間で課金 | 100万トークンあたり入力$4、出力$24 | 100万トークンあたり入力$0.60、出力$2.40 |
| キャッシュ入力 | 該当なし | 100万トークンあたり$0.40 | 100万トークンあたり音声$0.30、テキスト$0.06 |
| 推論とツール | バックエンドモデルの料金で別途課金 | トークン料金に含まれる | トークン料金に含まれる |
GPT-Liveは秒単位で課金されるため、90秒の通話は音声時間で$0.075であり、$0.10ではありません。WebRTCセッションは初期化中に15秒分が課金されますが、実行が開始されるとクレジットされます。
スタンバイはRealtimeにはないコスト削減の仕組みです。WebRTCでは、wake_policy.typeを"speech"に、idle_timeout_sを5から60の整数に設定します。指定した秒数無音が続くと、誰かが話し始めるまでセッションの料金は1分あたり$0.02に下がります。スタンバイはWebRTCのみでドキュメント化されているため、WebSocketとSIPセッションは接続されているすべての秒でアクティブ料金が課金されます。
自分のトラフィックで両者を比較するには、推測ではなく損益分岐点の数値を使いましょう。$0.05で、gpt-realtime-2.1では音声入力約1,560トークンまたは音声出力約780トークン、2.1-miniでは入力約5,000トークンまたは出力約2,500トークンに相当します。Realtimeの使用状況イベントから1分あたりの音声トークン数を取得してください。平均アクティブ1分間の使用量がそれを上回るなら、GPT-Liveの音声時間の方が安くなります。そこにバックエンドモデルのトークン料金を加えて全体像を確認しましょう。
Realtimeは推論をトークン料金に含めています。GPT-Liveは委任タスクごとにバックエンド料金が加算されますが、スタンバイによって沈黙時間のコストを削減できます。トークン側の詳細については、gpt-realtime-2.1-miniガイドをご覧ください。
関数呼び出しとツール
どちらのスタックもユーザーの関数を呼び出しますが、その場所が異なります。
Realtimeでは、ツールはセッション上に存在します。Realtimeツールガイドでは、session.toolsに"type": "function"ツールを設定し、session.updateで送信する例が示されています。クライアントが関数を実行し、function_call_outputアイテムを返します。リモートMCPサーバーも利用できます。"type": "mcp"、server_label、server_urlを指定したツールを追加すると、Realtime APIがサーバーを呼び出してくれます。response.toolsでツールを1ターンに限定することもできます。
GPT-Live-1.1では、ツールはバックエンド上に存在します。関数ツール、MCPサーバー、Web検索・ファイル検索・Code Interpreterなどのホスト型ツールをdelegation.responses.toolsに設定します。バックエンドのイベントはresponse.eventエンベロープで包まれて届き、関数の結果はfunction_call_outputアイテムに続いてresponse.createで返します。
メリット:遅いツールがバックエンドで実行されている間も、音声は応答性を保てます。デメリット:2つのモデル、2つのイベントストリーム、2つの請求書が必要になります。
ターンテイキング、割り込み、トランスポート
発信者が最も違いを感じるのはここです。
ターンテイキング。GPT-Live-1.1は全二重です。出力を生成しながら入力音声を処理するため、聞く、相槌を打つ、文の途中で調整することができます。Realtimeは音声アクティビティ検出によるターン単位で動作します。Realtime VADガイドによると、session.audio.input.turn_detection.typeには2つのモードがあります:
server_vad:デフォルトで、threshold、prefix_padding_ms、silence_duration_msで調整します。semantic_vad:eagerness(low、medium、high、またはmediumと同じauto)で調整します。
Realtimeはinterrupt_responseで割り込みに対応します。GPT-Liveは話しながらすでに聞いているため、この設定は不要です。
トランスポート。どちらもブラウザでのWebRTCとサーバーでのWebSocketをサポートしています。電話発信は異なります。SIPガイドによると、GPT-Liveは着信・発信の両方のSIPをサポートしており、発信は「Realtime APIの通話作成エンドポイントではなく、Live APIを通じてすべての組織で利用可能」です。接続されたGPT-LiveのSIP通話は2時間に制限されます。RealtimeのSIPガイドは、realtime.call.incoming Webhookによる着信をカバーしています。
制限とコンテキスト
| 制限 | GPT-Live-1.1 | gpt-realtime-2.1 |
|---|---|---|
| コンテキスト | セッションあたり128,000トークン、自動管理 | 128,000トークン |
| 最大出力トークン | 非公開 | 32,000 |
| インストラクション | 最大16,384トークン | 非公開 |
| レート制限 | モデルごとの同時セッション数 | Buildティアで400 RPM、200,000 TPM |
GPT-Liveはトークン数ではなく同時実行数でカウントします。GPT-Live-1ページによると、Buildで50同時セッション、Launchで300、Growで500で、Freeティアでは利用できません。GPT-Live-1.1には独自の制限があり、そのページではまだ数値が公開されていないため、ローンチ前に組織の制限ページを確認してください。
Realtimeの制限はLaunchで最大10,000 RPM、Growで20,000 RPMまでスケールします。
どちらのOpenAI音声APIを使うべきか?
音声がすでに信頼しているエージェントの上に載るレイヤーであるならGPT-Live-1.1、音声モデル自体がエージェントであるべきならRealtimeを使ってください。
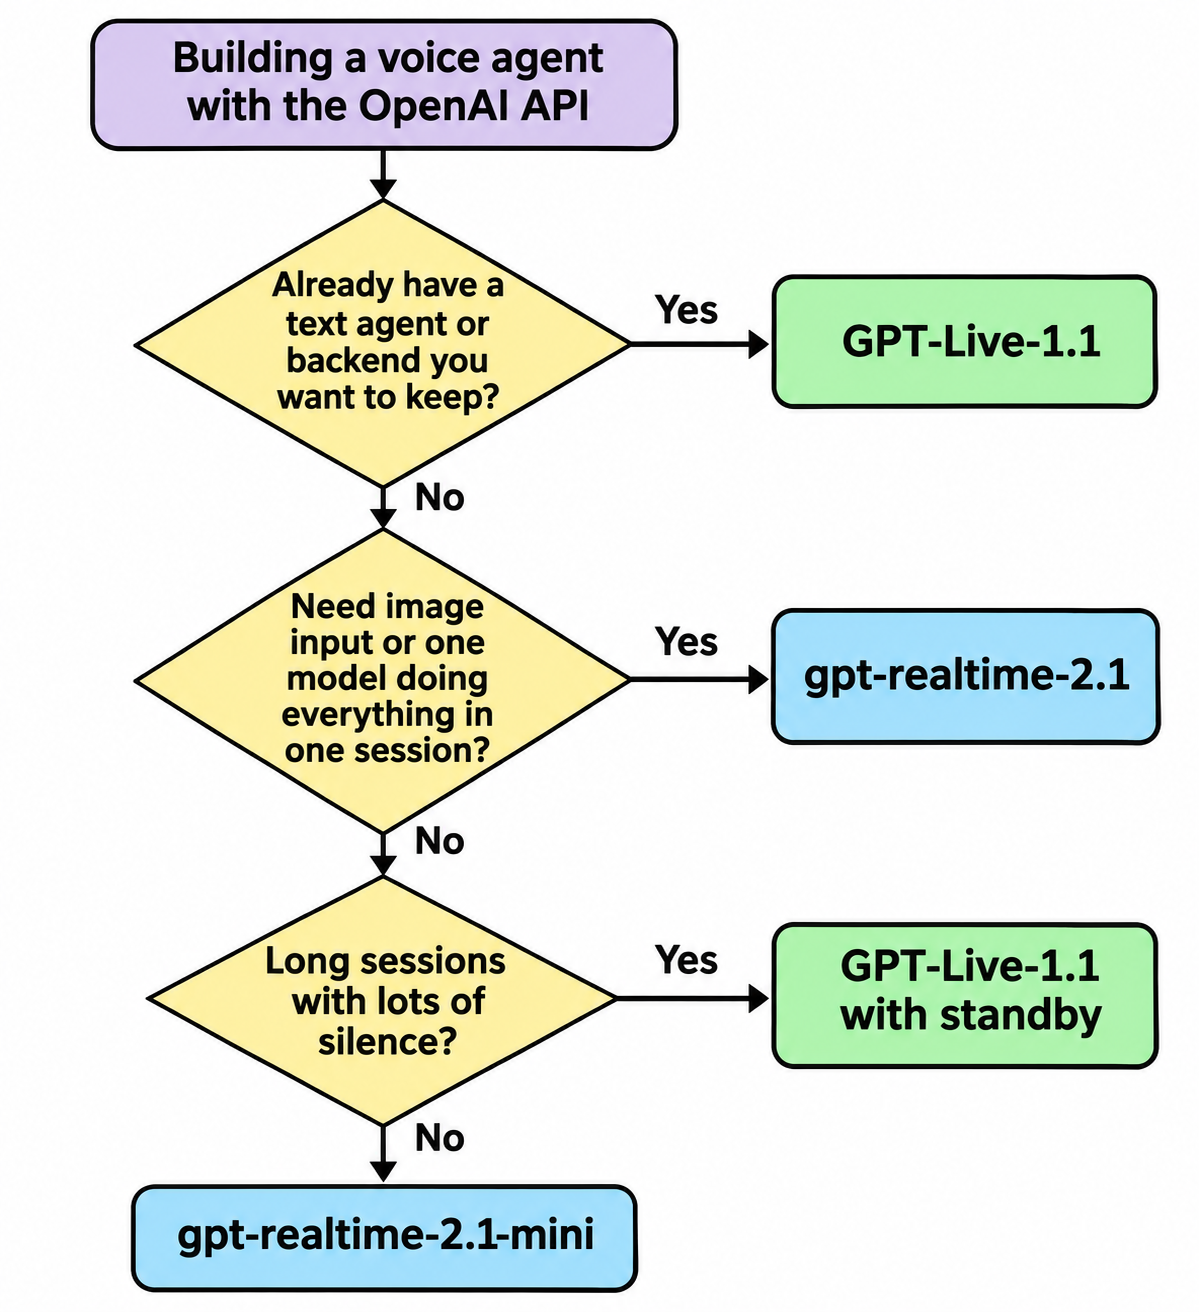
GPT-Live-1.1を選ぶケース:
- 既存のテキストエージェント、サポートボット、ワークフローを再構築せずに音声を追加したい。
- チュータリング、コーチング、コンパニオンなど、沈黙の多い長時間セッションでスタンバイが効果を発揮する。
- アウトバウンド電話発信。Live APIでのみ提供されています。
- 自然な相槌や発話の重なりが必要な会話。
gpt-realtime-2.1を選ぶケース:
- 1つのモデルが推論と実行の両方を担うべき、自己完結型の音声エージェント。
- 音声と一緒に画像を送信するアプリ。
- 1つのイベントストリームと1つの請求書で済ませたいチーム。
gpt-realtime-2.1-miniを選ぶケース:短時間で大量、低コストの音声タスクで、トークン単位の料金が分単位の料金より有利な場合。Realtimeのセットアップについては、GPT-Realtime-2 APIガイドで詳しく説明しています。
コーディングエージェントにApidog CLIでツールAPIをテストさせる
どちらのスタックが勝っても、両方が呼び出すのは同じものです:あなたのツールAPIです。遅い検索はどちらでも無音の空白時間になるため、発信者が耳にする前にレイテンシとコントラクトをテストしましょう。Apidog CLIを使って、Claude Code、Codex、Cursorにテストさせることができます。
セットアップは一度だけ:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
あとはエージェントに1つのプロンプトを与えるだけ:
Import ./voice-tools-openapi.yaml into Apidog project <projectId>. Build a test scenario
that calls GET /orders/{order_id} and GET /customers/{id} in sequence, asserts 200 and
the fields my voice agent reads aloud, and fails any request slower than 800 ms.
Run it 20 times against staging and tell me which step is slowest.
エージェントがスペックをインポートし、ペイロードの形状を確認し、シナリオを構築して実行します:
apidog import --project <projectId> --format openapi --file ./voice-tools-openapi.yaml
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointIds> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <envId> -n 20 --timeout-request 800 -r cli,json
-n 20は実行を繰り返すことで、たまたまうまくいった1回のレスポンスが遅いテールを隠すのを防ぎ、--timeout-request 800は発信者を待たせるほど遅い呼び出しを失敗させます。CIでは-r cli,jsonを-r junitに置き換えることで、リグレッションがデプロイをブロックできます。Apidog CLI CI/CDガイドでその方法を紹介しています。エージェントワークフローが初めての方は、Claude CodeでのApidog CLIから始めてください。ApidogのFreeプランは最大4ユーザーまで利用できます。
FAQ
GPT-Live-1.1とGPT-Realtimeはどちらが安いですか?1分あたりの音声トークン数とバックエンド次第です。GPT-Liveの音声はアクティブ1分あたり$0.05に加えてバックエンドモデルのトークン料金がかかります。gpt-realtime-2.1では、$0.05で音声入力約1,560トークンまたは音声出力約780トークンに相当します。自分の使用ログと比較してください。
GPT-Live-1.1で関数呼び出しは使えますか?はい、委任を通じて使えます。関数ツールをdelegation.responses.toolsに入れるか、クライアント委任モードでバックエンドを自分で実行します。音声モデルがRealtimeのsession.toolsのように直接ツールリストを受け取ることはありません。
GPT-Realtimeはスタンバイ課金をサポートしていますか?いいえ。1分あたり$0.02のスタンバイはGPT-Liveの機能で、wake_policyとidle_timeout_sを設定したWebRTCセッションのみが対象です。Realtimeは各セッションが使用したトークンに対して課金されます。
GPT-Live-1.1でアウトバウンド電話発信はできますか?はい。POST /v1/live/sessionsでtransport.type: "sip"とSIPトランクの詳細を指定してセッションを作成します。OpenAIのドキュメントによると、アウトバウンドSIPはRealtime APIの通話作成エンドポイントではなく、Live APIを通じて実行されます。
GPT-Live-1.1は画像入力を受け付けますか?いいえ。モデルページには音声とテキストの入出力のみが記載されています。音声エージェントで画像を見る必要がある場合は、gpt-realtime-2.1が100万トークンあたり$5で画像入力を受け付けます。