
GPT-Live-1.1の料金はトークン単位ではなく、時間単位で課金されます。OpenAIは音声セッションに対して、アクティブな時間が1分あたり0.05ドル、スタンバイ時間が1分あたり0.02ドルで課金し、秒単位で計算されるため、端数が切り上げられることはありません。バックエンドのモデル呼び出しやツール呼び出しは、通常の料金で別途課金されます。途切れなく1時間会話し続けた場合の音声料金は3.00ドル、1時間スタンバイ状態で待機していた場合の料金は1.20ドルです。
料金表そのものはシンプルです。重要なのは、実際のアプリでの挙動です。発話者が一時停止したり、バックエンドの処理に時間がかかったり、セッションが必要以上に開いたままになったりします。以下では、実際の料金計算例を3つ挙げ、請求額を予測可能に保つための設定を紹介します。
GPT-Live-1.1の料金 早見表
GPT-Live-1.1には2つの音声料金があり、バックエンドは別途課金されます。2026年11月20日時点で、GPT-Live-1.1モデルのページとOpenAIの料金ページには以下のように記載されています:
| 課金項目 | 料金 | 1時間あたり | 備考 |
|---|---|---|---|
| アクティブセッション時間 | 1分あたり$0.05 | $3.00 | 音声、アイドルタイムアウト前の無音、バックエンド処理の待機時間 |
| スタンバイセッション時間 | 1分あたり$0.02 | $1.20 | WebRTCのみ、推論が一時停止している間 |
| バックエンドResponsesモデル | 通常のトークン料金 | 変動 | 委譲先として選択したモデルによる |
| ホステッドツール | 通常のツール料金 | 変動 | Web検索、ファイル検索、Code Interpreterなど |
表記上の料金よりも、以下の3つの詳細が重要です:
- 秒単位の課金。 90秒の通話にかかる費用は0.10ドルではなく0.075ドルです。通話時間が丸めて1分単位になることはありません。
- GPT-Live-1と同一料金。 両モデルの料金は同一なので、アップグレードしても音声の請求額は変わりません。
- 15秒の起動課金。 WebRTCセッションの作成時には、初期化中の15秒分が課金されますが、セッションが正常に実行された時点でクレジット(相殺)されます。追加料金がかかるのは、作成したまま放置されたセッションのみです。
音声スタックの背景については、GPT-Live vs GPT-Realtimeを参照してください。
アクティブとスタンバイに分類される時間の定義
アクティブな時間とは、推論が実行中であるすべての時間です。スタンバイ時間とは、WebRTCセッションが接続されたまま推論が一時停止し、発話を待っている時間です。この2つの間の1分あたり0.03ドルの差が、音声料金の大半を左右します。
OpenAIのコストガイドでは、アクティブに分類される時間として以下が挙げられています:
- ユーザーまたはモデルが話している時間。
- アイドルタイムアウトが経過するまでの無音時間。
- 推論が実行中のままバックエンド処理の完了を待っている時間。
マイクをミュートしてもスタンバイにはなりません。セッションは1分あたり0.05ドルで課金され続けます。
スタンバイを有効にするには、セッション作成時にライブ会話ガイドに記載されている2つの設定が必要です:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech"は、推論を開始する前に発話を待つようセッションに指示します。idle_timeout_sは5から60の整数を受け取り、入力または出力のトランスクリプトがない状態がその秒数続くと、セッションをスタンバイに戻します。タイムアウトを省略すると、セッションが終了するまで推論がアクティブなままになるため、スタンバイ料金が適用されることはありません。
2つの注意点があります。スタンバイはWebRTC専用であるため、WebSocketおよびSIPセッションは接続中の全時間がアクティブ料金で課金されること。また、スタンバイ直後の最初の応答には時間がかかる場合があることです。
料金計算の実例
音声料金は公開されている料金に基づきますが、バックエンドのトークン数は説明用の想定値です。バックエンドの価格はOpenAIの料金ページに基づきます: gpt-6-lunaは100万トークンあたり入力$0.10・出力$0.50、gpt-6-solは100万トークンあたり入力$2.00・出力$10.00(スタンダードティア、短いコンテキスト)。OpenAIの委譲ガイドでは、まずgpt-6-lunaから始め、より難しいバックエンドタスクにはgpt-6-solを試すことが推奨されています。
例1: カスタマーサポート通話
電話またはWebSocketによるサポート通話が6分間続いたとします。スタンバイは適用されないため、6分全体がアクティブとして課金されます。GPT-Liveは4回の照会をgpt-6-lunaに委譲し、それぞれ約6,000入力トークンと400出力トークンを使用します。
| 明細 | 計算 | 費用 |
|---|---|---|
| 音声 | 6分 × $0.05 | $0.30 |
| バックエンド入力 | 24,000トークン × $0.10 / 1M | $0.0024 |
| バックエンド出力 | 1,600トークン × $0.50 / 1M | $0.0008 |
| 1回あたり | $0.3032 |
月間10,000件の通話とすると、約3,032ドルとなり、そのうち3,000ドルが音声時間です。平均通話時間を30秒短縮するだけで、バックエンドの請求額全体よりも多くを節約できます。
例2: ブラウザ上の語学チューター
idle_timeout_sを15に設定した30分間のWebRTCチュータリングセッションです。生徒は文章を読んで考える時間が長く、セッションはアクティブ18分・スタンバイ12分で進みました。チューターは10回の解説をgpt-6-solに委譲し、それぞれ約8,000入力トークンと600出力トークンを使用します。
| 明細 | 計算 | 費用 |
|---|---|---|
| アクティブ音声 | 18分 × $0.05 | $0.90 |
| スタンバイ音声 | 12分 × $0.02 | $0.24 |
| バックエンド入力 | 80,000トークン × $2.00 / 1M | $0.16 |
| バックエンド出力 | 6,000トークン × $10.00 / 1M | $0.06 |
| 1セッションあたり | $1.36 |
スタンバイを使わなかった場合、同じ30分の音声料金は1.14ドルではなく1.50ドルになるため、スタンバイにより音声料金が24%削減されたことになります。
例3: 常時起動のデスクトップアシスタント
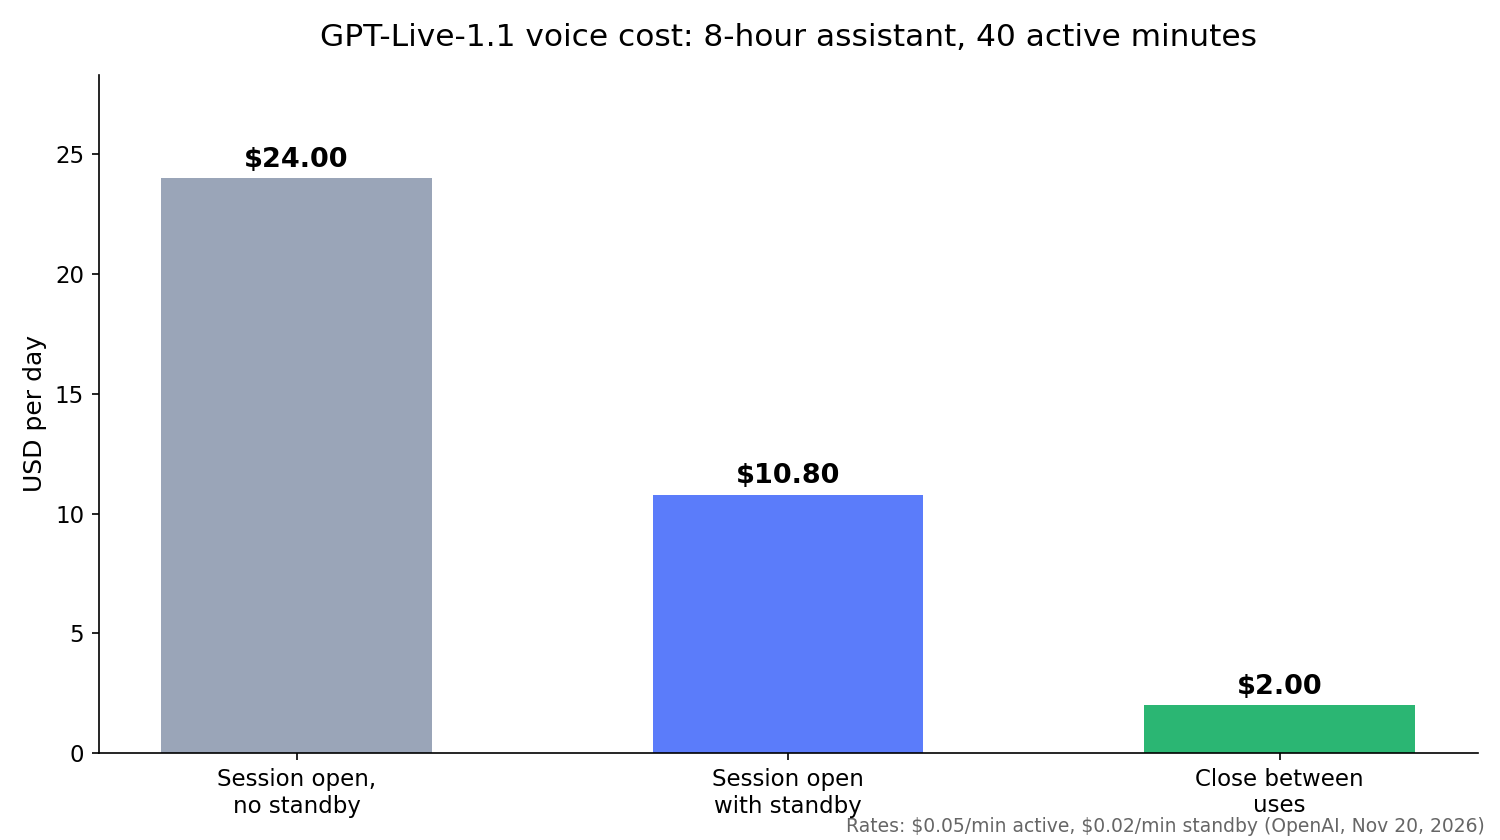
アシスタントは8時間の勤務時間中ずっと開いたままですが、ユーザーが実際に話しかけるのは短時間に分けて合計40分だけです。この場合、選択する戦略によって請求額は10倍以上変わります:
| 戦略 | 計算 | 1日あたり | 22日間の月あたり |
|---|---|---|---|
| セッションを開いたまま、スタンバイなし | 480分 × $0.05 | $24.00 | $528.00 |
| セッションを開いたまま、スタンバイあり | 40 × $0.05 + 440 × $0.02 | $10.80 | $237.60 |
| 使用間隔でクローズ | 40分 × $0.05 | $2.00 | $44.00 |
スタンバイでもアイドル時間1時間あたり1.20ドルはかかります。OpenAIのガイドでは、長い空白期間にはセッションを閉じ、ユーザーが戻ってきたら保存済みの履歴を引き継いで新しいセッションを開始することが推奨されています。15秒の起動課金は新しいセッションが実行された時点で相殺されるため、音声料金だけを見ればクローズが有利です。ただし、即時の復帰は諦めることになります。閉じたセッションはユーザーの声を聞き取れないため、プッシュトゥトークや独自の起動トリガーが必要です。
アイドルタイムアウトが請求額に与える影響
アイドルタイムアウトが発火するまで、一時停止はすべてアクティブな時間として課金されます。タイムアウトを短くすれば、より安いスタンバイ料金に早く移行できますが、その代わりに一時停止・再開のサイクルが増え、再開後の最初の応答が遅くなります。
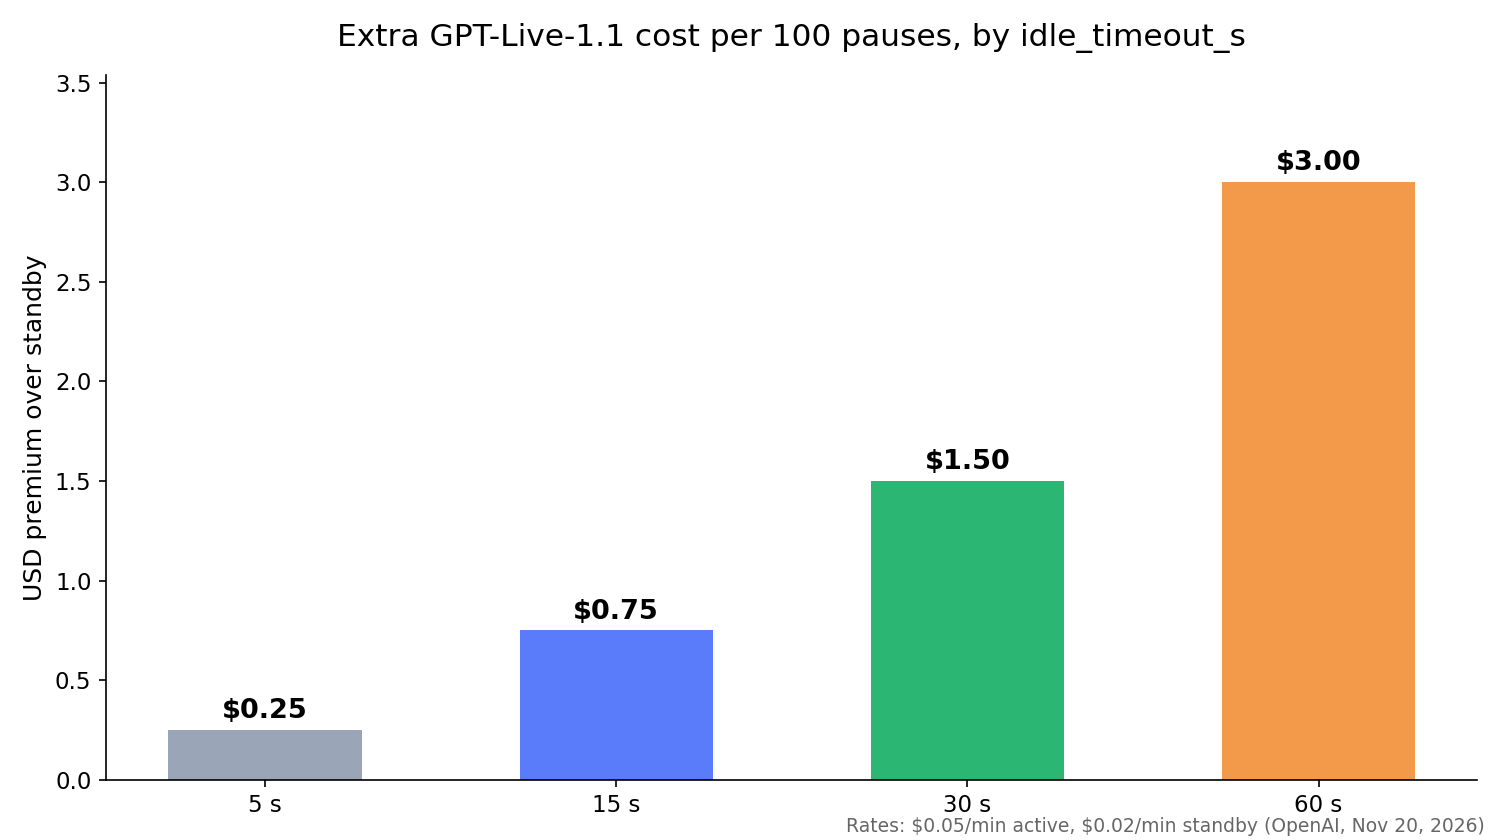
1回の一時停止あたりの追加コストは、タイムアウトの長さに2つの料金の差である$0.03を乗じたものです。1セッションまたは1日で100回の一時停止が発生した場合:
idle_timeout_s |
1回の一時停止あたりアクティブ秒数 | 100回の一時停止あたりスタンバイとの差額 |
|---|---|---|
| 5 | 5 | $0.25 |
| 15 | 15 | $0.75 |
| 30 | 30 | $1.50 |
| 60 | 60 | $3.00 |
金額はわずかです。それがポイントです。タイムアウトは主にユーザー体験のための設定です。ユーザーの考え途中で遮断しない値を選び、長めの空白はスタンバイで、非常に長い空白はセッションのクローズで対応しましょう。
GPT-Live-1.1とGPT-Realtimeの料金比較
GPT-Live-1.1は分単位で課金されますが、GPT-Realtimeモデルはトークン単位で課金されます。OpenAIの料金ページでは、gpt-realtime-2.1の音声は100万入力トークンあたり$32.00・100万出力トークンあたり$64.00、gpt-realtime-2.1-miniの音声は$10.00と$20.00と記載されています。
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| 課金単位 | セッション秒数 | 入力および出力トークン |
| 音声料金 | アクティブ$0.05/分、スタンバイ$0.02/分 | 100万音声トークンあたり$32 / $64 |
| 推論とツール | 別のバックエンドモデル | 同一モデル内 |
| コスト曲線 | 1分あたり一定 | コンテキストの増加に伴いターンごとに上昇 |
OpenAIのコストガイドによると、Realtimeセッションでは応答のたびに会話全体がモデルに送信されるため、後半のターンほどコストが高くなります。GPT-Liveは2分目も40分目も同じ料金であるため、コスト予測が容易です。トークンベースの設定については、GPT-Realtime-2 APIガイドで解説しています。
使用量を追跡し、想定外の請求を避ける
GPT-Liveは、session.usage.updatedイベントを通じて累積音声使用量を秒単位で報告します:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
各更新は前の合計を置き換えるため、合算してはいけません。session.closeを送信し、session.closedを待って、最終的なusage.secondsを記録してください。アクティブとスタンバイを分けるには、session.pausedとsession.resumedイベントの間の時間を計測します。
コストを一定に保つための習慣:
- 終了したセッションは閉じる。 放置された開いたセッションは課金され続けます。
- バックエンドを高速化する。 委譲タスクの待機時間はアクティブ時間です。1分早く終われば$0.05の節約になります。
- 長い処理の間はセッションを閉じる。 バックエンドの処理中は音声を閉じ、結果が準備できたら再オープンしましょう。
- 同時実行数を計画に入れる。 制限は同時セッション数に対して適用され、GPT-Live-1.1にはGPT-Live-1とは別の制限があります。GPT-Live-1の公開制限は50(Build)、300(Launch)、500(Grow)です。Freeティアは対応していません。
Apidog CLIでCodexにコスト計算ロジックをテストさせる
使用量の計算ロジックはあなたが所有するコードであり、そこにバグがあればすべての通話の金額が誤ります。音声セッションを開かずに、音声時間$0で毎回のコミット時にテストを実行しましょう。コーディングエージェントにApidog CLIでテストを実行させることができます。
CLIをインストールし、ログインして、Apidogスキルをエージェントに追加します:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
その後、Codexに次の1つのプロンプトを与えます:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
エージェントはスキーマを読み、ペイロードを検証し、テストケースを作成して実行します:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
-r cli,jsonを-r junitに変えれば、同じ実行をそのままCIに組み込めます。詳しくはCI/CDパイプラインでのApidog CLIの実行を参照してください。エージェントの設定についてはCodexでのApidog CLIガイドで解説しています。ApidogのFreeプランは最大4ユーザーのチームまで対応しています。
FAQ
GPT-Live-1.1の1分あたりの料金は? アクティブな時間が1分あたり$0.05、スタンバイが1分あたり$0.02で、秒単位で課金されます。バックエンドの使用量は別途かかります。
GPT-Live-1.1はGPT-Live-1より高価ですか? いいえ。OpenAIは両モデルを同じアクティブ料金・スタンバイ料金でリストしています。
電話でもスタンバイは使えますか? いいえ。低いスタンバイ料金は、推論が一時停止している間のWebRTCセッションにのみ適用されます。WebSocketおよびSIPセッションは、接続時間がアクティブ料金で課金されます。
バックエンドのモデル呼び出しは1分あたりの料金に含まれていますか? いいえ。委譲されたResponses呼び出しは、選択したモデルのトークン料金で課金され、ツールの料金も加算されます。
7月の「GPT-Live API」の話はどうなったのですか? 当時、GPT-LiveはAPIのないChatGPTの音声機能でした。これは当時のGPT-Live API解説記事でも指摘されています。GPT-Live-1.1がAPIモデルであり、v1/live/sessionsで提供されています。