
GPT-Live-1.1 APIは、OpenAIの全二重音声モデルで、v1/live/sessions上で提供されます。WebRTC、WebSocket、またはSIPでセッションを開き、モデル、instructions、voiceを含むsession設定を送信し、委任(delegation)を通じて推論やツール呼び出しをバックエンドのResponsesモデルに任せることができます。料金はアクティブな分あたり$0.05、スタンバイの分あたり$0.02です。
OpenAIは2026年11月20日にGPT-Live-1.1をAPIで利用可能にしました(OpenAI Developersのアナウンスによる)。7月の記事「Is there a GPT-Live API?」では「まだ利用できない」とお伝えしていましたが、状況は変わりました。このガイドでは、実際に動作するセッション、委任設定、関数ツール、そして音声エージェントが呼び出すバックエンドのテスト環境の構築方法を解説します。
GPT-Live-1.1 APIとは?
GPT-Live-1.1は、話しながら聞き取ることのできるspeech-in、speech-outのモデルです。v1/realtimeやv1/responsesではなく、v1/live/sessionsエンドポイント上で動作します。このモデル本体の役割は会話です。より重い推論やツールの使用は、設定したバックエンドモデルに委ねられるため、処理が実行されている間も音声の応答性が維持されます。
現在のGPT-Live-1.1モデルページに記載されている内容は以下のとおりです:
| 項目 | GPT-Live-1.1 |
|---|---|
| モデルID | gpt-live-1.1(単一スナップショット) |
| 入力 / 出力 | 音声とテキスト入力、音声とテキスト出力 |
| エンドポイント | v1/live/sessionsのみ |
| トランスポート | WebRTC(推奨)、WebSocket、SIP |
| アクティブ価格 | 1分あたり$0.05 |
| スタンバイ価格 | 1分あたり$0.02(WebRTC、推論一時停止時) |
| バックエンドモデルとツール | それぞれの通常料金で別途課金 |
| 同時実行数 | GPT-Live-1とは別の制限、組織単位 |
製品の背景については、GPT-Liveとは、およびGPT Realtimeとの違いを解説した記事をご覧ください。
GPT-Live-1.1とGPT-Live-1の違い:何が変わったのか
モデルページとプロンプティングガイドには、実用面での4つの違いが記載されています:
- 文字起こし: 1.1は「より正確に音声を文字起こしする」。
- 音声: 1.1は「言語をまたいでより一貫したアクセントと声を維持する」。
- 委任プロンプト: 1.1は平文での指示を受け付ける(「Delegate to the backend when:」など)。GPT-Live-1ではポリシーに
<|SpawnThinking|>マーカーが必要。 - 課金の表記: GPT-Live-1は秒単位で課金され、1分に切り上げられることはない。1.1のページには「durationに応じて課金」としか記載されていない。
両モデルともエンドポイント、価格、セッションの構造は共通しているため、1.1への移行は基本的にモデル名の文字列変更と、よりクリーンなプロンプトへの書き換えだけで済みます。
GPT-Live-1.1セッションの開始方法
GPT-Live入門ガイドでは、ブラウザ、モバイル、サーバーのオーディオにはWebRTCが推奨されています。ただしサーバーサイドのプロトタイプにはWebSocketがよりシンプルなので、まずはそこから始めましょう:
- クエリパラメータなしで、
Authorization: Bearer $OPENAI_API_KEYを付けてwss://api.openai.com/v1/live/sessionsに接続します。 session設定を含むsession.startを最初のメッセージとして送信します。- 音声を送信する前に
session.startedを待ちます。 - 選択した形式で音声をストリーミングします。デフォルトは24 kHzのPCMです。
import WebSocket from "ws";

const ws = new WebSocket("wss://api.openai.com/v1/live/sessions", {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  ws.send(JSON.stringify({
    type: "session.start",
    event_id: "start_1",
    session: {
      model: "gpt-live-1.1",
      instructions: "You are the voice agent for Acme order support. Keep answers short.",
      audio: {
        format: { type: "audio/pcm", rate: 24000 },
        output: { voice: "marin" },
      },
    },
  }));
});

ws.on("message", (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type === "session.started") console.log("Session ready");
});
会話ガイドからの設定ルールをいくつか紹介します:
instructionsは最大16,384トークンまで。セッション中にsession.instructions.appendで追加可能(1回あたり500トークン)。audio.output.voiceのデフォルトはmarin。その他のAPI名にはquartz、stone、meridian、willowがあります。- WebSocketのフォーマットは、24,000Hzまたは16,000Hzの
audio/pcm、電話向けには8,000Hzのaudio/pcmuまたはaudio/pcmaです。 storeのデフォルトはfalse。modelの変更には新しいセッションが必要です。
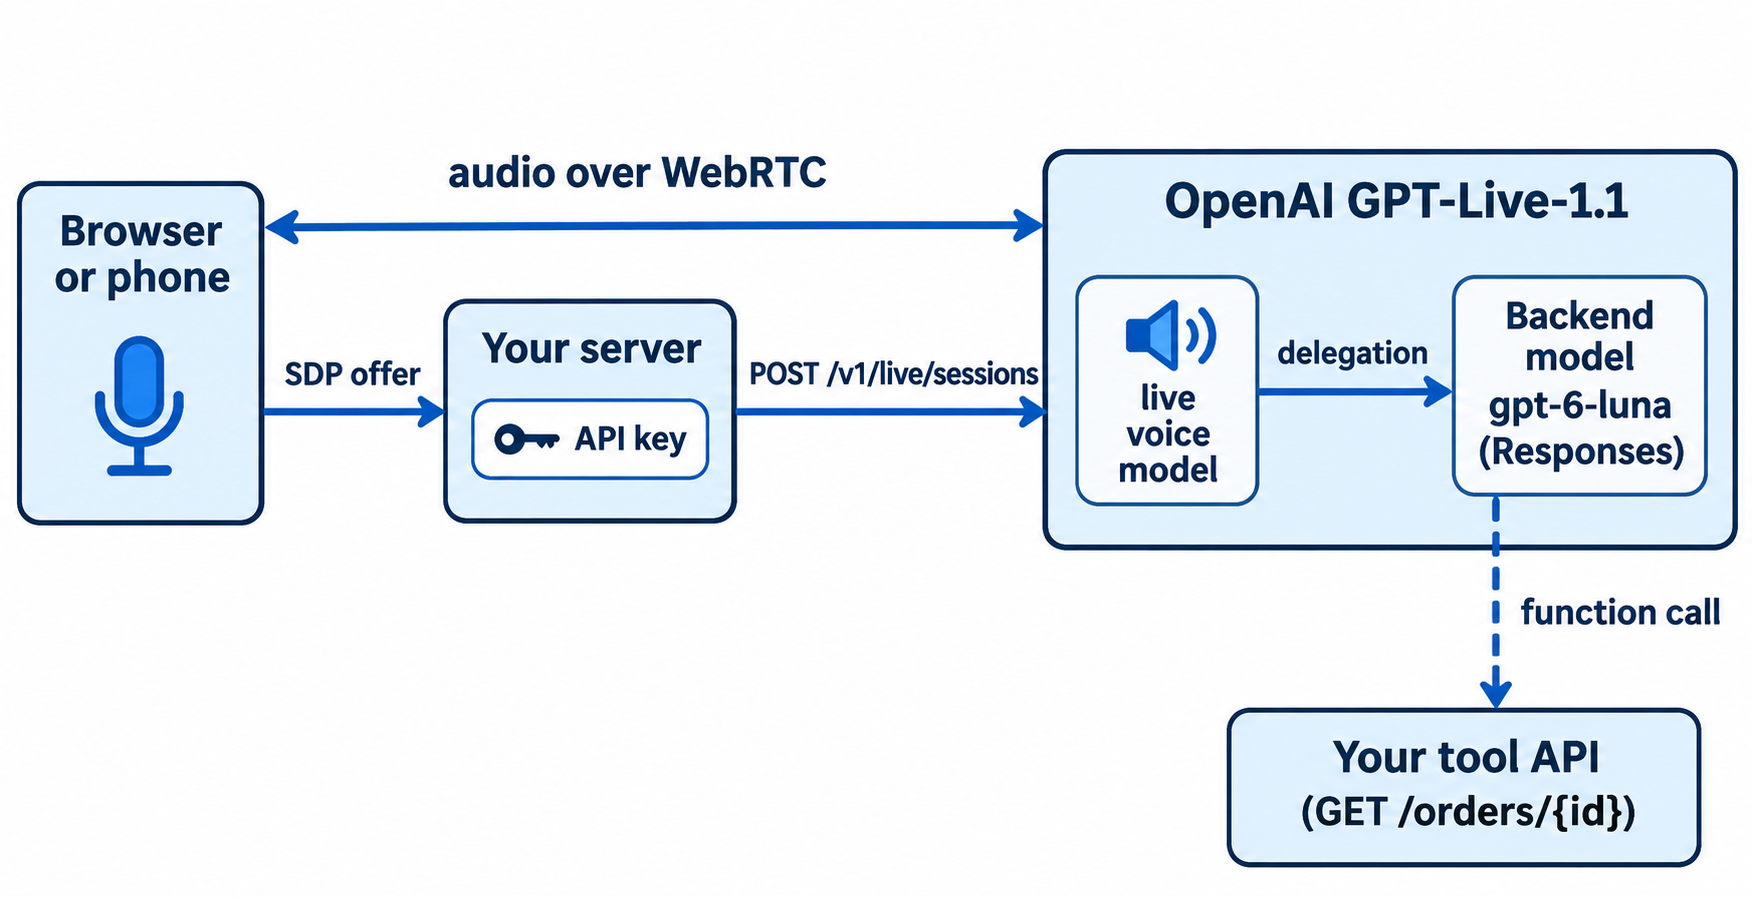
ブラウザでの本番環境では、WebRTCに切り替えてください。サーバーがAPIキーを保持し、ブラウザのSDPオファーを中継します:
const res = await fetch("https://api.openai.com/v1/live/sessions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { model: "gpt-live-1.1", instructions: "..." },
    transport: { type: "webrtc", sdp: offerSdp },
  }),
});
const { session, transport } = await res.json(); // HTTP 201
// session.id looks like "live_123"; return transport.sdp to the browser
WebRTCリクエストではaudio.formatを指定せず、データチャネル上でsession.startを送信しないでください。課金に関する注意点として、WebRTCセッションの作成時には初期化中に15秒分が課金されますが、セッションが実行されるとクレジットされます。
GPT-Live-1.1の委任:バックエンドモデルに推論を任せる
委任(delegation)は、このAPIが存在する最大の理由です。音声モデルが会話を続けている間に、バックエンドモデルが推論、検索、ツール呼び出しを実行します。セッション作成時に2つのモードのいずれかを選択し、セッション中にモードを切り替えることはできません。
| モード | delegation.type |
バックエンドを実行する主体 | 最適な用途 |
|---|---|---|---|
| Responses | "responses" |
OpenAI。設定したモデルとツールを使用 | ほとんどのアプリ。ホスト型ツール、関数呼び出し |
| Client | "client"(デフォルトでもある) |
あなたのアプリ | 独自のエージェントループやOpenAI以外のバックエンド |
委任ガイドでは、まずgpt-6-lunaから始め、より難しいバックエンドタスクにはgpt-6-solを試すことが推奨されています。まだ選択していない場合は、GPT-6 Lunaの概要でトレードオフを解説しています。
"delegation": {
  "type": "responses",
  "responses": {
    "model": "gpt-6-luna",
    "instructions": "Look up orders with get_order. Answer in one sentence.",
    "tools": [{ "type": "web_search" }],
    "tool_choice": "auto",
    "parallel_tool_calls": false
  }
}
responsesブロックには、max_output_tokens(16以上)、service_tier(auto、default、flex、priority。うちpriorityは高速モード)、およびバックエンドモデルが対応するreasoningとtextの設定も指定できます。これらのフィールドはセッション中にsession.updateで変更可能です。検証は非同期で行われます。不正な設定はコードresponses_validation_failedのerrorとして届き、セッションは開いたままになります。
次に、音声モデルにいつ委任するかを指示します。1.1では、instructions内で平文で記述するだけです:
Delegate to the backend when: the caller asks about an order, a refund or anything you must look up.
Do not delegate when: the caller greets you, asks you to repeat, or says goodbye.
While the backend works, briefly say what you are checking.
プロンプティングガイドは、「確認しています」と音声で言ったことだけでは、バックエンド処理が開始された証拠にはならないと警告しています。代わりに、ログでsession.delegation.createdを監視してください。
GPT-Live-1.1セッションに関数呼び出しを追加する
Web検索のようなホスト型ツールはOpenAI内部で実行されますが、独自の関数はあなたのアプリ内で実行されます。標準のResponses関数ツールをdelegation.responses.toolsに記述します:
{
  "type": "function",
  "name": "get_order",
  "description": "Get the shipping status of an order by its ID.",
  "parameters": {
    "type": "object",
    "properties": { "order_id": { "type": "string" } },
    "required": ["order_id"],
    "additionalProperties": false
  },
  "strict": true
}
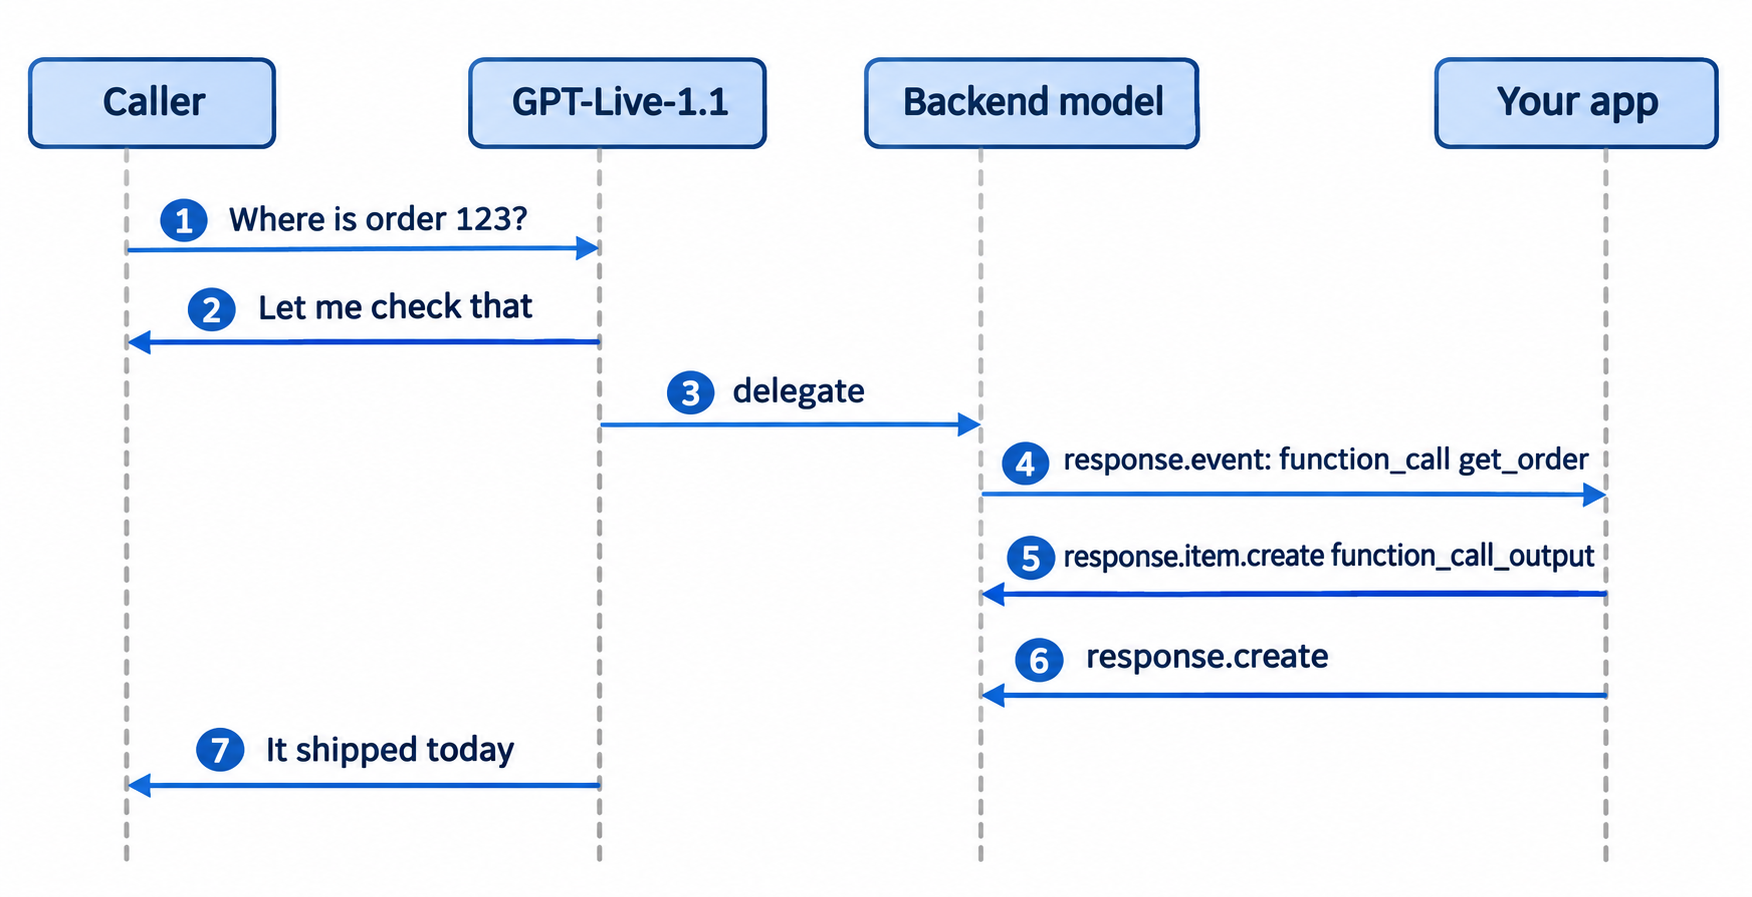
バックエンドのイベントは、delegation_idとネストされたeventを含むresponse.eventエンベロープにラップされて届きます。完了した関数呼び出しは、call_id、name、argumentsを持つアイテムを含むネストされたresponse.output_item.doneとして届きます。関数を実行し、結果を含むresponse.item.createを送信し、その後response.createを送信します:
ws.on("message", async (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type !== "response.event") return;
  const ev = msg.event;
  if (ev.type !== "response.output_item.done" || ev.item?.type !== "function_call") return;

  const { order_id } = JSON.parse(ev.item.arguments);
  const order = await fetch(`${ORDERS_API}/orders/${order_id}`).then((r) => r.json());

  ws.send(JSON.stringify({
    type: "response.item.create",
    item: { type: "function_call_output", call_id: ev.item.call_id, output: JSON.stringify(order) },
  }));
  ws.send(JSON.stringify({ type: "response.create" }));
});
人々がつまずきやすい3つのポイントがあります:
- 出力の追加だけではバックエンドは再開しません。
response.createが必要です。 - 保留中の結果をスキップすると
function_call_outputs_requiredが返されます。重複または不一致のcall_idは拒否されます。 - 転送された
response.completedイベントのresponse.outputは空です。個々の出力アイテムイベントを読んでください。
GPT-Live-1.1の料金と制限
音声の時間はコスト計算がシンプルです。全編アクティブな5分間のサポート通話は、音声時間で5 × $0.05 = $0.25かかります。1,000件なら$250で、それに加えてバックエンドモデルとツールの通常料金が課金されます。
| コスト項目 | 料金 |
|---|---|
| アクティブな音声 | 1分あたり$0.05 |
| スタンバイの音声(WebRTC、推論一時停止時) | 1分あたり$0.02 |
| WebRTCの初期化 | 15秒。セッション実行時にクレジット |
| バックエンドモデルとツール | そのモデルとツールの通常料金 |
レート制限はトークンではなく同時セッション数でカウントされます。GPT-Live-1.1とGPT-Live-1には別々の制限があり、すべての推論リージョンに適用されます。GPT-Live-1のページには、Build、Launch、Growティアでそれぞれ50、300、500の同時セッションが記載されており、Freeティアでは利用できません。1.1のページには数字が記載されていないため、リリース前に組織の制限ページを確認してください。
Apidog CLIでコーディングエージェントにツールバックエンドをテストさせる
音声エージェントの信頼性は、get_orderの背後にあるAPI次第です。応答が遅かったり不正な形式だったりすると、沈黙や間違った回答がそのまま発話されてしまいます。だからこそ、発信者に聞かれる前にそのバックエンドをテストしましょう。Apidog CLIを使えば、コーディングエージェントにテストさせることができます。
一度だけセットアップします:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
あとはClaude Code、Codex、Cursorに1つのプロンプトを渡すだけです:
Import ./orders-openapi.yaml into Apidog project <projectId>. Create test cases for
GET /orders/{order_id}: a known ID returns 200 with a status field in under 800 ms,
and an unknown ID returns 404 with a JSON error. Run them against the staging
environment and tell me what failed.
エージェントがスキーマを読み取り、ペイロードを検証し、テストケースを作成して実行します:
apidog import --project <projectId> --format openapi --file ./orders-openapi.yaml
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
音声においては、ツールに要した1ミリ秒ごとが発信者に聞こえてしまうため、この800msの予算は重要です。CIに-r junit付きの同じapidog runを組み込めば、リグレッションがビルドを失敗させます。詳細はApidog CLI CI/CDガイドをご覧ください。エージェントワークフローが初めての場合は、Claude CodeでのApidog CLIから始めてください。ApidogのFreeプランは最大4ユーザーまで対応しています。
FAQ
GPT-Live-1.1はAPIで利用できますか? はい。2026年11月20日以降、WebRTC、WebSocket、SIP経由でv1/live/sessions上のgpt-live-1.1を呼び出せます。v1/realtime、v1/responses、Chat Completionsでは提供されていません。
GPT-Live-1.1 APIの料金はいくらですか? アクティブな分あたり$0.05、スタンバイの分あたり$0.02です。バックエンドモデルの呼び出しとツールは、それぞれの料金で別途課金されます。
GPT-Live-1.1とGPT Realtimeの違いは何ですか? GPT-Liveは専用のエンドポイント上で動作し、音声の時間に応じて課金され、委任を通じて推論をバックエンドモデルに任せます。GPT Realtimeはv1/realtime上で動作します。詳しくはGPT-Live vs GPT Realtimeの比較をご覧ください。
委任にはどのバックエンドモデルを使うべきですか? OpenAIのガイドでは、まずgpt-6-lunaから始め、より複雑なバックエンドタスクにはgpt-6-solを試すことが推奨されています。コストよりもレイテンシが重要な場合は、service_tierをpriorityに設定してください。
Responsesモデルの代わりに独自のエージェントを使えますか? はい。delegation.typeをclientに設定してください。あなたのアプリがバックエンド処理を実行し、session.commentary.appendで結果を返します。文字起こしの管理も自分で行う必要があります。
GPT-Live-1.1は関数呼び出しをサポートしていますか? はい、Responses委任を通じてサポートされます。delegation.responses.toolsで関数を定義し、response.eventから呼び出しを読み取り、response.item.createとresponse.createで結果を返します。