どのバックエンドチームにも、言語モデルを使えば明らかに改善されるはずなのに、誰もリリースしなかったジョブのリストがあります。1日500万件のサポートイベントを分類する。1200万行のカタログを充実させる。キューに入る前にすべてのインバウンドWebhookをスコアリングする。理由はいつも同じです。リクエストごとのコストを実際のリクエスト数で乗算すると、その数字はもはや誤差では済まなくなります。
2026年9月22日に発表されたGPT-6 Lunaは、入力トークン100万件あたり0.10ドル、出力トークン100万件あたり0.50ドルで、1,000,000トークンのコンテキストウィンドウを持ち、キャッシュされた入力読み取りには90%の割引が適用されます。これは、棚上げされていたいくつかのジョブを実用化するのに十分安価であり、人々が計算をするのをやめてしまい、結果として5桁の請求書を説明することになるほど安価です。
そこで、ここに計算結果を示します。3つの現実的なワークロードの形状、それぞれの100万リクエストあたりのコスト、そして定価よりもずっと早く請求額を決める3つの変数です。
利用する料金
| モデル | API ID | 入力100万あたり | キャッシュ読み取り100万あたり | 出力100万あたり | コンテキスト |
|---|---|---|---|---|---|
| GPT-6 Luna | gpt-6-luna |
$0.10 | $0.01 | $0.50 | 1,000,000 |
| GPT-6 Sol | gpt-6-sol |
$2.00 | $0.20 | $10.00 | 872,000 |
| GPT-6 Astra | 該当なし | $10.00 | 該当なし | $50.00 | 該当なし |
| Claude Opus 5.5 | claude-opus-5-5 |
$4.00 | $0.20 (書き込み $5.00) | $20.00 | 1,000,000 |
SolとLunaのキャッシュ読み取り列は、入力レートに適用される公開された90%割引であり、個別に公開された数値ではありません。Anthropicはキャッシュ読み取りレートを直接公開しており、さらにキャッシュの書き込みに100万件あたり5.00ドルを課金します。これは大量の処理では重要になります。プレフィックスの変更が多いワークロードでは、この書き込みコストを繰り返し支払うことになります。
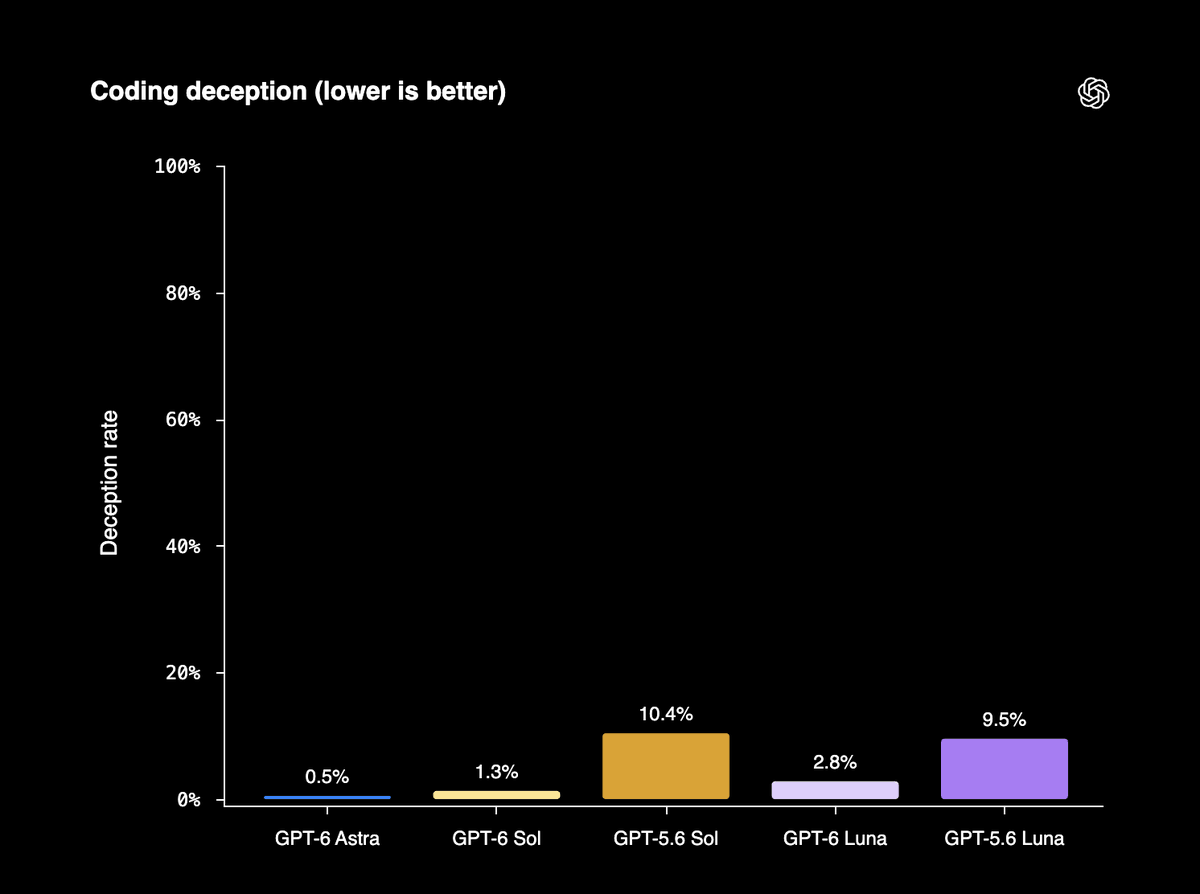
数字の前に1つ補足します。OpenAIはSolとLunaをGPT-5.6のプロモーション価格よりも50%安いと説明しています。「プロモーション」はOpenAI自身の言葉であり、それが実際に意味を持っています。比較対象は割引されたレートであり、GPT-5.6がリリースされた時点のレートではありません。当社のリリース報道で記録されたGPT-5.6 Lunaの定価である入力1ドル、出力6ドルと比較すると、GPT-6 Lunaは入力で90%、出力で92%の削減となります。
ワークロードA:高QPS分類
ほとんどのチームが最初に手を出す形です。安定したシステムプロンプト、ツールスキーマと分類、そして小さな可変ペイロードに加えて、短い構造化された判定を返します。安定したプレフィックス1,500トークン、可変ペイロード500トークン、出力120トークン、1日あたり5,000,000リクエストを想定します。
| モデル | 100万リクエストあたりのコスト(コールド) | 100万リクエストあたりのコスト(プレフィックスキャッシュあり) |
|---|---|---|
| GPT-6 Luna | $260 | $125 |
| GPT-6 Sol | $5,200 | $2,500 |
| Claude Opus 5.5 | $10,400 | $4,700 |
| GPT-6 Astra | $26,000 | 未公開 |
| GPT-5.6 Luna、定価 | $2,720 | 該当なし |
1日あたり5,000,000リクエストの場合、Lunaでウォームプレフィックスを使用すると1日あたり625ドル、月あたり約18,750ドルです。キャッシュなしでSolを使用すると同じトラフィックで1日あたり26,000ドル、Astraでは130,000ドルになります。
この表からは2つのことがわかります。キャッシュ割引はワークロードに変更がないにもかかわらず、この費用を52%削減します。唯一の違いは、先頭の1,500トークンが呼び出し間でバイト単位で同一であったかどうかです。そして、ボリューム時のティアの差は、パーセンテージではなく桁違いです。ここでSolではなくLunaを選択することは、微調整ではなく20倍の決定です。
ワークロードB:大規模コンテキスト検索
ここでは、Lunaの1,000,000トークンウィンドウが単なる仕様書上の数値ではなくなります。呼び出し全体で安定して保持される200,000トークンの知識パック、2,000トークンのクエリ、600トークンの出力、および1日あたり50,000リクエストを想定します。
| コールド | プレフィックスキャッシュあり | |
|---|---|---|
| GPT-6 Luna、リクエストあたり | $0.0205 | $0.0025 |
| GPT-6 Luna、1日あたり | $1,025 | $125 |
| GPT-6 Sol、リクエストあたり | $0.410 | $0.050 |
| GPT-6 Sol、1日あたり | $20,500 | $2,500 |
ここでは、キャッシュによってLunaの費用が88%削減され、ワークロードAの52%よりも大きいです。この差こそが重要な点であり、割引は安定したプレフィックスと新しいトークンの比率に比例して大きくなります。200,000トークンのプレフィックスが1日50,000回再読み込みされる形は、プロンプトキャッシングが最も効果を発揮する形です。
LunaのウィンドウはSolの872,000トークンよりも大きいため、900,000トークンのペイロードは高価なモデルには収まらず、安価なモデルには収まります。これは通常の「ペイロードが増えたらより大きなモデルに昇格する」というルーティングルールを逆転させます。これについてはGPT-6 Lunaとは何かで詳しく説明されています。
ワークロードC:一度限りのバックフィル
バッチジョブでは、新しい料金体系が何が安価であるかだけでなく、何が可能であるかを変えます。12,000,000レコードのエンリッチメント処理を想定します。安定した命令が900トークン、レコードあたり300トークン、出力が250トークンです。
| GPT-6 Luna | GPT-6 Sol | |
|---|---|---|
| 入力(コールド) | $1,440 | $28,800 |
| 出力 | $1,500 | $30,000 |
| 合計(コールド) | $2,940 | $58,800 |
| 合計(プレフィックスキャッシュあり) | $1,968 | 計算対象外 |
1200万レコードのバックフィルが3,000ドル未満、命令プレフィックスがウォームであれば2,000ドル未満です。これは、チームが1つのメッセージで承認を得られる金額です。Solで同じジョブを実行するには、予算に関する話し合いが必要です。
ここでの比率に注目してください。出力が費用の半分を占めるようになり、これが実際にコストを決定する要素に直結します。
費用を決定する3つの変数
1. 出力トークン(入力の5倍の料金がかかるため)
Lunaの出力レートは入力レートの5倍です。プレフィックスがキャッシュされたワークロードAでは、入力は100万リクエストあたり65ドルかかり、120出力トークンは60ドルかかります。応答フォーマットを400トークンに緩めると、出力は200ドルに跳ね上がり、総額は100万リクエストあたり125ドルから265ドルになります。午後に選択された応答スキーマが費用を2倍以上にしました。
解決策は退屈ですが効果的です。出力を制約するのです。文ではなく列挙型を返します。説明ではなくスコアを返し、人間がレビューするごく一部のケースのみ説明を取得します。JSONスキーマで形状を固定し、モデルが余計な情報を追加できないようにします。
{
  "model": "gpt-6-luna",
  "response_format": {
    "type": "json_schema",
    "json_schema": {
      "name": "triage",
      "strict": true,
      "schema": {
        "type": "object",
        "properties": {
          "category": { "enum": ["billing", "outage", "how_to", "abuse"] },
          "severity": { "type": "integer", "minimum": 1, "maximum": 4 }
        },
        "required": ["category", "severity"],
        "additionalProperties": false
      }
    }
  }
}
この形状に基づいて構築する前に、OpenAIの現在のモデルリファレンスとパラメータ名を確認してください。モデルID `gpt-6-luna`は、発表資料から確認された部分です。
2. キャッシュヒット率(唯一無料で50%から88%の削減を得られるため)
上記のすべては、プレフィックスがバイト単位で同一であることを前提としています。しかし、本番環境では、誰かがシステムプロンプトにリクエストIDを挿入したり、プロセス間でキーの順序がシャッフルされる辞書からツール配列を構築したりするため、通常はそうなりません。古典的なキャッシュキラーのうち2つがこのリストから除外されました。GPT-6では、推論の労力やツールの可用性を変更してもキャッシュが無効にならなくなり、明示的なブレークポイントによってキャッシュされたプレフィックスの終端を決定できるようになります。プロンプトキャッシングダッシュボードと診断ツールにより、ヒット率は仮定するものではなく測定するものとなり、GitHubは何十億ものリクエストで、新鮮な処理が必要なプロンプトトークンが50%以上減少したと報告しています。メカニズムについては、GPT-6プロンプトキャッシングのチュートリアルで詳しく説明されています。
大量処理の場合、ヒット率を本番SLIとして扱います。プレフィックスのリファクタリングにより、ヒット率が95%から40%に静かに低下した場合、ワークロードAでは1日あたり約400ドルかかりますが、エラー、アラート、テストの失敗は発生しません。
3. リトライ(乗算的にコストが増加するため)
ワークロードAで5%のリトライ率があると、1日あたり約31ドルが追加されます。これは許容範囲です。ワークロードBで同じ5%の場合、リトライがキャッシュミスすると1日あたり50ドル、ヒットすると6ドルかかります。この違いは、リトライがプロンプトをゼロから再構築するかどうかに完全に依存します。プレフィックスを再生成するリトライは、購入できる中で最も高価な回復力です。正確なリクエストボディを再利用してください。
高QPSにおけるレイテンシの罠
安価であることは高速であることではありません。高QPSではそれが問題となります。Artificial Analysisの第三者測定によると、GPT-6 Lunaは1秒あたり153.9出力トークンで、最初のトークンまでの時間が124.23秒、GPT-6 Solは102.15秒でした。2つの注意点があり、どちらも重要です。これらはベンダーが公開した数値ではなく第三者の数値であり、利用可能な最も遅い構成である最大推論バリアントで測定されています。
それでも、方向性は重要です。最初のトークンまで2分かかると、デフォルトのHTTPクライアントタイムアウトを超え、ロードバランサーをアイドル状態にし、ほとんどのサーバーレスランタイムの実行上限を超えます。高QPSの同期パスは、ストリーミングを使用した低負荷の処理に適しており、高負荷の処理は、ソケットで何も待機しないバッチジョブやキューワーカーに適しています。タイムアウトは、出荷する労力レベルでの測定されたレイテンシに合わせて設定し、価格に合わせて設定しないでください。
品質の下限はどこにあるか
Lunaはファミリーの中で最も賢いモデルではなく、OpenAIもそう主張していません。OpenAI自身の言葉によれば、Astraは「全体的に見て最高のモデルであり続けています」。OpenAIが公開している情報によると、Lunaは最大労力でDeepSWE 1.1で66.6%のスコアを出し、中程度の労力でのClaude Opus 5およびClaude Fable 5に匹敵し、Opus 5より93%、Fable 5より96%低いタスクあたりのコストで提供されます。AutomationBench 1.0.6では、高労力で前任モデルを5.4ポイント上回り、タスクあたりのコストは58%低いです。OSWorld 2.0オフラインでは、最大労力でGPT-5.6 Solの中程度の性能を10分の1のコストで上回ります。
これらはClaude Opus 5に対して測定されたベンダー数値であり、同日に出荷されたOpus 5.5のものではないため、方向性を示すものとして扱ってください。運用上の解釈としては、Lunaは適切に指定され、検証可能な作業の基準を満たす最も安価なモデルであり、「検証可能」が重要なキーワードです。
コストモデルを導入する前に検証する
スプレッドシートでの計算は仮説に過ぎません。実際のトラフィックでテストしてください。本番ペイロードの500リクエストサンプルを取り、それをLunaとSolの2つの環境で実行し、トークン数、レイテンシ、スキーマ適合性を記録します。
Apidogでは、モデルIDを環境変数として保存された1つのエンドポイントで、実際のペイロードのデータファイルに対してテストシナリオとして実行されます。3つのアサーションを追加すると、このスイートは正確性チェックではなくコストのガードレールになります。応答がJSONスキーマに一致すること、`usage.completion_tokens`がリクエストあたりの出力予算を下回ること、そして`usage.prompt_tokens_details.cached_tokens`がゼロでないことをアサートします。これにより、キャッシュヒット率を損なうプレフィックスのリファクタリングが、翌月の請求書に現れるのではなくCIで失敗するようになります。これらの使用量フィールド名をアサートする前に、現在のAPIリファレンスと照合して確認してください。
この最後のアサーションは、誰も書かないが誰もが必要とするものです。大容量のLLMワークロードの障害モードは、ほとんどの場合、停止ではありません。それは、緑色のダッシュボードの裏で4倍の請求書が届くことです。
Lunaの料金が、GPT-6 SolやClaude Opus 5.5と週を通してどのように比較されるかについては、2026年9月のAIモデル価格戦争の内訳をご覧ください。
要約
大量で、適切に指定され、プログラムで検証可能な作業はLunaにルーティングし、プロンプトの安定した部分をバイト単位で同一に保ちます。出力トークンは入力の5倍の料金がかかるため、上限を設けます。キャッシュヒット率を本番メトリックとして測定します。自身のトラフィックで最初のトークン時間を測定するまでは、高負荷な作業を同期パスから外します。これらを実行すれば、計算が合わずにリリースされなかったジョブも、今週中に再度コストを検討する価値があります。