
GPT-6 Astra は、Qwen3.5-0.8B の MATH-500 スコアを、一切のトレーニングなしで 7.9% から 48.1% へと引き上げた。モデルの重みを読み取り、モデルが思考の中でループに陥る原因となる 1 つの方向を見つけ出し、それを 2 つの MLP 層から差し引いたのだ。この編集が触れた重みは 131,072 個、モデル全体の 0.016% にあたる。数値は MIT CSAIL の 4 名の研究者による 11 月 2 日の投稿に基づいており、編集済みモデルは公開されているので、この主張は自分で確認できる。
以下では、重み空間プログラミングとは何か、Astra が何を変更したのか、この手法がどこで通用しなくなるのか、そしてコーディングエージェントに Apidog CLI で両方のモデルを比較させる方法を説明する。
重み空間プログラミングとは何か?
重み空間プログラミングとは、汎用 LLM がニューラルネットワークの重みを直接読み書きする手法であり、平易な言葉で書かれた目標に導かれ、勾配降下もトレーニングループも用いない。モデルはネットワークの各部分が何を計算しているかを推論し、プログラマーがソースコードを編集するように、数値を手作業で変更する。
この用語は、Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab による Sparks of Weight-Space Programming(2026 年 11 月 2 日公開)に由来する。著者らはすべての結果を「非常に初期段階」と呼んでおり、いくつかは 1 回か数回の実行から得られたものだ。編集を行っているモデルの背景については、GPT-6 Astra ハンズオンレビューを参照のこと。
GPT-6 Astra が Qwen3.5-0.8B をどう修正したか
目玉となる結果は実験 8 である。研究者たちは GPT-6 Astra に対し、重みを編集することで Qwen3.5-0.8B を数学でより優れたものにするよう求めた。以下が順を追った経緯である:
- セットアップ。 Astra には、モデルの重みが読み込まれた Python セッション(ノートブックのようなもの)、GPU なし、そしてトレーニングセットから 7,469 問の GSM8K と 7,275 問の MATH 練習問題が与えられた。テストセットは一切見ていない。
- 予算。 トレーニングの代わりに、Astra は 10、25、または 50 回のフォワードパスを費やすことができた。1 回のフォワードパスで、モデルは最大 512 問に回答するか、最大 1,024 件のテキストを読むことができた。
- 診断。 Astra はベースモデルがループしていることに気づいた。最初の 96 件の練習回答のうち 85 件が、答えに到達することなく 32,768 トークンの上限まで走り続けた。著者らは、Qwen 自身のモデルカードがこのモデルは思考ループに陥りやすいと警告していることを指摘している。
- トレース。 Astra はループの原因を、層 15 と層 19 の MLP が書き出す 1 つの方向に突き止めた。
- 編集。 それは、2 つの層それぞれの
down_projの 64 個の出力列からその方向を差し引いた。これは 8 億個のうちの 131,072 個の重みにあたる。
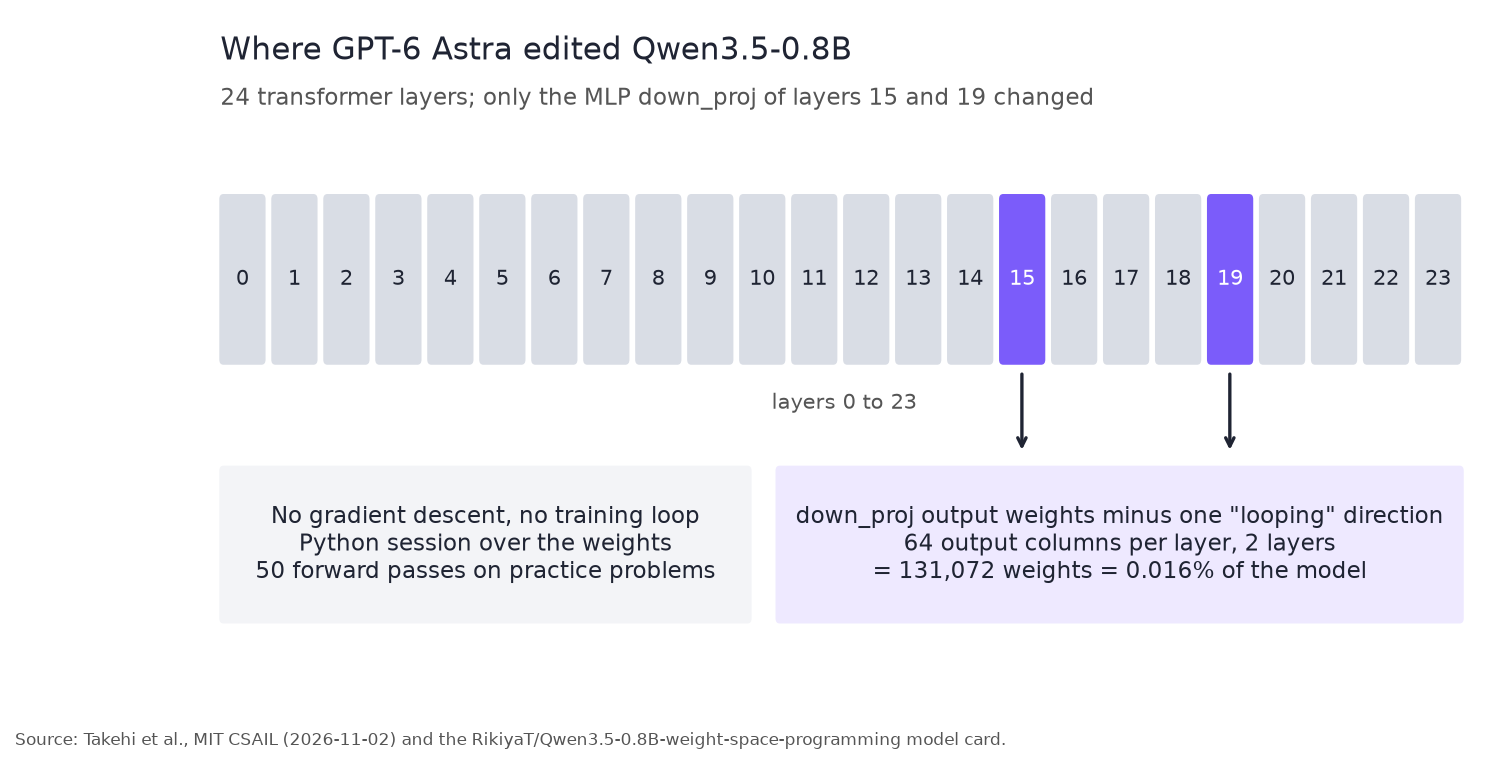
Hugging Face のモデルカードによれば、ベースの Qwen/Qwen3.5-0.8B チェックポイントと異なるのは、これら 2 つの down_proj テンソルのみであり、再構築された各テンソルは、著者らが評価したものと sha256 で検証されている。編集済みモデルは Apache 2.0 の下で配布されている。
結果:ベース版と編集済み Qwen3.5-0.8B の比較
ここに示す数値はすべて著者らの投稿によるものである(thinking オン、最大 32,768 トークン、各問題につき複数サンプル)。「トークン上限到達」は、トークンを使い果たした MATH-500 の回答の割合である。
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | トークン上限到達 |
|---|---|---|---|---|
| ベース | 7.9% | 13.8% | 21.0% | 93.0% |
| 編集済み、10 フォワードパス | 12.3% | 25.7% | 49.0% | 87.2% |
| 編集済み、25 フォワードパス | 14.1% | 25.1% | 39.9% | 86.4% |
| 編集済み、50 フォワードパス | 48.1% | 67.1% | 62.3% | 33.1% |
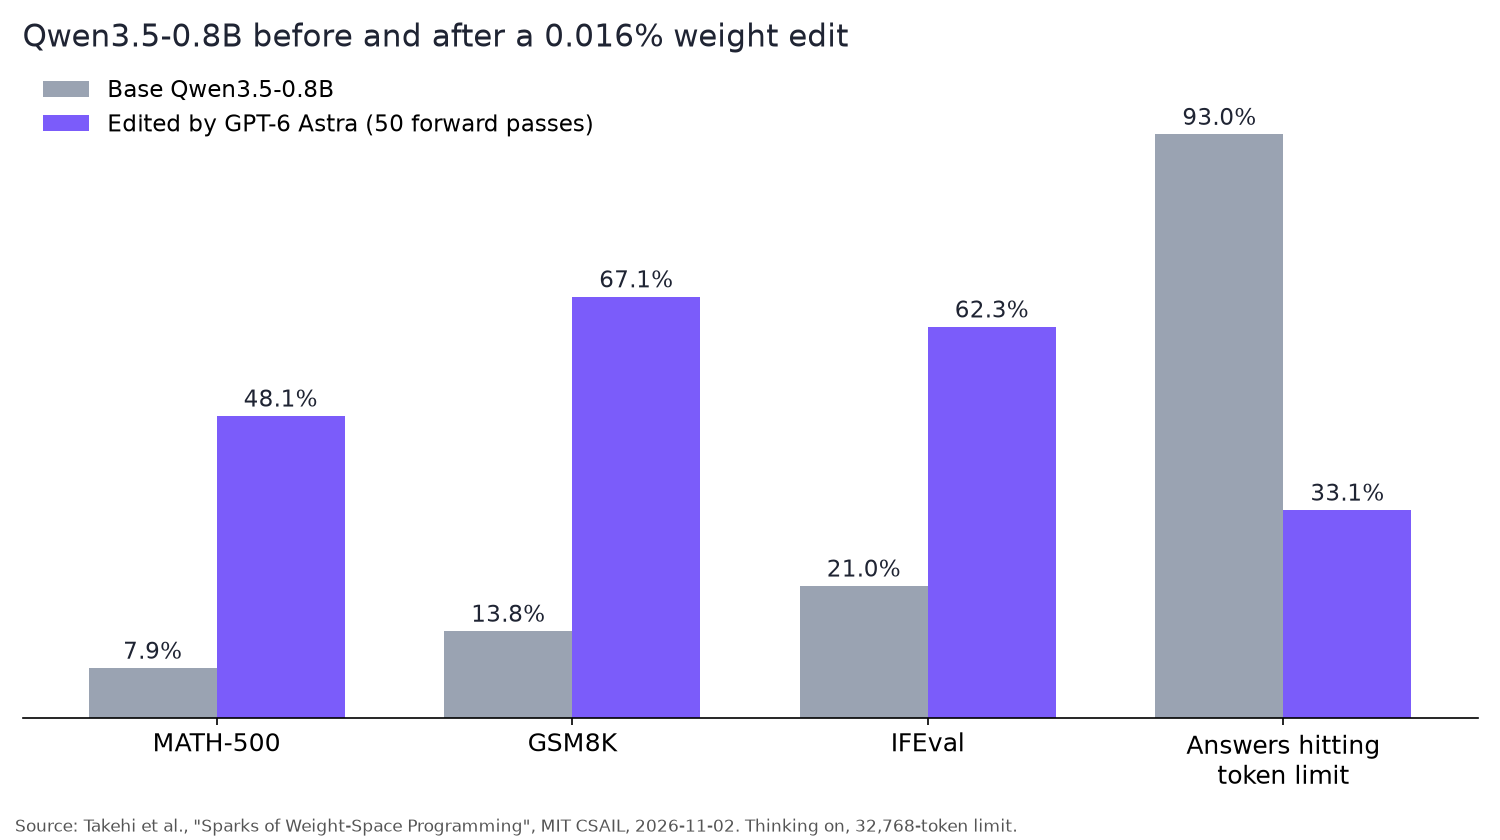
- 修正は汎用化した。 ループは数学に特有のものではないため、IFEval もおよそ 3 倍になった。
- 予算が重要だった。 10 回または 25 回のフォワードパスでは、ループはほとんど解消しなかった。
- 第三者が再現した。 Hugging Face の Ahsen Khaliq がログからチェックポイントを再構築し、MATH-500 全体(500 問、各 4 サンプル)を再実行した。編集済みモデルは 51.0% を記録し、回答の 31.6% が上限に到達した。ベースモデルの 25 問のスモークテストでは 5.0% だった。
デモ Spaceでは、問題を入力して両方のモデルの回答を見ることができる。
重みの編集にできないこと
著者らは、目玉の結果よりも重要な対照実験を行った。彼らは同じアプローチを Gemma 3 270M に試した。これはループをほとんど起こさないモデルである(回答の 8.5% が上限に到達したのに対し、Qwen は 93% だった)。
| Gemma 3 270M | MATH-500 |
|---|---|
| ベース | 6.8% |
| 最良の編集(25 フォワードパス) | 7.7% |
Gemma の誤りは、計算間違いのようなごく普通のもので、オフにできる単一の要素は存在しなかった。著者らの結論はこうである:編集は、能力を隠していた障害物を取り除くことはできたが、モデルが持っていない能力を加えることはできなかった。Qwen はすでに多くの答えを導き出せていた。ただ、それを最後まで終わらせることができなかっただけである。
つまりこれは「トレーニングは終わった」という話ではない。フロンティアモデルが、1 か所に存在する 1 つの失敗を見つけ出して取り除いた、ということである。
重み空間プログラミング論文の残りの内容
実験 8 は 8 つのうちの 1 つである。残りははるかに小さなネットワークを使用している:
- 重みの読み取り。 生の重みだけから、Astra は PPO でトレーニングされた 4 つのゲームポリシーのうち 4 つすべてでゲーム名を特定し、3 つの小さな文字レベルの言語モデルのうち 3 つすべてでトレーニング言語を特定した。
- ポリシーの修正。 256 エピソード中 256 エピソードで失敗した Kinetix の車ポリシーが、Astra が 1 回の返信で重みの 3.5% を編集した後、1,024 エピソード中 1,024 エピソードで成功した。
- 重みをゼロから書く。 Astra は MinAtar Breakout の重みを書き、5 億ステップトレーニングした PPO の 25.3 に対して 517.4 を記録した。Seaquest では 88.9 に対して 53.1 で負けた。
- 囲碁。 ゼロから 148 万重みの 9x9 囲碁ネットワークを書き、50 回のフォワードパスで、同サイズの PPO ネットワークを打ち負かした。
- 失敗例。 重みだけからでは、2 つの Gemma 3 270M のコピーのうちどちらがお世辞を言うようにトレーニングされたかを判別できなかった。アテンションパターンにアクセスできる場合、3 つのペアすべてでお世辞モデルを選び当てた。
完全な実験ログには、すべてのプロンプト、Astra の推論サマリー、実行したすべてのコードが含まれている。
Qwen3.5-0.8B の思考ループ修正を自分で確認する
最もクリーンなテストは、両方のチェックポイントを同じ OpenAI 互換 API の背後で提供し、同一のプロンプトを送ることである。vLLM なら、モデルごとに 1 つのコマンドでこれを実現できる:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
両方のサーバーは qwen という名前で応答するので、1 つのリクエストボディがどちらのポートでも機能する。--max-model-len 34816 はモデルカードの例と一致している。
各リクエストは著者らのサンプリング設定を反映し、thinking をオンにする:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
最後の \boxed{} の値が答えであり、finish_reason はモデルが停止したか(stop)トークンを使い果たしたか(length)を示す。length での終了はループである。
GPU を動かしたくない場合は、GPT-6 Astra API を同じ方法でテストするか、無料の Qwen3.5 Ollama セットアップで小さな Qwen モデルをローカルで比較できる。
コーディングエージェントに Apidog CLI で両方のモデルをテストさせる
20 件の長い生成を手作業で採点するのは、コーディングエージェントの仕事である。Apidog CLI は、エージェントに環境、テストシナリオ、データ駆動型実行、レポートを提供し、あなたのマシン上で動作するので、localhost のエンドポイントも機能する。
インストールして、エージェントにスキルを与える:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、Claude Code、Codex、Cursor、または OpenCode に 1 つのプロンプトを与える:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
エージェントはペイロードのスキーマを読み取り、その JSON を検証してから、以下のコマンドを実行する:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d は CSV の各行を 1 回のイテレーションとして供給する。--timeout-request はミリ秒単位で、ループする回答は 32,768 トークンを使い切るのに数分かかることがある。-r cli,json はサマリーを出力し、エージェントが差分を取れる JSON レポートを書き出す。10 問は GSM8K テスト分割から取られている。
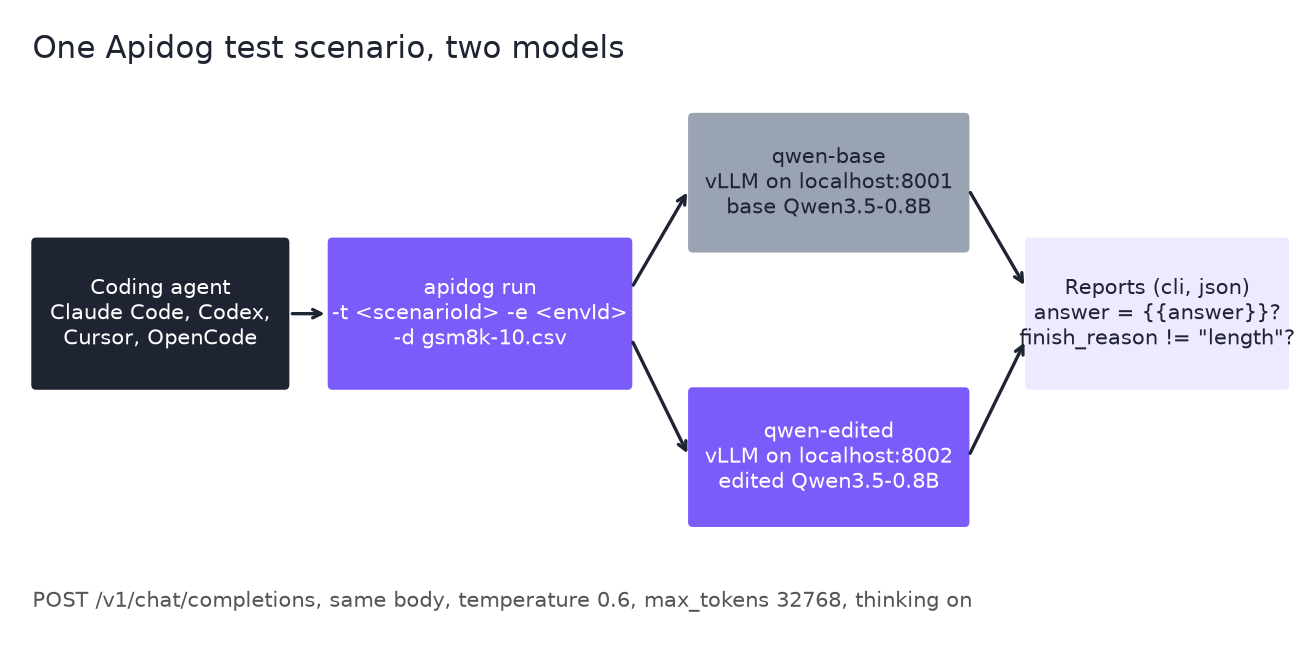
もしあなたの実行結果が著者らのものと似ているなら、大半のベース回答は finish_reason のアサーションに失敗し、大半の編集済み回答はそれを通過するはずである。10 問はベンチマークではなくスモークテストなので、差をスコアではなくシグナルとして扱うこと。アプリで実行を表示するには --upload-report を追加し、すべてのフラグについては apidog run コマンドリファレンスを参照のこと。
同じシナリオは、あらゆるモデル入れ替えに対する回帰テストとして機能する。Apidog CLI CI/CD ガイドでは -r junit のセットアップを示している。
小さなモデルをリリースする場合、これが意味すること
- 精度だけでなく打ち切りを測定せよ。 Qwen の 7.9% は、ほとんど決して終わらないモデルを隠していた。
finish_reasonのチェックがそれを見つける。 - 単一原因の失敗を探せ。 ループや繰り返しは、ネットワークの狭い一部に存在しうる。
- 対照実験を忘れるな。 あなたのモデルが行き詰まっているのではなく間違っているなら、このような編集は役に立たない。
エージェント作業用の GPT-6 ティアをお探しなら、GPT-6 Luna vs Sol vs Astra を参照のこと。
FAQ
GPT-6 Astra は Qwen3.5-0.8B をトレーニングしたのですか? いいえ。著者らは勾配降下もトレーニングループも許可しませんでした。Astra は Python セッションで重みを編集し、モデルを 10、25、または 50 回のフォワードパスを通してのみ観察しました。
この編集で何個の重みが変更されたのですか? 131,072 個の重みで、著者らはこれをモデルの 0.016% としています。変更は層 15 と層 19 の MLP の down_proj 行列にあり、それぞれ 64 個の出力列です。
編集済みモデルは入手できますか? はい、Hugging Face 上で RikiyaT/Qwen3.5-0.8B-weight-space-programming として Apache 2.0 の下で入手可能で、変更された 2 つのテンソルのハッシュと、独立した再実行結果(MATH-500 で 51.0%)が付属しています。
なぜ数学のスコアがこれほど急上昇したのですか? ベースモデルがループしていたからです。MATH-500 では、その回答の 93.0% が 32,768 トークンの上限に到達しました。この編集によりそれが 33.1% に削減され、モデルはすでに導き出せていた答えを最後まで終わらせられるようになりました。新しい数学を学んだわけではありません。
重み空間プログラミングはどんなモデルでも機能しますか? 著者ら自身の説明によれば、まだそうではありません。ループをほとんど起こさない Gemma 3 270M では、最良の編集でも MATH-500 は 6.8% から 7.7% にしか動きませんでした。著者らは自分たちの結果をすべて非常に初期段階のものと呼んでいます。
コードを書かずに編集済みモデルをテストできますか? はい。Hugging Face のデモ Space では、あなたが入力した問題に対して両方のモデルを実行します。再現可能なチェックには、上記のように vLLM と Apidog CLI を使用してください。