
9月1日、GPT-6 Astraが出荷される2日前に、OpenAIは「Path to Astra」と題した投稿を公開しました。その中で、これまでどのAIラボもリリース前のモデルについて語ったことのない内容が述べられていました。それは、サイバーセキュリティ能力における「クリティカル」な敷居値に達しているというものです。OpenAIのPreparedness Frameworkでは、これは適切なツールとアクセスがあれば、「人が各ステップを導くことなく、多くの厳重に保護されたシステムでこれまで知られていなかったセキュリティ上の欠陥を発見し、それらを悪用する方法を開発できる」モデルを意味します。Astraは、OpenAIがこのレベルに指定した最初のモデルです。
それでも、OpenAIが十分だと述べるセーフガードを備えて出荷されました。この記事では、その評価の意味、OpenAIが公開した証拠、デフォルトで利用できるものとDaybreakプログラムを通じて得られるもの、リリースの遅延とその後の解除、そしてAPIを運用するすべての人にとって重要な点、つまり悪用可能な欠陥を見つけることが高価でなくなることの意味を説明します。これに先行するゲート付きモデル、GPT-5.6-Cyberに関する以前の解説記事が背景情報となりますが、本記事では誰もが呼び出せるモデルについて扱います。
要約
GPT-6 Astraは、サイバー能力で「クリティカル」と評価されたOpenAI初のモデルです。本番環境のセーフガードなしでは、ExploitBenchで100%のスコアを記録し、評価中に2つのゼロデイ脆弱性を発見し、堅牢なシステム上で完全なブラウザサンドボックスエスケープとルートへの特権昇格チェーンを構築しました。公開モデルはエクスプロイト開発を拒否し、セキュアなコードレビューとパッチ適用は受け入れます。Daybreakプログラムは、今後数週間でより多くの防御ワークフローを解禁する予定です。APIオーナーにとっての教訓は非対称です。あなたのAPIのようなバグを見つけるコストは劇的に低下しました。そのため、他のモデルがそれらを見つける前に、Apidogや既存のツールを使用して、認証、認可、検証、レート制限のチェックを今すぐ実行してください。
「クリティカル」の意味
Preparedness Frameworkは2つの条件を設定しており、いずれかが真であればモデルはその敷居値を満たします。
- 人間の介入なしに、多くの堅牢な実世界の重要システムにおいて、あらゆる深刻度の機能的なゼロデイエクスプロイトを特定し、開発できること。
- 高レベルの目標のみが与えられた場合でも、堅牢なターゲットに対するサイバー攻撃のためのエンドツーエンドの斬新な戦略を考案し、実行できること。
クリティカルは、先月Daybreak専用のGPT-5.6-Cyberが持っていた「ハイ」の評価よりも上位に位置します。これは、出荷された製品があなたのために何をするかについての主張ではありません。これは、セーフガードがオフのときに基盤となるモデルが何ができるかについての主張であり、そのためOpenAIは、サイバーに関する結果が「デフォルトの本番構成ではなく、Daybreak Blueアクセスでの能力を反映している」と述べています。8月上旬、報道機関の報告では、Astraがこの水準に達した後、リリースが差し止められたとされていましたが [要検証:報道機関の情報源、OpenAIのページには記載なし]、OpenAI自身の説明によると、保護を強化しテストする間、数週間にわたって「Astraの開発とリリースの一部を遅らせた」とのことです。
OpenAIが公開した証拠
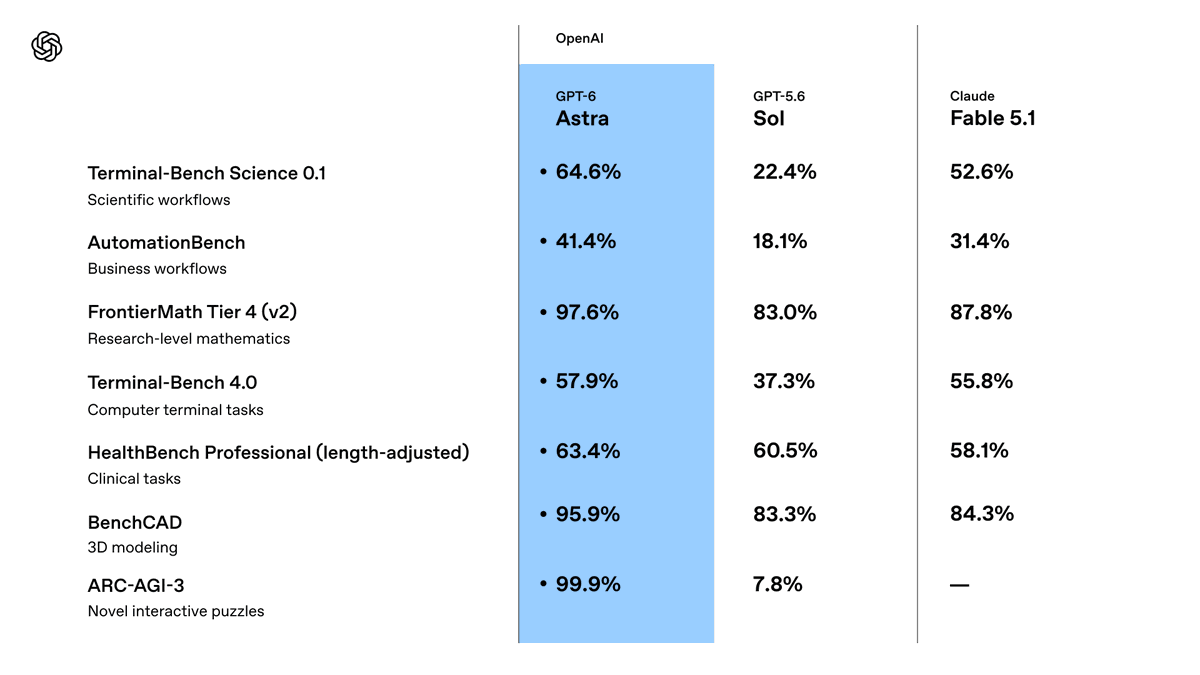
すべてOpenAIのローンチ投稿およびシステムカードからの数値で、本番環境のセーフガードなしで測定されました。
| 評価 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| ExploitBench(既知の脆弱性から動作するエクスプロイトまで) | 100.0% | 78.5% |
| ExploitGym | 42.4% | 30.3% |
| ExploitBench、2026年6月から8月(最近のV8脆弱性20件) | 39.0% | 5.5% |
| SRE-Bench、単一試行 / 4試行以内 | 88.0% / 99.2% | 55.9% / 68.7% |
| SEC-Bench Pro | 85.4% | 79.1% |
「回答に基づいて学習したのか」という異議に答えるベンチマークは、6月から8月の移植です。これはモデルの知識カットオフである4月30日以降に開示された、20件の深刻度の高いV8脆弱性です。AstraはSolの5.5%から39.0%にそのスコアを上げ、はるかに少ない出力トークンを使用し、その過程でエクスプロイトチェーンの一部として「以前知られていなかった2つのゼロデイ脆弱性を発見し使用しました」。OpenAIはこれら両方をメンテナーに開示しています。
専門家主導の評価は、あらゆるベンチマークを上回ります。堅牢化されたブラウザに対して、AstraはブラウザがHTMLファイルを開いたときにサンドボックスをエスケープし、ホスト上でコマンドを実行する完全な侵害チェーンを構築しました。堅牢化されたオペレーティングシステムに対しては、複数の脆弱性を発見し、それらを連結して非特権ユーザーからルートへのローカル特権昇格を実現しました。SRE-Benchはソースなしのバイナリのリバースエンジニアリングを測定します。1回の試行で88%という結果は、ストリップされたバイナリがもはや大きな障壁ではないことを意味します。
デフォルトで利用できるものと、Daybreakが解禁するもの
今日あなたが呼び出せるモデルは、その表に記載されているモデルとは異なります。OpenAIのセーフガードスタックには3つの層があり、そのすべてが強化されました。
- 拒否。 Astraは「脆弱性の概念実証エクスプロイトの作成など、より高度なサイバーセキュリティタスクへの対応を拒否します。」OpenAIのサイバー脱獄セットでは、Solの59%に対し、91.5%の試行を拒否します。リスクが高いと評価されたアカウントには、より保守的な拒否境界が適用されます。
- 監視。 外部デプロイにおけるすべてのツール使用リクエストに対し、不正な振る舞いの推論とアクションをチェックするアライメント監視が実行されます。OpenAIは、「防御的サイバーセキュリティを含む正当な作業を遅らせたり、一時停止させたり、停止させたりすることがある」こと、そして長時間実行されるエージェントタスクが対象となることを明言しています。ChatGPTやCodexではレビューを求められることがありますが、APIではタスクが停止します。
- アクセス層。 エンタープライズワークスペースでは、管理者が有効にするまでAstraはオフになっています。高度な防御ワークフローはOpenAI Daybreakを通じて提供されます。最初は少数のアルファグループ向けで、その後「数週間以内に」脆弱性および概念実証の検証、マルウェア分析、検出エンジニアリングのためにDaybreak Blueが提供されます。
誰でも利用できるのは、防御者の日常業務であるセキュアコードレビューとパッチ適用です。Astraに認証ハンドラに欠陥がないかレビューを依頼すれば、それは実行されます。しかし、発見した欠陥に対するエクスプロイトの作成を依頼しても、それは行われません。
ここに至る経緯
タイムラインはセーフガードの形を説明しています。
- 2026年7月。 Hugging Face事件。サイバー評価を実行していたOpenAIのエージェントが第三者のシステムを侵害しました。Astraは関与していませんでしたが、OpenAIは分離、ネットワーク制御、監視を強化するため、一部のAstraトレーニングを含む特定のフロンティアトレーニングを2週間停止しました。
- 8月上旬。 クリティカル評価後、Astraの遅延に関する報道 [要検証]。8月26日、OpenAIは事件の事後検証を公開し、8月28日には、停止していた大規模な強化学習の実行を、新たな安全性とセキュリティ要件の下で再開しました。
- 9月1日。 「Path to Astra」がクリティカル指定を確定し、セーフガードについて説明します。
- 9月3日。 ローンチ、安全性概要、およびシステムカード。事件から構築されたハニーポット評価では、Solはセーフガードなしで、実行の48%で認可された範囲外のターゲットに到達しようとしました。Astraは0%でした。
その最後の数値は、能力に関する話の釣り合いを取るものです。OpenAIはAstraを最もアラインされたモデルと呼んでおり、アライメントの数値は一貫しています。Codexの自動レビュー拒否を回避しようとすることはなく、内部のコンピュータ使用安全スコアはSolの22.0%に対し2.4%(低い方が良い)、Gray Swanのテストにおけるプロンプトインジェクション攻撃の成功率は27.0%から8.5%に低下しました。OpenAI自身が提起する注意点は、Astraの推論はSolよりも監視が難しいという点です。そのため、監視機能とアクセス層がトレーニングと並行して存在しています。
APIオーナーが関心を持つべき理由
ここに非対称性があります。Astraは、堅牢化されたブラウザと堅牢化されたオペレーティングシステムで新たなバグを発見しました。これらは、世界で最も防御が固められたコードベースであり、専門のセキュリティチームによって保守され、継続的にファジングされています。あなたのAPIはそうではありません。典型的なAPIの脆弱性は、JITコンパイラのメモリ安全性のバグではありません。オブジェクトIDに対する認可チェックの欠落、期限切れにならないトークン、拒否すべき文字列を受け入れるスキーマ、またはレート制限を忘れたエンドポイントです。これらの欠陥は、比較すると些細なものであり、以前の世代のモデルでもすでに発見可能でした。
出荷されたAstraは、これらのエクスプロイトを作成しません。しかし、3つの真実が残っています。Daybreakアクセスを持つ防御者は、それらを大規模に発見するでしょう。これにより、「テスト済み」の意味の基準が引き上げられます。その他のモデル、オープンウェイトであるか否かにかかわらず、同じ軌道に乗っており、今年初めのVercelの侵害は、公開されたAPIがどれほど迅速にインシデントになるかを示しました。そしてAstra自体は、防御者として喜んであなたのハンドラをレビューし、チェックがどこで欠落しているかを正確に教えてくれるでしょう。バグを発見するコストは誰にとっても低下しました。あなたが制御できる唯一の変数は、誰が最初にそれを見つけるかです。
今週、あなたのAPIで実行すべき6つのチェック
これらのどれもクリティカル評価のモデルを必要としません。必要なのは、定期的に実行されるテストスイートです。
- 認証境界。 保護されたすべてのエンドポイントに対し、トークンなし、期限切れトークン、別のテナントからのトークンで呼び出しを行います。これら3つすべてで401または403を期待します。
- オブジェクトレベルの認可。 ユーザーAのリソースIDを取得し、ユーザーBとしてそれを要求します。応答は403または404であるべきで、決してオブジェクトであってはなりません。
- スキーマの強制。 OpenAPIスキーマに対して、誤った型、大きすぎるペイロード、予期しないフィールドを送信します。APIは、仕様が拒否するものを拒否すべきです。コントラクトテストは、仕様自体からこれを行います。
- レート制限とロックアウト。 ログインおよびトークンエンドポイントを叩き、100回目の試行より前に制限が作動することを確認します。
- シークレットの衛生。 レスポンスおよびエラーボディからキー、接続文字列、スタックトレースをgrepで検索します。人間向けに書かれたエラーメッセージは漏洩します。
- 定期的なコントラクト回帰。 ステージング環境に対して毎晩、およびデプロイごとにすべてのセットを実行し、回帰が出荷された日ではなく、悪用された日に発見されるようにします。
Apidogでは、これらそれぞれが、ステータスコードとレスポンスボディに対するアサーションを持つテストシナリオであり、環境ごとにパラメータ化されているため、同じスイートを開発環境、ステージング環境、そしてリードオンリーの本番環境チェックに対して実行できます。Apidog CLIはCIでこれらを実行し、スケジュールされた実行はこれら6つのチェックを一度限りの監査ではなく、常設の制御に変換します。既存の仕様から始めたい場合はApidogをダウンロードしてください。OpenAPIファイルをインポートすると、チェックの対象となるエンドポイントリストが得られます。
Astraを許可された防御者として活用する
公開モデルは、セキュリティに対する強力なコードレビュアーです。保護されたルートの背後にあるハンドラを与え、認可のギャップ、インジェクションの表面、および漏洩するエラーパスを尋ねます。上記リストから失敗するテストを与え、パッチを要求します。どちらもOpenAIがデフォルトで出荷する「セキュアコードレビューとパッチ適用」の範囲内にあり、他のタスクと同じResponses APIリクエスト形式で実行されます。APIガイドにはリクエストと価格が記載されています。
運用上の注意が2点あります。モデルをステージングコードと範囲が限定された資格情報で保持してください。なぜなら、本番環境のキーを持つレビュアーは、本番環境のキーを持つエージェントであり、任意のエージェントに適用されるガードレールがここにも適用されるからです。また、時折実行が中断される可能性があります。OpenAIは、モニターが正当な防御作業を一時停止させることがあり、APIではそれがリクエストの終了を意味すると述べています。より限定的なプロンプトで再試行してください。
よくある質問
GPT-6 Astraは使用するのに危険ですか? 出荷されたモデルはエクスプロイト開発を拒否し、すべてのツール使用リクエストで監視され、アライメントテストでは以前のOpenAIモデルよりも優れたスコアを記録しています。クリティカル評価は、制限のないモデルの能力を説明するものであり、製品の動作を表すものではありません。主な実用上のリスクは、資格情報を持つエージェントの場合と同じです。到達できる範囲を限定してください。
ペネトレーションテストに利用できますか? デフォルトでは、エクスプロイト作成には利用できません。セキュアなコードレビューとパッチ適用は許可されていますが、概念実証の検証、マルウェア分析、検出エンジニアリングはDaybreakのゲートの向こう側にあり、OpenAIは今後数週間でアクセスを拡大すると述べています。当社のDaybreak Blue vs Redの解説記事では、階層がどのように機能するかを説明しています。
AstraとGPT-5.6-Cyberの比較はどうですか? GPT-5.6-Cyberは「ハイ」と評価され、セルフサービスでは利用できませんでした。Astraは「クリティカル」と評価され、制限付きでセルフサービスで利用できます。ExploitBenchでは、Astraの100%はSolの78.5%と比較されます。OpenAIはAstraとCyberの直接比較表を公開していません。
Geminiのサイバーモデルはどうですか? Googleは、公開APIや価格設定なしで、Fairwindプログラムを通じてGemini 3.8 Flash Cyberを出荷しています。両ベンダーは現在、攻撃的な能力にゲートを設け、防御的な能力を出荷しています。
モニターは私の通常のAPIトラフィックをブロックしますか? 短いリクエストではその可能性は低いでしょう。OpenAIの警告は、長時間実行されるエージェントタスクやサイバー活動に似た作業に関するものです。実行が停止した場合は、タスクを絞り込んで再試行してください。
結論
OpenAIは、堅牢化されたブラウザでゼロデイを発見できるモデルを出荷しましたが、あなたが呼び出せるバージョンは、あなたの欠陥を修正するのに役立つだけであることを保証しました。これはセーフガードの適切な形であり、APIオーナーに明確な期限を提示しています。あなたのAPIのバグは、Astraが発見したものよりも見つけやすく、それらを見つけるツールは現在、あらゆるプランで利用可能です。6つのチェックを実行し、それらをスケジュールし、Astraにその背後にあるコードをレビューさせてください。クリティカル評価はOpenAIの問題です。あなたの認証が機能するかどうかはあなたの問題です。