
GPT-6.1 Terraは、レートカードのどの項目でもGPT-6.1 Solの半額です。100万トークンあたり$1/$5に対し、$2/$10となっています。OpenAIによれば、Terraはタスクを平均で3倍以上の速さで完了します。Solは依然としてより強力なモデルであり、Artificial AnalysisのCoding Agent Indexで6ポイント差(54対48)をつけており、OpenAI自身も最も複雑なコーディングや深い調査にはSolまたはGPT-6 Astraを推奨しています。
つまり問題は、どちらが優れているかではありません。あなたのワークロードがその差を必要とするかどうかです。この比較では、スペック、価格、ベンチマーク、APIの違いを並べて示し、最後にそのまま使えるルーティングルールを提示します。各モデルの背景については、GPT-6.1 Terraとは何かとGPT-6.1 Solとは何かをご覧ください。
並べて比較
| GPT-6.1 Terra | GPT-6.1 Sol | |
|---|---|---|
| APIモデルID | gpt-6.1-terra |
gpt-6.1-sol |
| リリース日 | 2026年10月26日 | 2026年9月29日(DevDay) |
| 入力 / キャッシュ / 出力(100万あたり) | $1.00 / $0.05 / $5.00 | $2.00 / $0.10 / $10.00 |
| キャッシュ書き込み、30分 | $1.25 | $2.50 |
| コンテキストウィンドウ | 1,050,000 | 1,050,000 |
| 最大入力 / 出力 | 922,000 / 128,000 | 922,000 / 128,000 |
| 推論エフォート | noneからmaxまで |
lowからmaxまで(noneなし) |
| エンドポイント | Responses、Chat Completions、Batch | Responses、Chat Completions、Batch |
| 速度(OpenAI) | 平均で3倍以上高速 | ベースライン |
| OpenAIによる位置づけ | 高速で効率的:ライティング、視覚的理解、コンピュータ操作 | 難易度の高いコーディングと調査に強いオールラウンダー |
価格は、入力トークン272Kまでのプロンプトに対するStandard料金で、OpenAIの料金ページによるものです。両モデルは同じ長文プロンプトのルールを共有しています。272K入力トークンを超えると、リクエスト全体が入力とキャッシュ料金の2倍、出力の1.5倍で課金されます。
価格:Terraはちょうど半額
Terraのすべての料金はSolの半額です。これによりコスト比較は単純になります。同じトークン数であれば、Terraは50%安く済みます。100,000トークンのキャッシュ済みプレフィックス、8,000の新規入力トークン、2,000の出力トークンを使うエージェントの1ステップを考えてみましょう:
| GPT-6.1 Terra | GPT-6.1 Sol | |
|---|---|---|
| キャッシュ入力(100K) | $0.0050 | $0.0100 |
| 新規入力(8K) | $0.0080 | $0.0160 |
| 出力(2K) | $0.0100 | $0.0200 |
| 1回あたり | $0.0230 | $0.0460 |
| 10,000回あたり | $230 | $460 |
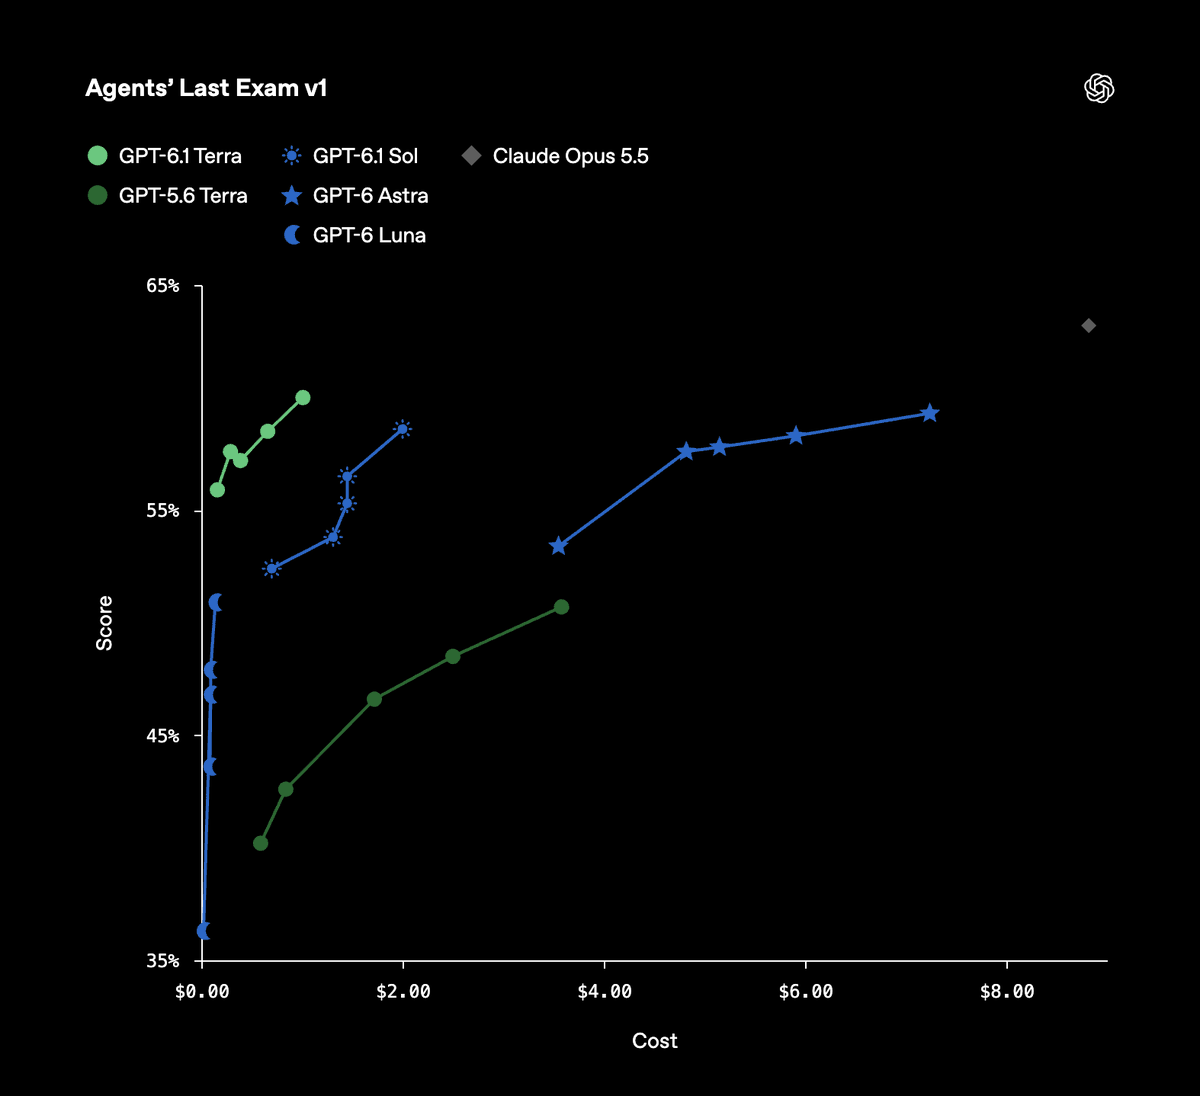
実際にはトークン数は同一にはなりません。より長く推論するモデルは、より多くの出力を消費します。しかしTerraが高速であることは、余分なトークンで速度を買っているわけではないことを示唆しています。Artificial Analysisは、そのスイートでmaxエフォートのTerraについてタスクあたり$0.40と計測しました。GPT-6.1 Terraの価格ガイドには、完全なレートカードとBatch、Flex、Fastの各バリアントが掲載されています。
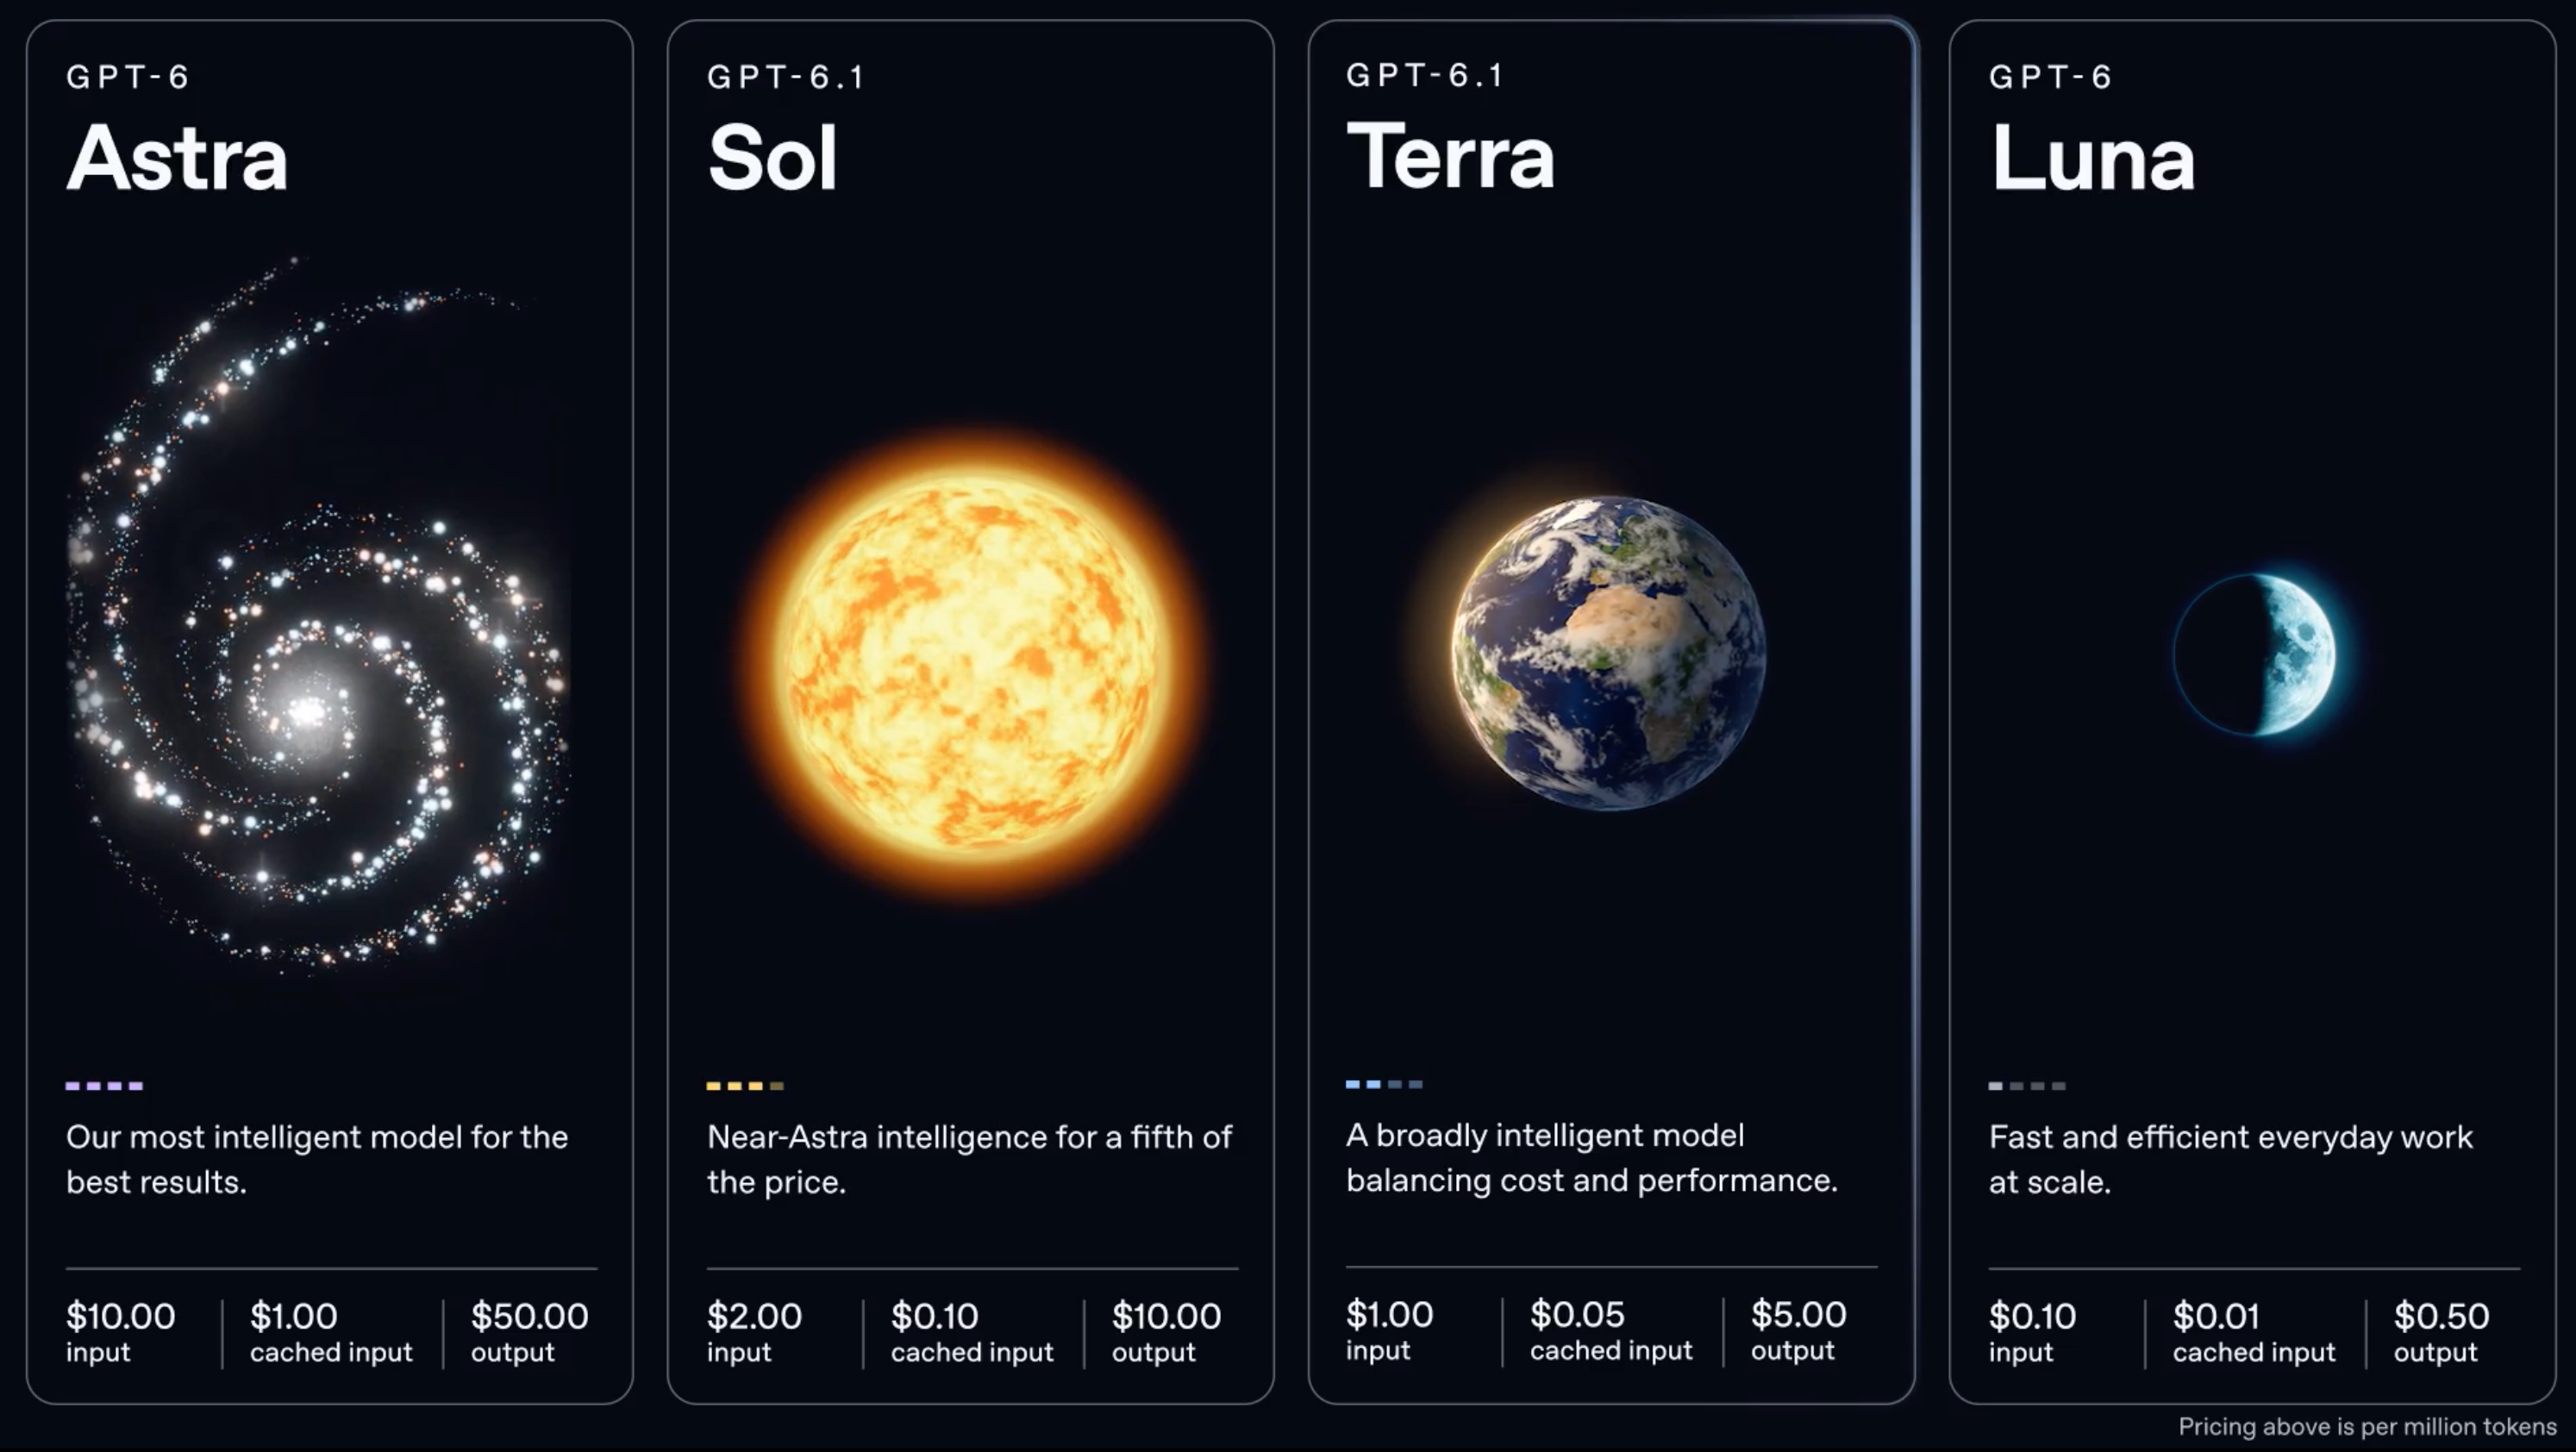
もう1つのデータポイント:FastモードのTerraは$2/$10で、ちょうどSolのStandard価格と同じです。Solの価格を支払っているなら、Solの追加能力と、より高速なTerraのどちらかを選べるということです。
ベンチマーク:わずかな差
| ベンチマーク | GPT-6.1 Terra | GPT-6.1 Sol | 出典 |
|---|---|---|---|
| Coding Agent Index v2.0 | 48 | 54 | Artificial Analysis |
| Intelligence Index、maxエフォート | Solより4ポイント低い | ベースライン | Artificial Analysis |
| Terminal-Bench 4.0、maxエフォート | 50.3% | maxのTerraと互角 | OpenAI、Artificial Analysis |
| Agents' Last Exam | OpenAIによればGPT-6 Astraと同等 | 該当なし | OpenAI |
| タスク速度 | 平均で3倍以上高速 | ベースライン | OpenAI |
数値はOpenAIの発表資料とArtificial Analysisによるものです。Artificial Analysisは、TerraのTerminal-Bench 4.0スコアがmaxエフォートにおいてGPT-6.1 Solに「今や互角に迫る」と述べています。すべてのベンチマークについて両モデルのスコアを同じチャートで公開している情報源は見つからなかったため、この表は差の方向性と大きさを示すものとして扱い、正確な順位付けとは考えないでください。
傾向は情報源をまたいで一貫しています。最も難しいエージェント的コーディング作業では、Solが1桁台の差でリードしています。ターミナルタスクや一般的なエージェント作業では、Terraは近い位置にあります。規模感を示すと、同じIntelligence IndexでTerraはGPT-6 Lunaより10ポイント上にあるため、SolからTerraへの段差は、TerraからLunaへの段差の半分未満です。
信頼性
Terraの最大の単一改善点はハルシネーションです。Artificial Analysisは、そのAA-Omniscienceテストで38%のハルシネーション率を計測しました。これはGPT-5.6 Terraの88%からの低下です。OpenAIの社内事実性テストでは、maxエフォートでのTerraのエラー率は4.3%で、OpenAIはこれがGPT-6 AstraとGPT-6.1 Solに「ほぼ」匹敵すると述べています。lowエフォートでは16.7%です。
重要な点:高エフォートでは、OpenAIのテストにおいてTerraとSolは同程度の割合で事実誤りを犯します。Solの優位性はより難しい推論にあり、基本的な正確性にあるのではありません。
コードに影響するAPIの違い
ほとんどのコードは、モデルIDを変えるだけでどちらのモデルでも動作します。重要な違いは3つあります:
noneエフォート。Terraはreasoning.effort: "none"をサポートしていますが、Solはサポートしていません。OpenAIのコミュニティフォーラムのある開発者によると、Terraでnoneを使うとtemperatureとtop_pも設定できるようになります。6.1 Solでnoneが廃止されたために分類ジョブをGPT-6 Solから移行したのであれば、Terraはそれを取り戻してくれます。- キャッシュの経済性。キャッシュ入力はTerraが$0.05、Solが$0.10です。長いプレフィックスを再利用するエージェントは、Terraで比例してより多く節約できます。
- 速度に敏感なロジック。UIがユーザーにストリーミングする場合や、エージェントが多数の逐次ステップを実行する場合、Terraの速度は体験を変えます。OpenAIの3倍という数値は同社のタスク全体の平均なので、ご自身で計測してください。
どちらもResponses API上の同じホスト型ツールをサポートしており、computer_use、web_search、file_search、code_interpreter、mcpを含みます。GPT-6.1 Terra APIガイドとGPT-6.1 Sol APIガイドで、それぞれのセットアップを扱っています。
ChatGPTとCodexでの利用
どちらも有料プランのChatGPT WorkとCodexで利用でき、FreeやGoにはありません。Terraについて、OpenAIはPlus、Pro、Enterprise、Eduを挙げています。実用的な違いは使用量です。OpenAIによれば、WorkとCodexの許容量はGPT-6.1 SolやGPT-6 AstraよりもTerraのほうが「はるかに」長持ちします。SolでCodexの上限に達しているなら、定型的なタスクをTerraで実行する(codex -m gpt-6.1-terra、Codex CLI 0.159.0以降)ことで、同じプランを使い伸ばせます。Codexの使用量上限ガイドで許容量の仕組みを説明しています。
どちらを使うべきか?
GPT-6.1 Terraを使うべき場面:
- コンピュータ操作:アプリをクリックして操作し、画面を読み取り、フォームに入力する。これが代表的なユースケースです。
- ライティングや下書き、要約、返信。
- 通常難易度のコーディングタスク:単一ファイルの変更、テスト、スクリプト、レビュー。
- 多数のステップがあるエージェントループ。1ステップあたりの速度とコストが積み重なります。
- Lunaでは足りない抽出や分類。特に
noneエフォートを使う場合。
GPT-6.1 Solを使うべき場面:
- 大規模な複数ファイルにまたがるリファクタリングやアーキテクチャ作業。
- 1つの誤ったステップが結果を台無しにする長い調査チェーン。
- Terraがすでに失敗したタスク。OpenAI自身、最も難しいコーディングはSolまたはAstraへと導いています。
うまく機能するルーティングルール:デフォルトはTerraとし、タスクがチェックに失敗した場合や、難しいと分かっているカテゴリに該当する場合にSolへエスカレートします。価格が50/50の分割であれば、トラフィックの3分の1をSolに送っても、全量をSolで処理した請求額の約3分の2で済みます。ラボをまたいで比較する場合は、GPT-6.1 Sol vs Claude Sonnet 5.5の解説が$2/$10の価格帯を扱っています。
Apidog CLIでコーディングエージェントに比較を実行させる
ベンチマークは他人のタスクについて教えてくれるものです。最も速い決め方は、自分のプロンプトを両モデルで実行して比較することで、コーディングエージェントならApidog CLIでそれができます。
まず一度セットアップします:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
次に、Claude Code、Codex、Cursorのいずれかに1つのプロンプトを与えます:
In Apidog project <id>, create a test case for POST https://api.openai.com/v1/responses
that sends model {{MODEL}} at reasoning effort medium, iterating over the 20 prompts in
prompts.csv. Assert status 200 and that each output passes our JSON schema. Run it with
MODEL=gpt-6.1-terra and MODEL=gpt-6.1-sol against the <env> environment, then report
pass rate, average output tokens and estimated cost for each model.
エージェントはペイロードを検証し、ケースを作成し、同じデータで両モデルを実行します:
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "MODEL=gpt-6.1-terra" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "MODEL=gpt-6.1-sol" -r cli,json
あなたのプロンプトでTerraの合格率がSolと一致すれば、証拠とともに請求額を半減できたことになります。一致しなければ、失敗した行がどのタスクをSolにルーティングすべきかを教えてくれます。-r junitでこの比較をCIに組み込み(Apidog CLI CI/CDガイド)、どちらかのモデルが更新されるたびに再実行しましょう。CodexのセットアップについてはCodexでのApidog CLIをご覧ください。
FAQ
GPT-6.1 TerraはGPT-6.1 Solより優れていますか?いいえ。Solのスコアのほうが高くなっています(Artificial AnalysisのCoding Agent Indexで54対48)。Terraは価格が半額で、OpenAIによれば3倍以上高速です。
TerraはSolよりどのくらい安いですか?すべての料金でちょうど50%です。入力は$1対$2、キャッシュは$0.05対$0.10、出力は$5対$10です。
TerraとSolのコンテキストウィンドウは同じですか?はい。どちらも1,050,000トークンで、入力922,000、出力128,000です。
コーディングにはどちらが良いですか?OpenAIが推奨するように、最も難しい作業にはSolです。日常的なコーディングにはTerraで、ターミナルタスクでは半額で遜色ありません。
コードを変更せずに切り替えられますか?ほぼ可能です。モデルIDを変更してください。ただしreasoning.effort: "none"を使う場合、それはTerraでのみ動作します。
まとめ
GPT-6.1 Terraは、GPT-6.1 Solの能力のほとんどを、半額かつ待ち時間のほんの一部で手に入れられます。デフォルトはTerraにし、難しい裾野にはSolを残し、コミットする前にApidog CLIで自分のプロンプトにおいてエージェントにこの分割を証明させましょう。