
OpenAIは2026年7月9日にGPT-5.6の一般提供を開始しました。これにより最初に迫られる決断は、アップグレードするかどうかとは関係ありません。それはメニューの選択です。このリリースは、gpt-5.6-sol、gpt-5.6-terra、gpt-5.6-lunaという3つのモデルとして提供され、コストと性能の曲線上にある3つの異なる点に位置しています。高すぎるモデルを選ぶと、Terraで十分対応できる作業に対してSolの料金を支払うことになります。低すぎるモデルを選ぶと、Lunaが元々想定していないタスクでエージェントが停止してしまいます。
これらの名前には体系があります。数字は世代を示し、Sol、Terra、Lunaはそれぞれ独自のペースで進化する永続的なティア(段階)です。当社のGPT-5.6命名解説では、その構造を詳しく説明していますので、このガイドではその歴史を省きます。ここでお伝えするのは購入の意思決定についてです。各ティアが得意とすること、料金の落とし穴がどこに潜んでいるか、そしてローンチ日(提供開始日)のチャートに頼らず、独自のプロンプトで選択を決定する方法です。
30秒でわかる回答
| モデル | 100万トークンあたりの料金 | 選択すべき時 |
|---|---|---|
gpt-5.6-sol |
$5入力 / $30出力 | タスクが本当に難しい場合:エージェントによるコーディング、多段階のツール連携、深い調査 |
gpt-5.6-terra |
$2.50入力 / $15出力 | 他のほとんどすべて。本番環境の作業におけるデフォルト |
gpt-5.6-luna |
$1入力 / $6出力 | 量とレイテンシーが重要視される場合:分類、抽出、ルーティング、初期段階のドラフト |
Terraは賢明なデフォルト設定です。OpenAIはGPT-5.5と同等の性能を約半額で提供すると位置付けており、この位置づけがほとんどの実際のワークロードを決定します。先月ほとんどの本番アプリケーションで使われていたモデルクラスのコストが半額になったことを意味します。Solはそのプレミアム料金を、タスクが明確な性能差を示すほど十分に難しい場合にのみ正当化します。Lunaは、トークンあたりの料金を数百万のリクエストで乗算するような場合に最も有利です。
信頼するよりもテストしたいなら、それは良い直感です。3つのモデルはすべて同じResponses API呼び出しを受け入れるため、Apidogで各ティアに対して同じプロンプトセットを実行し、出力で議論を解決できます。セットアップには10分かかります。詳細は後述します。
各ティアの用途
3つのモデルはすべて、どのAPIアカウントでも利用可能です。アクセスはプランによる制限がなく、セルフサービスで、上記のモデルIDはOpenAIの開発者向けドキュメントから直接引用しています。初期のドキュメントによると、ファミリー全体で1Mトークンのコンテキストウィンドウ、128Kの最大出力、2026年2月16日のナレッジカットオフが報告されています。これらはOpenAIのモデルページがあなたのアカウントで確認されるまで、報告された数値として扱ってください。
Sol:困難な問題のための主力モデル
Solは深層推論ティアであり、ローンチ時のベンチマークでは予想通り、長期的な視点を持つエージェント的な作業においてその性能向上が集中しています。OpenAIによると、SolはAgents’ Last ExamでGPT-5.5の46.9点に対し約53点、Terminal-Bench 2.1で88.8%、OSWorld 2.0で47.5点から62.6点に上昇しました。これらはリリース初日の主張なので、あまり鵜呑みにしないでください。しかし、パターンは一貫しています。計画、ツール使用、エラー回復は、ルーチン的なテキストの品質よりもはるかに改善されました。
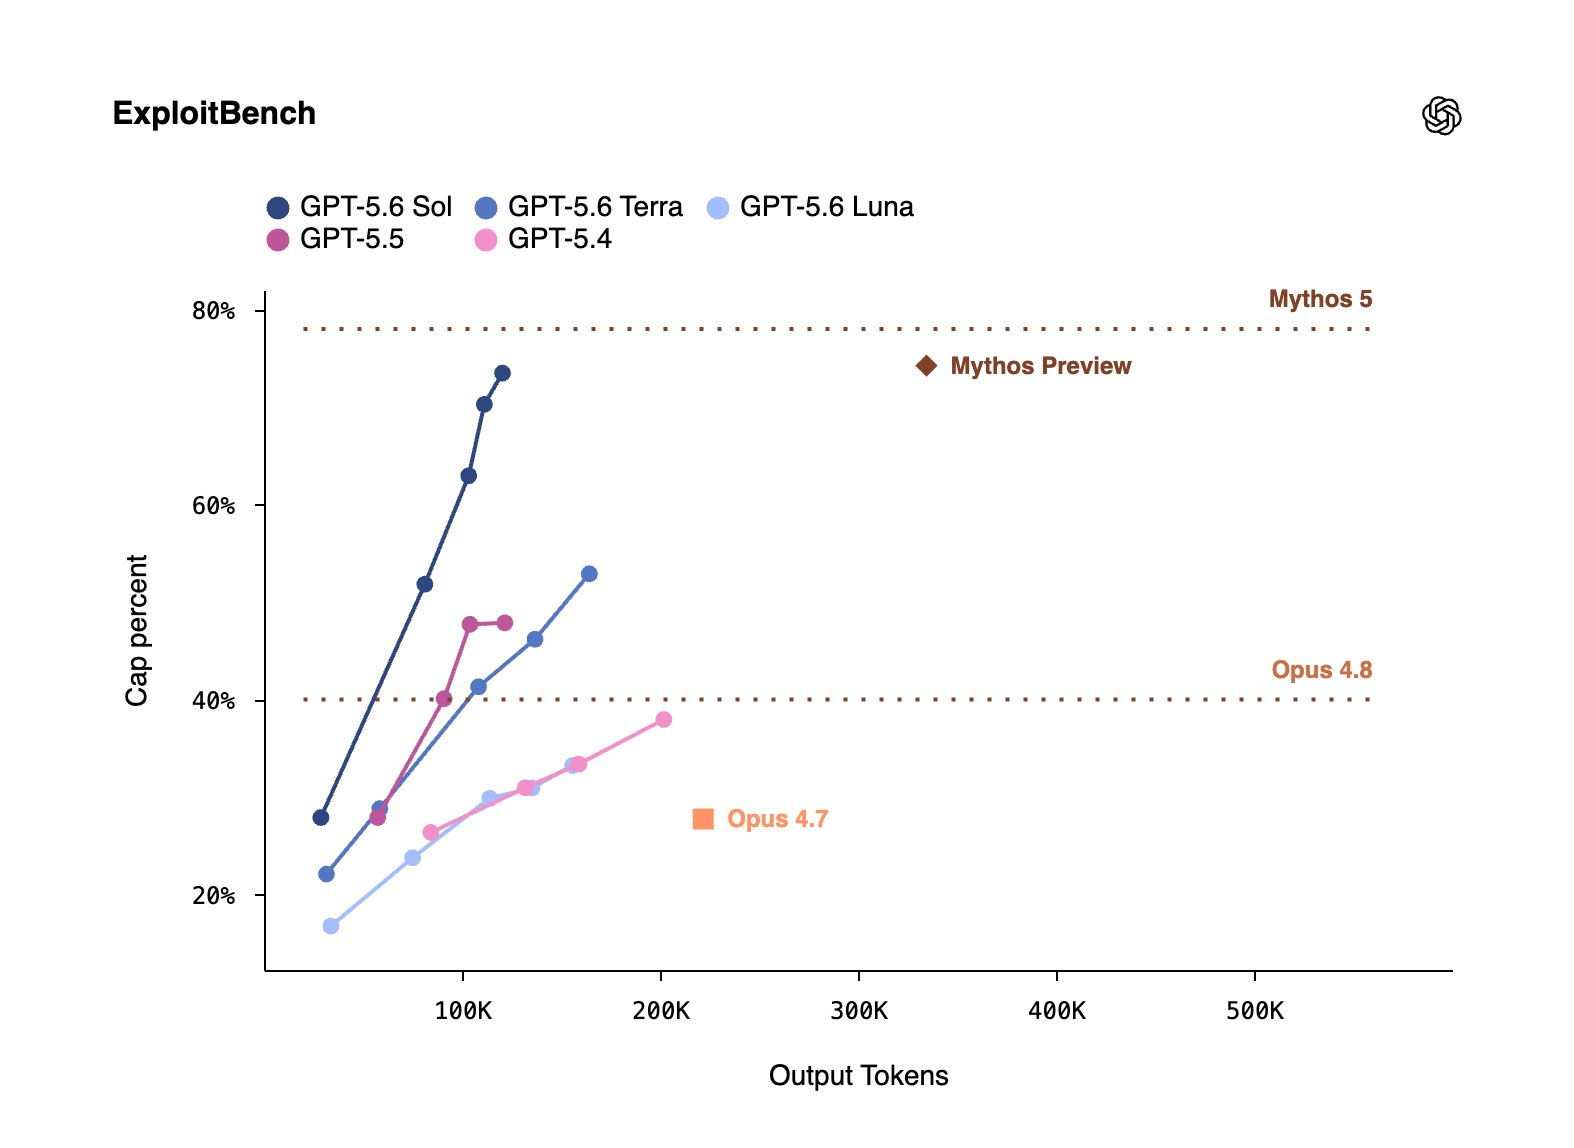
これは完璧な勝利ではありません。SWE-Bench Proでは、Claude Fable 5が80.3%でSolの64.6%を上回っており、「主力」が「すべてにおいて最高」を意味するわけではありません。当社のGPT-5.6 Solベンチマーク分析では、どこで数値が最も強く、どこで最も弱いかを詳細に解説しています。
Terra:本番環境作業のデフォルト
Terraの売りは、英雄的な性能よりも経済性です。OpenAIは、GPT-5.5と同等の性能を約2倍安価で提供すると位置付けており、この位置づけがほとんどの実際のワークロードを決定します。もしあなたの製品がGPT-5.5で十分に動作していたなら、Terraは同じレベルの機能を半分の費用で提供します。チャットアシスタント、要約、コンテンツパイプライン、ほとんどのRAGセットアップなど、これが始めるべきティアであり、ここから離れるためには説得力のある理由が必要となるティアです。
Luna:ユニットエコノミクスと速度
Lunaは、誰も推論を読まないような作業、すなわち分類、エンティティ抽出、リクエストルーティング、人間またはより大きなモデルが修正する初期ドラフトなどを処理します。$1入力 / $6出力で、Solのメーターの両側で5分の1のコストであり、3つの中で最も高速です。よくある間違いは、技術的なものではなく感情的なものです。「最も安い」が「最も悪い」ように聞こえるため、チームはLunaを飛ばし、一言の出力で済むタスクにTerraの料金を支払ってしまいます。
デフォルトの落とし穴
ここで請求額を静かに膨らませる詳細があります:gpt-5.6というベアエイリアス(モデル名の省略形)はSolにルーティングされます。明白なモデル文字列を使用すると、意識することなく最も高価なティアを選択してしまうことになります。
すべての呼び出しでティアを明示的に指定してください。
{
  "model": "gpt-5.6-terra",
  "input": "このサポートチケットを緊急度と製品分野で分類してください。",
  "reasoning": { "effort": "medium" }
}
この違いはすぐに積み重なります。月に50Mの入力トークンと10Mの出力トークンを処理するサービスは、Terraでは約$275、Solでは$550、Lunaでは$110を支払います。同じトラフィックでも、たった一つの文字列によって5倍もの差が生じます。キャッシュ割引を含む完全な料金表については、当社のGPT-5.6料金内訳をご覧ください。サイモン・ウィリソン氏のリリースに関する記事も、独立系開発者による初見として読む価値があります。
ワークロードに合ったモデルを選択する
3つのシナリオが、意思決定の大部分をカバーします。
エージェント型コーディングパイプライン。 Solを選択してください。ベンチマークの性能向上はここに集中しており、GA(一般提供)機能も同様です。プログラムによるツール呼び出しにより、モデルはツールの呼び出しをオーケストレーションするJavaScriptを記述でき、ネットワークアクセスなしの隔離されたV8ランタイムで実行され、持続的な推論がターン間でコンテキストを保持します。実行が40ステップかかり、12ステップ目で誤った決定が次の28ステップを無駄にする場合、モデルの品質はパイプライン内で最も安価な項目となります。Solの完全なプロファイルでは、この主力モデルが他に何を変更するかをカバーしています。
本番環境のチャットアシスタント。 Terraを選択してください。ユーザーはベンチマークの差分ではなく、レイテンシーと有用性で判断します。ルーチン的な質問では、SolとTerraの区別がつきません。ログで必要性が証明された場合、まれに難しいクエリをヒューリスティックの背後でSolにルーティングします。しかし、「パスワードをリセットするにはどうすればよいですか」といった質問に主力モデルの料金を払う必要はありません。
大量のドキュメントパイプライン。 Lunaを選択し、その上にキャッシングを重ねてください。GPT-5.6は明示的なキャッシュブレークポイント(`prompt_cache_options.mode: "explicit"`と`ttl`フィールド)をサポートしています。キャッシュの読み取りは90%の割引を維持し、書き込みは入力レートの1.25倍で課金され、キャッシュされたコンテンツは少なくとも30分間存続します。数千のドキュメントで長いシステムプロンプトを再利用する抽出ジョブの場合、Lunaと明示的なキャッシングを組み合わせると、他のいずれのティアとも異なるコストクラスに位置します。新しいビジョン詳細設定(`original`と`auto`)は元の画像寸法も保持します。これはスキャンからフィールドを抽出する際に重要です。
努力レベルが計算を変える
ティアはノブの半分に過ぎません。GPT-5.6は、どのティアでも6つの推論努力レベルを公開しています:`none`、`low`、`medium`、`high`、`xhigh`、`max`です。これにより3つのモデルがグリッドになり、最も興味深いセルの比較は、同じ設定でのSol対Terraではありません。それは`high`設定のTerraと`medium`設定のSolの比較です。思考時間を増やしたTerraは、トークン価格の半分で品質のギャップの大部分を埋めることができ、それがあなたのタスクにとって十分かどうかは、仕様書の問題ではなく、経験的な問題です。
OpenAI自身の移行ガイダンスも同じ方向を示しています。移行はモデルスラッグの交換ではなく、チューニングパスとして扱ってください。まず代表的なタスクをベンチマークし、現在の努力レベルと1段階低いレベルを並行してテストしてください。ドキュメントからのもう一つのプロンプトに関する注意点:GPT-5.6は、一般的な導入部が少なく、著しく短い回答を生成します。そのため、引き継ぐプロンプトから「簡潔に」という定型文を削除しないと、役に立たないほど簡潔な回答になる可能性があります。
再実行するよりも待つことを優先する品質重視の作業では、プロモード(`reasoning.mode: "pro"`)が3つのモデルすべてで利用可能です。これは設定であり、別のモデルではないため、Solと同じくらい簡単にTerraでも切り替えることができます。
コミットする前に3つすべてをテストする
「どのモデルを使うべきか」という問いに対する正直な答えは、「あなたのプロンプトで最も優れた結果を出すもの」です。ベンチマークはOpenAIのタスクであり、あなたの本番トラフィックではありません。
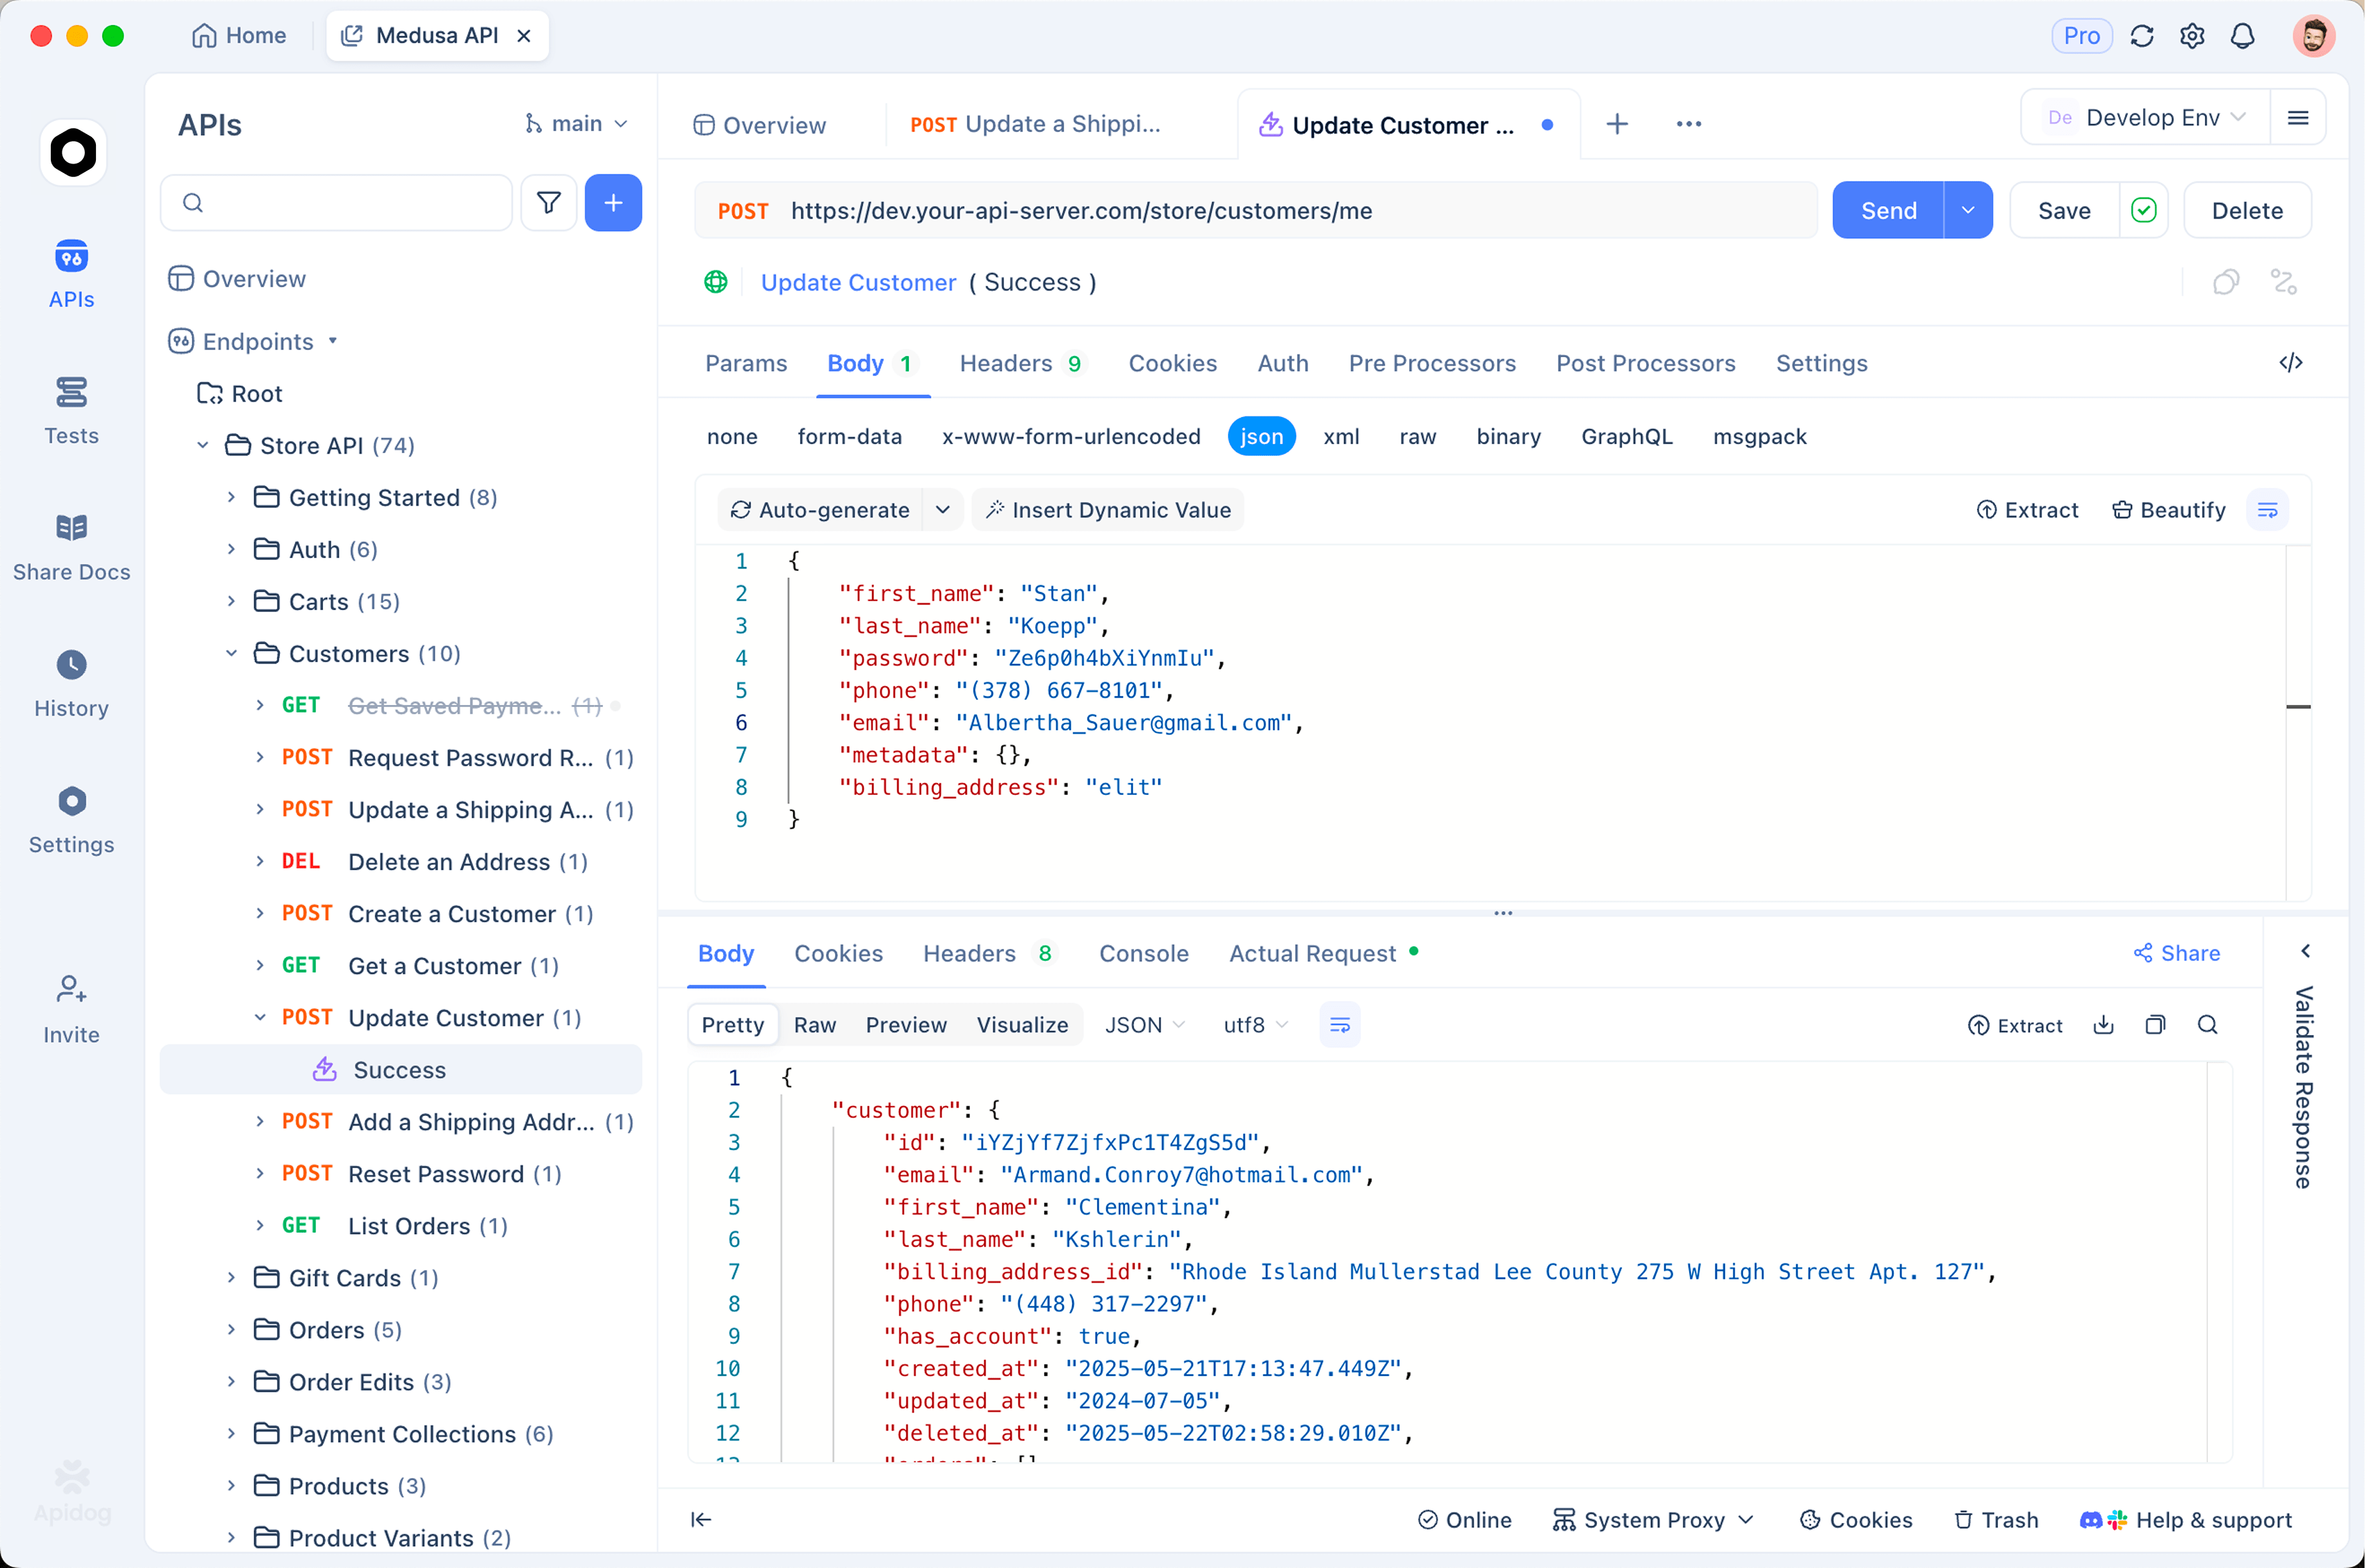
テストは安価に実行できます。ログから10~20個の実際のタスク(醜いものも含む)を収集してください。Apidogをダウンロードし、OpenAIのベースURLとAPIキーを一度保存し、モデルIDを環境変数に入れて、一つのリクエスト定義で3つのティアすべてをカバーできるようにします。`{{model}}`を`gpt-5.6-sol`、`gpt-5.6-terra`、`gpt-5.6-luna`の間で切り替え、同じプロンプトセットを実行し、2つのことを並行して比較します:独自の基準に対する出力品質と、各レスポンスの`usage`トークン数です。それらのカウントを料金表で乗算すれば、タスクあたりのコスト表は自動的に作成されます。
これらの比較テストのほとんどで、2つの発見が見られます。Terraは、料金の差が示す以上に多くのタスクでSolに匹敵します。そしてLunaは、その価格が示唆するよりもはるかに頻繁に、分類や抽出といった構造化出力作業に対応できます。あなたのワークロードがそのパターンを破る場所は、実際に実行してみることでしかわかりません。
Ultraが適合する場所
Ultraは、このラインナップの中でAPIモデルIDではない唯一のオプションです。これはマルチエージェント設定で、デフォルトで4つのエージェントを並行して実行し、難しい問題に対してより速い実時間結果を得るために意図的に多くのトークンを消費します。OpenAIによると、UltraはSolのTerminal-Bench 2.1スコアを88.8%から91.9%に引き上げます。
利用可能性は製品側でプランによって制限されます。UltraはProおよびEnterpriseプランのChatGPT Workで利用でき、Plus以上のCodexで利用可能です。チャット製品には、OpenAIのヘルプセンターによると、独自のティアマップがあります。
| ChatGPTプラン | GPT-5.6アクセス |
|---|---|
| 無料 / Go | Terra |
| Plus | Sol、Terra、Luna(モデルごとの努力レベル制御付き、Solは中程度の努力レベル以上から) |
| Pro / Business / Enterprise | 上記のすべて、さらにSol Pro |
| ChatGPT Work (Pro / Enterprise)、Codex (Plus以上) | Ultra |
もしあなたの並列エージェントワークロードがチャットではなくコードで動作する場合、Responses APIのマルチエージェントベータに注目してください。これは同じアイデアのAPI側の兄弟です。
よくある質問
gpt-5.6-terraは本番環境でGPT-5.5を置き換えるのに十分ですか?
ほとんどのワークロードで、はい。OpenAIはTerraをGPT-5.5と同等の性能を約半額で提供すると位置付けており、同じResponses APIインターフェースであるため、切り替えのリスクは低いと言えます。移行する前に評価を実行し、GPT-5.6の回答は設計上短くなる傾向があるため、出力長に注意してください。
ベアエイリアスgpt-5.6を呼び出すとどうなりますか?
リクエストはSolにルーティングされ、Solの料金、$5/1M入力トークン、$30/1M出力トークンで課金されます。何も壊れない、それが問題です。コストは後で請求書に現れます。より安価なティアで十分な場合は、`gpt-5.6-terra`または`gpt-5.6-luna`を明示的に指定してください。
統合を変更せずにティアを切り替えることはできますか?
はい。Sol、Terra、Lunaは同じResponses APIインターフェースを共有しているため、それらの間で移行するには、モデル文字列を1行変更するだけです。努力レベルとプロモードも、3つのモデルすべてで機能します。GPT-5.6 APIの使用方法に関する私たちのガイドでは、リクエストの形式を最初から最後まで説明しています。
APIでこれらのモデルを使用するために、特定のChatGPTプランが必要ですか?
いいえ。APIアクセスは、どのAPIアカウントでもセルフサービスで利用でき、3つのモデルのいずれにもプランによる制限はありません。ChatGPTのプランティアはチャット製品のみを制御し、UltraはAPIモデルとして提供されるのではなく、製品側(ChatGPT WorkおよびCodex)に残る唯一の機能です。
ティアとの最初の1時間
Terraから始めて、他のティアにその有用性を証明させてください。Solへのエスカレーションは、あなたの評価で2倍の費用を払う価値のあるギャップが見られる場合にのみ行ってください。これは通常、エージェント的な作業や長期的な視点を持つ作業を意味します。出力が短く、ボリュームが多い場合は常にLunaにダウングレードしてください。Solがデフォルトとなるエイリアスがあなたに代わって選択しないように、常に明示的なモデルIDを指定し、ティアを変更する前に努力レベルを調整してください。なぜなら、`high`設定のTerraは、ラインナップの中で最も安価な品質アップグレードだからです。
読み終えたら、測定を開始してください。最も見栄えの悪い本番プロンプトを10個Apidogにロードし、環境変数を使って1つのリクエストを3つのモデルIDすべてに指向させ、独自のトークンカウントと出力で判断してください。この演習全体にかかるAPI費用は1ドル未満であり、毎月積み重なる決定を解決します。
button