
Z.ai は現在、ほぼ同じ名前、同じ1Mトークンのコンテキストウィンドウ、そして9倍の価格差を持つ2つのモデルを販売しています。命名規則は選択の役には立ちません。「Flash」という名前は、より小さく、速く、弱いバリアントを意味しますが、これらのうち正確なのは3つのうちの1つだけです。
要点をまとめると、 **GLM-5.3-Flashはより安価で、画像をネイティブに処理し、コーディングプランのユーザーには3倍の割り当てを提供します。GLM-5.3はいくらか賢く、約2倍の速さで生成します。** ほとんどのワークロードでは、Flashが適切なデフォルトであり、高価な方を選ぶにはそれなりの根拠が必要です。
この投稿では、そのルールが破れるケースを解説します。
比較表
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| インテリジェンス指数(Artificial Analysis) | 57 | 60 |
| 1Mトークンあたりの統合価格 | $0.10 | $0.90 |
| 1Mあたりの入力/出力 | $0.15 / $0.50 | $1.40 / $4.40 |
| 出力速度 | 約49トークン/秒 | 約86トークン/秒 |
| 初回トークンまでの時間 | 1.52秒 | 1.57秒 |
| コンテキストウィンドウ | 1,048,576 | 1,048,576 |
| ネイティブ画像入力 | はい | いいえ、アダプターベース |
| パラメータ数 | 合計320B / アクティブ18B | より大きい、完全には非公開 |
| ライセンス | MIT、オープンウェイト | オープンウェイト |
| コーディングプランの割り当て | 3倍 | 1倍 |
速度とインテリジェンスの数値はArtificial Analysisの測定値です。価格は、以下で説明するローンチ割引適用前のZ.aiのリスト価格です。
9倍の価格差がどこから来るのか
GLM-5.3-Flashは、ハイブリッド線形および疎なアテンションを備えた新しいベース上に構築された、トークンあたり18Bのパラメーターをアクティブ化する320BのMixture-of-Expertsモデルです。Z.aiの報告によると、GLM-5.3と比較して約3分の1のアテンション計算量、KVキャッシュは約4.4分の1のサイズです。
KVキャッシュのサイズは、長文コンテキストの提供を高くする要因です。これを4.4分の1に削減することで、Z.aiが1Mトークンのウィンドウを10分の1の価格で提供できる主な理由となっています。短いコンテキストや性能の低いモデルに対して安く支払っているわけではありません。リクエストあたりの提供フットプリントが実際に小さいため、安く支払っているのです。
これは、プロモーション割引ではなく、本物のエンジニアリングの成果であり、価格が維持されるかどうかにおいて重要です。
3ポイントのインテリジェンスギャップが意味するもの
Artificial Analysis Intelligence Indexで57対60というのは、絶対的にはわずかな差です。参考までに、同規模のオープンウェイトモデルの中央値は27点であり、どちらもこの分野でははるかに上回っています。
しかし、3ポイント差は決して無視できるものではありません。この規模のインデックスギャップは、通常、複数ステップの推論チェーンでの性能のわずかな低下、非常に長いエージェントタスクでのより大きなドリフト、そして曖昧な指示に対する感度の高さとして現れます。直接的な抽出、分類、要約、または単一ファイルのコード編集ではめったに現れません。
実用的なテストは、あなたのタスクに検証可能な答えがあるかどうかです。出力プログラムでチェックできる場合、Flashのたまのミスは捕捉が容易で再試行も安価であり、9分の1の価格であれば何度も再試行できます。タスクが人間が読んで判断する必要のある散文を生成する場合、品質の差は回復が難しく、価格差よりも結果の方が重要になります。
スピードはFlashが実際に劣る唯一の点
ここは名前が逆転している部分です。GLM-5.3は約86トークン/秒で生成します。GLM-5.3-Flashは約49トークン/秒です。より大きく、より高価なモデルは、出力生成においてほぼ2倍の速さです。
最初のトークンまでの時間は、1.52秒対1.57秒と実質的に同じなので、どちらも応答開始時の反応速度は同じように感じられます。
結果は完全にアウトプットの長さに依存します。
- 短い応答。関係ありません。どちらも約1.5秒で開始し、誰かがスループットの違いに気づく前に終了します。
- 長い生成。 4,000トークンの応答は、Flashでは約82秒、GLM-5.3では約47秒かかります。インタラクティブなツールでは、これは意味のある差です。
- 並行処理を伴うバッチジョブ。これもほとんど関係ありません。なぜなら、ストリームごとの速度ではなく並列リクエストでスケールするため、価格差が多くの並列処理を可能にするからです。
待っている人に長文出力をストリーミングする場合、GLM-5.3の方が良い体験を提供します。これが9倍多く支払う最も明確な理由です。
マルチモダリティが真の分水嶺
GLM-5.3-Flashは、画像、動画、ファイルをテキストと同じチャット完了リクエスト内のコンテンツブロックとして受け入れます。GLM-5.3はこれをネイティブに行いません。ビジョンは別のアダプターを介して処理されます。
アプリケーションが何かをモデルに見せる必要がある場合、これは比較ではなく要件です。Flashは、単一の呼び出し、単一のコンテキストウィンドウ、単一の請求行でそれを行うことができる2つのうちの唯一のものです。
この機能は、このモデルファミリーにとって真に新しい方法で1Mコンテキストと組み合わされます。長い仕様書と構築された結果のスクリーンショットが同じプロンプトを占めることができます。Z.ai自身のポジショニングでは、インターフェースの観察と結果のレンダリングについて語っており、これは画像キャプションではなくコーディングエージェントの枠組みです。
当社のビジョンガイドでは、ペイロードとワークフローについて説明しています。古い専用のビジョンモデルについては、そのパスで構築されたものを維持している場合、GLM-5V-TurboのAPIガイドで説明されています。
コーディングプランの視点
GLMコーディングプランの購読者にとって、計算は異なり、より単純です。Flashはプランに含まれており、GLM-5.3の**3倍の利用可能な割り当て**があると報告されています。Z.aiはまた、オフピーク時の呼び出しが通常のポイントの半分を消費するとも述べています。
Claude CodeまたはClineをプランの割り当てに対して実行している場合、3ポイントのインデックス低下に対して3倍のリクエストは、日常業務では簡単なトレードオフです。GLM-5.3は難しい問題のために取っておき、Flashに大量の処理を吸収させましょう。両方のハーネスのセットアップは、Claude CodeとClineのガイドにあります。
プランの条件はモデルの仕様よりも頻繁に変わるため、計画を立てる前にz.aiで割り当て倍率を確認してください。
価格設定の期限
GLM-5.3-Flashの50%ローンチ割引は**2026年9月9日**まで実施されます。それまでは、実効料金は入力1Mあたり0.075ドル、出力1Mあたり0.25ドルとなり、GLM-5.3との差は約18倍に広がります。
割引が終了すると、リスト価格の入力1Mあたり0.15ドル、出力1Mあたり0.50ドルが適用され、差は約9倍に戻ります。いずれにせよ、Flashは劇的に安価です。期限は、両モデルの選択ではなく、コスト予測を固定するために重要です。当社の価格内訳には計算された数字が示されています。
決定ルール
GLM-5.3-Flashを使うべき時:
- 入力に画像、動画、またはファイルが含まれる場合。
- トークンあたりのコストが最適化する制約である場合。
- 大量の抽出、分類、ルーティングを実行する場合。
- コーディングプランに加入しており、割り当てをさらに活用したい場合。
- MITライセンスのオープンウェイトを自分でホストしたい場合。ローカルでの実行ではハードウェアをカバーしています。
GLM-5.3を使うべき時:
- 待っている人間に長い応答をストリーミングし、スループットが体感に影響する場合。
- あなたの作業が、複数ステップにわたって3ポイントのインデックス差が影響する長期的推論である場合。
- 出力品質がテストによってではなく、人間によって判断される場合。
両方を使うべき時:ルーティングが可能な場合。トラフィックの大部分をFlashに送り、失敗、信頼度の低さ、またはタスクの種類に応じてGLM-5.3にエスカレートさせます。9倍の価格差はルーターを構築する価値があり、両モデルが同じOpenAI互換エンドポイントの背後にあるため、ルーティングは統合ではなくモデルIDの交換で済みます。
モデル間の移行
すでにGLM-5.3を使用しており、移行を検討している場合、機械的な部分は些細なことですが、検証の部分に労力がかかります。
変更されないもの。ベースURL、認証スキーム、リクエストとレスポンスの形式、ストリーミングセマンティクス、ツール呼び出しスキーマ。両モデルは同じOpenAI互換インターフェースの背後にあります。交換はモデルID文字列です。
変更されるもの。呼び出しあたりのコストが約9分の1に減少します。生成速度が約半分になります。推論品質は3インデックスポイント変動します。そして、以前は利用できなかった画像入力が得られます。
コミットする前に確認すべきこと。実際のプロンプトを両方で実行し、次の4つの軸で比較します。検証可能なケースにおける出力の正確性、初回トークンだけでなく生成時間を含むエンドツーエンドの遅延、各レスポンスの`usage`オブジェクトからのトークン数、そして最長の実用的なコンテキストでの動作です。
4つ目の点が最も多くの問題を引き起こします。短いプロンプトでは同等に見えるモデルでも、コンテキストがいっぱいになると著しく異なる挙動を示すことがあり、ベンチマーク表ではあなた自身のデータについてそれを教えてくれることはありません。
ベースモデルから始めた場合、GLM-5.3とは何かはそれ自身の言葉で説明されており、GLM-5.3 APIガイドには移行元のセットアップが記載されています。
表を信用するのではなく、テストする
上記のすべての数字は、ベンダーの主張か、他者のワークロードで実行されたサードパーティのベンチマークのいずれかです。どちらも、あなたのプロンプトに対してこれら2つのモデルがどのように動作するかを教えてはくれません。
交換は文字列一つです。OpenAI互換のクライアントを`https://api.z.ai/api/paas/v4/`に向け、`glm-5.3-flash`と`glm-5.3`を通して実際のプロンプトを実行し、気になるトラフィックの出力、遅延、トークン数を比較してください。APIガイドにセットアップがあります。
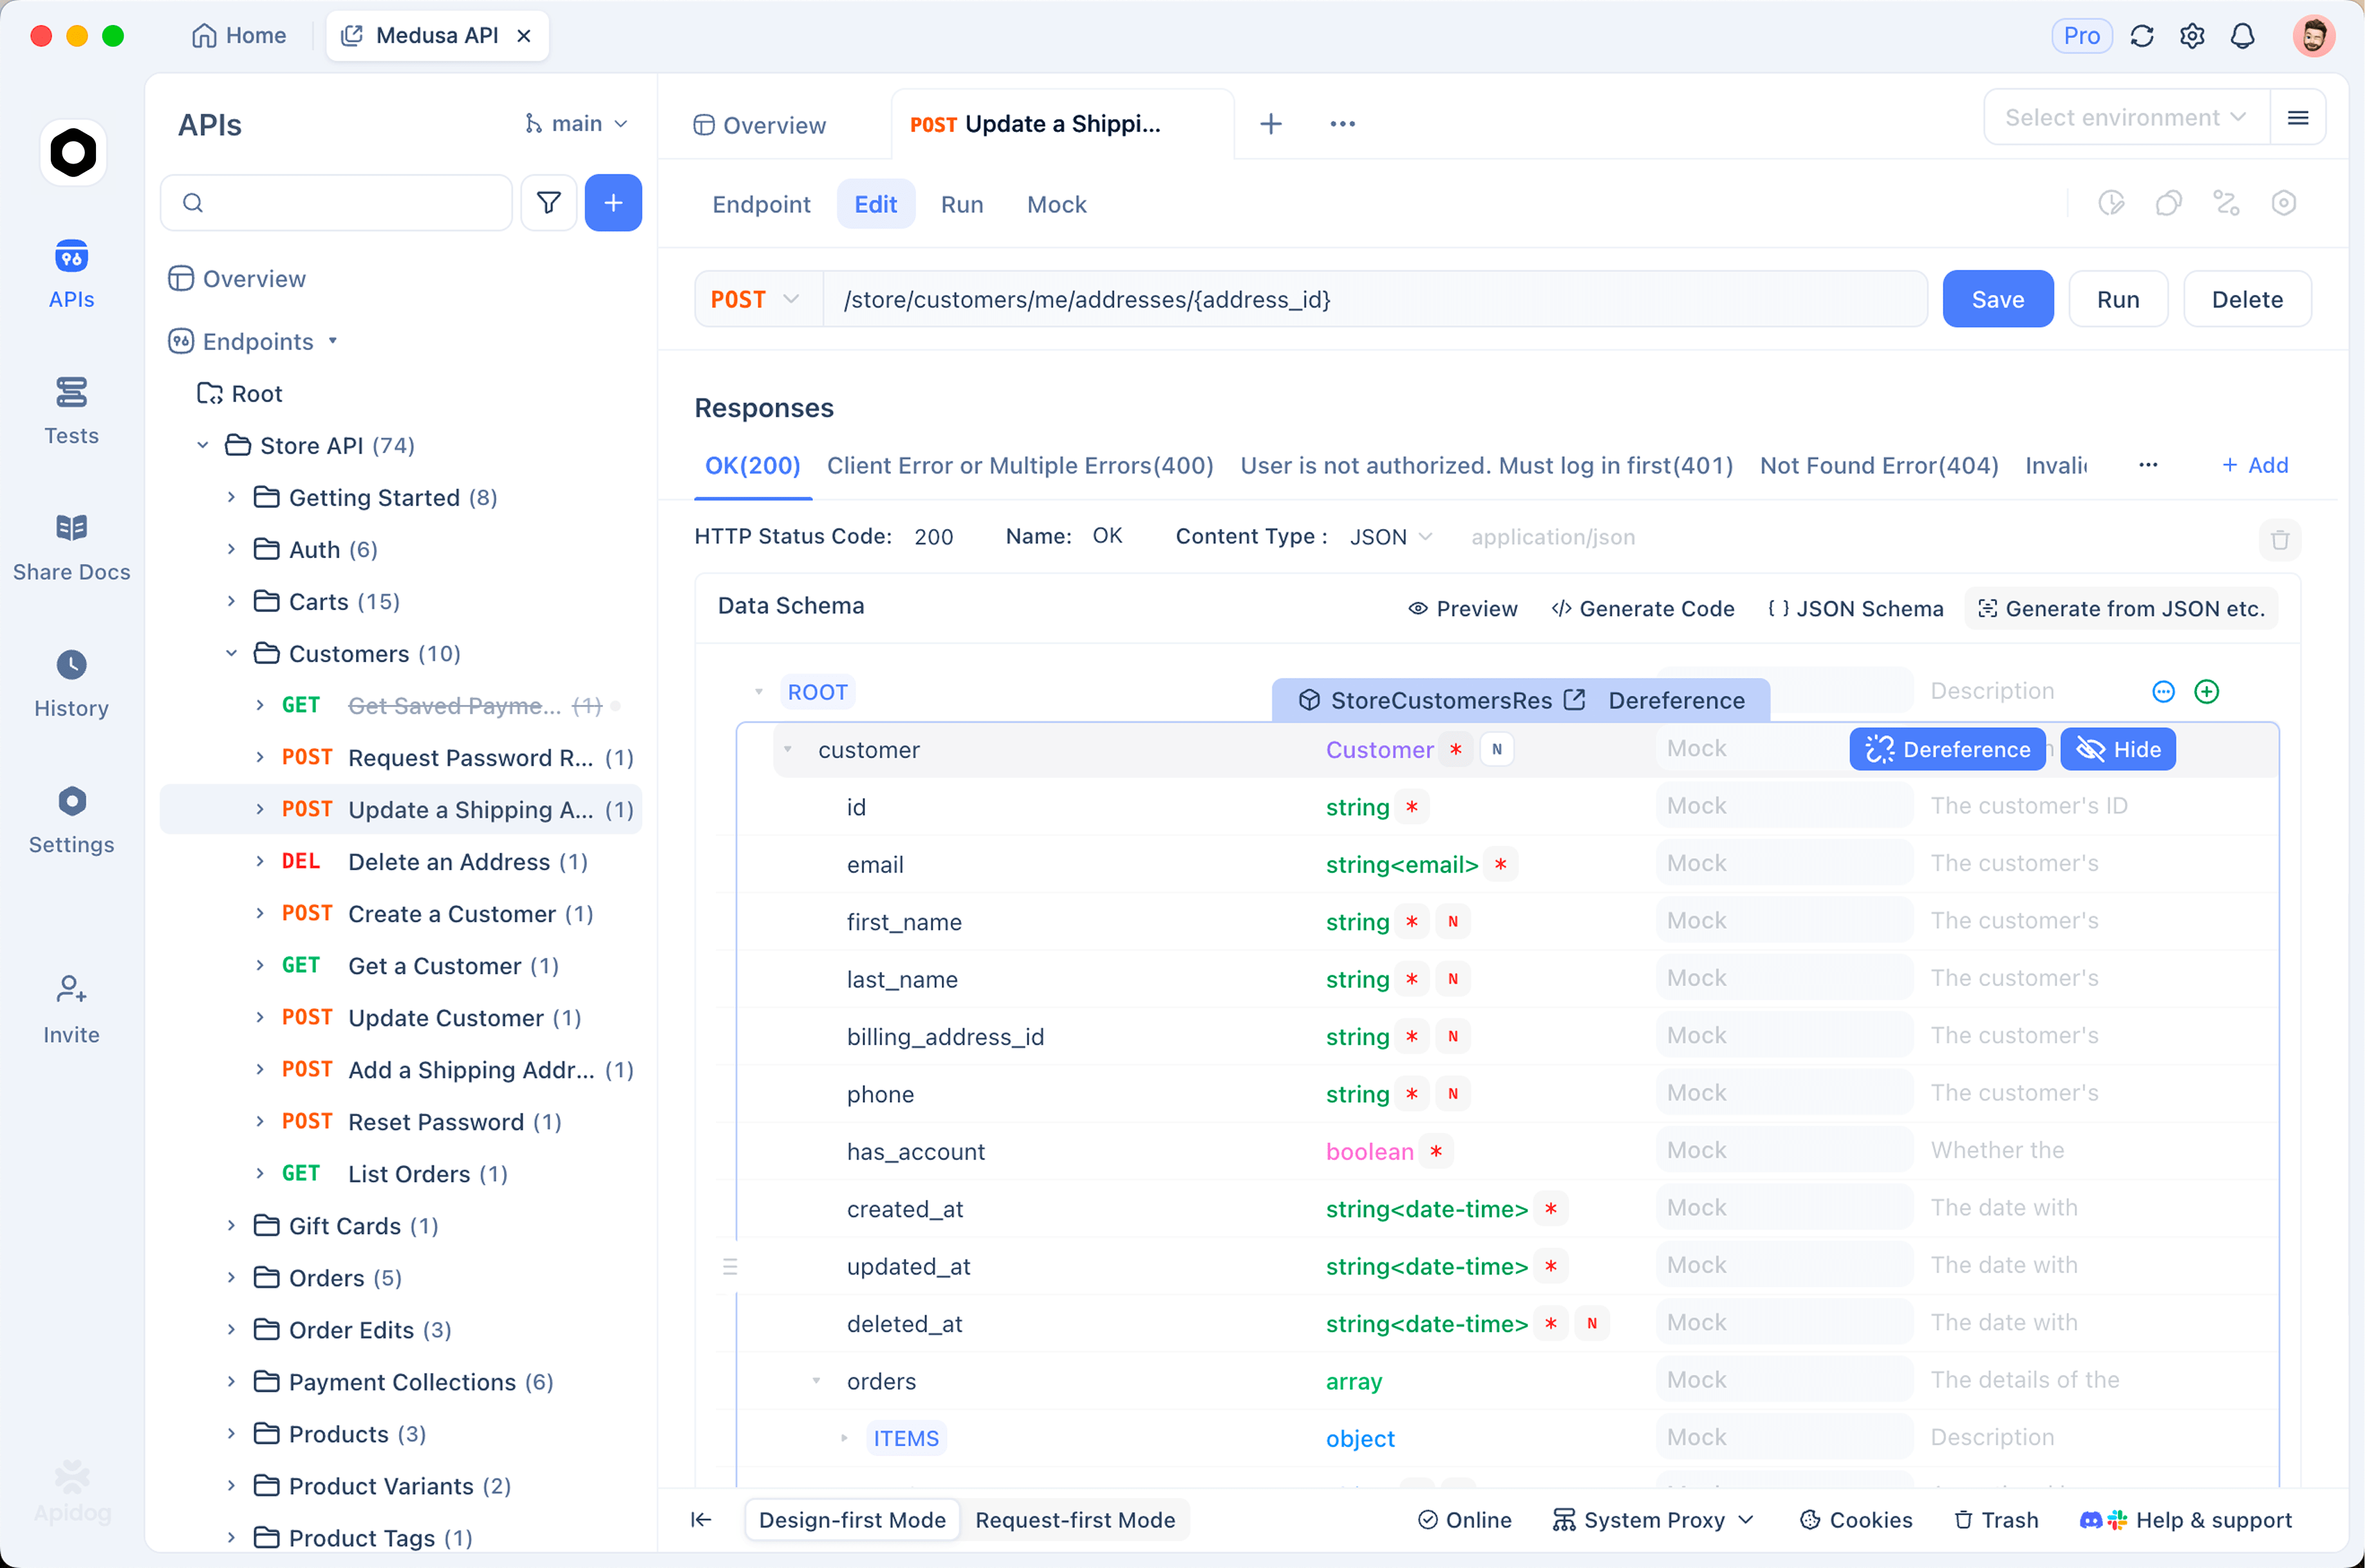
ここで、比較を再現可能なスイートとして保存することが報われます。Apidogでは、モデルIDを環境変数として使用して、両方の呼び出しを1つのコレクションに保持し、アプリケーションが読み取るフィールドにアサーションを添付し、割引が失効したりZ.aiが次の改訂版を出荷したときに全体を再実行できます。30秒で再テストできるモデル選択は再検討可能な決定ですが、シェル履歴に残っているものはそうではありません。
よくある質問
GLM-5.3-Flashは単に小型のGLM-5.3ですか? いいえ。これは、蒸留や剪定されたバリアントではなく、異なるアテンションアーキテクチャを持つ個別にトレーニングされたベースモデルです。
コンテキストウィンドウは同じですか? はい、どちらも1,048,576トークンです。
コーディングにはどちらが良いですか? Z.aiによると、FlashはTerminal-Bench 2.1で84.3、DeepSWEで63.4と強力なスコアを出しています。GLM-5.3は一般的な推論においていくらか強力です。コーディングプランのユーザーにとっては、3倍の割り当てが通常決め手となります。
コード変更なしで切り替えられますか? はい。同じOpenAI互換エンドポイントですが、モデルIDが異なります。画像入力のみFlash専用です。
安い方は安価なままですか? この価格はプロモーションではなく、より小さなKVキャッシュと低いアテンション計算を反映しているため、構造的な優位性は維持されるはずです。追加の50%ローンチ割引は2026年9月9日に終了します。